GGraphRAG 文献图谱自动同步
LIT-B0856E32 · 2026

CS-RAG - Robust GraphRAG over Imperfect KGs

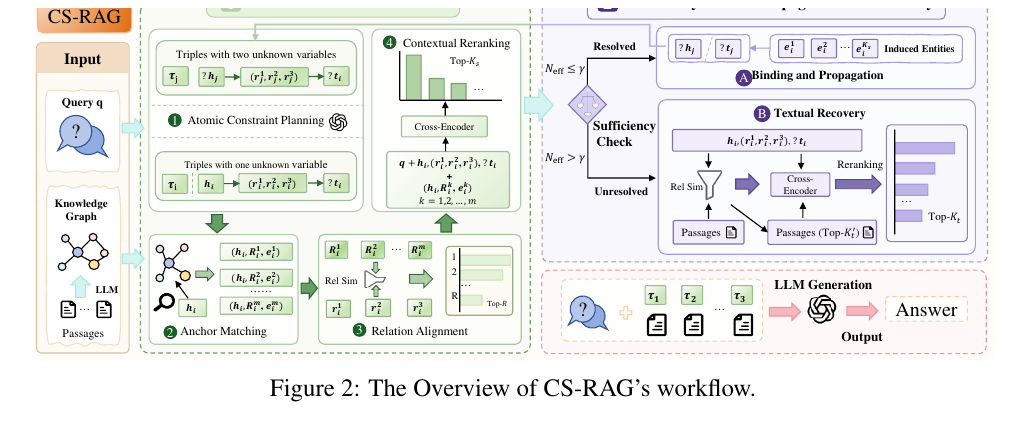
CS-RAG 不试图先把 KG 修到完美,而是在检索时把问题拆成可执行原子约束,并用 Neff 判断每一跳的结构候选是否足够集中;集中则传播变量,不集中则转入文本恢复。

PDF 级阅读卡优先级 P1Yizhuo Ma, Jinchuan Xu, Tao Wen, Qizhi Chen, Jiakai Li, Rongzheng Wang, Muquan Li, Shuang Liang, Ke QinarXiv 2026;README 标注为 NeurIPS 2026 submission,正式接收状态待复查
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:很多 GraphRAG 默认 KG 是可靠的,但实际 LLM 构图会产生错关系、错实体绑定、关系方向翻转、缺桥接边和缺限定信息。这些问题进入多跳检索后,会把检索轨迹带偏,或让系统在结构证据不足时继续传播伪 binding。
  • 为什么重要:GraphRAG 的错误不只来自最终 LLM 幻觉,也可能来自检索阶段对错误 KG 结构的过度信任。若不区分“图里有噪声”和“图里缺证据”,系统会把局部看起来相关的 triple 当作可继续推理的证据。
  • 现有路线:
  • 对本知识库的意义:CS-RAG 把 GraphRAG中的知识图谱噪声传播 从攻击/构图质量扩展到 retrieval-time mitigation:不一定先修 KG,而是在每一跳判断“这个结构 binding 是否足够可靠,可以继续传播”。

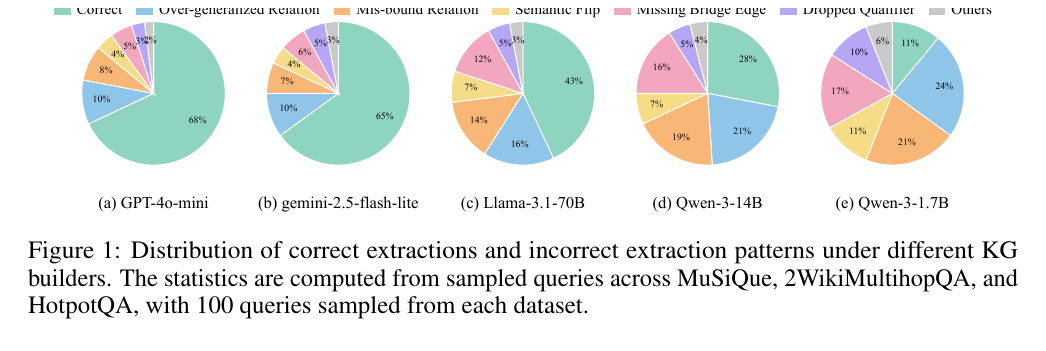
Figure 1 的关键信号是:不同 LLM builder 都会产生不同比例的错误 tuple;即使强 builder,也不是所有 query-relevant 支持句都能被正确抽取。论文把错误聚合成两类:spurious noise 触发 retrieval drift,incomplete information 触发 retrieval hallucination。

  • Reliable-KG assumption:多数 GraphRAG 方法默认 KG 足够可靠,只在图上做 PPR、beam search、path reranking 或社区摘要。
  • Coarse semantic matching:如果只看 query-triple 语义相似度,mis-bound relation、over-generalized relation 和 semantic flip 仍可能进入候选池。
  • Forced structural continuation:当 bridge edge 或 qualifier 缺失时,系统仍可能沿弱连接继续传播变量,产生 unsupported binding。
  • KG repair cost high:直接重抽、验证或人工修 KG 成本高,尤其在多 builder、多数据集或本地部署场景中不可持续。
  • Sufficiency not explicit:已有方法常有 stop / fallback 概念,但缺少一个能解释“为什么当前 hop 可以或不可以传播”的候选分布级判据。

方法与机制

1. 总体框架:Query -> Constraint Plan -> Structured Retrieval -> Sufficiency Decision -> Text Recovery / Binding Propagation

输入:问题 $q$、LLM 构建的知识图谱 $G=(E,R,T)$、query-specific passages $U(q)$、结构候选预算 $K_s$、文本恢复预算 $K_t$、sufficiency threshold $\gamma$。

计算链路:

  1. Atomic Constraint Planning:LLM 把多跳问题规划成有序原子约束:
P=\langle \tau_1,\tau_2,\ldots,\tau_k\rangle,\quad \tau_i=(h_i,r_i,t_i)

其中 $h_i,t_i$ 可以是问题中的常量实体,也可以是中间变量 $V={?v_1,?v_2,\ldots}$。每个约束还生成 relation variants:

R_i=\{r_i^{(1)},\ldots,r_i^{(m)}\}
  1. Constraint-based Retrieval:先执行只有一个未知变量的约束:
P_1=\{\tau_i=(h_i,r_i,t_i)\in P\mid |\{h_i,t_i\}\cap V|=1\}
  1. Sufficiency-Guided Propagation and Recovery:对每个约束的 refined candidate pool 判断是否足够支持变量 binding。
  2. LLM Generation:把 resolved structural evidence 和 unresolved textual evidence 组织成 constraint-aligned context,生成答案。

输出:最终答案、每个原子约束的 resolved / unresolved 状态、变量 binding、结构证据、文本恢复证据。

直观解释:CS-RAG 把 GraphRAG 的多跳检索从“沿图走”改成“逐条执行约束”。每一跳必须先证明结构候选足够集中,才允许把变量带到下一跳。

2. Atomic Constraint Planning:把问题转成带变量的可执行约束

输入:自然语言问题 $q$。

计算链路:

  1. 抽出 query entities $E_q$ 和中间变量 $V$。
  2. 生成 ordered constraints $P$,每个 constraint 是一个 triple pattern。
  3. 为每个 relation 生成多个语义变体 $R_i$,作为后续 relation alignment 的目标。

输出:原子约束序列 $P$ 和 relation variants ${R_i}$。

直观解释:planner 的作用不是直接回答,也不是直接检索文本,而是把多跳问题变成一组可以在 KG 中逐步执行的结构约束。

3. Anchor Matching + Relation Alignment + Contextual Reranking

输入:单变量约束 $\tau_i\in P_1$、anchor surface $e_i^{surf}$、KG triple set $T$、relation variants $R_i$。

计算链路:

  1. Anchor Matching:用 top-3 token-coverage matching 把 $e_i^{surf}$ 映射到 KG anchor nodes $E_i^{anchor}$。
  2. One-hop Enumeration:从 anchor nodes 枚举一跳邻域,形成候选池 $C_i$。
  3. Relation Alignment:比较候选 triple 的 KG relation 和 $R_i$,保留 top-$R$ relation-aligned candidates,得到 $C_i^{init}$。
  4. Contextual Reranking:cross-encoder 输入 query、linearized constraint 和 candidate triple,得到分数 $z_{i,c}$,保留 top-$K_s$:
C_i^{top}=\operatorname{TopK}_{K_s}\{c\in C_i^{init};\ z_{i,c}\}

输出:当前约束的 refined structural candidate pool $C_i^{top}$。

直观解释:这一步防 retrieval drift。候选不仅要连到 anchor,还要满足当前 hop 的 relation semantics;否则只是实体相关,不能算 constraint-compatible evidence。

4. Neff Sufficiency Check:只传播足够集中的结构 binding

输入:候选池 $C_i^{top}$ 和 cross-encoder 分数 ${z_{i,c}}$。

计算链路:

  1. 对候选分数做 softmax:
p_{i,c}=\frac{\exp(z_{i,c})}{\sum_{c'\in C_i^{top}}\exp(z_{i,c'})}
  1. 计算 effective number of candidates:
N_{\mathrm{eff}}(\tau_i)=\frac{1}{\sum_{c\in C_i^{top}}p_{i,c}^{2}}
  1. 用阈值 $\gamma$ 判断状态:

$$ \operatorname{State}(\tau_i)= \begin{cases} \text{Resolved}, & N_{\mathrm{eff}}(\tau_i)\le \gamma\

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

1. 跨 KG builder 鲁棒性

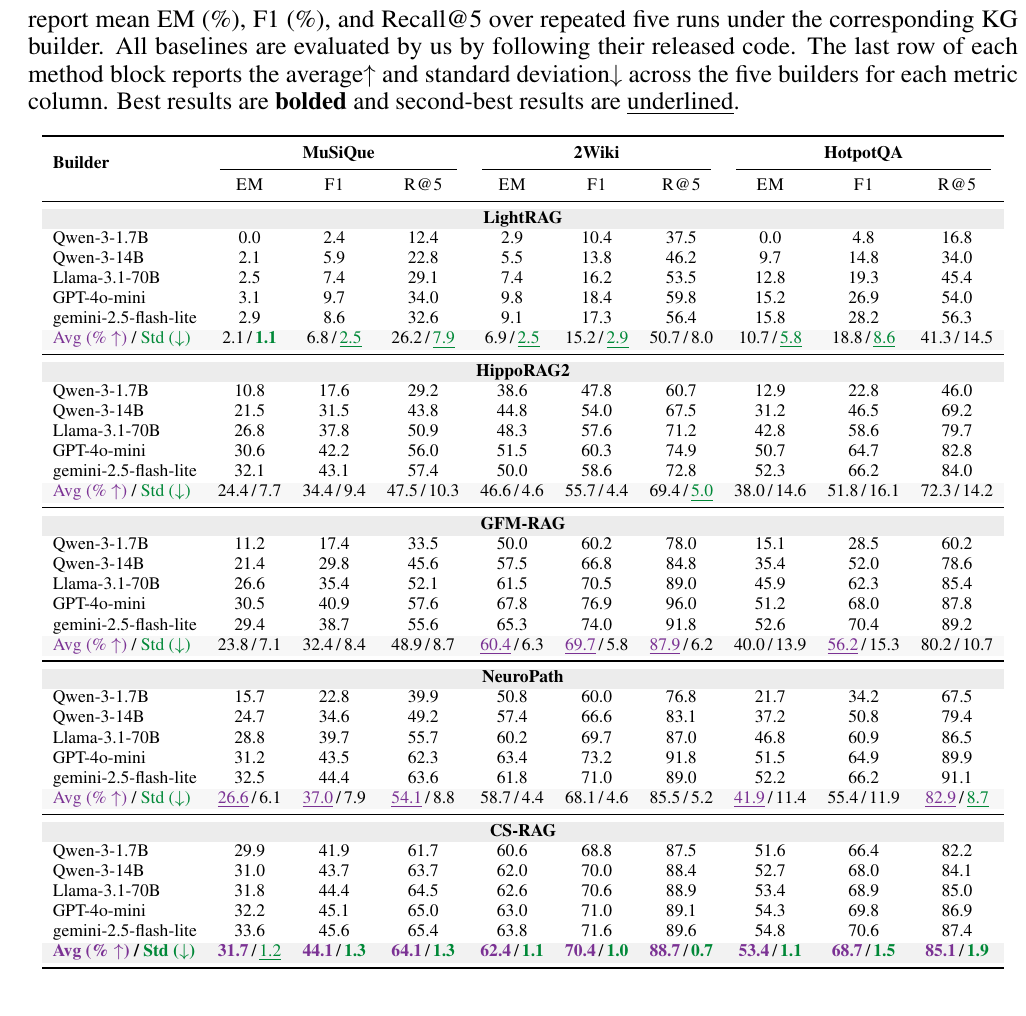
Table 1 的核心结论是:CS-RAG 在 MuSiQue、2Wiki 和 HotpotQA 上都取得最高 cross-builder average,并且标准差很低。例如平均 F1 分别为 MuSiQue 44.1、2Wiki 70.4、HotpotQA 68.7;对应 std 为 1.3、1.0、1.5。这说明 CS-RAG 对 KG builder 质量差异不那么敏感。

2. 受控 KG issue injection

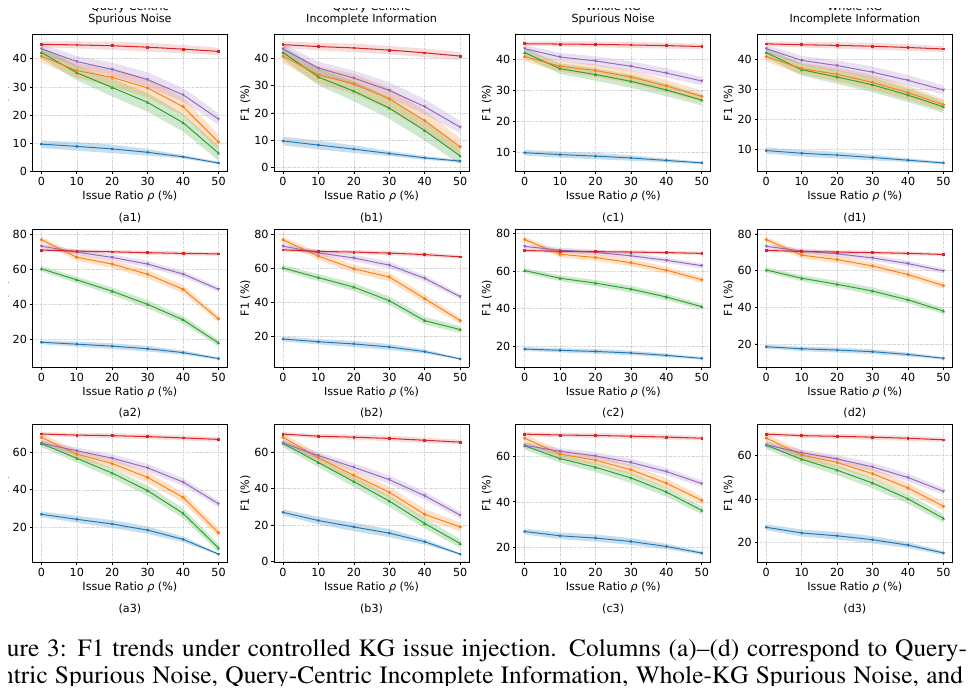
Figure 3 把问题注入分成 query-centric / whole-KG 两种范围,以及 spurious noise / incomplete information 两种类型。随着 issue ratio $\rho$ 从 0.1 到 0.5 增加,基线 F1 明显下降,而 CS-RAG 曲线基本稳定。这个实验直接支持“constraint retrieval 防 drift,sufficiency + textual recovery 防 hallucinated continuation”。

3. 消融:planner、relation alignment、sufficiency check 都不可替代

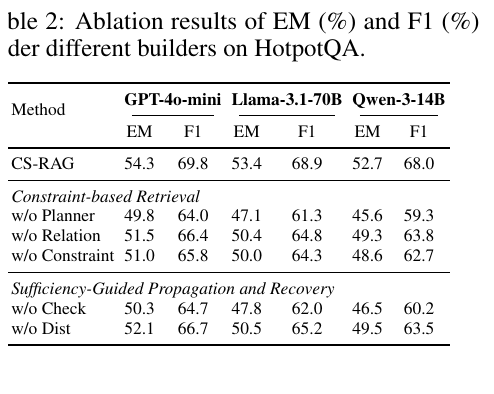
Table 2 显示在 HotpotQA 上,去掉 Planner、Relation、Constraint、Check、Dist 都会下降。w/o Planner 下降最大,说明原始 query 不能替代 hop-wise constraints;w/o Check 会强制传播不可靠结构候选,说明 sufficiency check 是防 retrieval hallucination 的关键。

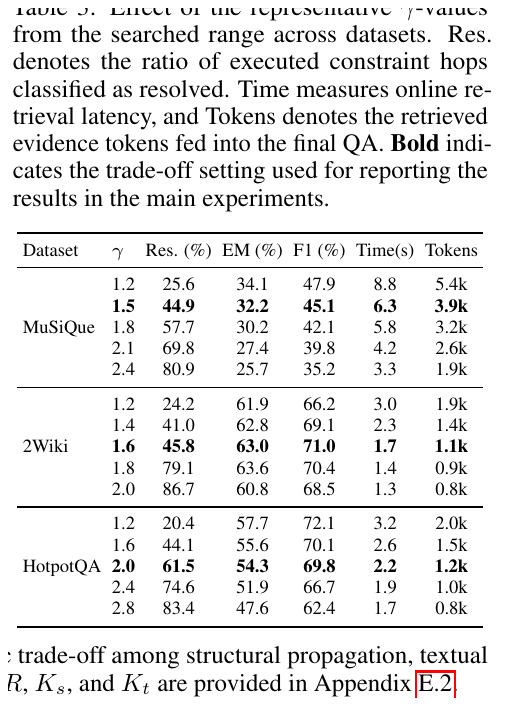
4. $\gamma$ 是结构传播与文本恢复的成本-质量旋钮

Table 3 显示 $\gamma$ 越大,resolved-hop rate 越高,latency 和最终上下文 tokens 越低;但过大的 $\gamma$ 会让弱 binding 更容易被接受。MuSiQue 更偏向小 $\gamma$ 和更多 textual recovery;2Wiki 在中等 $\gamma$ 处达到更好 trade-off;HotpotQA 也体现准确率-成本折中。

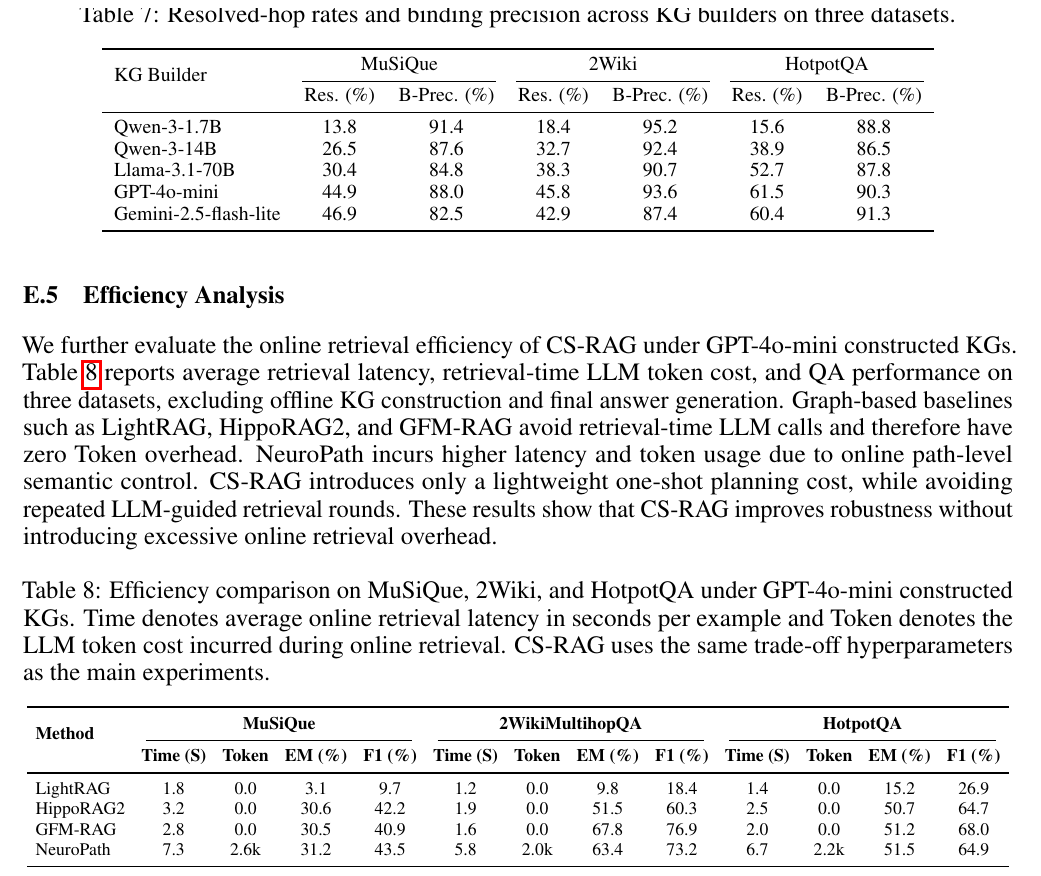
5. Sufficiency check 的正确性与效率边界

Table 7 显示 weaker builders 的 resolved-hop rate 更低,但 resolved 后的 binding precision 仍较高,说明 Neff 能过滤不确定结构候选。Table 8 显示 CS-RAG 引入 one-shot planning token cost,但没有像多轮 LLM-guided traversal 那样反复调用;在 GPT-4o-mini KG 上,MuSiQue / 2Wiki / HotpotQA 的 retrieval-time tokens 约为 0.86k / 0.72k / 0.76k。

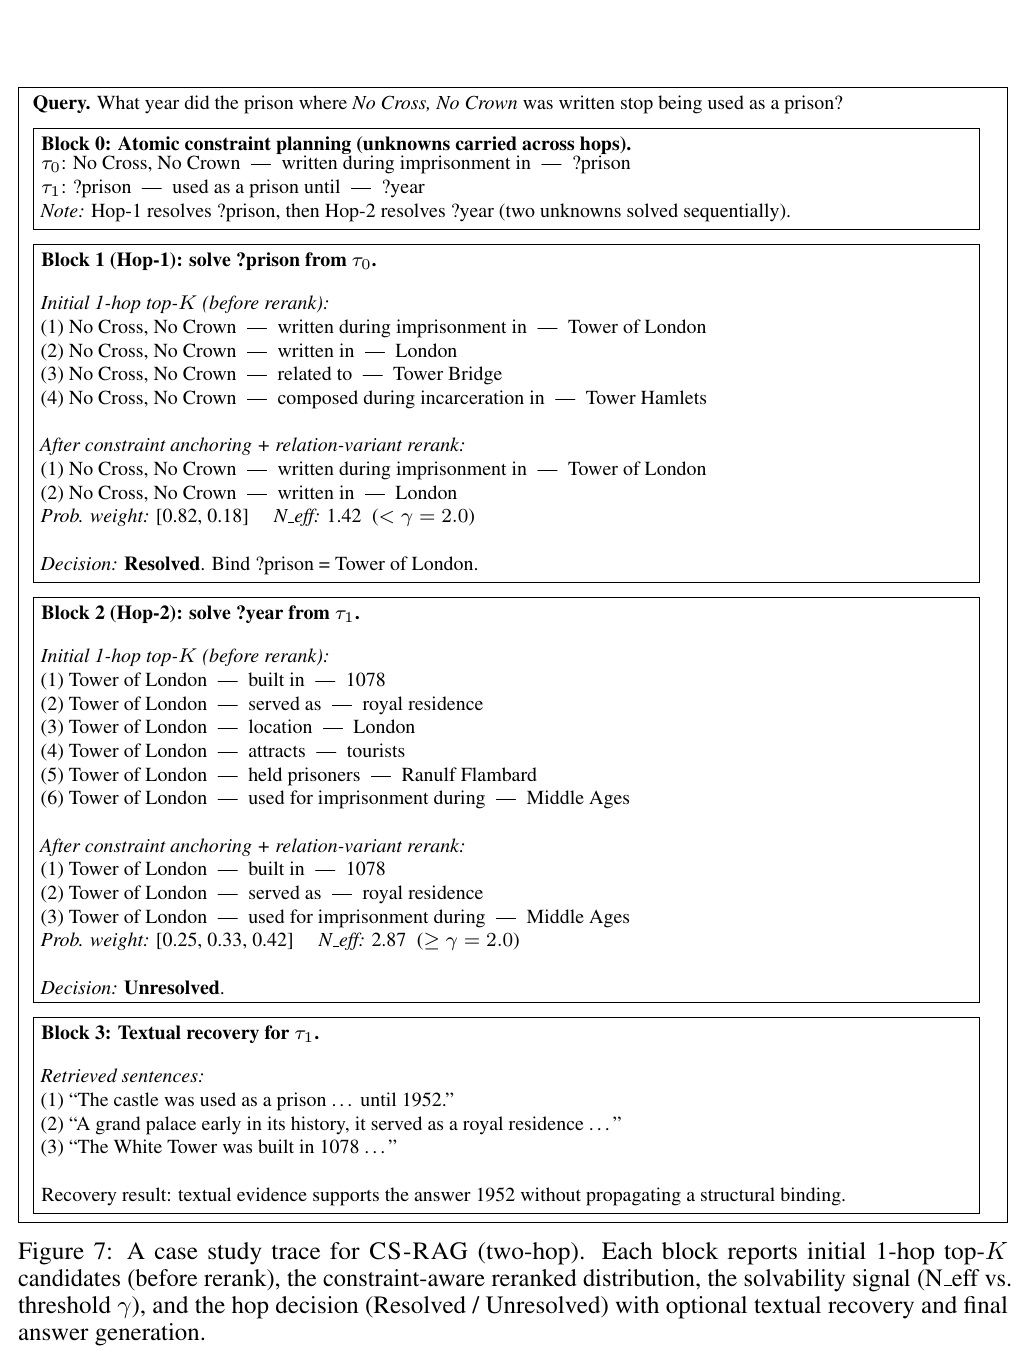
6. Case trace:resolved 传播,unresolved 转文本

Figure 7 的两跳例子说明执行逻辑:第一跳候选集中,$N_{\mathrm{eff}}=1.42<\gamma=2.0$,系统绑定 ?prison = Tower of London;第二跳候选分布不集中,$N_{\mathrm{eff}}=2.87\ge\gamma$,系统不传播结构 binding,而是启动 textual recovery,最终从文本中恢复 1952。

局限与开放问题

  • Planner 仍是前置风险:如果 atomic constraint planning 漏掉 bridge variable 或把 relation 规划错,后续检索会围绕错误目标执行。

  • Textual recovery 依赖 passage pool:如果 KG 缺桥接证据,文本池也没有明确 bridge evidence,CS-RAG 只能阻止错误传播,不能凭空恢复答案。

  • $\gamma$ 需要按数据集/任务调节:MuSiQue、2Wiki、HotpotQA 的最佳 resolved-hop / latency / tokens trade-off 不同。

  • 评测仍集中在 Wikipedia multi-hop QA:对于代码库、表格/公式、医疗、法律或企业 schema 图,需要重新验证 atomic constraint 和 Neff 的适配性。

  • KG repair 没有解决:CS-RAG 是 retrieval-time mitigation,不会从根本上修复抽取器、构图器或长期 graph memory 的错误积累。

  • 代码仓库未声明 license,README 有桌面系统和本地部署说明,但正式复现完整结果仍需进一步跑通。

  • 把 Neff sufficiency 接入 GraphRAG中的停止准则与预算分配形式化:记录每一跳的 $N_{\mathrm{eff}}$、resolved/unresolved、binding precision、text fallback trigger 和最终 answer-used evidence。

  • 和 LogicPoison - Logical Attacks on GraphRAG 对照:测试 CS-RAG 对恶意 entity swapping / path poisoning 是否同样有效,区分自然 imperfect KG 与 adversarial topology attack。

  • 和 DOTRAG - Retrieval-Time Reasoning Along Paths、PRoH - Dynamic Planning over Knowledge Hypergraphs 对照:把 path-level / hyperedge-level sufficiency 变成可学习或可校准的 acceptance criterion。

  • 扩展到 CacheRAG - Semantic Caching for KGQA:缓存的不只是 query plan,还可以缓存 constraint plan、resolved-hop statistics、fallback decision 和 stale-plan failure。

  • 做 sample-level 诊断:把错误拆成 planner error、anchor miss、relation alignment miss、Neff false accept、Neff false reject、text recovery miss、generation error。

  • 用于训练信号:把 support gain、binding precision、unresolved fallback success、retrieval-turn utility 纳入 GraphRAG RL 或 reranker training。

关联与拓展

研究问题入口

Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略, Q6 证据来源与可解释性, Q7 鲁棒性与安全, Q8 效率与部署, Q9 评测与理论
展开原始论文笔记全文

基本信息

  • 英文标题:Toward Robust GraphRAG: Mitigating Retrieval Drift and Hallucination from Imperfect Knowledge Graphs
  • 中文标题:面向鲁棒 GraphRAG:缓解不完美知识图谱导致的检索漂移与检索幻觉
  • 方法名:CS-RAG,Constraint-based and Sufficiency-guided Retrieval Augmented Generation
  • 作者:Yizhuo Ma, Jinchuan Xu, Tao Wen, Qizhi Chen, Jiakai Li, Rongzheng Wang, Muquan Li, Shuang Liang, Ke Qin
  • 年份:2026
  • 会议:arXiv 2026;README 标注为 NeurIPS 2026 submission,正式接收状态待复查
  • 版本:arXiv v2,2026-05-19 更新;初版 2026-03-16
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:https://github.com/myz12138/CS-RAG ,2026-06-09 检查为公开 Python 仓库,默认分支 main,未声明 license
  • Semantic Scholar:2026-06-09 直接查询 arXiv ID 得到 CorpusId 286571523,citationCount 0,venue 为空
  • 阅读状态:PDF级
  • 所属方向:imperfect KG robustness、retrieval drift、retrieval hallucination、atomic constraint planning、Neff sufficiency check、textual recovery
  • 优先级:P1

Background

  • 研究问题:很多 GraphRAG 默认 KG 是可靠的,但实际 LLM 构图会产生错关系、错实体绑定、关系方向翻转、缺桥接边和缺限定信息。这些问题进入多跳检索后,会把检索轨迹带偏,或让系统在结构证据不足时继续传播伪 binding。
  • 为什么重要:GraphRAG 的错误不只来自最终 LLM 幻觉,也可能来自检索阶段对错误 KG 结构的过度信任。若不区分“图里有噪声”和“图里缺证据”,系统会把局部看起来相关的 triple 当作可继续推理的证据。
  • 现有路线:
  • 对本知识库的意义:CS-RAG 把 GraphRAG中的知识图谱噪声传播 从攻击/构图质量扩展到 retrieval-time mitigation:不一定先修 KG,而是在每一跳判断“这个结构 binding 是否足够可靠,可以继续传播”。

CS-RAG-fig1-kg-builder-error-distribution

Figure 1 的关键信号是:不同 LLM builder 都会产生不同比例的错误 tuple;即使强 builder,也不是所有 query-relevant 支持句都能被正确抽取。论文把错误聚合成两类:spurious noise 触发 retrieval drift,incomplete information 触发 retrieval hallucination。

Gap

  • Reliable-KG assumption:多数 GraphRAG 方法默认 KG 足够可靠,只在图上做 PPR、beam search、path reranking 或社区摘要。
  • Coarse semantic matching:如果只看 query-triple 语义相似度,mis-bound relation、over-generalized relation 和 semantic flip 仍可能进入候选池。
  • Forced structural continuation:当 bridge edge 或 qualifier 缺失时,系统仍可能沿弱连接继续传播变量,产生 unsupported binding。
  • KG repair cost high:直接重抽、验证或人工修 KG 成本高,尤其在多 builder、多数据集或本地部署场景中不可持续。
  • Sufficiency not explicit:已有方法常有 stop / fallback 概念,但缺少一个能解释“为什么当前 hop 可以或不可以传播”的候选分布级判据。

Insight

  • 一句话创新点:CS-RAG 不试图先把 KG 修到完美,而是在检索时把问题拆成可执行原子约束,并用 Neff 判断每一跳的结构候选是否足够集中;集中则传播变量,不集中则转入文本恢复。
  • 核心洞察:
    • 漂移来自约束太粗:需要 anchor-aware + relation-aware retrieval,而不是只取语义相关 triple。
    • 幻觉来自传播太早:变量 binding 只有在候选分布出现明显 dominant candidate 时才应进入下一跳。
    • 缺图不等于缺答案:结构证据不足时,可以放弃 structural propagation,但仍用 textual recovery 补证据。
    • 鲁棒性应跨 builder 和 controlled issue injection 同时测:自然 LLM 构图误差和可控错边/断边是两个互补评测口径。

Method

1. 总体框架:Query -> Constraint Plan -> Structured Retrieval -> Sufficiency Decision -> Text Recovery / Binding Propagation

CS-RAG-fig2-workflow-overview

输入:问题 $q$、LLM 构建的知识图谱 $G=(E,R,T)$、query-specific passages $U(q)$、结构候选预算 $K_s$、文本恢复预算 $K_t$、sufficiency threshold $\gamma$。

计算链路:

  1. Atomic Constraint Planning:LLM 把多跳问题规划成有序原子约束:
P=\langle \tau_1,\tau_2,\ldots,\tau_k\rangle,\quad \tau_i=(h_i,r_i,t_i)

其中 $h_i,t_i$ 可以是问题中的常量实体,也可以是中间变量 $V={?v_1,?v_2,\ldots}$。每个约束还生成 relation variants:

R_i=\{r_i^{(1)},\ldots,r_i^{(m)}\}
  1. Constraint-based Retrieval:先执行只有一个未知变量的约束:
P_1=\{\tau_i=(h_i,r_i,t_i)\in P\mid |\{h_i,t_i\}\cap V|=1\}
  1. Sufficiency-Guided Propagation and Recovery:对每个约束的 refined candidate pool 判断是否足够支持变量 binding。
  2. LLM Generation:把 resolved structural evidence 和 unresolved textual evidence 组织成 constraint-aligned context,生成答案。

输出:最终答案、每个原子约束的 resolved / unresolved 状态、变量 binding、结构证据、文本恢复证据。

直观解释:CS-RAG 把 GraphRAG 的多跳检索从“沿图走”改成“逐条执行约束”。每一跳必须先证明结构候选足够集中,才允许把变量带到下一跳。

2. Atomic Constraint Planning:把问题转成带变量的可执行约束

输入:自然语言问题 $q$。

计算链路:

  1. 抽出 query entities $E_q$ 和中间变量 $V$。
  2. 生成 ordered constraints $P$,每个 constraint 是一个 triple pattern。
  3. 为每个 relation 生成多个语义变体 $R_i$,作为后续 relation alignment 的目标。

输出:原子约束序列 $P$ 和 relation variants ${R_i}$。

直观解释:planner 的作用不是直接回答,也不是直接检索文本,而是把多跳问题变成一组可以在 KG 中逐步执行的结构约束。

3. Anchor Matching + Relation Alignment + Contextual Reranking

输入:单变量约束 $\tau_i\in P_1$、anchor surface $e_i^{surf}$、KG triple set $T$、relation variants $R_i$。

计算链路:

  1. Anchor Matching:用 top-3 token-coverage matching 把 $e_i^{surf}$ 映射到 KG anchor nodes $E_i^{anchor}$。
  2. One-hop Enumeration:从 anchor nodes 枚举一跳邻域,形成候选池 $C_i$。
  3. Relation Alignment:比较候选 triple 的 KG relation 和 $R_i$,保留 top-$R$ relation-aligned candidates,得到 $C_i^{init}$。
  4. Contextual Reranking:cross-encoder 输入 query、linearized constraint 和 candidate triple,得到分数 $z_{i,c}$,保留 top-$K_s$:
C_i^{top}=\operatorname{TopK}_{K_s}\{c\in C_i^{init};\ z_{i,c}\}

输出:当前约束的 refined structural candidate pool $C_i^{top}$。

直观解释:这一步防 retrieval drift。候选不仅要连到 anchor,还要满足当前 hop 的 relation semantics;否则只是实体相关,不能算 constraint-compatible evidence。

4. Neff Sufficiency Check:只传播足够集中的结构 binding

输入:候选池 $C_i^{top}$ 和 cross-encoder 分数 ${z_{i,c}}$。

计算链路:

  1. 对候选分数做 softmax:
p_{i,c}=\frac{\exp(z_{i,c})}{\sum_{c'\in C_i^{top}}\exp(z_{i,c'})}
  1. 计算 effective number of candidates:
N_{\mathrm{eff}}(\tau_i)=\frac{1}{\sum_{c\in C_i^{top}}p_{i,c}^{2}}
  1. 用阈值 $\gamma$ 判断状态:
\operatorname{State}(\tau_i)= \begin{cases} \text{Resolved}, & N_{\mathrm{eff}}(\tau_i)\le \gamma\\ \text{Unresolved}, & N_{\mathrm{eff}}(\tau_i)>\gamma \end{cases}
  1. 论文附录给出解释:若 $N_{\mathrm{eff}}(\tau_i)\le\gamma$,则 top candidate 概率满足:
\max_{c\in C_i^{top}}p_{i,c}\ge\frac{1}{\gamma}

输出:resolved constraints $P_R$ 和 unresolved constraints $P_U$。

直观解释:$N_{\mathrm{eff}}$ 小表示候选分布集中,有一个明显赢家;$N_{\mathrm{eff}}$ 大表示多个候选竞争,直接传播变量容易把错误结构带入下一跳。

5. Binding Propagation:resolved 才能进入下一跳

输入:resolved constraint $\tau_i\in P_R$ 和 $C_i^{top}$。

计算链路:

  1. 从候选 triple 的变量端抽 induced entity set:
E_i(v)=\{e\mid e\text{ is the variable endpoint in }C_i^{top}\}
  1. 如果同一变量出现在多个 resolved constraints 中,优先取交集,交集为空时退化为并集:
E_b(v)= \begin{cases} \bigcap_i E_i(v), & \bigcap_i E_i(v)\neq\varnothing\\ \bigcup_i E_i(v), & \text{otherwise} \end{cases}
  1. 用 $E_b(v)$ 过滤结构候选,并把该变量实例化为后续双变量约束的 anchor。
  2. 对双变量约束 $P_2$,若其中一个变量已被绑定,则转成单变量约束,重复 constraint retrieval 和 sufficiency check。

输出:稳定变量 binding、更新后的结构证据池、可继续执行的后续约束。

直观解释:CS-RAG 的传播不是“拿 top-1 就走”,而是只有 resolved hop 才能把变量值带到后续约束,减少因缺边或错边造成的结构幻觉。

6. Textual Recovery:unresolved 不传播结构,但补文本证据

输入:unresolved constraint $\tau_u\in P_U$、query-specific passages $U(q)$。

计算链路:

  1. 用 linearized constraint 和 passage 做语义检索,取 top-$K_t'$。
  2. cross-encoder rerank query、constraint 和 passage。
  3. 保留 top-$K_t$ 作为补充文本证据:
T_u^{txt}=\operatorname{TopK}_{K_t}\{p\in U(q)\}

输出:未解析约束的文本恢复证据。

直观解释:这一步防 retrieval hallucination。系统承认当前 KG 结构不足,不把不可靠 binding 继续传播,但仍尝试从原文中恢复 missing bridge / dropped qualifier。

Results

1. 跨 KG builder 鲁棒性

CS-RAG-table1-builder-robustness

Table 1 的核心结论是:CS-RAG 在 MuSiQue、2Wiki 和 HotpotQA 上都取得最高 cross-builder average,并且标准差很低。例如平均 F1 分别为 MuSiQue 44.1、2Wiki 70.4、HotpotQA 68.7;对应 std 为 1.3、1.0、1.5。这说明 CS-RAG 对 KG builder 质量差异不那么敏感。

2. 受控 KG issue injection

CS-RAG-fig3-controlled-issue-injection

Figure 3 把问题注入分成 query-centric / whole-KG 两种范围,以及 spurious noise / incomplete information 两种类型。随着 issue ratio $\rho$ 从 0.1 到 0.5 增加,基线 F1 明显下降,而 CS-RAG 曲线基本稳定。这个实验直接支持“constraint retrieval 防 drift,sufficiency + textual recovery 防 hallucinated continuation”。

3. 消融:planner、relation alignment、sufficiency check 都不可替代

CS-RAG-table2-ablation

Table 2 显示在 HotpotQA 上,去掉 Planner、Relation、Constraint、Check、Dist 都会下降。w/o Planner 下降最大,说明原始 query 不能替代 hop-wise constraints;w/o Check 会强制传播不可靠结构候选,说明 sufficiency check 是防 retrieval hallucination 的关键。

4. $\gamma$ 是结构传播与文本恢复的成本-质量旋钮

CS-RAG-table3-gamma-sensitivity

Table 3 显示 $\gamma$ 越大,resolved-hop rate 越高,latency 和最终上下文 tokens 越低;但过大的 $\gamma$ 会让弱 binding 更容易被接受。MuSiQue 更偏向小 $\gamma$ 和更多 textual recovery;2Wiki 在中等 $\gamma$ 处达到更好 trade-off;HotpotQA 也体现准确率-成本折中。

5. Sufficiency check 的正确性与效率边界

CS-RAG-table7-table8-sufficiency-efficiency

Table 7 显示 weaker builders 的 resolved-hop rate 更低,但 resolved 后的 binding precision 仍较高,说明 Neff 能过滤不确定结构候选。Table 8 显示 CS-RAG 引入 one-shot planning token cost,但没有像多轮 LLM-guided traversal 那样反复调用;在 GPT-4o-mini KG 上,MuSiQue / 2Wiki / HotpotQA 的 retrieval-time tokens 约为 0.86k / 0.72k / 0.76k。

6. Case trace:resolved 传播,unresolved 转文本

CS-RAG-fig7-case-trace

Figure 7 的两跳例子说明执行逻辑:第一跳候选集中,$N_{\mathrm{eff}}=1.42<\gamma=2.0$,系统绑定 ?prison = Tower of London;第二跳候选分布不集中,$N_{\mathrm{eff}}=2.87\ge\gamma$,系统不传播结构 binding,而是启动 textual recovery,最终从文本中恢复 1952。

Limitations

  • Planner 仍是前置风险:如果 atomic constraint planning 漏掉 bridge variable 或把 relation 规划错,后续检索会围绕错误目标执行。
  • Textual recovery 依赖 passage pool:如果 KG 缺桥接证据,文本池也没有明确 bridge evidence,CS-RAG 只能阻止错误传播,不能凭空恢复答案。
  • $\gamma$ 需要按数据集/任务调节:MuSiQue、2Wiki、HotpotQA 的最佳 resolved-hop / latency / tokens trade-off 不同。
  • 评测仍集中在 Wikipedia multi-hop QA:对于代码库、表格/公式、医疗、法律或企业 schema 图,需要重新验证 atomic constraint 和 Neff 的适配性。
  • KG repair 没有解决:CS-RAG 是 retrieval-time mitigation,不会从根本上修复抽取器、构图器或长期 graph memory 的错误积累。
  • 代码仓库未声明 license,README 有桌面系统和本地部署说明,但正式复现完整结果仍需进一步跑通。

Future Directions

  • 把 Neff sufficiency 接入 GraphRAG中的停止准则与预算分配形式化:记录每一跳的 $N_{\mathrm{eff}}$、resolved/unresolved、binding precision、text fallback trigger 和最终 answer-used evidence。
  • 和 LogicPoison - Logical Attacks on GraphRAG 对照:测试 CS-RAG 对恶意 entity swapping / path poisoning 是否同样有效,区分自然 imperfect KG 与 adversarial topology attack。
  • 和 DOTRAG - Retrieval-Time Reasoning Along Paths、PRoH - Dynamic Planning over Knowledge Hypergraphs 对照:把 path-level / hyperedge-level sufficiency 变成可学习或可校准的 acceptance criterion。
  • 扩展到 CacheRAG - Semantic Caching for KGQA:缓存的不只是 query plan,还可以缓存 constraint plan、resolved-hop statistics、fallback decision 和 stale-plan failure。
  • 做 sample-level 诊断:把错误拆成 planner error、anchor miss、relation alignment miss、Neff false accept、Neff false reject、text recovery miss、generation error。
  • 用于训练信号:把 support gain、binding precision、unresolved fallback success、retrieval-turn utility 纳入 GraphRAG RL 或 reranker training。

与本知识库的连接

一句话定位

CS-RAG 是一篇把 GraphRAG 鲁棒性从“修图/防攻击”推进到“检索时约束执行 + 每跳 sufficiency 决策”的论文:结构证据够集中才传播变量,不够则转文本恢复,从而同时缓解 imperfect KG 上的 retrieval drift 和 retrieval hallucination。