GGraphRAG 文献图谱自动同步
LIT-8648CB92 · 2026

LogicPoison - Logical Attacks on GraphRAG

LogicPoison 用“同类型实体循环置换”重写语料,使 GraphRAG 构建出的图拓扑被隐式污染,从而破坏多跳推理链,而不改变查询和 ground truth。

PDF 级阅读卡优先级 P1Yilin Xiao, Jin Chen, Qinggang Zhang, Yujing Zhang, Chuang Zhou, Longhao Yang, Lingfei Ren, Xin Yang, Xiao Huang发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:GraphRAG 通过实体抽取、关系过滤、图遍历和多跳 reasoning 提升 RAG 的结构化推理能力。但这种结构化 pipeline 也会让系统依赖隐式图拓扑:如果攻击者不注入明显恶意文本,而是悄悄改写实体间的逻辑连接,GraphRAG 可能沿着错误路径给出自信但错误的答案。
  • 为什么重要:传统 RAG 攻击通常依赖 malicious documents、prompt injection、GCG 或 disinformation。这些攻击在 GraphRAG 中会被图构建阶段过滤一部分,因为图构建会抽取实体和关系,而不是直接把整段文本交给生成模型。
  • 对本知识库的意义:这篇论文把 GraphRAG中的知识图谱噪声传播 中的“错边/漏边”升级为主动攻击问题:攻击者可以保持文本表面流畅,却重排图的桥接节点和 hub,使 GraphRAG的鲁棒性框架 必须覆盖 topology-level poisoning。

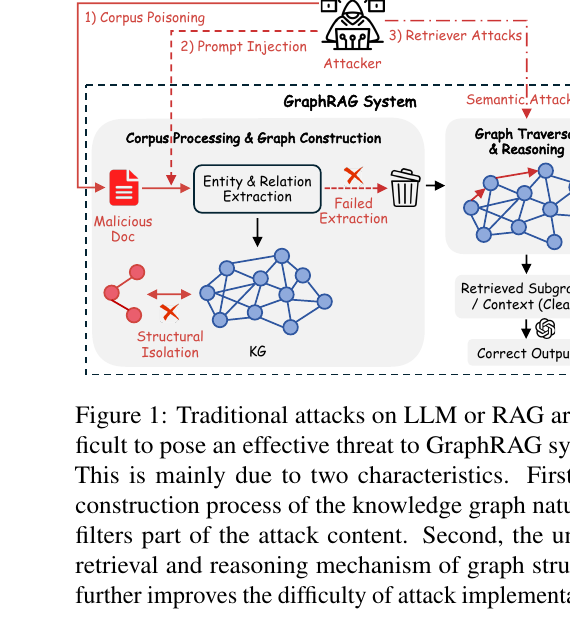
Figure 1 的关键点是:普通语义攻击容易在 corpus processing / graph construction 阶段被过滤;LogicPoison 不直接制造可见恶意内容,而是让构建出的 KG 在拓扑上被重连。

  • 现有 RAG poisoning 主要攻击文本内容或 prompt,目标是让恶意内容被检索到;但 GraphRAG 会通过实体抽取和关系过滤削弱这类攻击。
  • 现有 GraphRAG 鲁棒性讨论常把图错误当成自然噪声,例如抽取错误、chunk 边界漏边、实体链接错误;但缺少面向图拓扑的主动攻击框架。
  • 传统文本异常检测依赖 perplexity、语义突兀或插入文本长度。LogicPoison 的 type-preserving entity swapping 不注入额外文本,因此更隐蔽。
  • 多跳 QA 对 bridge entities 和 hub entities 高度敏感;只要关键桥接实体被替换,最终 retrieval path 可能仍然语法合理,却已经不再支持 ground truth。

方法与机制

1. 总体框架:选择目标实体 -> 同类型交换 -> 隐式污染图

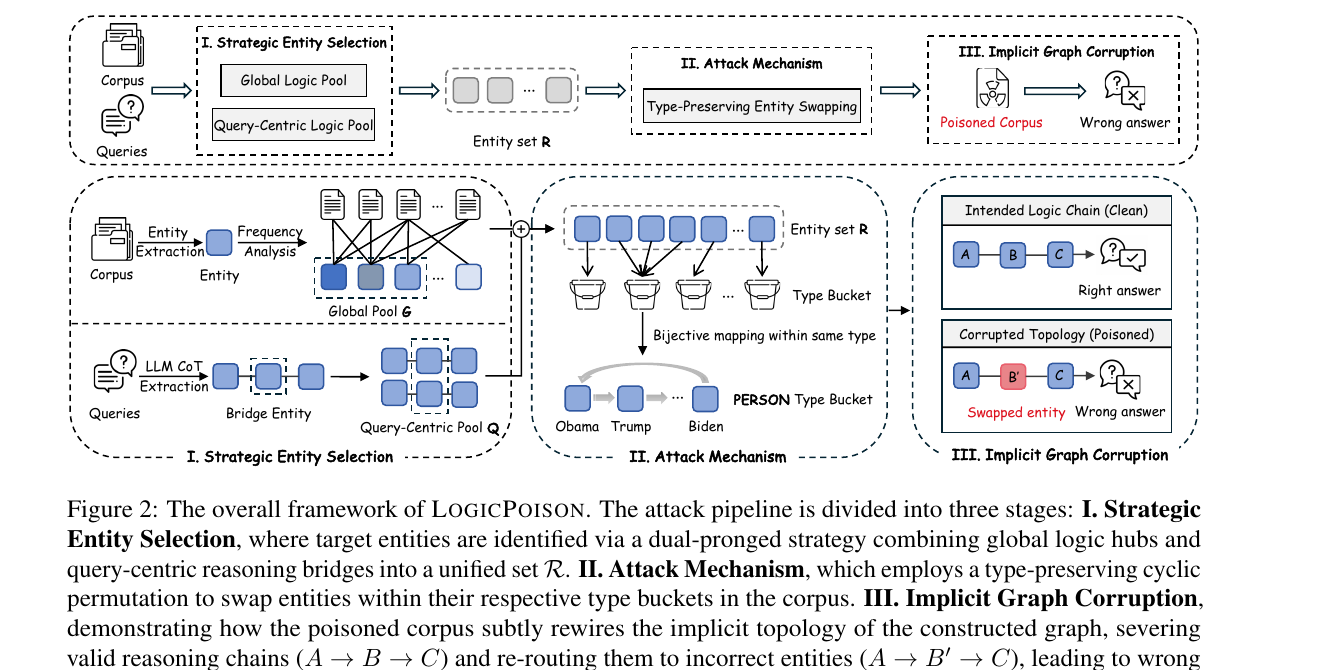
Figure 2 把 LogicPoison 分成三段:

  1. Strategic Entity Selection:从语料和 query 中选出全局 hub 与 query-specific bridge。
  2. Attack Mechanism:在同一实体类型桶内做 type-preserving entity swapping。
  3. Implicit Graph Corruption:文本仍然可读,但 GraphRAG 构建出的推理路径从 clean chain 变成 poisoned topology。

攻击目标不是改 query,也不是改 ground-truth answer,而是得到 poisoned corpus:

C \rightarrow \tilde{C}

当 GraphRAG 在 $\tilde{C}$ 上构建索引时,原本的正确路径:

A \rightarrow B \rightarrow C

会被重路由为:

A \rightarrow B' \rightarrow C

于是系统仍然能检索到“看似相关”的路径,但桥接实体已经被替换,答案会偏向错误结论。

2. Global Logic Poison:攻击语料级 hub

GraphRAG 往往依赖中心实体连接不同文档片段。LogicPoison 先对每篇文档 $d_i$ 做 typed entity extraction:

E(d_i)=\{(e,\tau)\mid e\in V_{vocab},\tau\in T\}

其中 $e$ 是实体 surface form,$\tau$ 是类型,例如 PERSON、ORG、DATE。

然后用文档频次近似实体的拓扑重要性:

f(e,\tau)=\sum_{i=1}^{N}\mathbb{I}[(e,\tau)\in E(d_i)]

在每个类型 $\tau$ 内选择 top-$n%$ 高频实体作为 global replacement pool:

G_\tau=\{e\mid type(e)=\tau \land rank(f(e,\tau))\le n\%\}

直觉:GraphRAG 构建 KG 前拿不到真实 degree,但在 co-occurrence 图中,高频实体通常更接近 hub。攻击这些实体可以用较小预算扰动全局信息传播。

3. Query-Centric Logic Poison:攻击问题级桥接实体

仅攻击全局 hub 可能漏掉长尾但关键的推理桥。LogicPoison 进一步用 LLM CoT 从 query 中抽取 reasoning-critical entities:

E_q=\{(e,\tau,r)\}

其中 $r$ 表示实体在推理链中的作用。为了避免 LLM 幻觉不存在的攻击目标,论文用语料频次过滤:

E_q^{corpus}=\{(e,\tau)\mid (e,\tau,r)\in E_q \land f(e,\tau)>0\}

再聚合得到 query-centric replacement pool:

Q_\tau=\bigcup_{q\in Q}\{e\mid (e,\tau)\in E_q^{corpus}\}

这一步保证:如果 GraphRAG 正确沿着原始问题所需的 reasoning chain 检索,它就会经过被攻击的桥接实体。

4. Type-Preserving Entity Swapping:同类型循环置换

统一目标集合:

R_\tau=G_\tau\cup Q_\tau,\quad R=\bigcup_{\tau\in T}R_\tau

对每个实体类型 $\tau$,把目标实体排成序列:

S_\tau=[e_1,e_2,\ldots,e_m]

定义循环置换:

\pi_\tau(e_i)= \begin{cases} e_{i-1}, & 1<i\le m\\ e_m, & i=1 \end{cases}

这样每个实体都被同类型实体替换,映射是 bijective / invertible。最后对语料中所有 $e\in R_\tau$ 做替换:

e \mapsto \pi_\tau(e)

攻击后的 $\tilde{C}$ 不插入新恶意文档,也不改变 query 和 gold answer。它改变的是 GraphRAG 从文本中抽取出的实体关系网络。

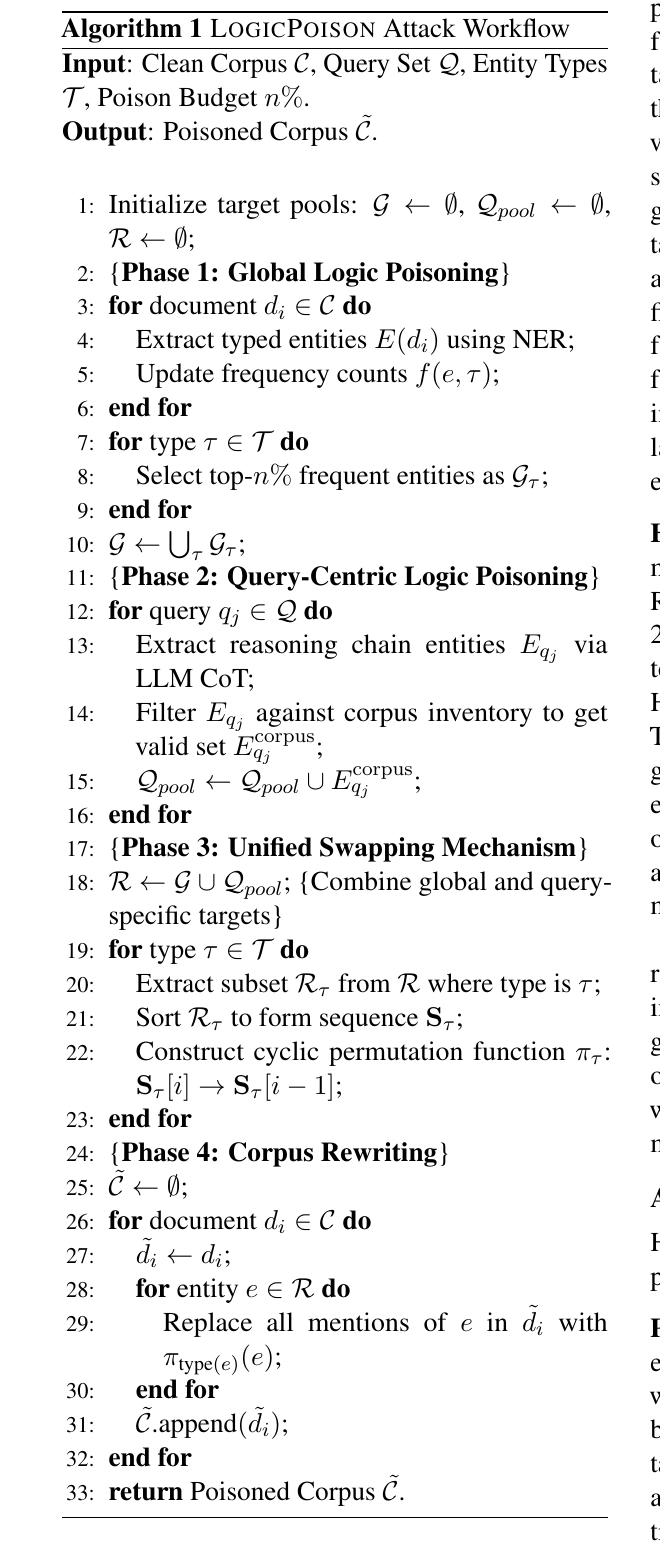
Algorithm 1 说明完整执行流程:先抽取全局高频实体,再抽取 query-centric bridge entities,合并为统一目标集合,按类型构造循环置换,最后重写 corpus。

证据与结果

1. 主结果:LogicPoison 在 GraphRAG 上显著强于 PoisonedRAG

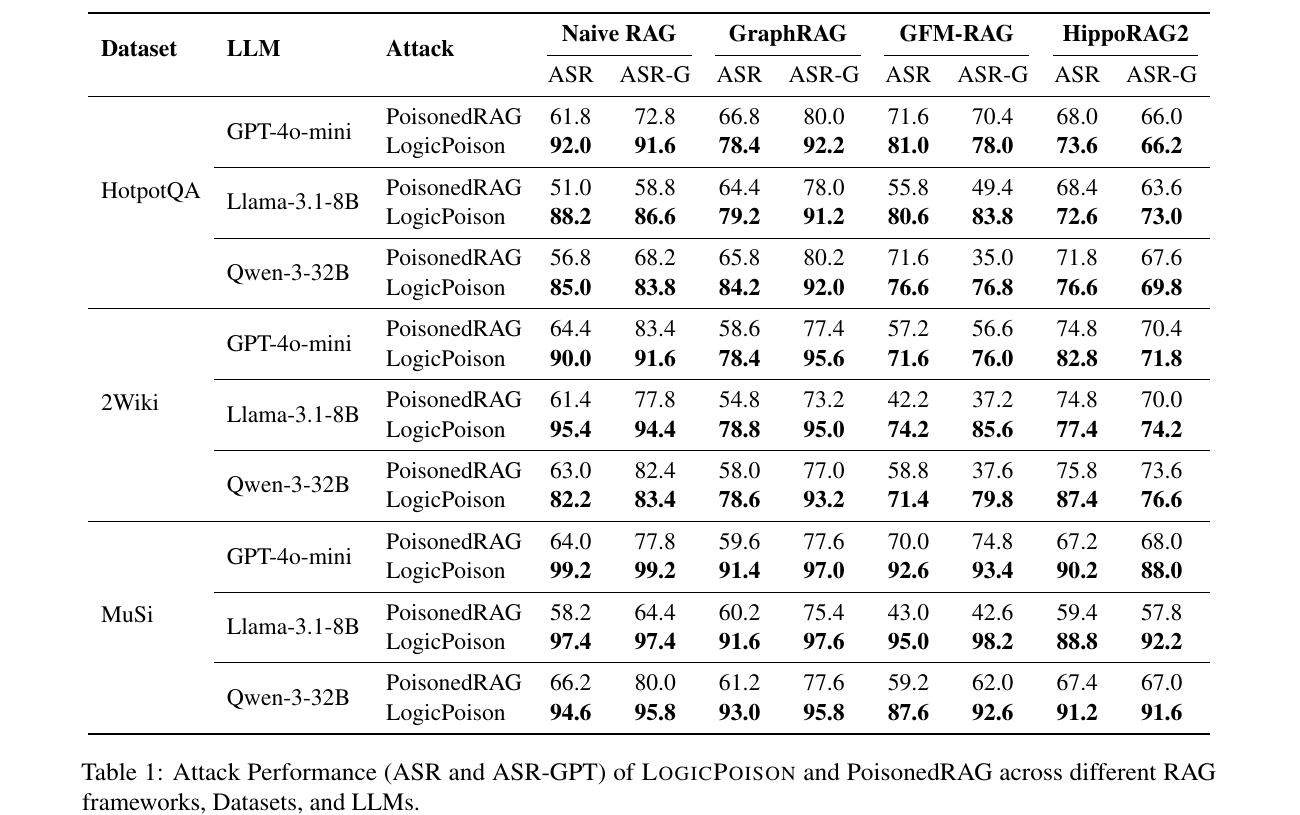
论文在 HotpotQA、2WikiMultiHopQA、MuSiQue 上评估 Naive RAG、Microsoft GraphRAG、GFM-RAG、HippoRAG2,并使用 GPT-4o-mini、Llama-3.1-8B、Qwen-3-32B 三个 backbone。

指标:

  • ASR:基于 substring inclusion 的攻击成功率。
  • ASR-G / ASR-GPT:用 LLM judge 判断预测是否与 ground truth 语义等价后的攻击成功率。

Table 1 的关键数字:

  • HotpotQA + GraphRAG:LogicPoison ASR-G 约 91.2-92.2,明显高于 PoisonedRAG 的 78.0-80.2。
  • 2Wiki + GraphRAG:LogicPoison ASR-G 约 93.2-95.6,高于 PoisonedRAG 的 73.2-77.4。
  • MuSiQue + GraphRAG:LogicPoison ASR 91.4 / 91.6 / 93.0,ASR-G 97.0 / 97.6 / 95.8,说明深层多跳任务尤其脆弱。
  • 在 GFM-RAG、HippoRAG2 上,LogicPoison 也普遍强于 PoisonedRAG,表明可学习图检索和 PPR 式检索也不能天然抵抗拓扑污染。

解读:GraphRAG 的结构化检索会削弱显式内容投毒,但会放大拓扑级错误。越依赖多跳桥接,越可能被实体交换破坏。

2. 与传统攻击相比:逻辑拓扑攻击更适合 GraphRAG

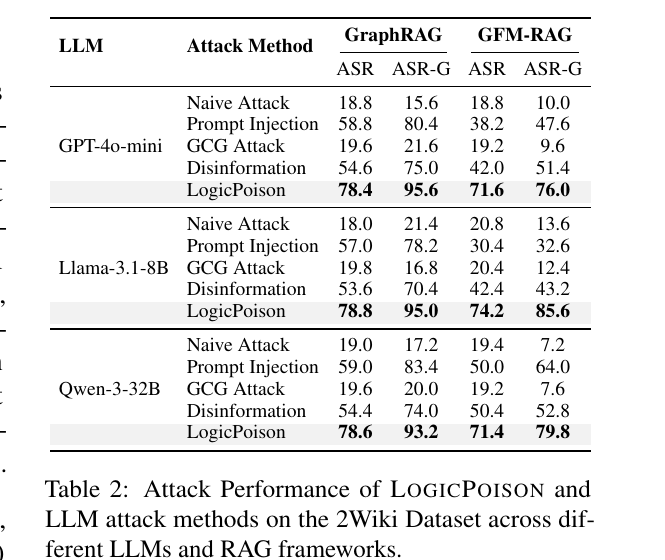
Table 2 在 2Wiki 上比较 Naive Attack、Prompt Injection、GCG、Disinformation 和 LogicPoison:

  • GPT-4o-mini + GraphRAG:LogicPoison ASR-G 95.6;Prompt Injection 80.4;Disinformation 75.0;Naive/GCG 约 15.6-21.6。
  • Llama-3.1-8B + GFM-RAG:LogicPoison ASR-G 85.6,高于传统攻击。
  • Qwen-3-32B + GraphRAG:LogicPoison ASR-G 93.2,高于 Prompt Injection 的 83.4。

解读:Prompt Injection 和 Disinformation 仍有一定效果,但它们攻击的是文本内容;GraphRAG 会在图构建阶段过滤一部分攻击信号。LogicPoison 攻击的是图构建后的逻辑路径,因此更稳定。

3. 效率与隐蔽性:更快、更少 token、零注入文本

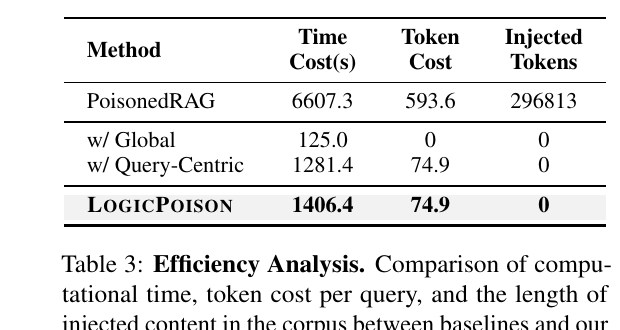
Table 3 的关键数字:

  • PoisonedRAG:6607.3s,593.6 token cost,296813 injected tokens。
  • Global only:125.0s,0 token cost,0 injected tokens。
  • Query-Centric only:1281.4s,74.9 token cost,0 injected tokens。
  • LogicPoison full:1406.4s,74.9 token cost,0 injected tokens。

解读:

  • Global phase 只依赖轻量 NER 和频次统计,几乎不需要 LLM。
  • Query-centric phase 需要 LLM 抽取 reasoning-critical entities,但总成本仍远低于 PoisonedRAG。
  • 不注入额外文本意味着攻击面更隐蔽:检测系统很难通过异常长恶意片段或 prompt 模式发现污染。

4. 消融:Global 与 Query-Centric 互补

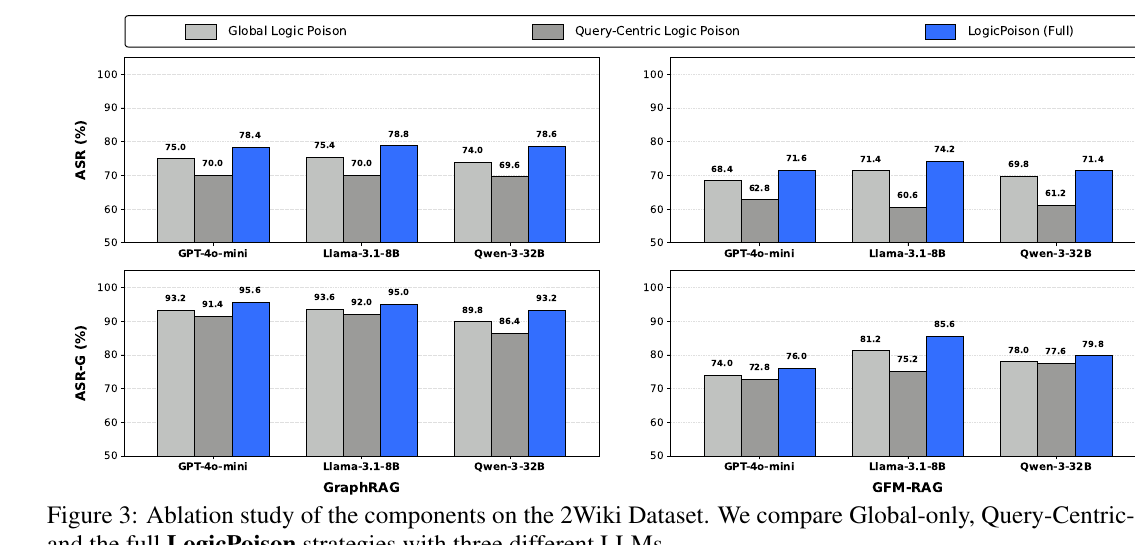
Figure 3 在 2Wiki 上比较 Global-only、Query-Centric-only 和 Full LogicPoison:

  • Global Logic Poison 破坏全局 hub,适合低成本、无 query 或 query 很少的场景。
  • Query-Centric Logic Poison 针对特定问题的 bridge entity,能切断 query-specific reasoning chain。
  • Full LogicPoison 通常最高,因为它同时破坏全局连接和局部推理路径。

对本知识库的启发:GraphRAG 鲁棒性不能只测随机边噪声。需要分别测 hub perturbation、bridge perturbation、query-specific path perturbation。

5. 防御:Query Paraphrasing 几乎无效

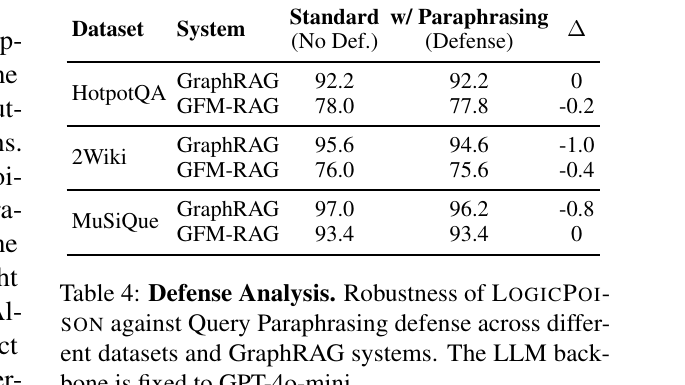
Table 4 显示 query paraphrasing 后攻击成功率下降很小:

  • HotpotQA + GraphRAG:92.2 -> 92.2。
  • 2Wiki + GraphRAG:95.6 -> 94.6。
  • MuSiQue + GraphRAG:97.0 -> 96.2。
  • 所有下降不超过 1.0。

原因:paraphrasing 改变句子表面形式,但问题核心语义和 reasoning-critical entities 不变。LogicPoison 已经污染了语料和图拓扑,重写 query 不能恢复 clean graph。

6. PPL 检测:接近随机

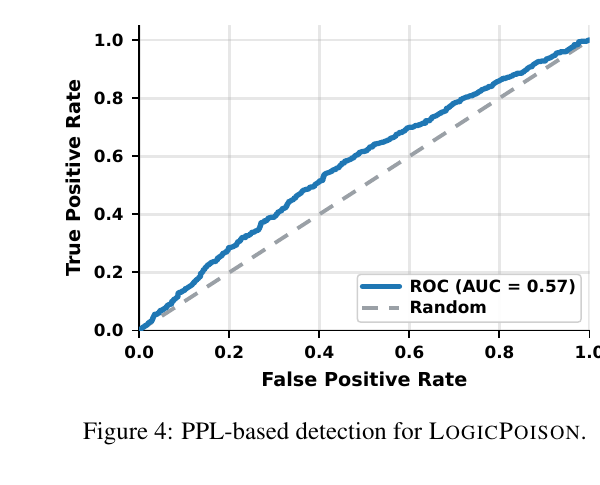
Figure 4 的 PPL-based detection AUC = 0.57,接近随机猜测 0.5。

解读:

  • Type-preserving swapping 保持实体类型一致,句法和流畅性不会明显破坏。
  • 攻击文本不是“低质量生成文本”,而是把原文中的实体做同类替换。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

局限与开放问题

  • 攻击假设攻击者能修改 corpus 或其进入索引前的文本版本;如果语料有强完整性校验、签名或审计日志,攻击空间会下降。

  • Query-centric phase 需要 query set 或代表性问题。如果实际用户问题分布变化很大,预先选择的 bridge entities 可能覆盖不足。

  • 实验集中在 HotpotQA、2Wiki、MuSiQue 这类开放域多跳 QA;法律、医疗、企业 schema、代码图等强 schema 场景仍需验证。

  • 论文主要展示攻击成功率和成本,没有给出系统级防御框架,例如 graph integrity verification、entity-swap detection、path consistency checking。

  • Type-preserving swapping 保持局部可读性,但可能在高度专业语料中制造领域知识不一致;这类不一致是否能被 domain verifier 捕捉,还需要实验。

  • 该工作偏攻击诊断,对正常数据演化和恶意逻辑污染的区分还不充分。真实系统中,图结构变化不一定都是攻击,也可能来自新知识更新。

  • 作者方向:

    • 继续扩展 GraphRAG 安全研究,把攻击从显式文本注入转向逻辑拓扑破坏。
    • 研究更有效的检测与防御机制,尤其是对 type-preserving entity swapping 的识别。
    • 扩大 GraphRAG 方法和数据集范围,测试不同图构建和检索范式的脆弱性。
  • Agent 推断的 Research Opportunities:

    • Graph topology integrity benchmark:构造 clean / poisoned corpus 对,记录 hub perturbation、bridge perturbation、path perturbation 对 FR@K、support-set completion、answer EM/F1 的影响。
    • Path consistency verifier:对检索路径中的实体类型、关系语义、source citation 和 ground-truth support 做一致性检查,识别“表面通顺但路径断裂”的证据链。
    • Entity-swap detector:利用实体共现、领域约束、temporal consistency、schema constraints 检测同类型实体循环置换。
    • Robust graph construction:在建图阶段保存 provenance、document signature、entity canonicalization history,避免污染文本静默进入 KG。
    • 和 GraphSteal - Structural Knowledge Stealing from GraphRAG 合并成双重安全评测:LogicPoison 测“外部能否污染图”,GraphSteal 测“外部能否重构图”。
    • 和 LegalGraphRAG - Multi-Agent GraphRAG for Reliable Legal Reasoning 的 Auditor 思路结合:把 evidence applicability verification 扩展为 graph-path applicability verification。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:LogicPoison: Logical Attacks on Graph Retrieval-Augmented Generation
  • 中文标题:LogicPoison:面向 GraphRAG 的逻辑攻击
  • 作者:Yilin Xiao, Jin Chen, Qinggang Zhang, Yujing Zhang, Chuang Zhou, Longhao Yang, Lingfei Ren, Xin Yang, Xiao Huang
  • 机构:Southwestern University of Finance and Economics; The Hong Kong Polytechnic University
  • 年份:2026
  • 版本:arXiv v1,2026-04-03
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:Jord8061/logicPoison
  • 阅读状态:PDF级
  • 所属方向:GraphRAG security、logical poisoning、topology robustness、entity swapping attack
  • 优先级:P1

Background

  • 研究问题:GraphRAG 通过实体抽取、关系过滤、图遍历和多跳 reasoning 提升 RAG 的结构化推理能力。但这种结构化 pipeline 也会让系统依赖隐式图拓扑:如果攻击者不注入明显恶意文本,而是悄悄改写实体间的逻辑连接,GraphRAG 可能沿着错误路径给出自信但错误的答案。
  • 为什么重要:传统 RAG 攻击通常依赖 malicious documents、prompt injection、GCG 或 disinformation。这些攻击在 GraphRAG 中会被图构建阶段过滤一部分,因为图构建会抽取实体和关系,而不是直接把整段文本交给生成模型。
  • 对本知识库的意义:这篇论文把 GraphRAG中的知识图谱噪声传播 中的“错边/漏边”升级为主动攻击问题:攻击者可以保持文本表面流畅,却重排图的桥接节点和 hub,使 GraphRAG的鲁棒性框架 必须覆盖 topology-level poisoning。

LogicPoison-fig1-attack-difficulty

Figure 1 的关键点是:普通语义攻击容易在 corpus processing / graph construction 阶段被过滤;LogicPoison 不直接制造可见恶意内容,而是让构建出的 KG 在拓扑上被重连。

Gap

  • 现有 RAG poisoning 主要攻击文本内容或 prompt,目标是让恶意内容被检索到;但 GraphRAG 会通过实体抽取和关系过滤削弱这类攻击。
  • 现有 GraphRAG 鲁棒性讨论常把图错误当成自然噪声,例如抽取错误、chunk 边界漏边、实体链接错误;但缺少面向图拓扑的主动攻击框架。
  • 传统文本异常检测依赖 perplexity、语义突兀或插入文本长度。LogicPoison 的 type-preserving entity swapping 不注入额外文本,因此更隐蔽。
  • 多跳 QA 对 bridge entities 和 hub entities 高度敏感;只要关键桥接实体被替换,最终 retrieval path 可能仍然语法合理,却已经不再支持 ground truth。

Insight

  • 一句话创新点:LogicPoison 用“同类型实体循环置换”重写语料,使 GraphRAG 构建出的图拓扑被隐式污染,从而破坏多跳推理链,而不改变查询和 ground truth。
  • 核心洞察:
    • GraphRAG 的脆弱点不是只在生成模型,而在 corpus -> KG -> traversal 的拓扑依赖。
    • 高频实体近似图 hub,攻击它们可以破坏全局结构。
    • 查询 reasoning chain 中的 bridge entities 是局部推理瓶颈,攻击它们可以切断特定问题的证据链。
    • 只在同类型实体内交换,例如 PERSON 换 PERSON、ORG 换 ORG,可以保持文本流畅,绕过 PPL 或语法异常检测。

Method

1. 总体框架:选择目标实体 -> 同类型交换 -> 隐式污染图

LogicPoison-fig2-framework

Figure 2 把 LogicPoison 分成三段:

  1. Strategic Entity Selection:从语料和 query 中选出全局 hub 与 query-specific bridge。
  2. Attack Mechanism:在同一实体类型桶内做 type-preserving entity swapping。
  3. Implicit Graph Corruption:文本仍然可读,但 GraphRAG 构建出的推理路径从 clean chain 变成 poisoned topology。

攻击目标不是改 query,也不是改 ground-truth answer,而是得到 poisoned corpus:

C \rightarrow \tilde{C}

当 GraphRAG 在 $\tilde{C}$ 上构建索引时,原本的正确路径:

A \rightarrow B \rightarrow C

会被重路由为:

A \rightarrow B' \rightarrow C

于是系统仍然能检索到“看似相关”的路径,但桥接实体已经被替换,答案会偏向错误结论。

2. Global Logic Poison:攻击语料级 hub

GraphRAG 往往依赖中心实体连接不同文档片段。LogicPoison 先对每篇文档 $d_i$ 做 typed entity extraction:

E(d_i)=\{(e,\tau)\mid e\in V_{vocab},\tau\in T\}

其中 $e$ 是实体 surface form,$\tau$ 是类型,例如 PERSON、ORG、DATE。

然后用文档频次近似实体的拓扑重要性:

f(e,\tau)=\sum_{i=1}^{N}\mathbb{I}[(e,\tau)\in E(d_i)]

在每个类型 $\tau$ 内选择 top-$n%$ 高频实体作为 global replacement pool:

G_\tau=\{e\mid type(e)=\tau \land rank(f(e,\tau))\le n\%\}

直觉:GraphRAG 构建 KG 前拿不到真实 degree,但在 co-occurrence 图中,高频实体通常更接近 hub。攻击这些实体可以用较小预算扰动全局信息传播。

3. Query-Centric Logic Poison:攻击问题级桥接实体

仅攻击全局 hub 可能漏掉长尾但关键的推理桥。LogicPoison 进一步用 LLM CoT 从 query 中抽取 reasoning-critical entities:

E_q=\{(e,\tau,r)\}

其中 $r$ 表示实体在推理链中的作用。为了避免 LLM 幻觉不存在的攻击目标,论文用语料频次过滤:

E_q^{corpus}=\{(e,\tau)\mid (e,\tau,r)\in E_q \land f(e,\tau)>0\}

再聚合得到 query-centric replacement pool:

Q_\tau=\bigcup_{q\in Q}\{e\mid (e,\tau)\in E_q^{corpus}\}

这一步保证:如果 GraphRAG 正确沿着原始问题所需的 reasoning chain 检索,它就会经过被攻击的桥接实体。

4. Type-Preserving Entity Swapping:同类型循环置换

统一目标集合:

R_\tau=G_\tau\cup Q_\tau,\quad R=\bigcup_{\tau\in T}R_\tau

对每个实体类型 $\tau$,把目标实体排成序列:

S_\tau=[e_1,e_2,\ldots,e_m]

定义循环置换:

\pi_\tau(e_i)= \begin{cases} e_{i-1}, & 1<i\le m\\ e_m, & i=1 \end{cases}

这样每个实体都被同类型实体替换,映射是 bijective / invertible。最后对语料中所有 $e\in R_\tau$ 做替换:

e \mapsto \pi_\tau(e)

攻击后的 $\tilde{C}$ 不插入新恶意文档,也不改变 query 和 gold answer。它改变的是 GraphRAG 从文本中抽取出的实体关系网络。

LogicPoison-algorithm1-workflow

Algorithm 1 说明完整执行流程:先抽取全局高频实体,再抽取 query-centric bridge entities,合并为统一目标集合,按类型构造循环置换,最后重写 corpus。

Results

1. 主结果:LogicPoison 在 GraphRAG 上显著强于 PoisonedRAG

论文在 HotpotQA、2WikiMultiHopQA、MuSiQue 上评估 Naive RAG、Microsoft GraphRAG、GFM-RAG、HippoRAG2,并使用 GPT-4o-mini、Llama-3.1-8B、Qwen-3-32B 三个 backbone。

指标:

  • ASR:基于 substring inclusion 的攻击成功率。
  • ASR-G / ASR-GPT:用 LLM judge 判断预测是否与 ground truth 语义等价后的攻击成功率。

LogicPoison-table1-main-attack-performance

Table 1 的关键数字:

  • HotpotQA + GraphRAG:LogicPoison ASR-G 约 91.2-92.2,明显高于 PoisonedRAG 的 78.0-80.2。
  • 2Wiki + GraphRAG:LogicPoison ASR-G 约 93.2-95.6,高于 PoisonedRAG 的 73.2-77.4。
  • MuSiQue + GraphRAG:LogicPoison ASR 91.4 / 91.6 / 93.0,ASR-G 97.0 / 97.6 / 95.8,说明深层多跳任务尤其脆弱。
  • 在 GFM-RAG、HippoRAG2 上,LogicPoison 也普遍强于 PoisonedRAG,表明可学习图检索和 PPR 式检索也不能天然抵抗拓扑污染。

解读:GraphRAG 的结构化检索会削弱显式内容投毒,但会放大拓扑级错误。越依赖多跳桥接,越可能被实体交换破坏。

2. 与传统攻击相比:逻辑拓扑攻击更适合 GraphRAG

LogicPoison-table2-baseline-attacks

Table 2 在 2Wiki 上比较 Naive Attack、Prompt Injection、GCG、Disinformation 和 LogicPoison:

  • GPT-4o-mini + GraphRAG:LogicPoison ASR-G 95.6;Prompt Injection 80.4;Disinformation 75.0;Naive/GCG 约 15.6-21.6。
  • Llama-3.1-8B + GFM-RAG:LogicPoison ASR-G 85.6,高于传统攻击。
  • Qwen-3-32B + GraphRAG:LogicPoison ASR-G 93.2,高于 Prompt Injection 的 83.4。

解读:Prompt Injection 和 Disinformation 仍有一定效果,但它们攻击的是文本内容;GraphRAG 会在图构建阶段过滤一部分攻击信号。LogicPoison 攻击的是图构建后的逻辑路径,因此更稳定。

3. 效率与隐蔽性:更快、更少 token、零注入文本

LogicPoison-table3-efficiency

Table 3 的关键数字:

  • PoisonedRAG:6607.3s,593.6 token cost,296813 injected tokens。
  • Global only:125.0s,0 token cost,0 injected tokens。
  • Query-Centric only:1281.4s,74.9 token cost,0 injected tokens。
  • LogicPoison full:1406.4s,74.9 token cost,0 injected tokens。

解读:

  • Global phase 只依赖轻量 NER 和频次统计,几乎不需要 LLM。
  • Query-centric phase 需要 LLM 抽取 reasoning-critical entities,但总成本仍远低于 PoisonedRAG。
  • 不注入额外文本意味着攻击面更隐蔽:检测系统很难通过异常长恶意片段或 prompt 模式发现污染。

4. 消融:Global 与 Query-Centric 互补

LogicPoison-fig3-ablation

Figure 3 在 2Wiki 上比较 Global-only、Query-Centric-only 和 Full LogicPoison:

  • Global Logic Poison 破坏全局 hub,适合低成本、无 query 或 query 很少的场景。
  • Query-Centric Logic Poison 针对特定问题的 bridge entity,能切断 query-specific reasoning chain。
  • Full LogicPoison 通常最高,因为它同时破坏全局连接和局部推理路径。

对本知识库的启发:GraphRAG 鲁棒性不能只测随机边噪声。需要分别测 hub perturbation、bridge perturbation、query-specific path perturbation。

5. 防御:Query Paraphrasing 几乎无效

LogicPoison-table4-paraphrasing-defense

Table 4 显示 query paraphrasing 后攻击成功率下降很小:

  • HotpotQA + GraphRAG:92.2 -> 92.2。
  • 2Wiki + GraphRAG:95.6 -> 94.6。
  • MuSiQue + GraphRAG:97.0 -> 96.2。
  • 所有下降不超过 1.0。

原因:paraphrasing 改变句子表面形式,但问题核心语义和 reasoning-critical entities 不变。LogicPoison 已经污染了语料和图拓扑,重写 query 不能恢复 clean graph。

6. PPL 检测:接近随机

LogicPoison-fig4-ppl-detection

Figure 4 的 PPL-based detection AUC = 0.57,接近随机猜测 0.5。

解读:

  • Type-preserving swapping 保持实体类型一致,句法和流畅性不会明显破坏。
  • 攻击文本不是“低质量生成文本”,而是把原文中的实体做同类替换。
  • 因此,依赖 PPL 或文本质量异常的 poisoning detector 很难发现逻辑拓扑污染。

Limitations

  • 攻击假设攻击者能修改 corpus 或其进入索引前的文本版本;如果语料有强完整性校验、签名或审计日志,攻击空间会下降。
  • Query-centric phase 需要 query set 或代表性问题。如果实际用户问题分布变化很大,预先选择的 bridge entities 可能覆盖不足。
  • 实验集中在 HotpotQA、2Wiki、MuSiQue 这类开放域多跳 QA;法律、医疗、企业 schema、代码图等强 schema 场景仍需验证。
  • 论文主要展示攻击成功率和成本,没有给出系统级防御框架,例如 graph integrity verification、entity-swap detection、path consistency checking。
  • Type-preserving swapping 保持局部可读性,但可能在高度专业语料中制造领域知识不一致;这类不一致是否能被 domain verifier 捕捉,还需要实验。
  • 该工作偏攻击诊断,对正常数据演化和恶意逻辑污染的区分还不充分。真实系统中,图结构变化不一定都是攻击,也可能来自新知识更新。

Future Directions

  • 作者方向:
    • 继续扩展 GraphRAG 安全研究,把攻击从显式文本注入转向逻辑拓扑破坏。
    • 研究更有效的检测与防御机制,尤其是对 type-preserving entity swapping 的识别。
    • 扩大 GraphRAG 方法和数据集范围,测试不同图构建和检索范式的脆弱性。
  • Agent 推断的 Research Opportunities:
    • Graph topology integrity benchmark:构造 clean / poisoned corpus 对,记录 hub perturbation、bridge perturbation、path perturbation 对 FR@K、support-set completion、answer EM/F1 的影响。
    • Path consistency verifier:对检索路径中的实体类型、关系语义、source citation 和 ground-truth support 做一致性检查,识别“表面通顺但路径断裂”的证据链。
    • Entity-swap detector:利用实体共现、领域约束、temporal consistency、schema constraints 检测同类型实体循环置换。
    • Robust graph construction:在建图阶段保存 provenance、document signature、entity canonicalization history,避免污染文本静默进入 KG。
    • 和 GraphSteal - Structural Knowledge Stealing from GraphRAG 合并成双重安全评测:LogicPoison 测“外部能否污染图”,GraphSteal 测“外部能否重构图”。
    • 和 LegalGraphRAG - Multi-Agent GraphRAG for Reliable Legal Reasoning 的 Auditor 思路结合:把 evidence applicability verification 扩展为 graph-path applicability verification。

与本知识库的连接

一句话定位

LogicPoison 的价值不是提出一个更强 GraphRAG,而是证明 GraphRAG 的关键风险已经从“检索到坏文本”升级为“构建出坏拓扑”:只要攻击者能在同类型实体之间重连语料,系统就可能沿着看似合理的图路径做出错误推理。