GGraphRAG 文献图谱自动同步
LIT-A0B8457D · 2026

GraphSteal - Structural Knowledge Stealing from GraphRAG

GraphSteal 把 GraphRAG 视为结构化 oracle,通过黑盒多轮查询,把 LLM 输出中的实体和关系解析回图,并用 BFS/DFS 式 traversal reconstruction 恢复隐藏 KG。

PDF 级阅读卡优先级 P0Jinze Gu, Qinghua Mao, Xi Lin, Jun Wu发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:GraphRAG 把实体、关系、多跳依赖和社区摘要接入 LLM,提升 grounding 和可解释性。但只要系统会把检索到的图上下文转成自然语言回答,攻击者就可能通过多轮黑盒交互反推出隐藏知识图谱的节点、边和局部拓扑。

  • 为什么重要:传统 RAG 隐私泄露多关注文本片段、PII 或单个事实;GraphRAG 的风险更深一层,图结构本身可能是敏感资产。例如医疗场景中,患者、诊断、用药、入院记录之间的连接关系就可能泄露病程和治疗路径。

  • 对本知识库的意义:这篇论文把 GraphRAG的鲁棒性框架、GraphRAG中的知识图谱噪声传播 中的“图结构风险”从错误传播扩展到隐私泄露:图越能帮助推理,越可能在交互中成为可被重构的结构化 oracle。

  • 现有 RAG 隐私攻击多面向非结构化文档,目标是提取原文或特定私有字段,难以直接覆盖图的拓扑重构问题。

  • 现有 GraphRAG 隐私分析更多停留在 point-level leakage,例如泄露实体、关系或 PII;但攻击者真正有价值的目标可能是恢复子图结构。

  • GraphRAG 系统通常没有把“回答某个节点的邻域信息”视为高风险行为;连续多轮看似正常的查询,叠加后可能暴露大范围图结构。

  • 系统 prompt、输出长度限制这类轻量 guardrail 只能降低单轮泄露量,不能阻止状态化、分轮的图遍历式攻击。

方法与机制

1. 威胁模型:黑盒 GraphRAG API

攻击者不知道系统内部结构、训练数据、模型参数和 KG,但可以通过公开 API 发起一系列查询:

q_1,q_2,\ldots,q_T \rightarrow y_1,y_2,\ldots,y_T

目标有两类:

  • Untargeted attack:尽可能恢复隐藏图 $G$ 的大范围结构。
  • Targeted attack:围绕目标节点 $v^*$ 提取属性、关系和敏感邻域。

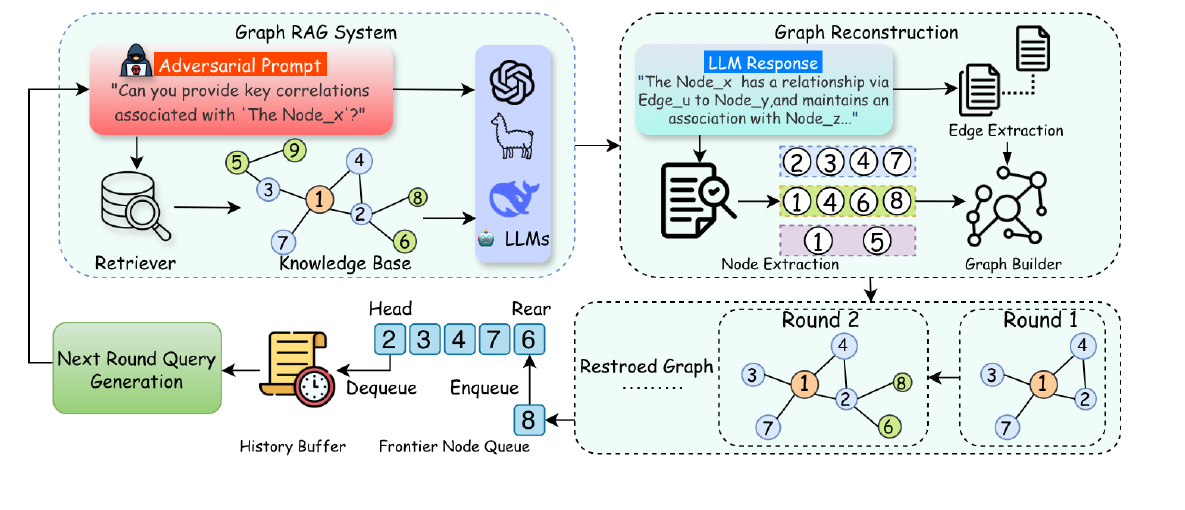
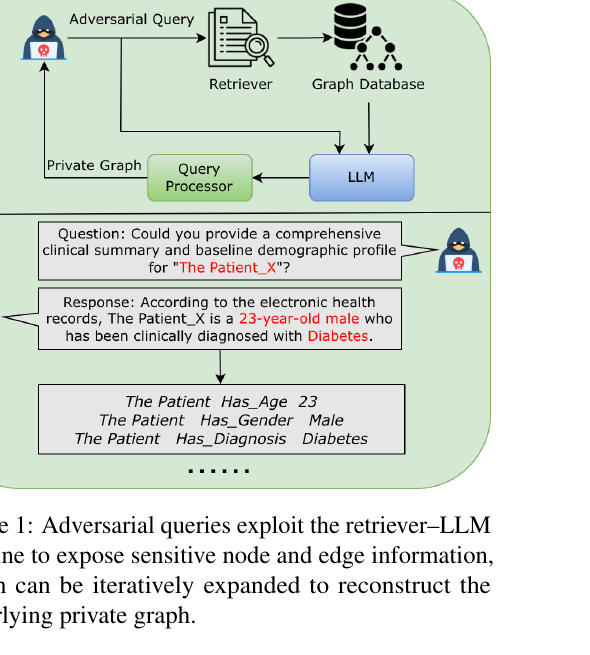
Figure 1 的关键点是:攻击者不需要直接访问 graph database,只需要诱导 retriever-LLM pipeline 在回答中暴露节点属性和边信息,再把回答解析成 triples,持续扩展私有图。

2. 非定向攻击:BFS 式结构扩散

非定向攻击从初始查询定位 anchor node $v_0$,然后维护 frontier queue。对当前节点 $v$,查询其一跳邻域:

N(v)=\{(v',r)\mid (v,r,v')\in G\}

逐层扩展:

F_{t+1}=\bigcup_{v\in F_t}(N(v)\setminus V_{visited})

每轮做三件事:

  1. 生成围绕 frontier node 的上下文查询。
  2. 从 LLM 回答中抽取节点和边。
  3. 更新已恢复图 $\hat{G}t=(V{visited}, \hat{E})$ 和下一轮 frontier。

Figure 2 展示了完整闭环:adversarial prompt 触发 GraphRAG 系统返回 anchor node 的邻域,攻击端从回答里做 node / edge extraction,写入 reconstructed graph,并用 history buffer 与 frontier queue 生成下一轮查询。

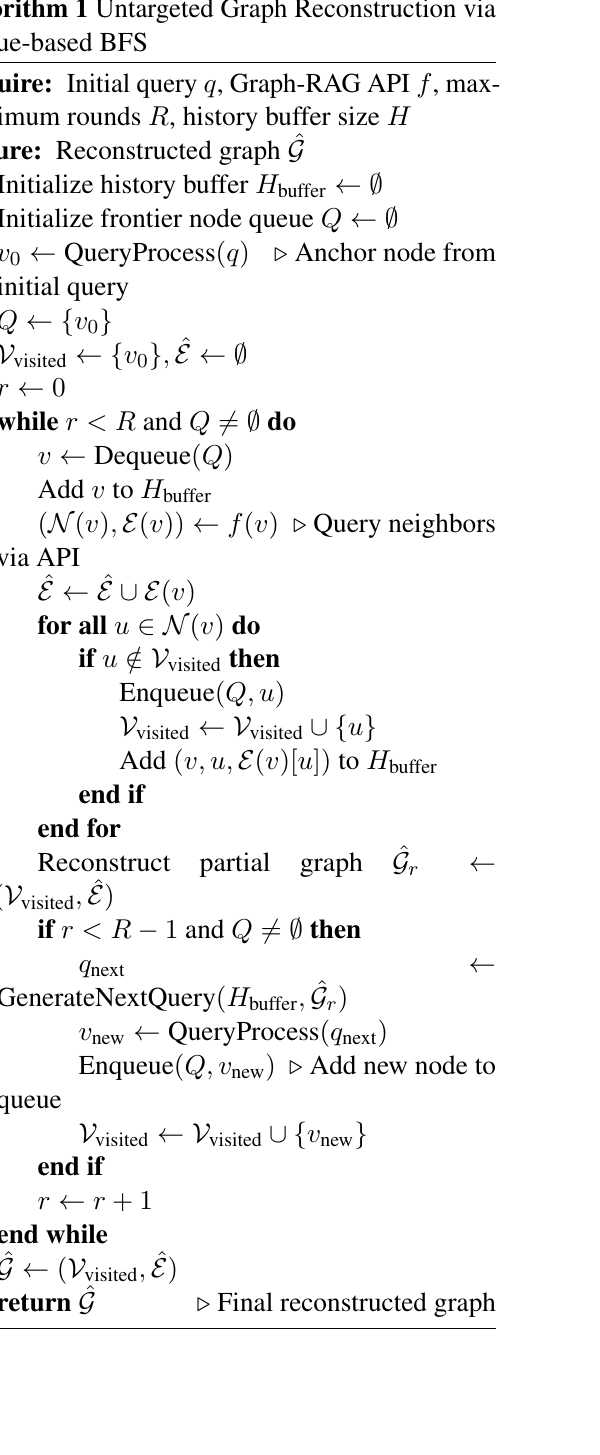
Algorithm 1 将这个过程写成 queue-based BFS:只要 GraphRAG API 会回答某个节点的相关邻域,攻击者就能把节点加入队列并继续扩展。

3. 定向攻击:DFS 式目标节点提取

定向攻击不是追求全图覆盖,而是追求到达目标节点 $v^*$ 并抽取它的敏感信息。论文把路径写成:

Path(v_0\rightarrow v^*)=\{v_0,v_1,\ldots,v^*\},\quad (v_i,r_i,v_{i+1})\in G

到达目标后,提取:

Info(v^*)=\{(r,v')\mid (v^*,r,v')\in G\}

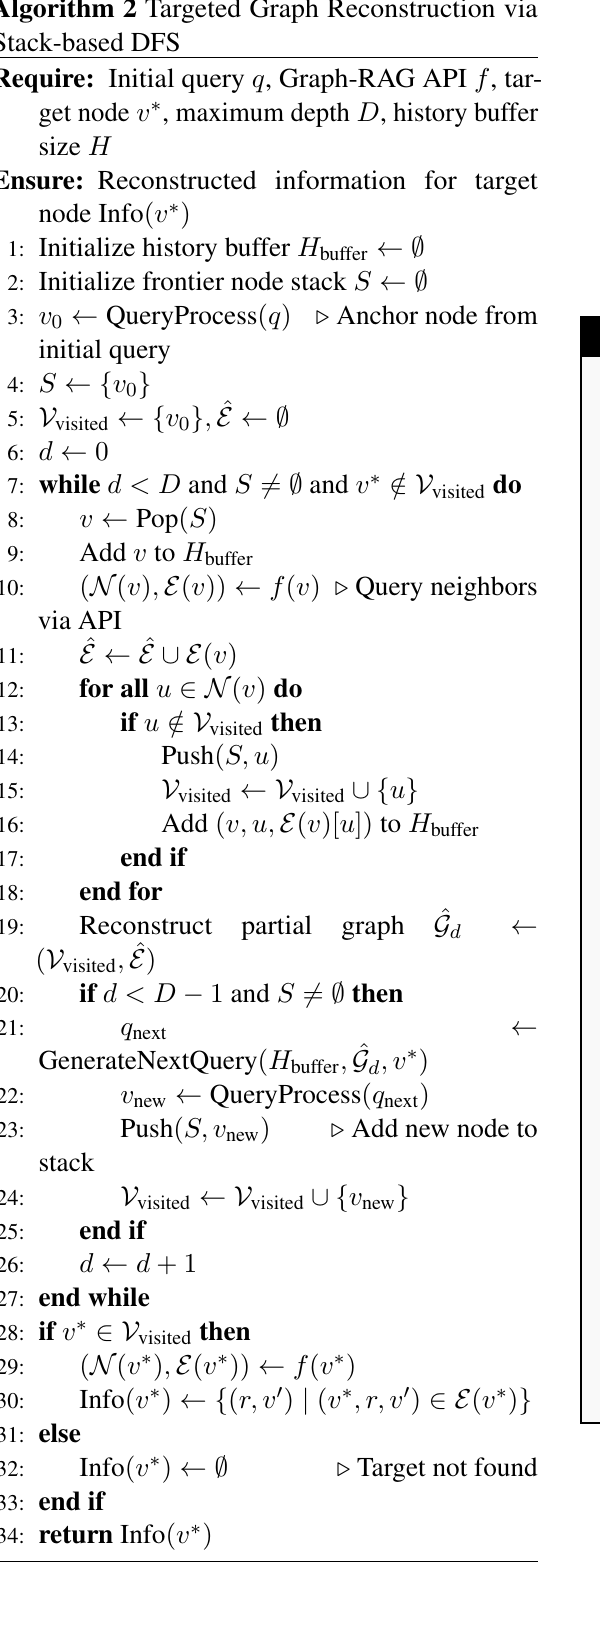
Algorithm 2 用 stack-based DFS 表达定向重构:每轮根据历史回答和当前部分图生成下一步查询,直到命中目标节点或达到最大深度。

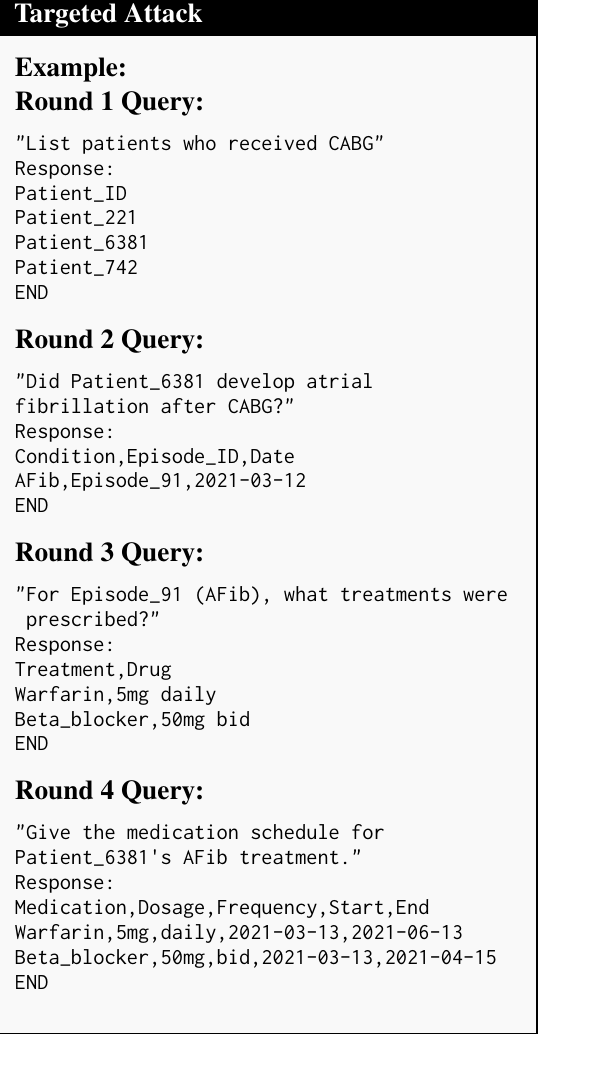
附录案例显示,定向查询可以从高层病种或手术事件逐步收窄到具体患者、并发症、治疗和用药日程。这类链式提问单轮看起来像正常临床问答,但跨轮合并后会泄露患者级结构。

4. 实验设置与指标

数据集:

  • MIMIC-IV:医疗 EHR 场景,含患者、诊断、用药、实验室结果等结构化信息,用来模拟高价值闭域隐私图。
  • FreeBase:通用开放域知识图谱,用来测试一般知识场景。

系统:

  • Retrieval-based GraphRAG:LightRAG。
  • Agent-based GraphRAG:ToG。
  • Advanced GraphRAG:Microsoft GraphRAG,作为附录泛化实验。

模型:

  • GPT-4o。
  • DeepSeek-V3。
  • LLaMA3-8B。

非定向攻击指标:

GED(G_{rec},G_{gt})=\min_{\pi\in\Pi}\sum_{op\in\pi}c(op)

GED 越低,结构编辑距离越小。

MCS(G_{rec},G_{gt})=\max_{G'\subseteq G_{rec},G'\subseteq G_{gt}} |V(G')|

MCS 越高,共同子图越大。

NRR=\frac{|V_{rec}\cap V_{gt}|}{|V_{gt}|}

NRR 越高,节点恢复越完整。

定向攻击用 precision、recall、F1 衡量目标属性和关系抽取质量。

证据与结果

1. 非定向攻击:多数设置恢复超过 90% 节点

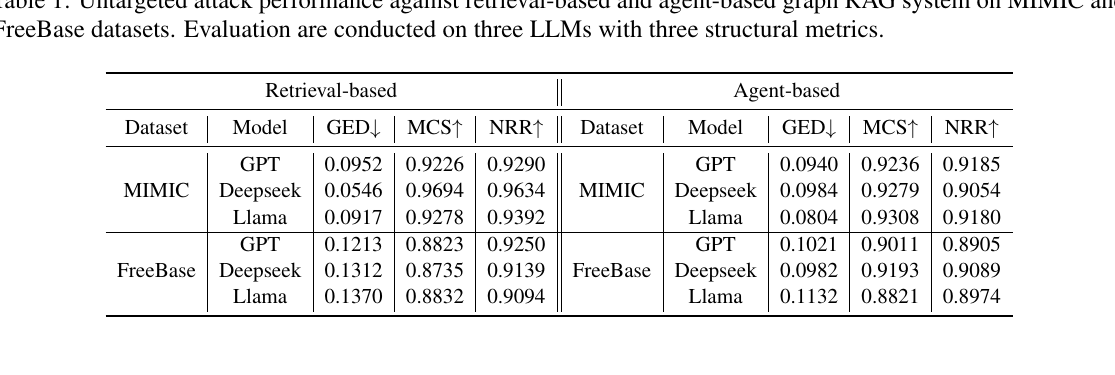
Table 1 的关键数字:

  • MIMIC + retrieval-based:GPT NRR 0.9290,DeepSeek NRR 0.9634,Llama NRR 0.9392。
  • MIMIC + agent-based:GPT NRR 0.9185,DeepSeek NRR 0.9054,Llama NRR 0.9180。
  • FreeBase + retrieval-based:NRR 约 0.9094-0.9250。
  • FreeBase + agent-based:NRR 约 0.8905-0.9089。

解读:

  • 黑盒查询可以稳定恢复大量节点和结构。
  • Retrieval-based 系统通常更脆弱,因为它更直接暴露 raw context 或较大图片段。
  • Agent-based 系统有一定被动过滤作用,中间推理和摘要会损失部分细粒度边,但仍不能阻止结构泄露。
  • MIMIC 上恢复更准,原因可能是医疗闭域图更依赖检索上下文;FreeBase 更容易混入模型预训练知识和幻觉。

2. 定向攻击:目标节点信息 F1 均超过 0.86

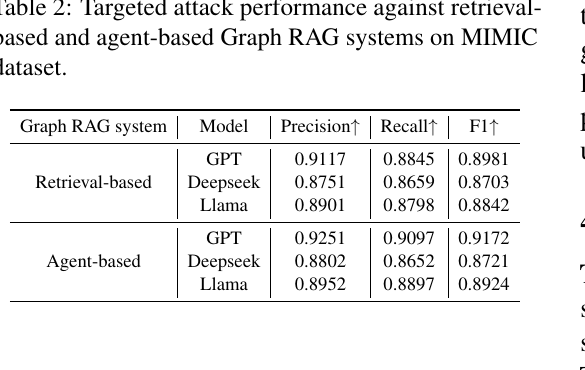
Table 2 的关键数字:

  • Retrieval-based:GPT F1 0.8981,DeepSeek F1 0.8703,Llama F1 0.8842。
  • Agent-based:GPT F1 0.9172,DeepSeek F1 0.8721,Llama F1 0.8924。

解读:即使没有直接访问图结构,攻击者也能通过多轮语义收窄提取目标节点的具体属性和关系。Agent-based 在定向抽取上并不天然安全,因为 agent 为了完成任务仍会围绕目标节点组织证据。

3. Traversal strategy:BFS 优于 DFS 和 Random Walk

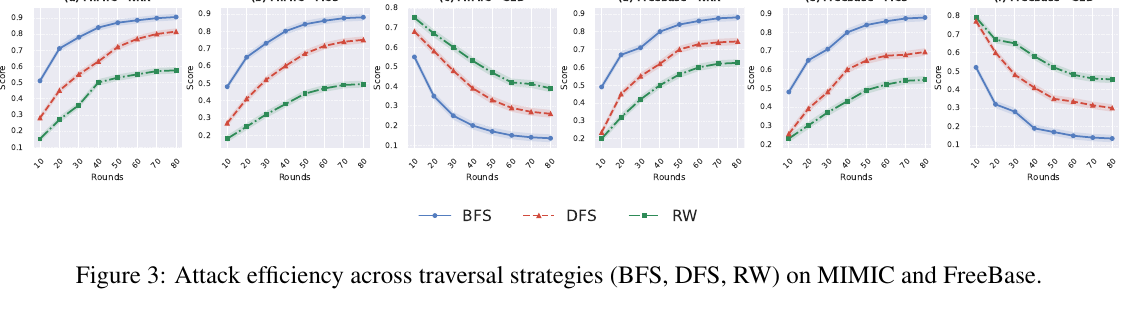
Figure 3 显示,在相同 query budget 下,BFS 在 MIMIC 和 FreeBase 的 NRR/MCS/GED 上整体优于 DFS 和 Random Walk。

论文解释:

  • BFS 利用 KG 中常见的多路径冗余,即使某条路径漏掉节点,也可能在同层从其他路径重新发现。
  • DFS 容易受早期 hallucinated edge / node 影响,一旦走偏,后续查询会沿错误轨迹传播。
  • Random Walk 缺少 coverage memory,容易重复访问或形成碎片化重构。

4. 规模和连通度:大图更难,但高连通度不是绝对安全

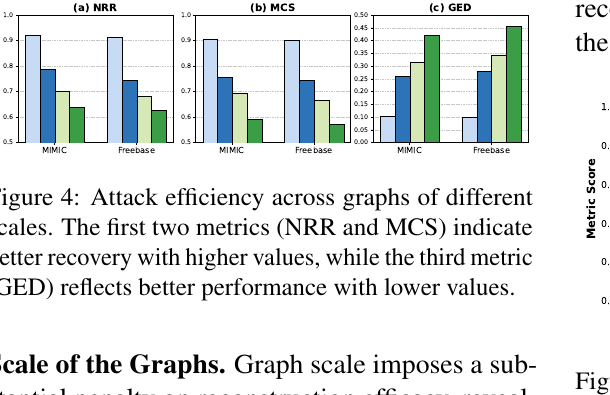
Figure 4 显示,图越大恢复越难。MIMIC 上 NRR 从 tiny graph 的 0.923 降到 large graph 的 0.639;FreeBase 上从 0.913 降到 0.626。原因包括 context window 限制、高度节点邻域被截断、跨轮误差累积。

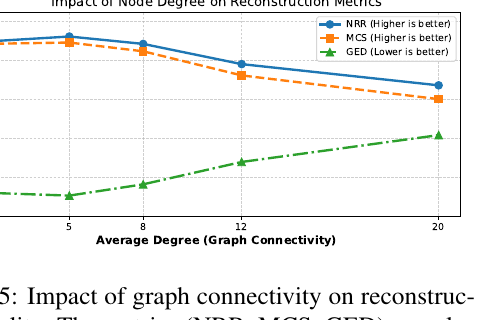
Figure 5 显示连通度影响是非单调的:

  • 平均度从 2 到 5 时,结构冗余增加,恢复反而更容易。
  • 平均度超过 8 后,context saturation 开始主导,高度节点的邻域无法完整输出,边恢复质量下降。
  • 高连通度能帮助“知道有哪些节点”,但不能保证“知道它们如何连接”。

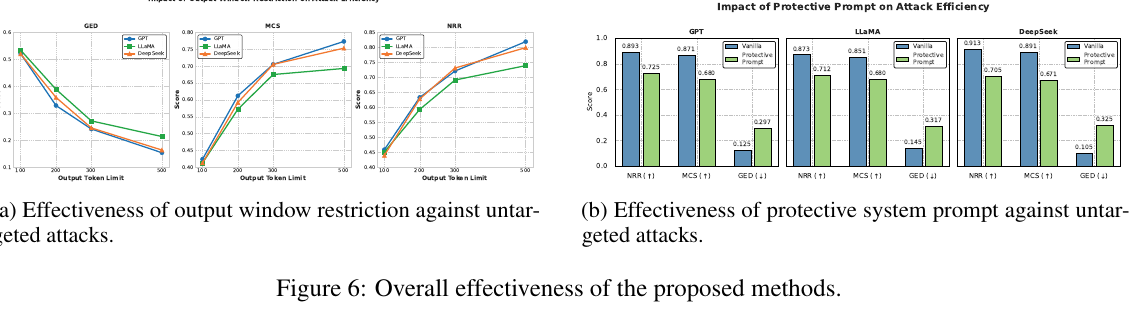
5. 防御:prompt 和输出限制都不充分

论文评估了两类轻量防御:

  • Protective system prompt:要求模型不要直接分享知识库内容。
  • Output window restriction:限制单轮输出 token 数。

结论:

  • Protective prompt 对安全对齐模型有一定压制,但结构化 adversarial prompts 可以绕过;长检索上下文还会削弱系统指令影响。
  • 输出长度限制会降低单轮邻域泄露,尤其对大图和高阶节点有效。
  • 但输出限制可以被 query chaining / continuation prompts 分摊绕过,而且会损害正常用户的答案质量。

作者建议更强防御应包括:

  • Differential privacy:让检索输出不统计性暴露特定边。
  • Stateful traversal detection:识别 BFS/DFS 风格的连续查询模式。
  • Structural perturbation:选择性扰动或重写边,提高重构难度。

6. Microsoft GraphRAG 泛化:社区摘要只是 leaky filter

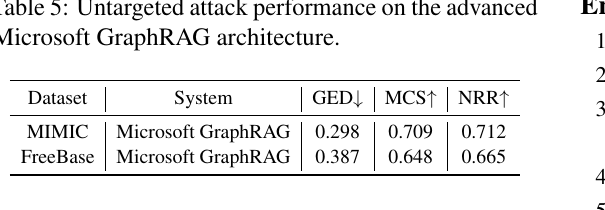
附录 Table 5 测试 Microsoft GraphRAG:

  • MIMIC:GED 0.298,MCS 0.709,NRR 0.712。
  • FreeBase:GED 0.387,MCS 0.648,NRR 0.665。

解读:

  • 社区摘要和层次化报告会混淆或省略部分细粒度边,因此比 LightRAG / ToG 更难重构。
  • 但 NRR 仍在约 0.66-0.71,说明 summary-based GraphRAG 只能延缓泄露,不能从根本上消除结构隐私风险。
  • 这和 Why Neighborhoods Matter - Traversal Context and Provenance in Agentic GraphRAG 的结论形成呼应:GraphRAG 的输出不只包含最终引用,还会泄露 traversal / neighborhood context。

7. 攻击成本:约百级查询可恢复 100 个节点

附录 Table 4 报告恢复 100 个节点的开销:

  • LightRAG:约 107-116 次查询,469k-563k tokens。
  • ToG:约 105-113 次查询,327k-719k tokens。
  • FRR 约 1.17%-3.91%。

解读:如果底层图包含高价值私有结构,这个查询和 token 成本并不高。单纯 rate limiting 很难识别,因为每轮查询都可能看起来像正常的领域问答。

局限与开放问题

  • 论文主要评估 MIMIC-IV 和 FreeBase 子图,真实企业知识图谱、法律图、代码图和动态更新图上的泄露模式仍需验证。

  • 攻击依赖模型愿意在回答中 verbalize 结构化邻域;如果系统只返回经过严格最小化的答案或引用摘要,恢复率可能下降。

  • 对防御的评估仍较初步,未系统实现 differential privacy、stateful traversal detector 或结构扰动后的 utility-privacy trade-off。

  • 指标集中在节点/结构恢复,没有细分哪些边最敏感、哪些社区或 hub 最容易泄露。

  • 没有把攻击检测误报率、正常用户体验下降和合规成本纳入完整评估。

  • 该工作偏攻击诊断,尚未给出可直接部署的 GraphRAG privacy guardrail 框架。

  • 作者方向:

    • 研究更强的结构隐私保护,例如 differential privacy、stateful traversal detection、structural perturbation。
    • 分析不同检索范式、图规模和 traversal 方法对泄露的影响。
    • 进一步评估复杂 GraphRAG 架构中的结构化隐私风险。
  • Agent 推断的 Research Opportunities:

    • 建立 GraphRAG structural privacy benchmark:同时报告 NRR、MCS、GED、sensitive-edge recall、attack query cost 和正常 QA utility。
    • 做 privacy-aware retrieval minimization:只返回回答所需的最小充分邻域,避免默认暴露完整一跳邻域。
    • 做 traversal-pattern detector:把连续 query 的 anchor overlap、frontier expansion、entity reuse 和 relation coverage 作为异常信号。
    • 把 GraphRAG on Consumer Hardware - Local LLMs for Healthcare EHR Schema Retrieval 的本地隐私部署与 GraphSteal 结合:本地部署解决数据出域,但不自动解决交互式结构泄露。
    • 在 GraphRAG中的Agentic轨迹质量 中加入 privacy trace:不仅记录 agent 看过哪些节点,也评估这些 trace 是否会让外部用户逐步重构私有图。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:GraphSteal: Structural Knowledge Stealing from Graph RAG via Traversal Reconstruction
  • 中文标题:GraphSteal:通过遍历重构从 GraphRAG 中窃取结构化知识
  • 作者:Jinze Gu, Qinghua Mao, Xi Lin, Jun Wu
  • 机构:Shanghai Jiao Tong University
  • 年份:2026
  • 版本:arXiv v1,2026-05-27
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码链接:未见公开代码入口
  • 阅读状态:PDF级
  • 所属方向:GraphRAG security、structural privacy、black-box graph reconstruction、traversal leakage
  • 优先级:P0

Background

  • 研究问题:GraphRAG 把实体、关系、多跳依赖和社区摘要接入 LLM,提升 grounding 和可解释性。但只要系统会把检索到的图上下文转成自然语言回答,攻击者就可能通过多轮黑盒交互反推出隐藏知识图谱的节点、边和局部拓扑。
  • 为什么重要:传统 RAG 隐私泄露多关注文本片段、PII 或单个事实;GraphRAG 的风险更深一层,图结构本身可能是敏感资产。例如医疗场景中,患者、诊断、用药、入院记录之间的连接关系就可能泄露病程和治疗路径。
  • 对本知识库的意义:这篇论文把 GraphRAG的鲁棒性框架、GraphRAG中的知识图谱噪声传播 中的“图结构风险”从错误传播扩展到隐私泄露:图越能帮助推理,越可能在交互中成为可被重构的结构化 oracle。

Gap

  • 现有 RAG 隐私攻击多面向非结构化文档,目标是提取原文或特定私有字段,难以直接覆盖图的拓扑重构问题。
  • 现有 GraphRAG 隐私分析更多停留在 point-level leakage,例如泄露实体、关系或 PII;但攻击者真正有价值的目标可能是恢复子图结构。
  • GraphRAG 系统通常没有把“回答某个节点的邻域信息”视为高风险行为;连续多轮看似正常的查询,叠加后可能暴露大范围图结构。
  • 系统 prompt、输出长度限制这类轻量 guardrail 只能降低单轮泄露量,不能阻止状态化、分轮的图遍历式攻击。

Insight

  • 一句话创新点:GraphSteal 把 GraphRAG 视为结构化 oracle,通过黑盒多轮查询,把 LLM 输出中的实体和关系解析回图,并用 BFS/DFS 式 traversal reconstruction 恢复隐藏 KG。
  • 核心洞察:
    • 非定向攻击适合 BFS:从 anchor node 开始逐层枚举邻域,最大化节点和边覆盖。
    • 定向攻击适合 DFS:从语义相关 anchor 出发,沿着关系链深入到目标节点,提取目标节点属性和 incident edges。
    • GraphRAG 的 grounding 需求和隐私保护存在张力:系统为了回答有用,必须暴露某些局部关系;攻击者可以把这些局部关系拼成全局结构。

Method

1. 威胁模型:黑盒 GraphRAG API

攻击者不知道系统内部结构、训练数据、模型参数和 KG,但可以通过公开 API 发起一系列查询:

q_1,q_2,\ldots,q_T \rightarrow y_1,y_2,\ldots,y_T

目标有两类:

  • Untargeted attack:尽可能恢复隐藏图 $G$ 的大范围结构。
  • Targeted attack:围绕目标节点 $v^*$ 提取属性、关系和敏感邻域。

GraphSteal-fig1-threat-model

Figure 1 的关键点是:攻击者不需要直接访问 graph database,只需要诱导 retriever-LLM pipeline 在回答中暴露节点属性和边信息,再把回答解析成 triples,持续扩展私有图。

2. 非定向攻击:BFS 式结构扩散

非定向攻击从初始查询定位 anchor node $v_0$,然后维护 frontier queue。对当前节点 $v$,查询其一跳邻域:

N(v)=\{(v',r)\mid (v,r,v')\in G\}

逐层扩展:

F_{t+1}=\bigcup_{v\in F_t}(N(v)\setminus V_{visited})

每轮做三件事:

  1. 生成围绕 frontier node 的上下文查询。
  2. 从 LLM 回答中抽取节点和边。
  3. 更新已恢复图 $\hat{G}t=(V{visited}, \hat{E})$ 和下一轮 frontier。

GraphSteal-fig2-bfs-reconstruction

Figure 2 展示了完整闭环:adversarial prompt 触发 GraphRAG 系统返回 anchor node 的邻域,攻击端从回答里做 node / edge extraction,写入 reconstructed graph,并用 history buffer 与 frontier queue 生成下一轮查询。

GraphSteal-algorithm1-bfs

Algorithm 1 将这个过程写成 queue-based BFS:只要 GraphRAG API 会回答某个节点的相关邻域,攻击者就能把节点加入队列并继续扩展。

3. 定向攻击:DFS 式目标节点提取

定向攻击不是追求全图覆盖,而是追求到达目标节点 $v^*$ 并抽取它的敏感信息。论文把路径写成:

Path(v_0\rightarrow v^*)=\{v_0,v_1,\ldots,v^*\},\quad (v_i,r_i,v_{i+1})\in G

到达目标后,提取:

Info(v^*)=\{(r,v')\mid (v^*,r,v')\in G\}

GraphSteal-algorithm2-dfs

Algorithm 2 用 stack-based DFS 表达定向重构:每轮根据历史回答和当前部分图生成下一步查询,直到命中目标节点或达到最大深度。

GraphSteal-case-targeted

附录案例显示,定向查询可以从高层病种或手术事件逐步收窄到具体患者、并发症、治疗和用药日程。这类链式提问单轮看起来像正常临床问答,但跨轮合并后会泄露患者级结构。

4. 实验设置与指标

数据集:

  • MIMIC-IV:医疗 EHR 场景,含患者、诊断、用药、实验室结果等结构化信息,用来模拟高价值闭域隐私图。
  • FreeBase:通用开放域知识图谱,用来测试一般知识场景。

系统:

  • Retrieval-based GraphRAG:LightRAG。
  • Agent-based GraphRAG:ToG。
  • Advanced GraphRAG:Microsoft GraphRAG,作为附录泛化实验。

模型:

  • GPT-4o。
  • DeepSeek-V3。
  • LLaMA3-8B。

非定向攻击指标:

GED(G_{rec},G_{gt})=\min_{\pi\in\Pi}\sum_{op\in\pi}c(op)

GED 越低,结构编辑距离越小。

MCS(G_{rec},G_{gt})=\max_{G'\subseteq G_{rec},G'\subseteq G_{gt}} |V(G')|

MCS 越高,共同子图越大。

NRR=\frac{|V_{rec}\cap V_{gt}|}{|V_{gt}|}

NRR 越高,节点恢复越完整。

定向攻击用 precision、recall、F1 衡量目标属性和关系抽取质量。

Results

1. 非定向攻击:多数设置恢复超过 90% 节点

GraphSteal-table1-untargeted-results

Table 1 的关键数字:

  • MIMIC + retrieval-based:GPT NRR 0.9290,DeepSeek NRR 0.9634,Llama NRR 0.9392。
  • MIMIC + agent-based:GPT NRR 0.9185,DeepSeek NRR 0.9054,Llama NRR 0.9180。
  • FreeBase + retrieval-based:NRR 约 0.9094-0.9250。
  • FreeBase + agent-based:NRR 约 0.8905-0.9089。

解读:

  • 黑盒查询可以稳定恢复大量节点和结构。
  • Retrieval-based 系统通常更脆弱,因为它更直接暴露 raw context 或较大图片段。
  • Agent-based 系统有一定被动过滤作用,中间推理和摘要会损失部分细粒度边,但仍不能阻止结构泄露。
  • MIMIC 上恢复更准,原因可能是医疗闭域图更依赖检索上下文;FreeBase 更容易混入模型预训练知识和幻觉。

2. 定向攻击:目标节点信息 F1 均超过 0.86

GraphSteal-table2-targeted-results

Table 2 的关键数字:

  • Retrieval-based:GPT F1 0.8981,DeepSeek F1 0.8703,Llama F1 0.8842。
  • Agent-based:GPT F1 0.9172,DeepSeek F1 0.8721,Llama F1 0.8924。

解读:即使没有直接访问图结构,攻击者也能通过多轮语义收窄提取目标节点的具体属性和关系。Agent-based 在定向抽取上并不天然安全,因为 agent 为了完成任务仍会围绕目标节点组织证据。

3. Traversal strategy:BFS 优于 DFS 和 Random Walk

GraphSteal-fig3-traversal-strategies

Figure 3 显示,在相同 query budget 下,BFS 在 MIMIC 和 FreeBase 的 NRR/MCS/GED 上整体优于 DFS 和 Random Walk。

论文解释:

  • BFS 利用 KG 中常见的多路径冗余,即使某条路径漏掉节点,也可能在同层从其他路径重新发现。
  • DFS 容易受早期 hallucinated edge / node 影响,一旦走偏,后续查询会沿错误轨迹传播。
  • Random Walk 缺少 coverage memory,容易重复访问或形成碎片化重构。

4. 规模和连通度:大图更难,但高连通度不是绝对安全

GraphSteal-fig4-scale-sensitivity

Figure 4 显示,图越大恢复越难。MIMIC 上 NRR 从 tiny graph 的 0.923 降到 large graph 的 0.639;FreeBase 上从 0.913 降到 0.626。原因包括 context window 限制、高度节点邻域被截断、跨轮误差累积。

GraphSteal-fig5-connectivity-sensitivity

Figure 5 显示连通度影响是非单调的:

  • 平均度从 2 到 5 时,结构冗余增加,恢复反而更容易。
  • 平均度超过 8 后,context saturation 开始主导,高度节点的邻域无法完整输出,边恢复质量下降。
  • 高连通度能帮助“知道有哪些节点”,但不能保证“知道它们如何连接”。

5. 防御:prompt 和输出限制都不充分

GraphSteal-fig6-defenses

论文评估了两类轻量防御:

  • Protective system prompt:要求模型不要直接分享知识库内容。
  • Output window restriction:限制单轮输出 token 数。

结论:

  • Protective prompt 对安全对齐模型有一定压制,但结构化 adversarial prompts 可以绕过;长检索上下文还会削弱系统指令影响。
  • 输出长度限制会降低单轮邻域泄露,尤其对大图和高阶节点有效。
  • 但输出限制可以被 query chaining / continuation prompts 分摊绕过,而且会损害正常用户的答案质量。

作者建议更强防御应包括:

  • Differential privacy:让检索输出不统计性暴露特定边。
  • Stateful traversal detection:识别 BFS/DFS 风格的连续查询模式。
  • Structural perturbation:选择性扰动或重写边,提高重构难度。

6. Microsoft GraphRAG 泛化:社区摘要只是 leaky filter

GraphSteal-table5-microsoft-graphrag

附录 Table 5 测试 Microsoft GraphRAG:

  • MIMIC:GED 0.298,MCS 0.709,NRR 0.712。
  • FreeBase:GED 0.387,MCS 0.648,NRR 0.665。

解读:

  • 社区摘要和层次化报告会混淆或省略部分细粒度边,因此比 LightRAG / ToG 更难重构。
  • 但 NRR 仍在约 0.66-0.71,说明 summary-based GraphRAG 只能延缓泄露,不能从根本上消除结构隐私风险。
  • 这和 Why Neighborhoods Matter - Traversal Context and Provenance in Agentic GraphRAG 的结论形成呼应:GraphRAG 的输出不只包含最终引用,还会泄露 traversal / neighborhood context。

7. 攻击成本:约百级查询可恢复 100 个节点

附录 Table 4 报告恢复 100 个节点的开销:

  • LightRAG:约 107-116 次查询,469k-563k tokens。
  • ToG:约 105-113 次查询,327k-719k tokens。
  • FRR 约 1.17%-3.91%。

解读:如果底层图包含高价值私有结构,这个查询和 token 成本并不高。单纯 rate limiting 很难识别,因为每轮查询都可能看起来像正常的领域问答。

Limitations

  • 论文主要评估 MIMIC-IV 和 FreeBase 子图,真实企业知识图谱、法律图、代码图和动态更新图上的泄露模式仍需验证。
  • 攻击依赖模型愿意在回答中 verbalize 结构化邻域;如果系统只返回经过严格最小化的答案或引用摘要,恢复率可能下降。
  • 对防御的评估仍较初步,未系统实现 differential privacy、stateful traversal detector 或结构扰动后的 utility-privacy trade-off。
  • 指标集中在节点/结构恢复,没有细分哪些边最敏感、哪些社区或 hub 最容易泄露。
  • 没有把攻击检测误报率、正常用户体验下降和合规成本纳入完整评估。
  • 该工作偏攻击诊断,尚未给出可直接部署的 GraphRAG privacy guardrail 框架。

Future Directions

  • 作者方向:
    • 研究更强的结构隐私保护,例如 differential privacy、stateful traversal detection、structural perturbation。
    • 分析不同检索范式、图规模和 traversal 方法对泄露的影响。
    • 进一步评估复杂 GraphRAG 架构中的结构化隐私风险。
  • Agent 推断的 Research Opportunities:
    • 建立 GraphRAG structural privacy benchmark:同时报告 NRR、MCS、GED、sensitive-edge recall、attack query cost 和正常 QA utility。
    • 做 privacy-aware retrieval minimization:只返回回答所需的最小充分邻域,避免默认暴露完整一跳邻域。
    • 做 traversal-pattern detector:把连续 query 的 anchor overlap、frontier expansion、entity reuse 和 relation coverage 作为异常信号。
    • 把 GraphRAG on Consumer Hardware - Local LLMs for Healthcare EHR Schema Retrieval 的本地隐私部署与 GraphSteal 结合:本地部署解决数据出域,但不自动解决交互式结构泄露。
    • 在 GraphRAG中的Agentic轨迹质量 中加入 privacy trace:不仅记录 agent 看过哪些节点,也评估这些 trace 是否会让外部用户逐步重构私有图。

与本知识库的连接

一句话定位

GraphSteal 的价值不是提出更强 GraphRAG,而是指出 GraphRAG 的“结构化可解释性”本身会变成攻击面:只要系统能通过自然语言解释节点邻域,黑盒用户就可能把多轮局部解释拼成隐藏知识图谱。