研究问题与动机
- 研究问题:KGQA 中的 LLM planner 往往是 stateless 的,每个问题都从零生成 SPARQL 或 API 调用计划,不能复用历史成功查询轨迹。
- 为什么重要:知识图谱接口要求 predicate、schema、domain routing 和 query operator 都正确。纯自然语言 planner 容易编造不存在的 schema term,也容易在多跳问题上只执行浅层检索。
- 现有路线:
- 普通 LLM / tool-calling KGQA 把当前问题直接转成 API 或 SPARQL,缺少历史计划记忆。
- ToG / ToG-2 一类方法强调多轮图搜索,但没有把成功 query plan 作为可复用缓存组织起来。
- Rethinking Agentic RAG - LLM-Driven Logical Retrieval Beyond Embeddings、DualGraph - Symbolic Querying and Semantic Retrieval for Semi-Structured QA 和 QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples 都说明:半结构化 QA 的关键不是“语义相似”,而是能否执行正确的查询逻辑。
- 对本知识库的意义:CacheRAG 把 GraphRAG中的图接口选择与任务类型、Query Execution 与 Retrieval 的区别 和 GraphRAG作为Query-Planning 连接起来。它不是单纯加一个向量缓存,而是把历史问题、物理查询计划和已验证答案组织成可检索的 plan memory。
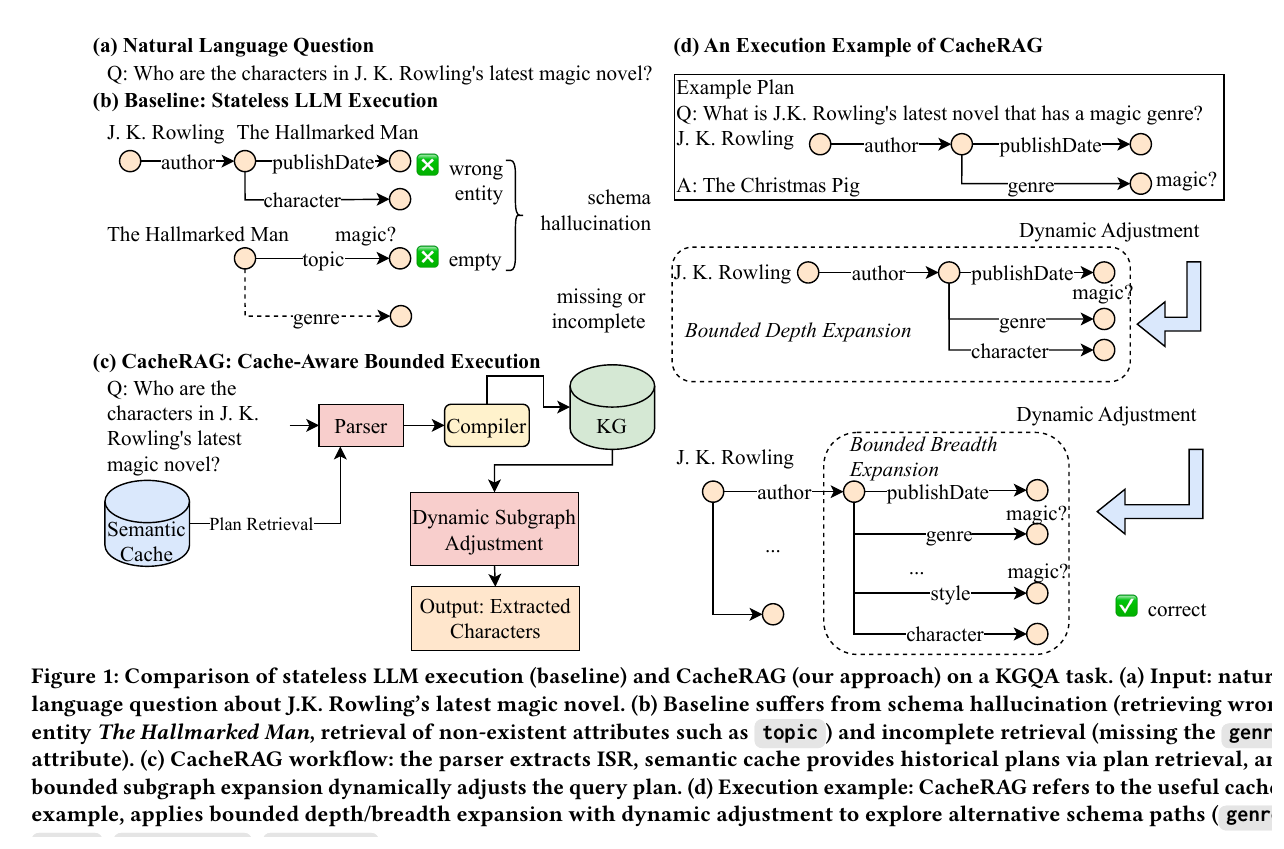
Figure 1 的关键对比是:baseline 在每次问题上重新猜 schema,可能取错实体、访问不存在属性或停在不完整子图;CacheRAG 先从语义缓存取历史计划,再用 bounded depth / breadth expansion 修正执行路径。
- Stateless planning:LLM 每次独立生成 query plan,不能从历史成功计划中学习 reusable schema path。
- Schema hallucination:直接让 LLM 输出 KG predicate / API call 容易生成图中不存在的属性或 relation。
- Cache retrieval redundancy:如果只按语义相似取 top-k,容易拿到一组结构相同的历史问题,浪费 prompt context,不能覆盖多种 query topology。
- Incomplete retrieval:初始 query plan 可能只拿到局部子图,缺少多跳链路或关键 1-hop 邻域。
- Cold-start:语义缓存一开始为空或很稀疏,系统需要在 cache miss 时仍能退化运行并把新成功计划写回缓存。
- 部署边界:论文展示了 CRAG / QALD / WebQSP / CWQ 结果,但正式代码、完整人工评测、动态 KG description 的定量图表仍需复查。
方法与机制
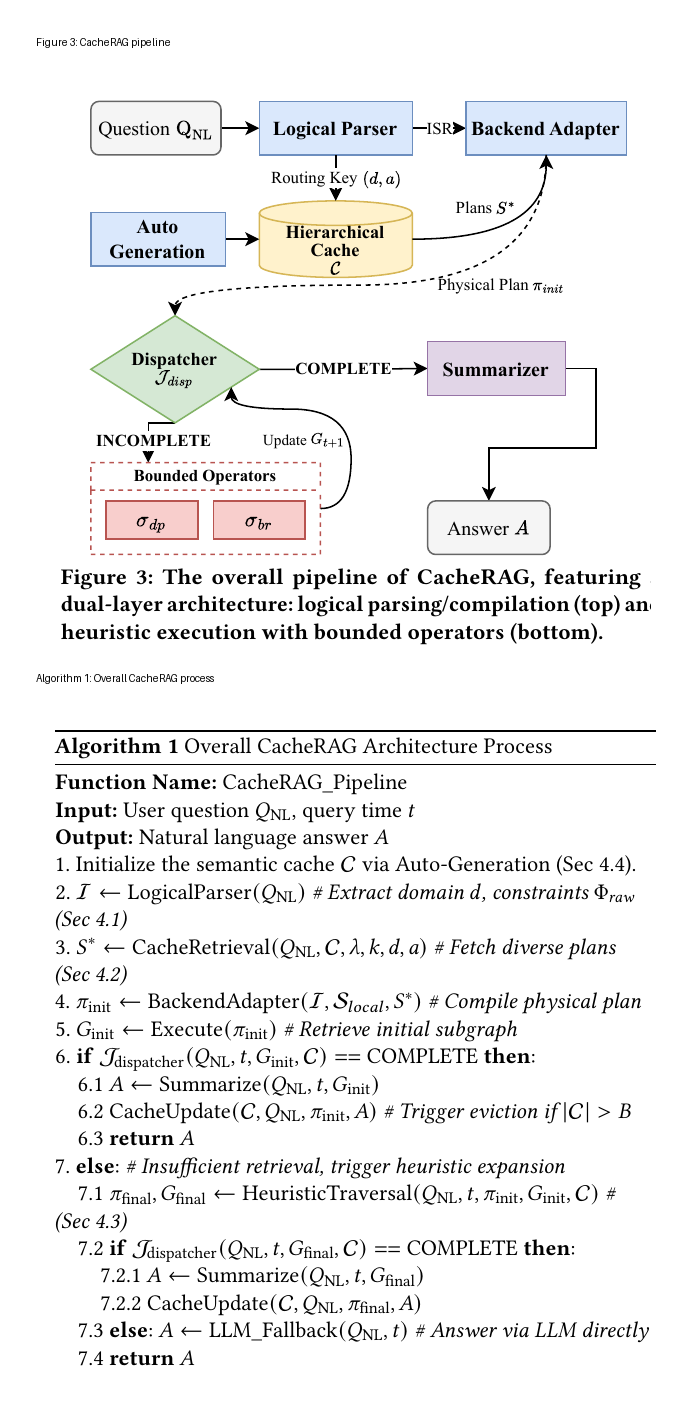
1. 总体框架:Logical Parsing -> Cache Retrieval -> Physical Compilation -> Bounded Execution
输入:自然语言问题 $Q_{NL}$、查询时间 $t$、知识图谱 $K$、本地 schema $S$、语义缓存 $C$。
计算链路:
- Auto-Generation 预热缓存,得到一批可执行历史计划。
- Logical Parser 把问题转成 schema-agnostic ISR:
其中 $e_{raw}$ 是原始主题实体,$\Phi_{raw}$ 是自然语言约束集合,$d$ 是 domain hint。
- Cache Retrieval 用 $(d,a)$ 定位缓存桶,并取多样历史计划 $S^*$。
- Backend Adapter 读取 topic entity 周围的本地物理 schema $S_{local}$,把 $\Phi_{raw}$ 映射为合法 predicate / API / SPARQL,形成初始计划:
- 执行 $\pi_{init}$ 得到初始子图 $G_{init}$。
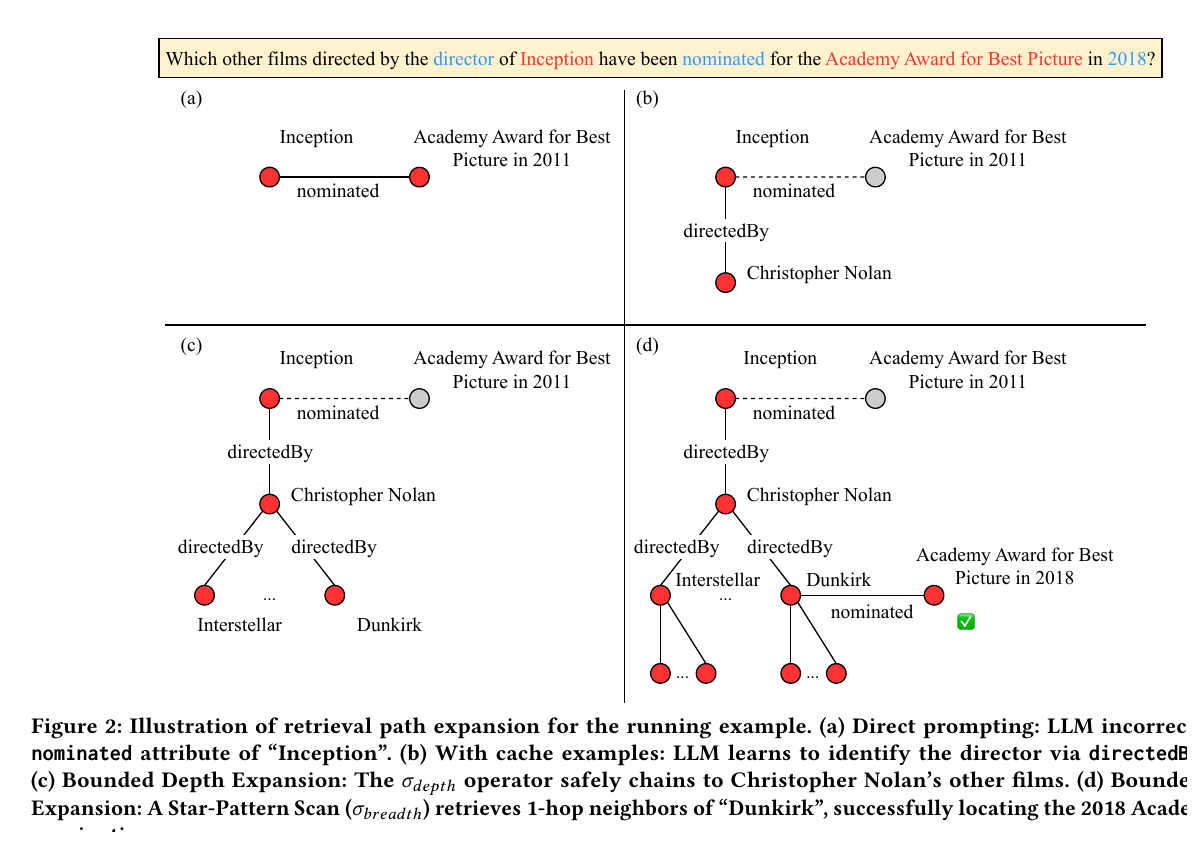
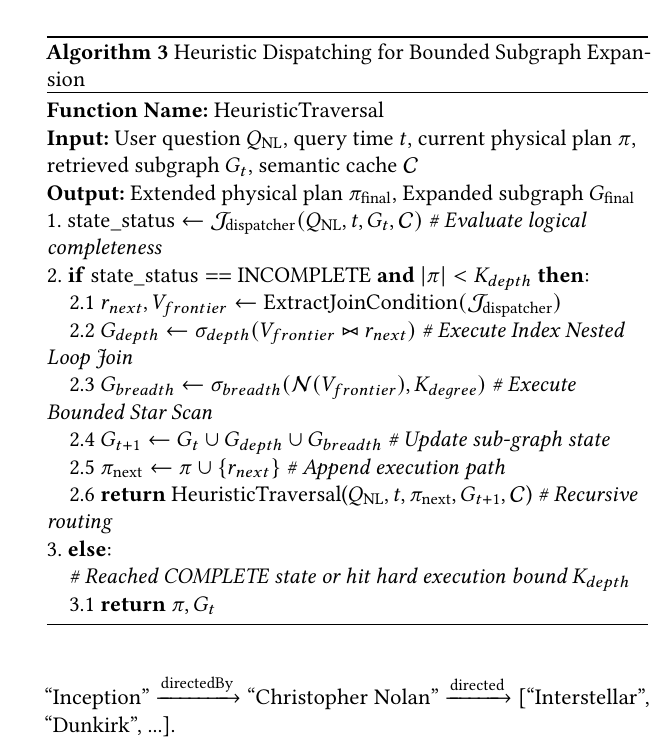
- Dispatcher 判断 $G_{init}$ 是否足够回答问题;若不足,触发有界 depth / breadth expansion。
- Summarizer 基于最终子图生成答案,并把成功轨迹写回缓存。
输出:自然语言答案 $A$、最终物理计划 $\pi_{final}$、最终证据子图 $G_{final}$、更新后的缓存 $C$。
直观解释:CacheRAG 把 KGQA 拆成“逻辑计划”和“物理执行”两层。LLM 不再直接猜 KG predicate,而是在本地合法 schema 和历史计划的约束下编译查询。
2. Semantic Cache:缓存的是可复用计划,而不是只缓存回答
输入:历史问题、已执行 query plan、已验证答案。
计算链路:
- 每条缓存项定义为:
其中 $Q_i\in NL$,$\pi_i$ 是 query plan,$A_i$ 是 verified answer。
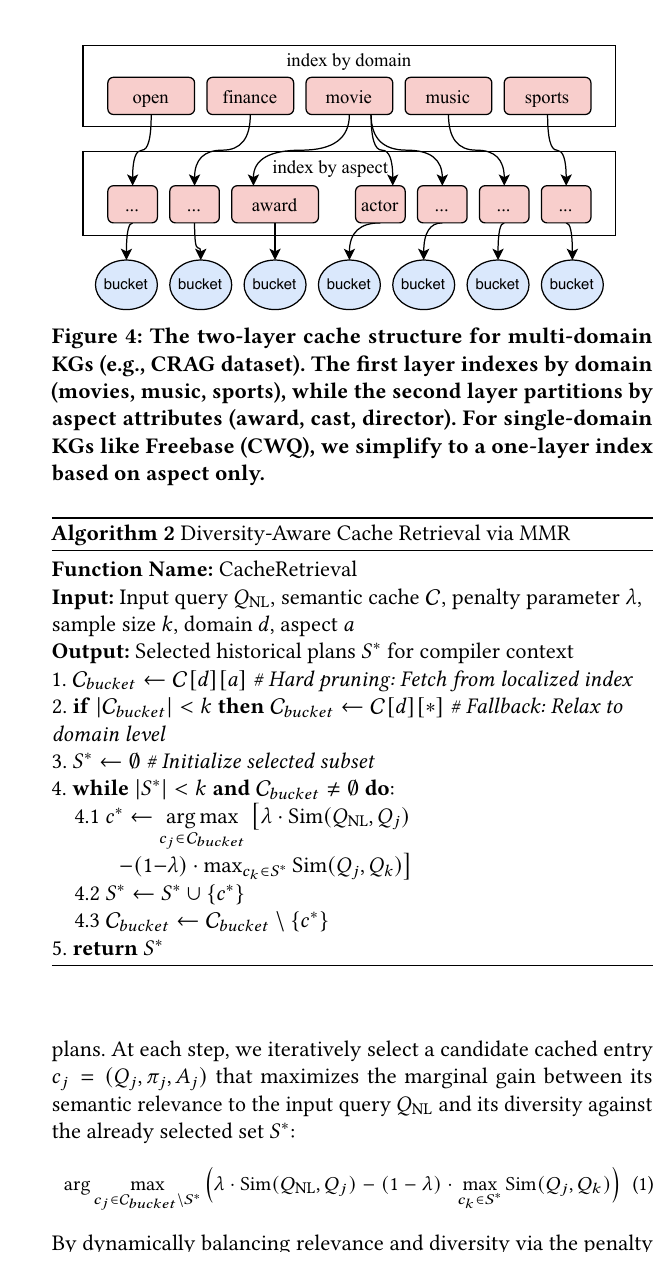
- 每条缓存项按 domain $d$ 和 aspect $a$ 建二级索引:
- 对多 domain KG,第一层按 domain 分桶,如 open / finance / movie / music / sports;第二层按 query aspect 分桶,如 award / actor / director。
- 对单 domain KG,退化成只按 aspect 的一层索引。
输出:可被 ISR routing key 快速定位的 plan memory。
直观解释:这一步把“历史 QA 经验”变成 planner 的可检索外部记忆。它不是 answer memoization,因为新问题可以复用旧计划结构但生成不同答案。
3. Diversity-Aware Cache Retrieval:Domain -> Aspect 硬剪枝 + MMR 软多样化
输入:当前问题 $Q_{NL}$、缓存 $C$、domain $d$、aspect $a$、样本数 $k$、权衡参数 $\lambda$。
计算链路:
- 先用 ISR routing key 取本地缓存桶:
- 若桶内样本不足,则退化到 domain-level:
- 在桶内用 MMR 逐个选择历史计划:
- 默认设置:$\lambda=0.5$,$k=5$,相似度 $Sim(\cdot)$ 用 BM25。
输出:结构上更互补的历史计划集合 $S^*$。
直观解释:Domain -> Aspect 负责把搜索空间从全局缓存缩到局部桶,MMR 负责避免取到 5 个几乎一样的示例。论文报告去掉 MMR 后 CRAG truthfulness 从 0.711 降到 0.682。
4. Two-Stage Compilation:先抽 ISR,再编译到合法物理 schema
输入:ISR $I=(e_{raw},\Phi_{raw},d)$、本地 schema $S_{local}$、历史计划 $S^*$。
计算链路:
- Logical Parser 只抽自然语言实体和约束,不允许生成 KG-specific predicate。
- Backend Adapter 针对 $e_{raw}$ 拉取合法本地 schema:
- Query Compiler 接收 $\Phi_{raw}$、$S_{local}$ 和 $S^*$,将自然语言约束 grounding 到合法 predicate / API / SPARQL。
- 若无法映射,则转入 breadth expansion 查找可能的多跳 schema path。
输出:可执行物理查询计划 $\pi_{init}$。
原始笔记摘录已截断;请打开来源笔记阅读完整内容。
证据与结果
CRAG 主结果
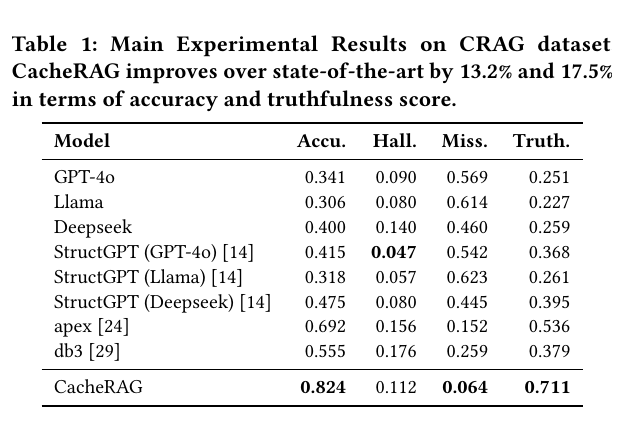
- CRAG 上 CacheRAG 的 Accu / Hall / Miss / Truth 为 0.824 / 0.112 / 0.064 / 0.711。
- 相比 SOTA,论文报告 accuracy 提升 13.2%,truthfulness 提升 17.5%。
- Retrieval recall 从 0.756 提升到 0.927,说明主要收益来自更完整的 KG evidence coverage。
- 代价是 hallucination 指标不总是最低:CacheRAG 的 Hall 0.112 高于 StructGPT(GPT-4o) 的 0.047。论文解释为召回更多长尾多跳上下文后,final summarizer 面对更复杂 synthesis。
泛化、消融和 backbone 鲁棒性
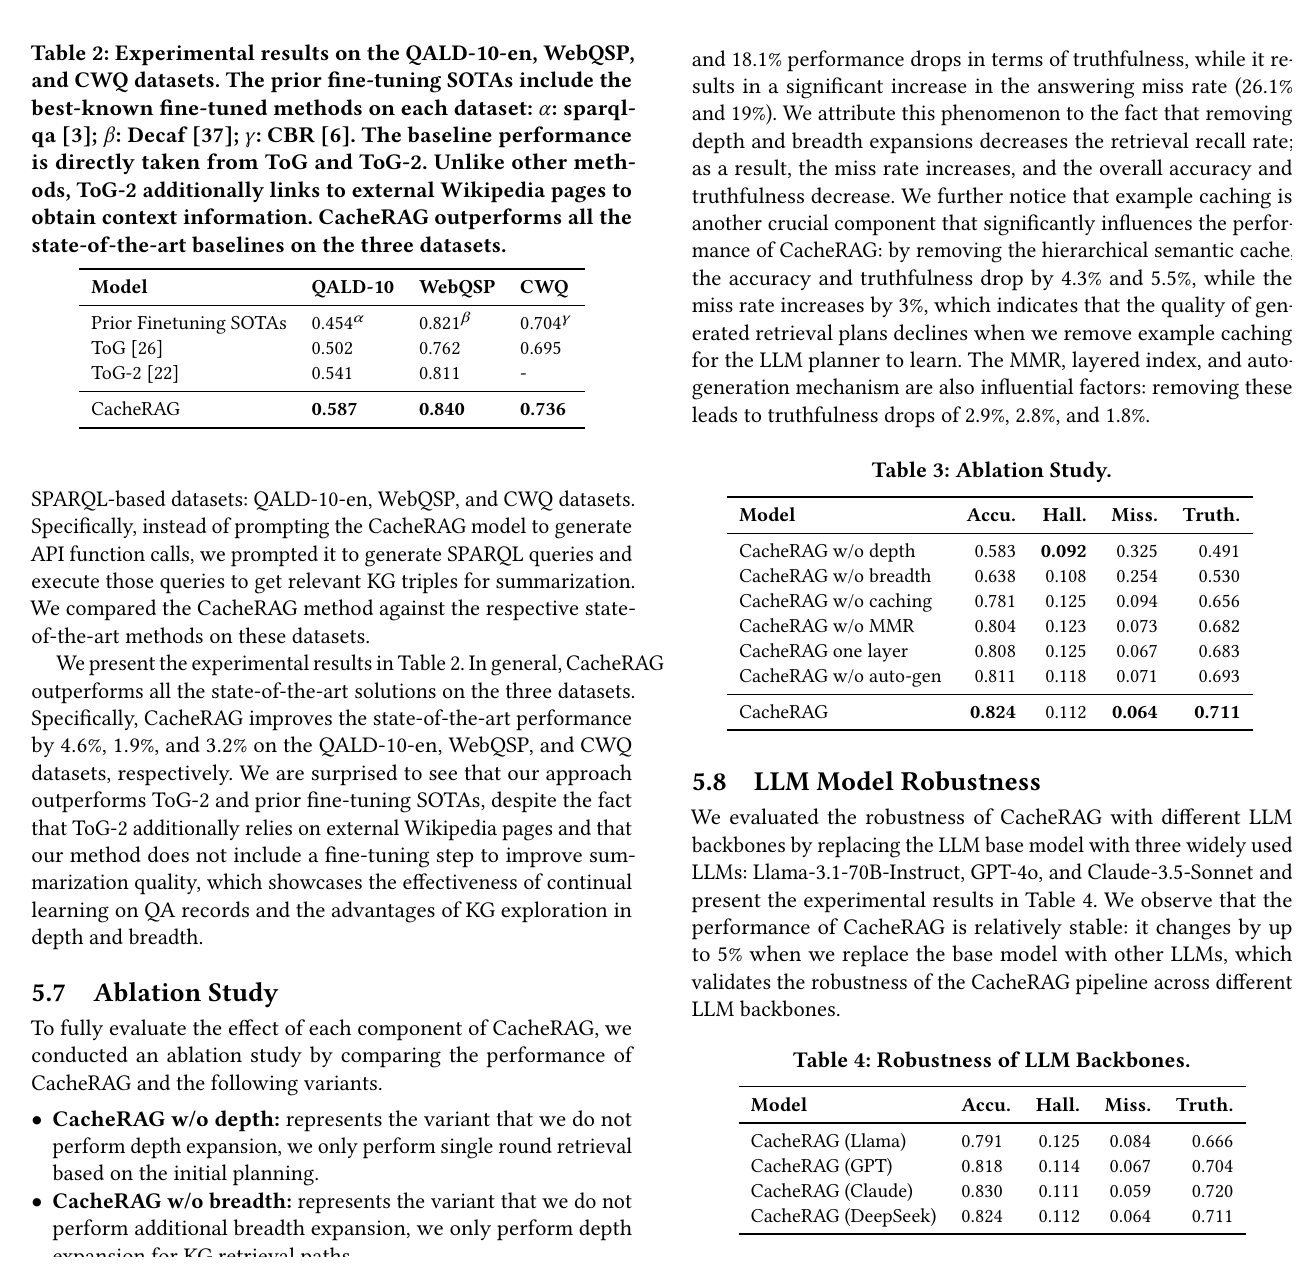
- QALD-10 / WebQSP / CWQ 上 CacheRAG 分别达到 0.587 / 0.840 / 0.736,高于 ToG / ToG-2 或 prior fine-tuning SOTA。
- 消融显示 depth / breadth expansion 是最大收益来源:去掉 depth 后 Accu 降到 0.583,去掉 breadth 后降到 0.638。
- 去掉 semantic caching 后 Accu / Truth 为 0.781 / 0.656,说明 plan memory 对质量有实质贡献。
- 去掉 MMR 后 Truth 为 0.682;one-layer cache 为 0.683,说明多样化检索和二级索引都有贡献。
- Backbone 替换下结果相对稳定:Llama / GPT / Claude / DeepSeek 的 Accu 在 0.791 到 0.830 之间。
效率、扩展性和 LRU cache
- CRAG 平均 inference time 为 9.44s,Apex 为 5.96s;CacheRAG 用额外 depth / breadth expansion 换准确率和 miss rate。
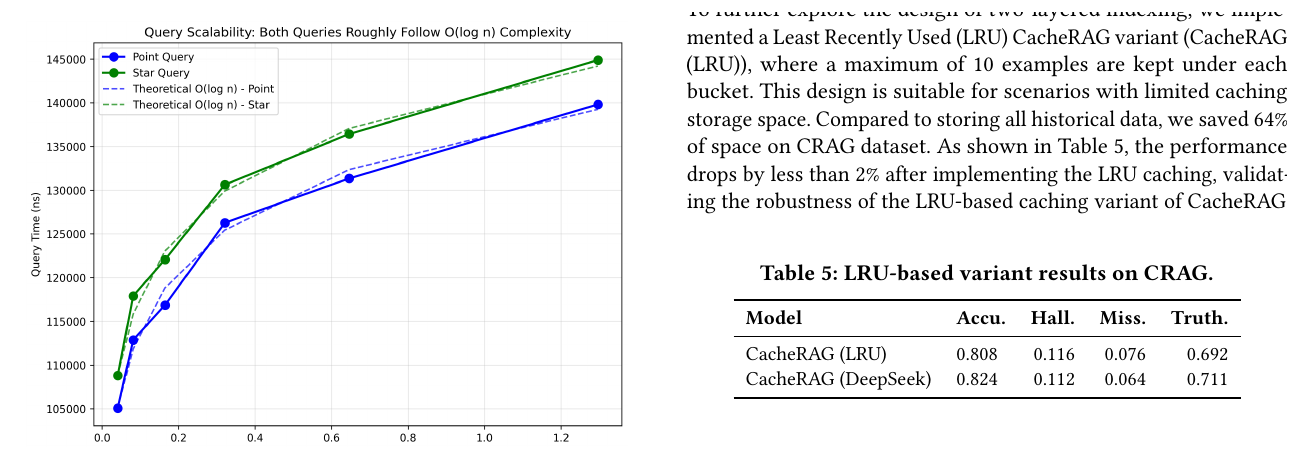
- 论文的合成 KG 实验显示 point query 和 star query 随 triple 数从 40K 到 1.28M 增长时呈近似 logarithmic growth。
- LRU variant 在每个 bucket 保留最多 10 个 examples,节省 64% storage,Accu / Truth 从 0.824 / 0.711 降到 0.808 / 0.692,性能下降小于 2%。
局限与开放问题
-
代码暂未找到,复现实验、prompt、cache construction 和 evaluator 细节仍需二次确认。
-
PDF 模板存在会议和 DOI 占位信息,正式发表状态不清晰。
-
Semantic Scholar 本轮查询遇到 429,citation、venue、external metadata 需要后续补查。
-
Auto-generation 依赖 LLM 生成和过滤训练样例,可能把错误 plan 写入缓存;论文没有充分展开错误缓存的清洗机制。
-
CacheRAG 主要验证 KGQA 和 SPARQL-based QA,对开放域文本 GraphRAG、文档级 GraphRAG、multi-modal GraphRAG 的泛化仍未知。
-
Hallucination 指标并非最低,说明检索覆盖提高后,summarizer 的 answer synthesis / evidence selection 仍是风险点。
-
Dynamic KG description cache 的附录定量结果有
Figure ??占位,当前只能把它视为思路,不应当作强证据。 -
缓存命中和 cache bucket 质量没有细粒度报告,例如 cache-hit type、retrieved-plan utility、plan reuse precision、cache poisoning 或 stale plan 风险。
-
Plan-cache routing:把 query complexity router 从“选 GraphRAG / LLM”扩展到“是否需要历史 plan cache、取多少 plans、是否需要 MMR 多样化”。
-
Cache attribution:记录每个 retrieved cached plan 是否实际改变 Backend Adapter 的 predicate choice、join path 或 fallback decision。
-
Error-aware cache update:加入 verified evidence、execution trace、answer verifier 和 rollback,避免错误计划进入长期缓存。
-
Hybrid interface router:把 CacheRAG 的 ISR + Backend Adapter 扩展成 semantic retrieval / lexical logical retrieval / SPARQL execution / API call / graph traversal 的统一路由器。
-
Post-retrieval reasoning:在 evidence 已召回但 summarizer 出错的样本上,加入 structured prompt、SPARQL CoT 或 answer verifier。
-
Cache + RL:把 cache hit、plan reuse、support gain、retrieval cost 和 final correctness 变成过程奖励,连接 Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning 和 GraphRAG-R1 - Process-Constrained Reinforcement Learning for GraphRAG。
-
Cache robustness:评估 stale cache、wrong plan cache、schema update、cache poisoning、domain misrouting 对 KGQA 的影响。
关联与拓展
- GraphRAG-Router - Cost-Efficient Routing over GraphRAGs and LLMs:GraphRAG-Router 负责后端和模型规模选择,CacheRAG 补上 plan cache / cache-hit / bounded expansion 作为路由维度。
- Rethinking Agentic RAG - LLM-Driven Logical Retrieval Beyond Embeddings:两者都从 dense retrieval 转向可执行检索逻辑;CacheRAG 更偏 KG schema 和 API/SPARQL 编译。
- DualGraph - Symbolic Querying and Semantic Retrieval for Semi-Structured QA:DualGraph 区分 TKG/SKG,CacheRAG 给了 schema-agnostic ISR 到物理 schema 的 adapter 模板。
- QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples:CacheRAG 的 plan cache 可作为 query-operator preservation 的历史轨迹来源。
- PRoH - Dynamic Planning over Knowledge Hypergraphs:PRoH 通过 reasoning DAG 动态改写计划,CacheRAG 通过历史 plan cache 和 bounded operators 复用/修正计划。
- LLM-Wiki - Retrieval as Reasoning via Self-Evolving Agent-Native Retrieval:LLM-Wiki 是 page/link traversal memory,CacheRAG 是 query-plan memory;两者都把检索结构变成 agent 可操作的外部记忆。
- DOTRAG - Retrieval-Time Reasoning Along Paths:DOTRAG 在 retrieval time 判断 path,CacheRAG 在执行阶段用 bounded expansion 和 dispatcher 补 path。
- GraphRAG作为Query-Planning:CacheRAG 是 query planning 视角下的典型系统:logical plan、physical plan、dispatcher、execution trace、cache update 都可记录。
- GraphRAG中的接口-代理-停止决策闭环:CacheRAG 的 Dispatcher、COMPLETE/INCOMPLETE 和 fallback 正好对应接口-代理-停止闭环。
- 2026-06-09-Open-Problems:连接 OP-3 query complexity routing、OP-10 planning-guided traversal attribution、OP-11 graph interface routing、OP-12 stage-aware deployment、OP-6 incremental graph memory update。
研究问题入口
Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略