研究问题与动机
-
研究问题:传统 RAG 主要检索 chunk,难以保留实体关系和多跳结构;传统 GraphRAG 虽然引入图结构,但常见流程仍是“离线建图、一次检索、长上下文生成”,缺少可学习的多轮检索策略。
-
为什么重要:GraphRAG 的新问题已经不只是“图怎么建”,而是“模型如何在图环境中逐步探索、判断是否继续检索、以及把检索轨迹和最终答案对齐”。这直接连接 GraphRAG作为Query-Planning 和 GraphRAG中的Agentic轨迹质量。
-
现有方法:
- StandardRAG 用 chunk semantic retrieval,结构弱。
- GraphRAG / LightRAG / PathRAG / HippoRAG2 / HyperGraphRAG 提供不同图结构,但多数依赖固定检索策略。
- Search-R1 / R1-Searcher 把 RL 用到多轮检索,但主要基于 chunk search,不直接利用图结构作为交互环境。
-
图构建成本高且可能损失语义:LLM 抽取实体关系会引入成本、漏边、错边和信息压缩。
-
检索过程固定:一次性 graph retrieval 很难处理需要逐步定位桥接实体的复杂问题。
-
生成阶段依赖长上下文和 prompt:图结构如果只被压成上下文,最终收益取决于 LLM 是否能从长上下文中正确选择路径。
-
RL 与 GraphRAG 的结合不充分:已有 RL search 证明了多轮检索价值,但 chunk 环境没有显式关系归纳偏置;已有 GraphRAG 又多数没有端到端策略学习。
方法与机制
总体框架
Figure 3 展示 Graph-R1 的核心闭环:输入问题后,agent 先在 <think> 中判断当前知识缺口,再生成 graph query,从 knowledge hypergraph 中取回 n-ary facts。如果证据仍不足,则继续 rethink 和 query;如果证据足够,则输出 <answer>。训练时用 F1 + format reward 对整条轨迹做端到端强化学习。
1. 轻量知识超图构建
输入:知识语料 K={d1,...,dN}。
计算:
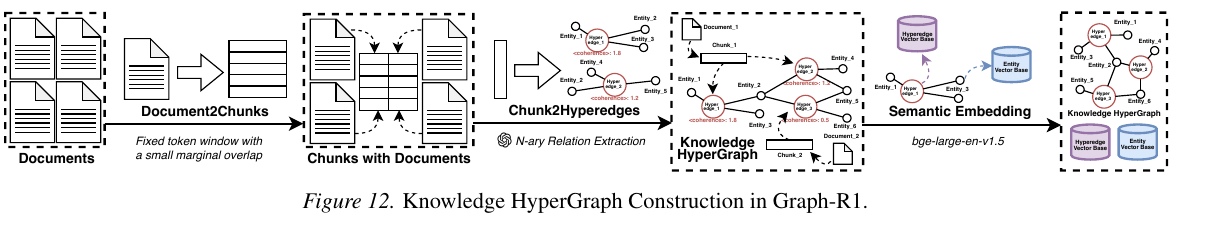
- 文档被切成 1200-token window,overlap 为 50 tokens。
- GPT-4o-mini 抽取 n-ary relational facts。每个事实包含语义片段
hi和参与实体集合V_hi={v1,...,vn}。 - 每个
hi形成一条 hyperedge,每个实体形成 node。 - 用
bge-large-en-v1.5为实体和 hyperedge 建向量索引。
形式化:
输出:可被语义检索和多轮查询的 knowledge hypergraph G_H。
2. Agent action space
每一步动作 a_t 由四类子动作组成:
a_t^think:反思当前状态,判断是否继续。a_t^query:生成检索查询。a_t^ret:从 hypergraph 返回相关 n-ary facts。a_t^ans:终止并输出最终答案。
动作有两种组合:
当 think -> continue 时执行上式;当 think -> terminate 时输出:
输出:一条由 state-action pair 组成的 reasoning trajectory。
3. Dual-path hypergraph retrieval
输入:agent 生成的 query a_t^query 和 hypergraph G_H=(V,E_H)。
计算一:entity-based hyperedge retrieval。先匹配 query 中的实体,再收集这些实体连接的 hyperedges:
计算二:direct hyperedge retrieval。直接按 query-hyperedge similarity 取 top hyperedges:
计算三:reciprocal rank aggregation 融合两路结果:
输出:当前轮返回给 agent 的 n-ary facts。
4. End-to-end RL / GRPO
输入:问题、knowledge hypergraph、当前策略 πθ、旧策略 πθold 和 N 条采样轨迹 {τ_i}。
计算目标:学习能产生正确答案的轨迹:
GRPO 目标使用 clipped advantage update:
其中:
奖励由 format reward 和 answer reward 组成:
原始笔记摘录已截断;请打开来源笔记阅读完整内容。
证据与结果
主结果:Graph-R1 在六个 RAG benchmark 上整体领先
- Qwen2.5-7B-Instruct 上,Graph-R1 平均 F1 为 57.82,高于 Search-R1 的 46.19、R1-Searcher 的 42.29、StandardRAG 的 15.89。
- GPT-4o-mini 的 HyperGraphRAG 平均 F1 为 29.40,说明“有 hypergraph 但没有端到端多轮 RL”并不足够。
- Graph-R1 在 2Wiki / HotpotQA / MuSiQue 三个多跳数据集上提升尤其明显:7B 下分别达到 65.04 / 62.69 / 46.17 F1。
- 解读:Graph-R1 的主要价值不是单独的超图表示,而是 hypergraph environment + multi-turn policy + answer-oriented RL 的组合。
Figure 2:RL over graph environment 的性能上界高于 chunk search
Figure 2 用同一组数据集直观比较 NaiveGeneration、StandardRAG、GraphRAG、HyperGraphRAG、Search-R1、R1-Searcher 和 Graph-R1。平均 F1 中 Graph-R1 为 57.8,Search-R1 为 46.2,R1-Searcher 为 42.3。这个结果支持一个更细的结论:RL 能提升 search policy,但当环境是 graph/hypergraph 而不是 chunk pool 时,上限更高。
消融与对比:三块核心组件都不能去掉
- 去掉 knowledge construction、multi-turn interaction 或 RL 都会下降。
- 不使用外部知识的模型最弱;chunk-based knowledge + RL 强于无知识,但低于 graph-based / hypergraph-based + RL。
- GRPO 明显优于 PPO 和 REINFORCE++,说明训练稳定性对 agentic GraphRAG 很关键。
- Qwen3-4B 虽然基础更强,但可能更依赖内部推理,Graph-R1 的上限略低于 Qwen2.5-3B 版本;这提示“模型越强越需要图”不是单调结论。
成本、效率和生成质量
- 2Wiki 上,Graph-R1 构建成本为 5.69s / 1K tokens 和 $2.81 / 1M tokens,低于 GraphRAG 的 8.04s / $3.35,也低于 HyperGraphRAG 的 6.76s / $4.14。
- Graph-R1 生成 120,499 nodes 和 98,073 edges,在线 TPQ 为 7.0s,CP1KQ 为 $0,F1 为 65.0。
- HotpotQA 上,Graph-R1 的响应长度约 1200-1500 tokens,交互轮数约 2.3-2.5,比 Search-R1 / R1-Searcher 更短但更有效。
- 生成质量评估中,Graph-R1 在 Correctness 86.9、Relevance 95.2、Logical Coherence 88.5 上表现强,整体分数 82.4,高于 Search-R1 的 70.3。
OOD 泛化:hypergraph retrieval 比 chunk search 更稳
-
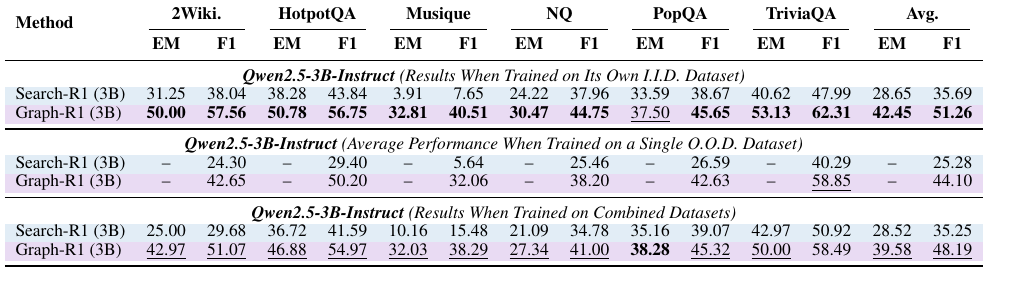
Qwen2.5-3B 在 IID setting 下,Graph-R1 平均 F1 为 51.26,Search-R1 为 35.69。
-
Single OOD training 下,Graph-R1 平均 F1 为 44.10,Search-R1 为 25.28。
-
Combined datasets training 下,Graph-R1 平均 F1 为 48.19,Search-R1 为 35.25。
-
解读:Graph-R1 的关系结构归纳偏置在跨数据集迁移时仍保留明显优势。
-
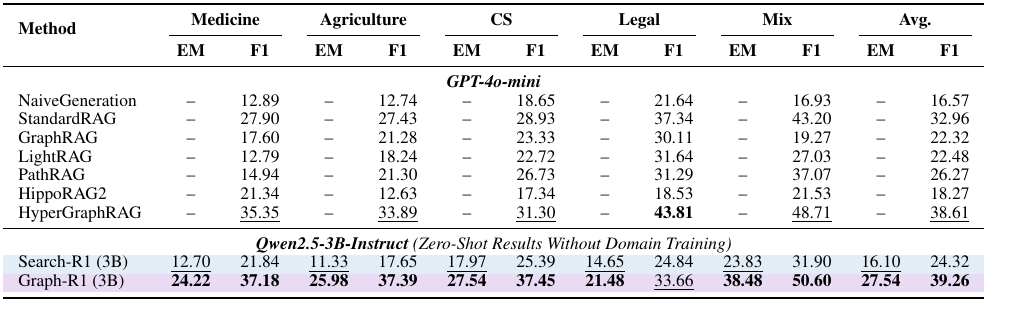
五个专门领域零样本结果中,Graph-R1 (3B) 平均 F1 为 39.26,高于 Search-R1 的 24.32,也略高于 GPT-4o-mini HyperGraphRAG 的 38.61。
-
Medicine / Agriculture / CS / Legal / Mix 上均超过 Search-R1,说明 hypergraph environment 对垂直领域关系推理有迁移价值。
局限与开放问题
-
奖励主要是 format reward + answer F1,没有显式奖励 retrieval relevance 或 path structural reliability;摘要中提到的“retrieval relevance / structural reliability”在正文实现里并未作为独立可复核奖励项展开。
-
仍依赖 GPT-4o-mini 做知识构建;虽然比 HyperGraphRAG 低成本,但不是纯本地、低算力方案。
-
多轮 agent 轨迹带来调试复杂度,需要保存 query、retrieved facts、turn utility、format validity 和 answer reward,才能解释失败原因。
-
实验主要是 QA benchmark,企业知识库、科研论文库、代码库、长期图记忆中的更新成本和错误累积仍需验证。
-
OOD 结果证明了跨数据集/跨领域倾向,但没有覆盖私有 schema、动态文档流或 adversarial graph noise。
-
作者 Future Work:论文主要指出 Graph-R1 为下一代 knowledge-driven、strategy-optimized agent 系统奠定基础,强调继续研究图结构和语言生成的端到端对齐。
-
Agent 推断的 Research Opportunities:
- 把 reward 拆得更细:answer reward、retrieval-turn utility、path coherence、support-set completion、citation faithfulness 分开记录。
- 和 GraphRAG-R1: Graph Retrieval-Augmented Generation with Process-Constrained Reinforcement Learning 做对照:Graph-R1 偏 outcome-directed end-to-end RL,GraphRAG-R1 可能更强调 process constraint。
- 用 Graph-R1 的 trajectory log 支撑 GraphRAG中的Agentic轨迹质量:哪些 turn 真正提高答案,哪些 query 是无效探索。
- 在 query complexity router 中加入“是否值得触发 Graph-R1 式多轮图环境交互”的决策,避免所有问题都走 RL agent。
- 增加 structural robustness:在 LogicPoison / GraphSteal 风格扰动下检查 RL policy 是否会过度相信错误 hyperedge。
关联与拓展
- 旧库内笔记:Graph-R1 - 已有摘要级/方法级笔记,本卡片补齐本轮工作流的 PDF级图表、公式和趋势连接。
- 相关论文:Do We Still Need GraphRAG - Agentic Search Benchmark、GraphRAG-Router - Cost-Efficient Routing over GraphRAGs and LLMs、A2RAG - Adaptive Agentic Graph Retrieval、Why Neighborhoods Matter - Traversal Context and Provenance in Agentic GraphRAG、Ex-GraphRAG - Interpretable Evidence Routing for Graph-Augmented LLMs
- 相关理论:GraphRAG中的Agentic轨迹质量、GraphRAG作为Query-Planning、Graph搜索的完备性与Beam-Search偏差、GraphRAG中的Query-Complexity与结构选择、GraphRAG中的接口-代理-停止决策闭环
- 可接到的 Open Problems:
- 2026-06-09-Open-Problems OP-3:判断什么时候需要 Graph-R1 式多轮图环境,而不是 dense RAG 或静态 GraphRAG。
- 2026-06-09-Open-Problems OP-10:记录 think/query/retrieve/answer 的 plan trace,做多轮图遍历归因。
- 2026-06-09-Open-Problems OP-18:把 retrieved facts、visited trajectory、final answer 和 reward 连接成 evidence-flow audit。
研究问题入口
Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略