GGraphRAG 文献图谱自动同步
LIT-B4B1DA19 · 2026

Ex-GraphRAG - Interpretable Evidence Routing for Graph-Augmented LLMs

Ex-GraphRAG 用 M-GNAN 替换 GraphRAG 的黑盒 GNN encoder,让 encoder 输出可以精确分解到节点和特征组,从而审计哪些实体真正影响了图条件表示。

PDF 级阅读卡优先级 P0Yoav Kor Sade, Arvindh Arun, Rishi Puri, Steffen Staab, Maya Bechler-Speicher发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:GraphRAG 常把 query-specific subgraph 编码成 soft prompt 或图表示,再交给 LLM 生成答案。但 GCN、GAT、GIN 这类 message-passing GNN 会在多层邻域聚合中混合节点贡献,最终 prompt 向量很难回答“哪些实体真正影响了 encoder 输出”。

  • 为什么重要:GraphRAG 的错误可能来自 retriever、graph encoder、context linearization 或 LLM。只知道系统检索了哪些节点,不等于知道这些节点是否真的进入了模型条件信息。在医疗、合规、科研证据审计这类场景,encoder-level attribution 是必要的。

  • 现有方法:GNNExplainer、SubgraphX、attention weight、gradient / perturbation attribution 都是 post-hoc 或近似解释。它们可以解释一个黑盒模型,但无法保证解释项就是模型前向计算里的真实贡献。

  • 对本知识库的意义:这篇论文把 Why Neighborhoods Matter - Traversal Context and Provenance in Agentic GraphRAG 的 trajectory provenance 继续推进到 encoder provenance:不仅要知道 agent 访问了什么、引用了什么,还要知道图 encoder 把哪些节点作为 conditioning signal 送进 LLM。它直接连接 OP-18。

  • GraphRAG 可解释性常停留在 retrieved subgraph 或 final citation,缺少 encoder-level evidence flow。

  • 黑盒 GNN encoder 的节点贡献被多跳 message passing 混合,缺少 closed-form per-node decomposition。

  • Attention 权重不一定等于因果贡献;post-hoc mask / Shapley 搜索也需要近似,不适合作为高风险审计证据。

  • 节点语义重要性和结构重要性可能分离:某些节点对 encoder 输出贡献很小,但作为 bridge node 对多跳连通性很关键。没有精确 attribution 时,这种 mismatch 容易被隐藏。

方法与机制

1. 整体输入输出:把 GraphRAG encoder 变成可分解模块

输入:

  • 自然语言 query。
  • 知识图谱中的节点文本/属性 embedding。
  • 由 query 检索出的 subgraph。

计算:

  1. 用 query embedding 找 top-k seed nodes。
  2. 从 seed nodes 扩展并用 PCST 构造 query-specific subgraph。
  3. 用 M-GNAN 编码 subgraph,而不是用 GAT / GCN / GIN。
  4. 从同一次 forward pass 中提取每个节点 / 特征组对 encoder 输出的 additive contribution。
  5. 将 M-GNAN node representations 通过 MLP 投影成 LLM soft prompt,同时把 subgraph linearized text 拼进输入。
  6. 用 LoRA 微调 LLM,并联合训练 M-GNAN encoder 和 projection layer。

输出:

  • LLM answer。
  • per-node / per-feature-group attribution。
  • 可用于 failure diagnosis 的 evidence routing map。

2. Graph construction:PCST-merge 取 query-specific subgraph

输入是 query $q$ 和 KG 节点 embedding。

作者先用 sentence transformer embedding 检索 top-$k=4$ seed nodes,再用两种方式扩展:

  • Single-hop PCST-merge:从 seed 做 1-hop candidate pool;对 query similarity top-100 节点赋 prize,用 uniform edge cost 跑 Prize-Collecting Steiner Tree;再和 top-200 相似节点诱导子图合并。
  • Multi-hop PCST-merge:从 seed 扩展 $h=3$ hops,每步只保留 query similarity top-$k_{seed}=5$ neighbors 控制规模;之后同样执行 PCST-plus-merge。

这一步的输出是 encoder 输入子图 $G_q=(V_q,E_q)$。single-hop 更干净,multi-hop 更能覆盖长路径,但会带入更多 intermediary nodes。

3. M-GNAN:把高维 embedding 分成 feature groups 做 additive graph encoding

普通 GNAN 按 scalar feature 做 shape function,但 GraphRAG 节点通常是 768 / 1536 维 embedding,单个维度不可解释。因此 Ex-GraphRAG 把特征维度划分成 feature groups:

F_g \subseteq \{1,\ldots,d\}, \quad g \in \{1,\ldots,G\}

对于常见的单一 node embedding,可以取:

G=1,\quad F_1=\{1,\ldots,d\}

每个 feature group 有一个 multivariate shape function:

f_g(x_g;\theta_g):\mathbb{R}^{|F_g|}\rightarrow \mathbb{R}

其中 $x_g$ 是节点 embedding 中属于 $F_g$ 的子向量。这个函数本身可以是 MLP,所以节点内部特征处理仍然是非线性的;约束发生在节点之间的组合方式上。

4. 节点表示与精确重要性分解

对目标节点 $i$ 和 feature group $g$,M-GNAN 计算:

[h_i]_g=\sum_{j=1}^{N}\frac{1}{\#dist(j,i)}\cdot \rho\left(\frac{1}{1+dist(j,i)}\right)\cdot f_g([x_j]_{F_g})

其中:

  • $dist(j,i)$:子图中节点 $j$ 到节点 $i$ 的最短路径距离。
  • $#dist(j,i)$:和 $j$ 到 $i$ 距离相同的节点数量,用于防止远处高连接邻域支配表示。
  • $\rho(\cdot)$:可学习单调函数,控制距离衰减。

图级输出可写成节点和 feature group 的 additive sum:

\sigma\left(\sum_{g=1}^{G}\sum_{i=1}^{N}[h_i]_g\right) = \sigma\left( \sum_{g=1}^{G}\sum_{j=1}^{N} f_g([x_j]_{F_g}) \sum_{i=1}^{N} \frac{1}{\#dist(j,i)} \rho\left(\frac{1}{1+dist(j,i)}\right) \right)

因此节点 $j$ 在 group $g$ 上的重要性就是内层项。它不是 post-hoc 估计,而是模型输出的组成部分。

5. Auditing:把 GraphRAG 失败拆到 retriever / encoder / LLM

有了 per-node attribution 后,错误诊断可以更细:

  • 如果重要性集中在 query-relevant entities,但 LLM 仍答错,问题更可能在 context construction、prompt use 或 generation。
  • 如果重要性集中在 irrelevant nodes,问题更可能在 subgraph composition 或 encoder training。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

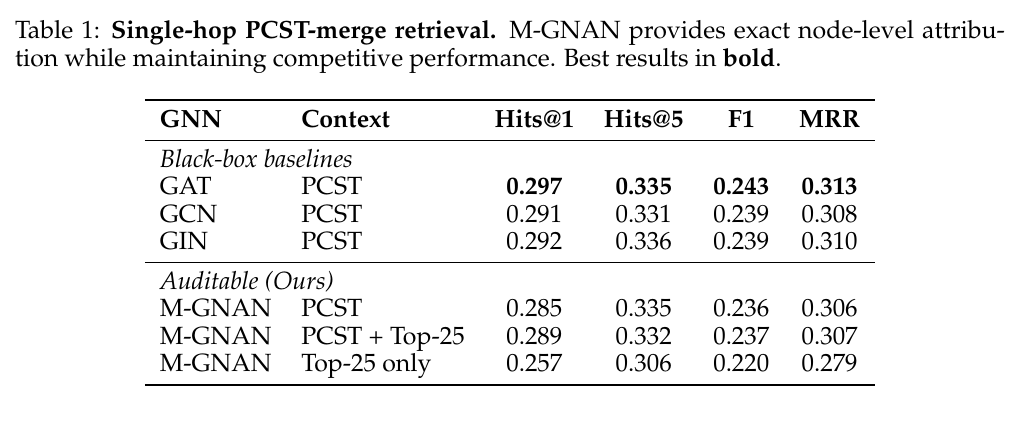
1. Single-hop:M-GNAN 接近黑盒 GNN,但获得精确归因

Table 1 说明,在 single-hop PCST-merge 上,M-GNAN + PCST 的 Hits@1 为 0.285,低于 GAT 的 0.297,但 Hits@5 与 GAT 同为 0.335。解释性带来的性能代价较小。

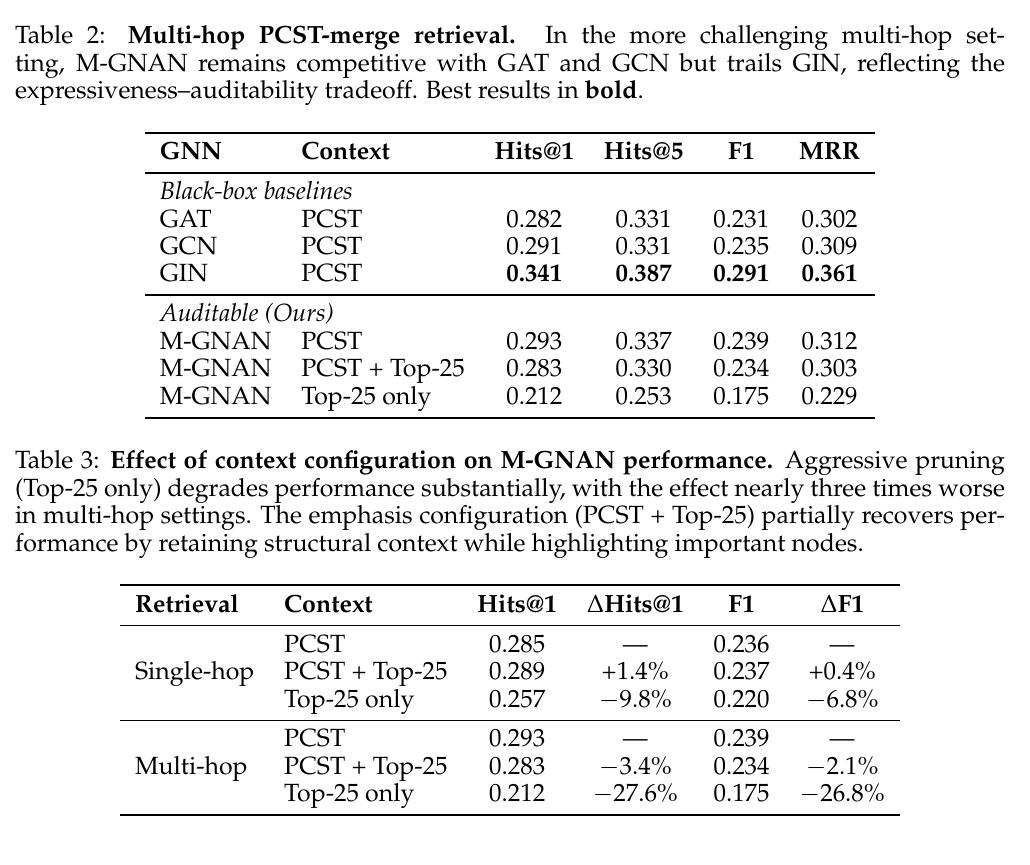
2. Multi-hop:出现 expressiveness-auditability tradeoff

Table 2 显示 multi-hop 设置中,M-GNAN Hits@1 为 0.293,高于 GAT 的 0.282,接近 GCN 的 0.291,但低于 GIN 的 0.341。这说明 M-GNAN 的 additive constraint 会牺牲一部分复杂结构建模能力。

Table 3 更关键:只保留 Top-25 高重要性节点会让 single-hop Hits@1 从 0.285 降到 0.257,multi-hop 从 0.293 降到 0.212,multi-hop 下降 27.6%。这说明 attribution 高的节点不是全部证据,低分 bridge nodes 对多跳连通性有独立价值。

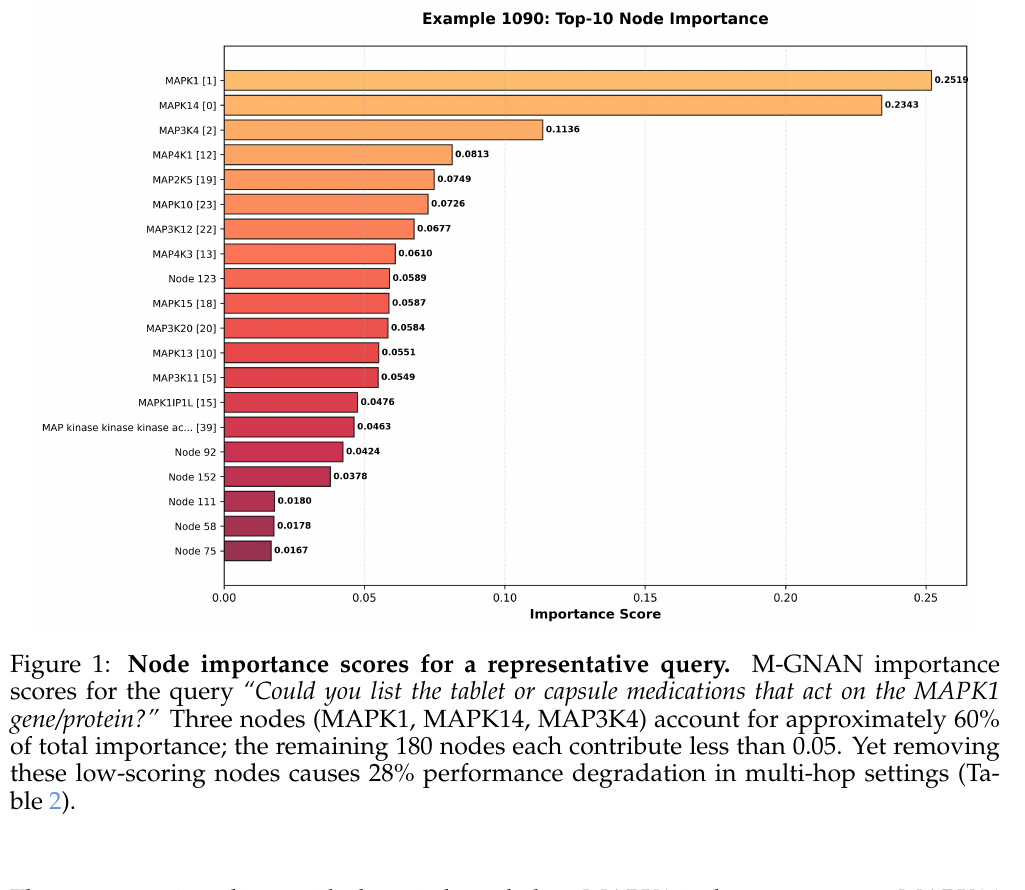
3. Case visualization:高 attribution 节点形成 semantic core

Figure 1 的 MAPK1 查询中,MAPK1、MAPK14、MAP3K4 三个节点贡献约 60% importance。这个结果符合 biomedical semantic core:它们与目标基因、相关 kinase 和上游 activator 相关。

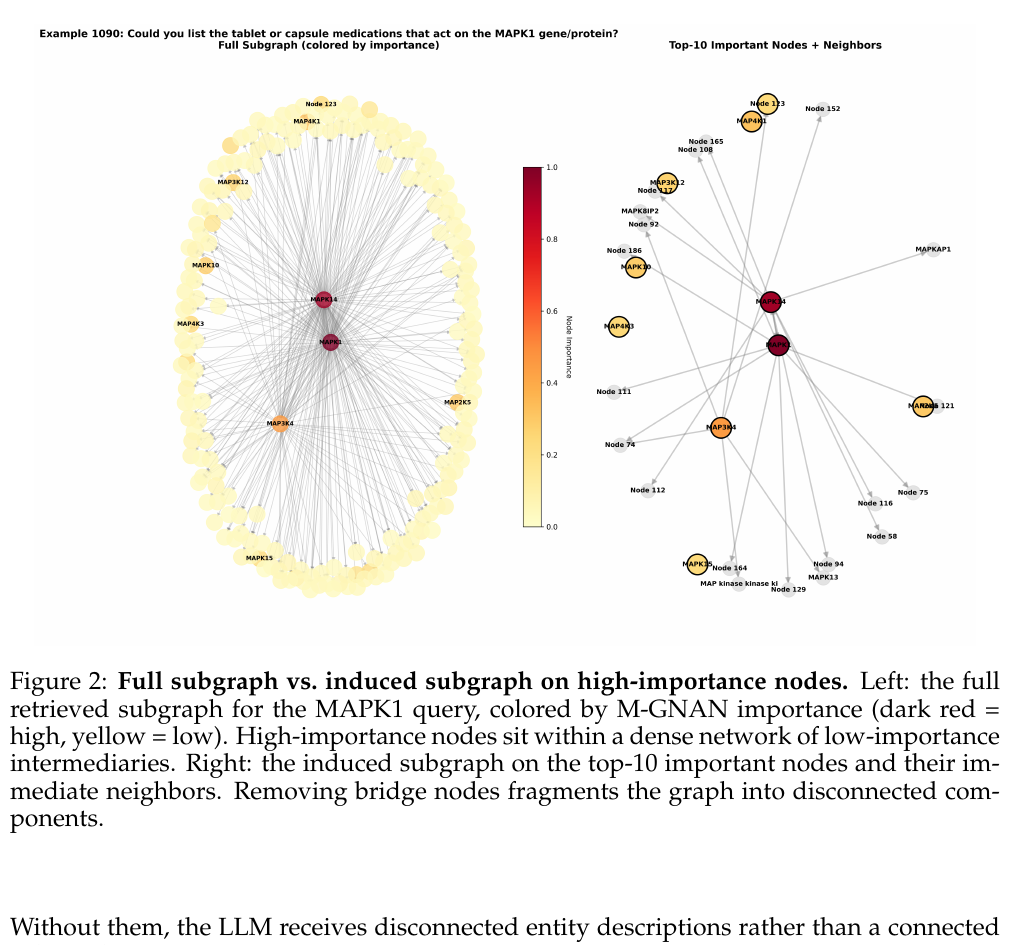
4. Semantic-structural mismatch:低分节点可能是关键结构桥

Figure 2 展示同一子图:左边完整子图里,高重要性节点嵌在大量低重要性 intermediary nodes 中;右边只保留 top important nodes 和邻居后,图被切成多个 disconnected components。

论文把这些低 attribution 但维持连通性的节点称为 bridge nodes。它们可能不是答案,也不是 encoder 语义输出的主贡献者,但删除后会破坏 LLM 需要的关系路径。这是 Ex-GraphRAG 对本知识库最重要的启发:解释性剪枝不能只看 semantic attribution,还要同时看 betweenness / connectivity / path preservation。

局限与开放问题

  • 只在 STaRK-Prime 一个 biomedical KGQA 数据集上评估,跨领域泛化还未证明。

  • 只详细审计了一个代表性 query;semantic-structural mismatch 需要更大规模 query-level 统计。

  • 没有把 M-GNAN attribution 与 GNNExplainer、SubgraphX、attention、gradient 等 post-hoc attribution 在同一 pipeline 下系统比较。

  • 没有报告多随机种子误差条,也没有做人类审计效率实验。

  • M-GNAN 的 additive constraint 在 multi-hop 上落后 GIN,说明可审计性和表达能力存在真实取舍。

  • 目前主要解释 encoder 输出,不直接解释 LLM 是否真正使用了 graph soft prompt 或 textualized context。

  • 作者提出的方向:

    • 在 STaRK-MAG 和其他 KGQA benchmark 上做多数据集验证。
    • 与 post-hoc explainability methods 在同一 G-Retriever pipeline 下比较。
    • 构造 composite importance,把 M-GNAN semantic attribution 与 betweenness centrality 等结构指标结合。
    • 做 user study,验证可解释 attribution 是否能帮助实践者更快诊断 retrieval failure。
  • Agent 推断的研究机会:

    • 为 OP-18 建立 evidence-flow log:retrieved_nodes -> encoded_node_contribution -> visited_nodes -> cited_nodes -> final_used_spans。
    • 设计 semantic + structural 双通道剪枝:保留 high attribution semantic core,同时保留 high betweenness bridge nodes。
    • 对 GraphRAG failure 做四层归因:retriever miss、encoder misweighting、context linearization loss、LLM synthesis error。
    • 和 Why Neighborhoods Matter - Traversal Context and Provenance in Agentic GraphRAG 结合,把 visited-but-uncited 节点再细分为 high encoded contribution、low encoded contribution but high structural bridge、完全冗余三类。
    • 和 STAR - Semantic-Tuned and Tail-Adaptive Retriever for GraphRAG 结合,区分 path retriever 的 semantic shortcut bias 与 encoder attribution mismatch。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略
展开原始论文笔记全文

基本信息

  • 英文标题:Ex-GraphRAG: Interpretable Evidence Routing for Graph-Augmented LLMs
  • 中文标题:Ex-GraphRAG:面向图增强大语言模型的可解释证据路由
  • 作者:Yoav Kor Sade, Arvindh Arun, Rishi Puri, Steffen Staab, Maya Bechler-Speicher
  • 机构:Tel Aviv University; Institute for AI, University of Stuttgart; NVIDIA; Meta AI
  • 年份:2026
  • 版本:arXiv v1,2026-05-21
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码 / 数据:论文未给出代码仓库;实验基于 STaRK-Prime 和 G-Retriever 风格设置。
  • 阅读状态:PDF级
  • 所属方向:GraphRAG explainability、encoder attribution、evidence routing audit、semantic-structural mismatch
  • 优先级:P0

Background

  • 研究问题:GraphRAG 常把 query-specific subgraph 编码成 soft prompt 或图表示,再交给 LLM 生成答案。但 GCN、GAT、GIN 这类 message-passing GNN 会在多层邻域聚合中混合节点贡献,最终 prompt 向量很难回答“哪些实体真正影响了 encoder 输出”。
  • 为什么重要:GraphRAG 的错误可能来自 retriever、graph encoder、context linearization 或 LLM。只知道系统检索了哪些节点,不等于知道这些节点是否真的进入了模型条件信息。在医疗、合规、科研证据审计这类场景,encoder-level attribution 是必要的。
  • 现有方法:GNNExplainer、SubgraphX、attention weight、gradient / perturbation attribution 都是 post-hoc 或近似解释。它们可以解释一个黑盒模型,但无法保证解释项就是模型前向计算里的真实贡献。
  • 对本知识库的意义:这篇论文把 Why Neighborhoods Matter - Traversal Context and Provenance in Agentic GraphRAG 的 trajectory provenance 继续推进到 encoder provenance:不仅要知道 agent 访问了什么、引用了什么,还要知道图 encoder 把哪些节点作为 conditioning signal 送进 LLM。它直接连接 OP-18。

Gap

  • GraphRAG 可解释性常停留在 retrieved subgraph 或 final citation,缺少 encoder-level evidence flow。
  • 黑盒 GNN encoder 的节点贡献被多跳 message passing 混合,缺少 closed-form per-node decomposition。
  • Attention 权重不一定等于因果贡献;post-hoc mask / Shapley 搜索也需要近似,不适合作为高风险审计证据。
  • 节点语义重要性和结构重要性可能分离:某些节点对 encoder 输出贡献很小,但作为 bridge node 对多跳连通性很关键。没有精确 attribution 时,这种 mismatch 容易被隐藏。

Insight

  • 一句话创新点:Ex-GraphRAG 用 M-GNAN 替换 GraphRAG 的黑盒 GNN encoder,让 encoder 输出可以精确分解到节点和特征组,从而审计哪些实体真正影响了图条件表示。
  • 核心洞察:
    • 可解释性不应只在生成后做 citation check,也要审计 graph encoder 的 evidence routing。
    • M-GNAN 的重要性分数不是额外训练的解释器,而是 encoder forward pass 的 additive partial sums。
    • 高 attribution 节点往往是语义核心节点;低 attribution 节点可能是结构桥。直接按 attribution 剪枝会破坏多跳连通性。
    • 因此 GraphRAG 的证据选择要同时考虑 semantic importance 和 structural importance。

Method

1. 整体输入输出:把 GraphRAG encoder 变成可分解模块

输入:

  • 自然语言 query。
  • 知识图谱中的节点文本/属性 embedding。
  • 由 query 检索出的 subgraph。

计算:

  1. 用 query embedding 找 top-k seed nodes。
  2. 从 seed nodes 扩展并用 PCST 构造 query-specific subgraph。
  3. 用 M-GNAN 编码 subgraph,而不是用 GAT / GCN / GIN。
  4. 从同一次 forward pass 中提取每个节点 / 特征组对 encoder 输出的 additive contribution。
  5. 将 M-GNAN node representations 通过 MLP 投影成 LLM soft prompt,同时把 subgraph linearized text 拼进输入。
  6. 用 LoRA 微调 LLM,并联合训练 M-GNAN encoder 和 projection layer。

输出:

  • LLM answer。
  • per-node / per-feature-group attribution。
  • 可用于 failure diagnosis 的 evidence routing map。

2. Graph construction:PCST-merge 取 query-specific subgraph

输入是 query $q$ 和 KG 节点 embedding。

作者先用 sentence transformer embedding 检索 top-$k=4$ seed nodes,再用两种方式扩展:

  • Single-hop PCST-merge:从 seed 做 1-hop candidate pool;对 query similarity top-100 节点赋 prize,用 uniform edge cost 跑 Prize-Collecting Steiner Tree;再和 top-200 相似节点诱导子图合并。
  • Multi-hop PCST-merge:从 seed 扩展 $h=3$ hops,每步只保留 query similarity top-$k_{seed}=5$ neighbors 控制规模;之后同样执行 PCST-plus-merge。

这一步的输出是 encoder 输入子图 $G_q=(V_q,E_q)$。single-hop 更干净,multi-hop 更能覆盖长路径,但会带入更多 intermediary nodes。

3. M-GNAN:把高维 embedding 分成 feature groups 做 additive graph encoding

普通 GNAN 按 scalar feature 做 shape function,但 GraphRAG 节点通常是 768 / 1536 维 embedding,单个维度不可解释。因此 Ex-GraphRAG 把特征维度划分成 feature groups:

F_g \subseteq \{1,\ldots,d\}, \quad g \in \{1,\ldots,G\}

对于常见的单一 node embedding,可以取:

G=1,\quad F_1=\{1,\ldots,d\}

每个 feature group 有一个 multivariate shape function:

f_g(x_g;\theta_g):\mathbb{R}^{|F_g|}\rightarrow \mathbb{R}

其中 $x_g$ 是节点 embedding 中属于 $F_g$ 的子向量。这个函数本身可以是 MLP,所以节点内部特征处理仍然是非线性的;约束发生在节点之间的组合方式上。

4. 节点表示与精确重要性分解

对目标节点 $i$ 和 feature group $g$,M-GNAN 计算:

[h_i]_g=\sum_{j=1}^{N}\frac{1}{\#dist(j,i)}\cdot \rho\left(\frac{1}{1+dist(j,i)}\right)\cdot f_g([x_j]_{F_g})

其中:

  • $dist(j,i)$:子图中节点 $j$ 到节点 $i$ 的最短路径距离。
  • $#dist(j,i)$:和 $j$ 到 $i$ 距离相同的节点数量,用于防止远处高连接邻域支配表示。
  • $\rho(\cdot)$:可学习单调函数,控制距离衰减。

图级输出可写成节点和 feature group 的 additive sum:

\sigma\left(\sum_{g=1}^{G}\sum_{i=1}^{N}[h_i]_g\right) = \sigma\left( \sum_{g=1}^{G}\sum_{j=1}^{N} f_g([x_j]_{F_g}) \sum_{i=1}^{N} \frac{1}{\#dist(j,i)} \rho\left(\frac{1}{1+dist(j,i)}\right) \right)

因此节点 $j$ 在 group $g$ 上的重要性就是内层项。它不是 post-hoc 估计,而是模型输出的组成部分。

5. Auditing:把 GraphRAG 失败拆到 retriever / encoder / LLM

有了 per-node attribution 后,错误诊断可以更细:

  • 如果重要性集中在 query-relevant entities,但 LLM 仍答错,问题更可能在 context construction、prompt use 或 generation。
  • 如果重要性集中在 irrelevant nodes,问题更可能在 subgraph composition 或 encoder training。
  • 如果 high-attribution nodes 彼此断裂,需要保留低 attribution bridge nodes,而不是直接按重要性剪枝。

这把 GraphRAG 证据流从 retrieved -> cited 扩展为:

retrieved\ nodes \rightarrow encoded\ contribution \rightarrow graph\ soft\ prompt \rightarrow textualized\ context \rightarrow final\ answer

Results

1. Single-hop:M-GNAN 接近黑盒 GNN,但获得精确归因

ExGraphRAG-table1-single-hop

Table 1 说明,在 single-hop PCST-merge 上,M-GNAN + PCST 的 Hits@1 为 0.285,低于 GAT 的 0.297,但 Hits@5 与 GAT 同为 0.335。解释性带来的性能代价较小。

2. Multi-hop:出现 expressiveness-auditability tradeoff

ExGraphRAG-table2-table3-multihop-context

Table 2 显示 multi-hop 设置中,M-GNAN Hits@1 为 0.293,高于 GAT 的 0.282,接近 GCN 的 0.291,但低于 GIN 的 0.341。这说明 M-GNAN 的 additive constraint 会牺牲一部分复杂结构建模能力。

Table 3 更关键:只保留 Top-25 高重要性节点会让 single-hop Hits@1 从 0.285 降到 0.257,multi-hop 从 0.293 降到 0.212,multi-hop 下降 27.6%。这说明 attribution 高的节点不是全部证据,低分 bridge nodes 对多跳连通性有独立价值。

3. Case visualization:高 attribution 节点形成 semantic core

ExGraphRAG-fig1-node-importance

Figure 1 的 MAPK1 查询中,MAPK1、MAPK14、MAP3K4 三个节点贡献约 60% importance。这个结果符合 biomedical semantic core:它们与目标基因、相关 kinase 和上游 activator 相关。

4. Semantic-structural mismatch:低分节点可能是关键结构桥

ExGraphRAG-fig2-structural-fragmentation

Figure 2 展示同一子图:左边完整子图里,高重要性节点嵌在大量低重要性 intermediary nodes 中;右边只保留 top important nodes 和邻居后,图被切成多个 disconnected components。

论文把这些低 attribution 但维持连通性的节点称为 bridge nodes。它们可能不是答案,也不是 encoder 语义输出的主贡献者,但删除后会破坏 LLM 需要的关系路径。这是 Ex-GraphRAG 对本知识库最重要的启发:解释性剪枝不能只看 semantic attribution,还要同时看 betweenness / connectivity / path preservation。

Limitations

  • 只在 STaRK-Prime 一个 biomedical KGQA 数据集上评估,跨领域泛化还未证明。
  • 只详细审计了一个代表性 query;semantic-structural mismatch 需要更大规模 query-level 统计。
  • 没有把 M-GNAN attribution 与 GNNExplainer、SubgraphX、attention、gradient 等 post-hoc attribution 在同一 pipeline 下系统比较。
  • 没有报告多随机种子误差条,也没有做人类审计效率实验。
  • M-GNAN 的 additive constraint 在 multi-hop 上落后 GIN,说明可审计性和表达能力存在真实取舍。
  • 目前主要解释 encoder 输出,不直接解释 LLM 是否真正使用了 graph soft prompt 或 textualized context。

Future Directions

  • 作者提出的方向:
    • 在 STaRK-MAG 和其他 KGQA benchmark 上做多数据集验证。
    • 与 post-hoc explainability methods 在同一 G-Retriever pipeline 下比较。
    • 构造 composite importance,把 M-GNAN semantic attribution 与 betweenness centrality 等结构指标结合。
    • 做 user study,验证可解释 attribution 是否能帮助实践者更快诊断 retrieval failure。
  • Agent 推断的研究机会:
    • 为 OP-18 建立 evidence-flow log:retrieved_nodes -> encoded_node_contribution -> visited_nodes -> cited_nodes -> final_used_spans。
    • 设计 semantic + structural 双通道剪枝:保留 high attribution semantic core,同时保留 high betweenness bridge nodes。
    • 对 GraphRAG failure 做四层归因:retriever miss、encoder misweighting、context linearization loss、LLM synthesis error。
    • 和 Why Neighborhoods Matter - Traversal Context and Provenance in Agentic GraphRAG 结合,把 visited-but-uncited 节点再细分为 high encoded contribution、low encoded contribution but high structural bridge、完全冗余三类。
    • 和 STAR - Semantic-Tuned and Tail-Adaptive Retriever for GraphRAG 结合,区分 path retriever 的 semantic shortcut bias 与 encoder attribution mismatch。

与本知识库的连接

一句话定位

Ex-GraphRAG 的核心价值是把 GraphRAG 的解释对象从“检索到哪些节点”推进到“哪些节点真正进入 encoder 表示”,并揭示了高语义贡献节点与低贡献结构桥节点之间的 semantic-structural mismatch。