GGraphRAG 文献图谱自动同步
LIT-0147739C · 2026

GraphRAG-Router - Cost-Efficient Routing over GraphRAGs and LLMs

GraphRAG-Router 把检索后端选择和生成 LLM 选择拆成层次化动作,并用 SFT + 两阶段 RL 学习何时使用哪种 GraphRAG-LLM 组合。

PDF 级阅读卡优先级 P1Dongzhe Fan, Chuanhao Ji, Zimu Wang, Tong Chen, Qiaoyu Tan发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:现有 GraphRAG 系统通常采用固定检索后端和固定生成 LLM。这个 one-size-fits-all 设计在 mixed workload 中不经济:简单问题不需要昂贵大模型,复杂多跳问题又可能需要更强的图结构和生成模型。

  • 为什么重要:这篇论文正好把 GraphRAG中的Query-Complexity与结构选择 往前推进一步:不仅要判断“要不要 GraphRAG”,还要判断“用哪一种 GraphRAG + 哪一种 LLM”。

  • 现有方法:

    • GraphRAG / RAPTOR / HippoRAG2 / HyperGraphRAG / LinearRAG 等后端各有结构偏好。
    • Router-R1 这类方法主要在多个 generator LLM 之间路由,但不同时选择 GraphRAG 后端。
    • Do We Still Need GraphRAG - Agentic Search Benchmark 已说明:显式图结构的收益随 query complexity、agentic search 能力和成本预算变化。
  • 固定 GraphRAG 后端无法覆盖所有 query 的证据粒度需求:有的问题需要局部实体事实,有的问题需要 community summary,有的问题需要多跳结构。

  • 固定大模型生成会产生过度调用成本;固定小模型又会在困难问题上牺牲准确率。

  • 如果把 GraphRAG 和 LLM 作为一个组合动作直接选择,动作空间是 |G| * |L|,优化难度高。

  • 现有 LLM routing 工作通常只路由生成模型,没有把 retrieval infrastructure 一起纳入决策。

方法与机制

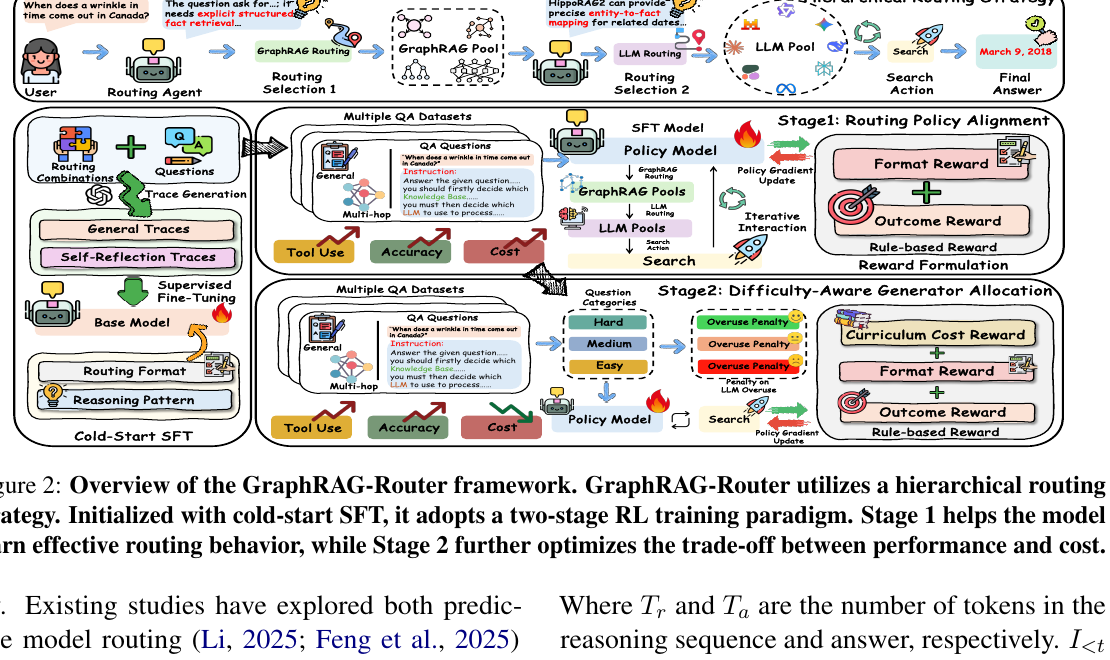
  • 整体框架:GraphRAG-Router 是一个 multi-round routing agent。每一轮先分析 query,选择 GraphRAG 后端,再选择 generator LLM,调用 <search> Question:LLM;GraphRAG </search> 获得信息,必要时继续换后端或换模型,最终输出答案。

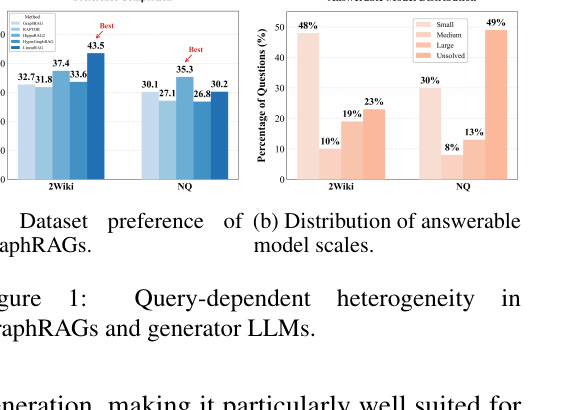
Figure 1 是论文动机证据。左图显示不同数据集偏好的 GraphRAG 后端不同;右图显示同一数据集内有大量问题可由 small / medium 模型回答,不必总调用 large LLM。这直接支撑“GraphRAG 后端 + LLM 规模都应按 query 路由”。

Figure 2 展示完整流程:

  • Cold-start SFT:用 general traces 和 self-reflection traces 让模型先学会合法的路由格式、思考顺序和多轮自反思。
  • Stage 1 Routing Policy Alignment:用 format reward + outcome reward 让模型学会有效路由。
  • Stage 2 Difficulty-Aware Generator Allocation:加入 curriculum cost reward,减少不必要的大模型调用。

路由问题形式化

给定 query q、GraphRAG 候选池 G={g1,...,gn}、生成模型候选池 L={l1,...,lm},学习一个策略 πθ。在第 t 轮:

g_t, l_t \sim \pi_\theta(\cdot \mid q, s_t, G, L)

被选中的 GraphRAG-LLM pair 返回信息:

I_t = l_t(q, g_t(q))

论文把生成过程写成 reasoning 和 answer 两部分:

P(R,a\mid q,T,I)= \prod_{t=1}^{T_r}P(R_t\mid R_{<t},q,T,I_{<t}) \prod_{t=1}^{T_a}P(a_t\mid a_{<t},R,q,T)

层次化路由把每步动作空间从:

O(|G|\cdot |L|)

降为:

O(|G|+|L|)

Cold-start SFT

  • General trace:先找能答对问题的 (GraphRAG, LLM) pair,再用强模型生成合法、简短、结构化的路由轨迹。
  • Self-reflection trace:构造第一轮证据不足、第二轮改换 GraphRAG 或 LLM 后答对的轨迹,让模型学习 rerouting。

SFT 目标:

L_{SFT}=-\mathbb{E}_{(x,y)\sim D_{SFT}}\left[\sum_{t=1}^{|y|}\log P_\theta(y_t\mid x,y_{<t})\right]

两阶段 RL

Stage 1 的目标是先学会“会路由、格式合法、能答对”:

\max_{\pi_\theta}\mathbb{E}_{x\sim D,y\sim\pi_\theta(\cdot\mid x;G,L)} \left[r_\phi(x,y)-\beta D_{KL}(\pi_\theta(y\mid x;G,L)\Vert \pi_{ref}(y\mid x;G,L))\right]

奖励由格式奖励和最终答案奖励组成:

r_\phi(x,y)=r_{format}(y)+r_{outcome}

其中 outcome reward 使用 Exact Match:

r_{outcome}=EM(a,a_{gt})

格式奖励不是简单 0/1,而是按错误类型扣分:

r_{format}(y)=-\min\left(1,\sum_{k=1}^{K}\lambda_k I_k(y)\right)

Stage 2 加入 difficulty-aware cost optimization。先通过多次 direct inference 估计每个模型对问题 q 的成功率:

SR(l_m,q)=\frac{c(l_m,q)}{N}

如果 SR(l_m,q) >= \tau,说明该模型规模能可靠回答问题。问题难度定义为能可靠回答它的最小模型规模:

m(q)=\min s\in\{small,medium,large\}\ \text{s.t.}\ SR(q,s)\ge\tau

再定义最小所需成本:

C_{min}(q)=\min \{C(l_m)\mid SR(l_m,q)\ge\tau\}

若路由选择了比必要成本更高的模型,则按难度加权惩罚:

r_{cost}(y)=\beta w_{D(q)}\max(0,C(l_m)-C_{min}(q))

最终奖励:

r_\phi(x,y)=r_{format}(y)+r_{outcome}-\mathbb{1}_{Correct}r_{cost}(y)

关键点是:只有答对后才扣过度成本。这样模型不会为了省钱牺牲 correctness,而是在正确轨迹中寻找最小充分模型。

证据与结果

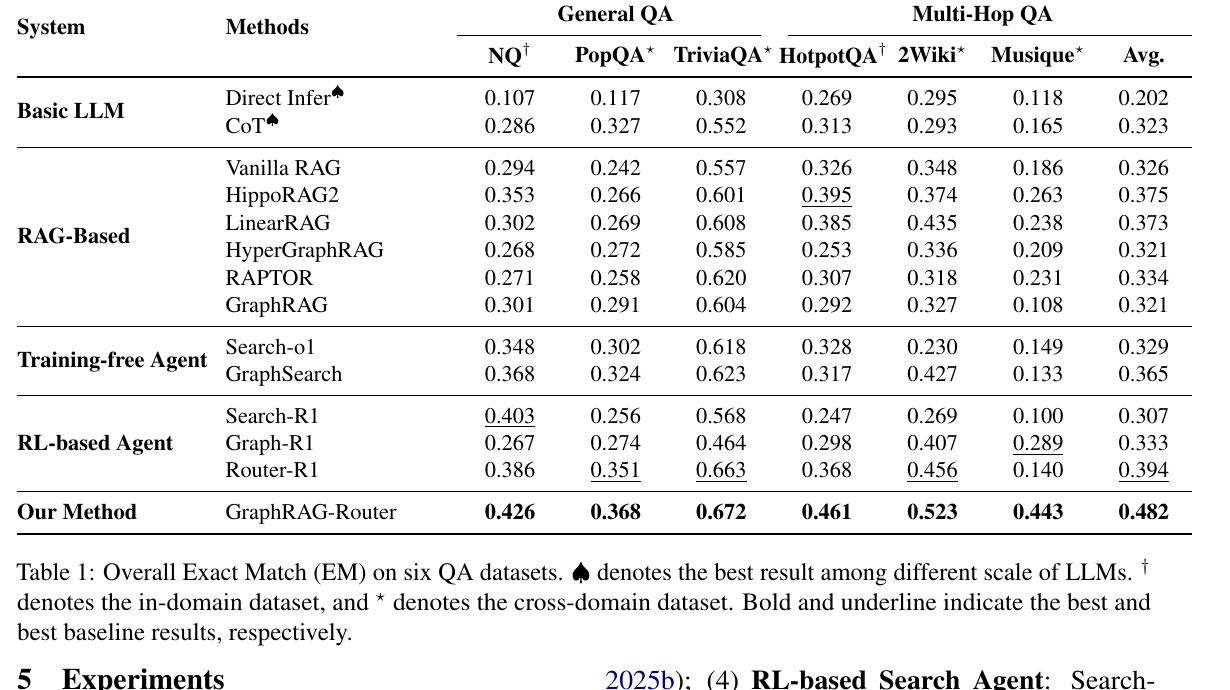
主结果:GraphRAG-Router 在平均 EM 上领先,multi-hop 提升更明显

  • GraphRAG-Router 平均 EM 为 0.482,高于最好基线 Router-R1 的 0.394。
  • General QA 上提升较温和:NQ 0.426、PopQA 0.368、TriviaQA 0.672。
  • Multi-hop QA 上提升更明显:HotpotQA 0.461、2Wiki 0.523、MuSiQue 0.443。
  • MuSiQue 最能说明问题:Graph-R1 为 0.289,Router-R1 为 0.140,GraphRAG-Router 达到 0.443,说明“同时选 GraphRAG 后端和 LLM”比只做模型路由更适合复杂多跳。

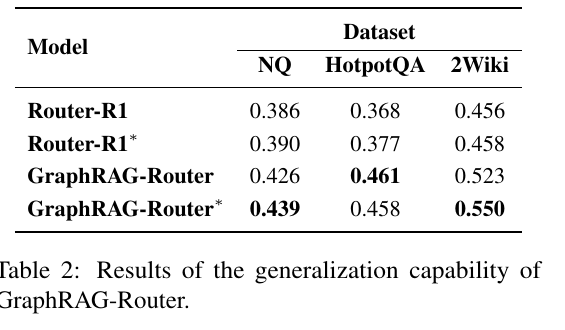
泛化:可扩展到未见 GraphRAG 和 LLM 候选

  • 作者在候选池中加入未训练过的 Qwen3-8B、gpt-oss-120b 和 LightRAG,不再额外训练。
  • GraphRAG-Router* 在 NQ 和 2Wiki 上进一步提升到 0.439 / 0.550,HotpotQA 基本持平。
  • 解读:路由器不是死记具体候选,而是利用候选描述做一定程度的 zero-shot 扩展。但这仍是在相近 QA setting 中扩展,不能直接等同于跨领域企业知识库泛化。

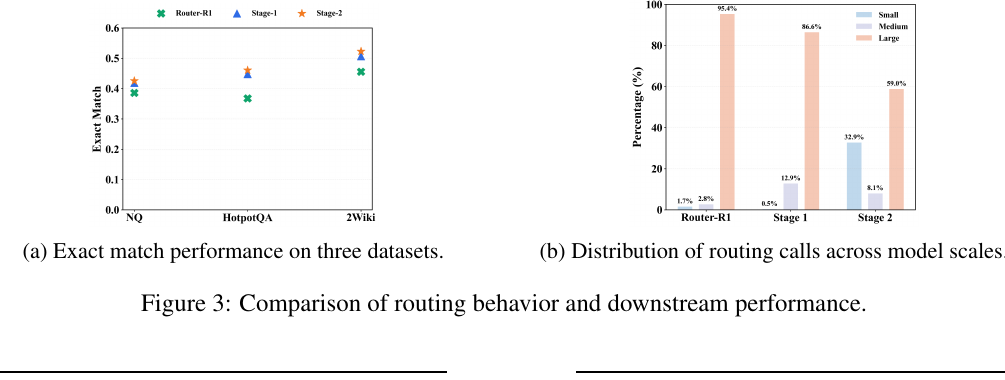
成本效率:减少 large LLM 过度调用

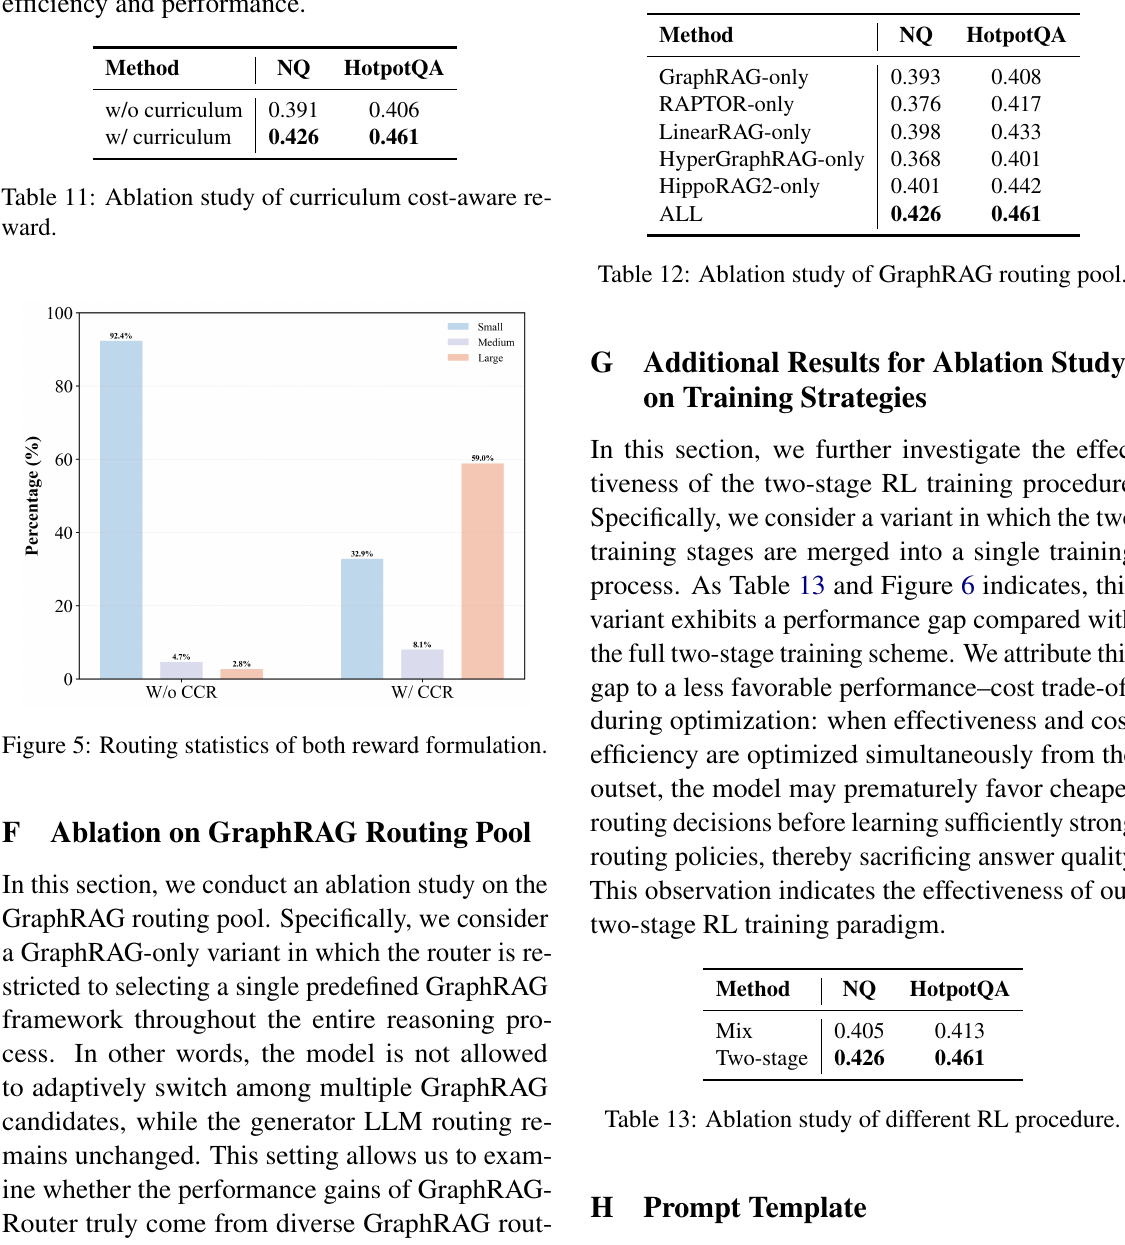
  • Router-R1 和 Stage 1 大量调用 large LLM;Stage 2 加入 curriculum cost-aware reward 后,大模型调用降到约 59.0%。
  • small model 调用升到约 32.9%,medium 约 8.1%。
  • EM 没有因省钱下降,反而在 NQ / HotpotQA / 2Wiki 上略高于 Stage 1。
  • 解读:这篇论文的“cost-efficient”主要是 generator LLM cost,而不是 GraphRAG 构建成本。它回答的是“证据后端和生成模型如何搭配”,不是“如何更便宜地建图”。

层次化路由与 SFT / RL 消融

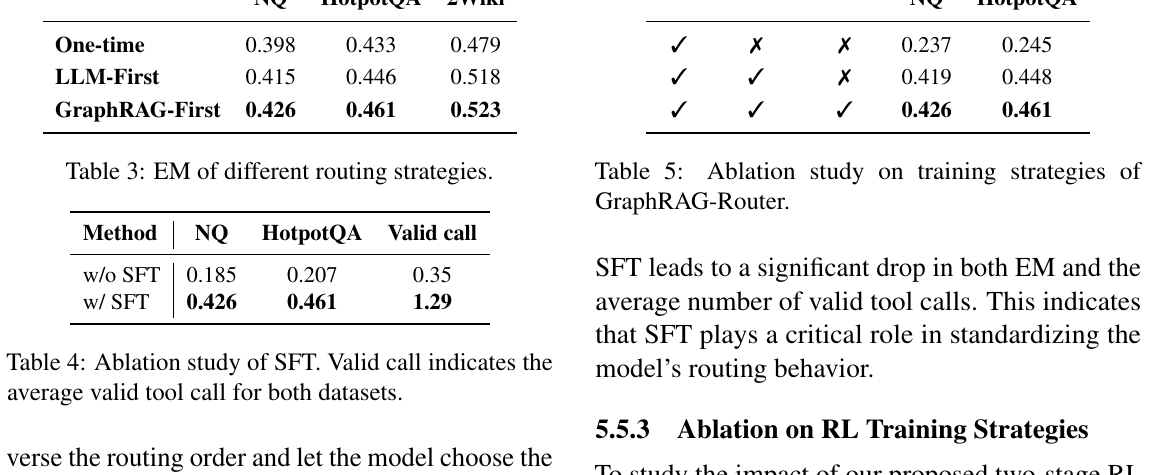
  • GraphRAG-first > LLM-first > one-time routing:
    • NQ:0.426 vs 0.415 vs 0.398。
    • HotpotQA:0.461 vs 0.446 vs 0.433。
    • 2Wiki:0.523 vs 0.518 vs 0.479。
  • 去掉 SFT 后 EM 从 0.426 / 0.461 降到 0.185 / 0.207,valid call 也从 1.29 降到 0.35。
  • 只做 SFT 不做 RL,EM 为 0.237 / 0.245;加 Stage 1 后 0.419 / 0.448;加 Stage 2 后 0.426 / 0.461。
  • 解读:SFT 的作用主要是把输出格式和 tool-use 行为拉到可训练区间;RL 的作用是把“会调用”优化成“调用得对且划算”。

F1 与附加消融:结论基本一致,但不是所有单项都最优

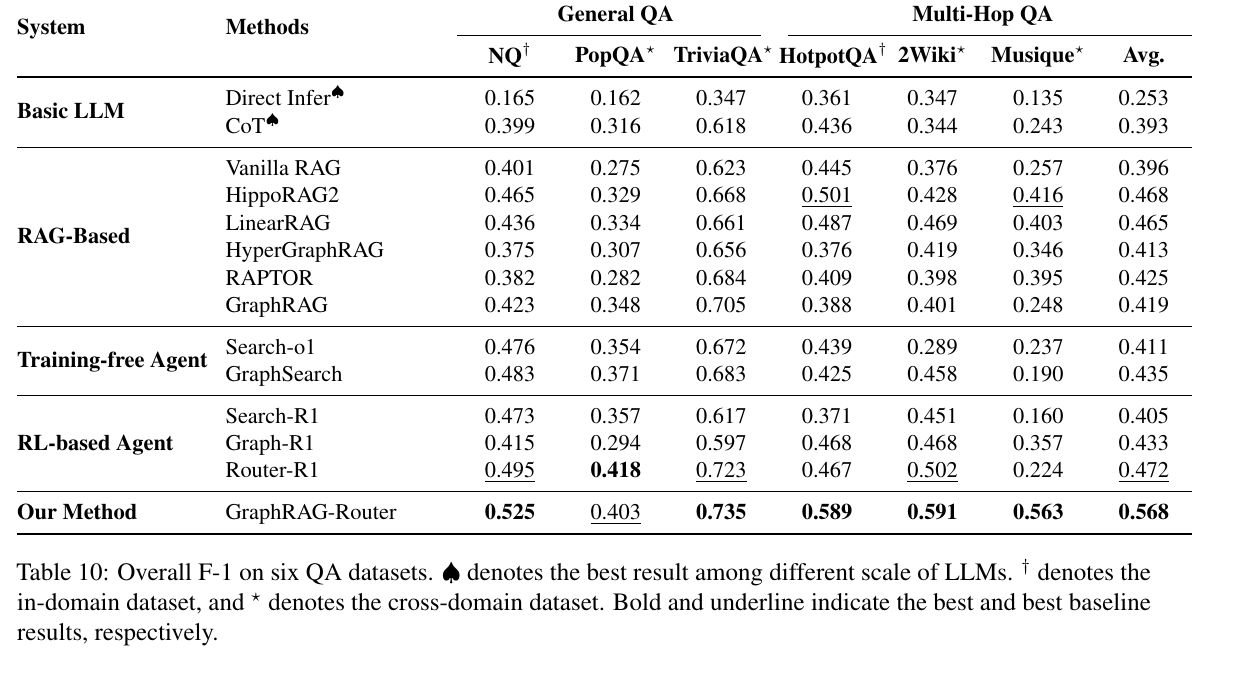
  • 平均 F1:GraphRAG-Router 为 0.568,高于 Router-R1 的 0.472。

  • 但 PopQA 上 Router-R1 的 F1 为 0.418,高于 GraphRAG-Router 的 0.403。

  • 解读:论文的强结论应写成“平均和多数复杂任务上更强”,不能写成“所有指标所有数据集无条件最优”。

  • Curriculum cost-aware reward 优于统一成本惩罚:NQ 0.426 vs 0.391,HotpotQA 0.461 vs 0.406。

  • 统一惩罚会让模型过度保守,几乎总用 small model,性能下降。

  • GraphRAG routing pool 消融显示,ALL 后端池优于任一单一 GraphRAG-only 版本;HippoRAG2-only 是最强单后端,但仍低于 ALL。

  • 两阶段 RL 优于混合训练:NQ 0.426 vs 0.405,HotpotQA 0.461 vs 0.413。

  • 解读:GraphRAG-Router 的收益来自三个组合因素:多 GraphRAG 后端池、GraphRAG-first 层次化选择、先学性能再压成本的训练顺序。

Case Study:路由轨迹可解释,但需要注意格式依赖

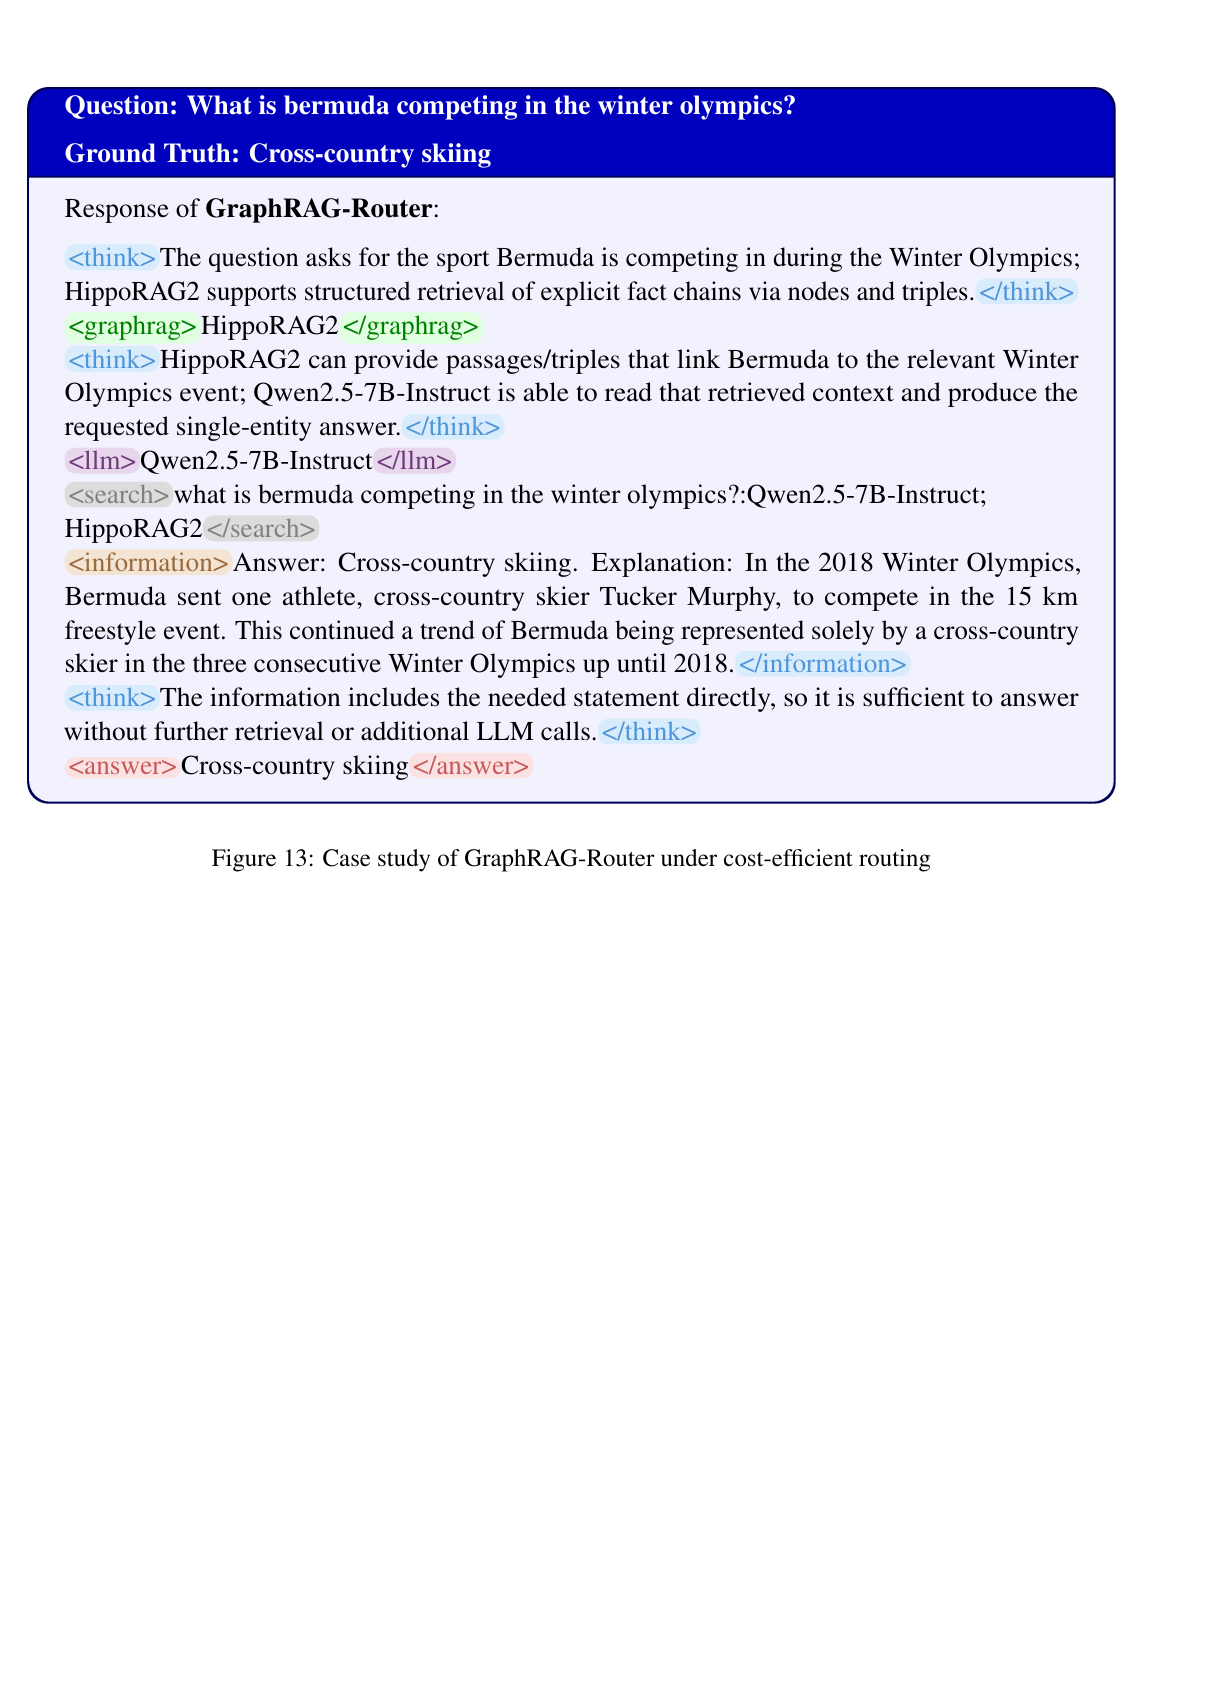
Figure 13 展示 cost-efficient routing 的案例:模型先选 GraphRAG,再选 LLM,再根据返回信息判断是否足够。这种 tagged trace 对调试很有价值,因为能看到后端选择、模型选择和 evidence sufficiency 判断。

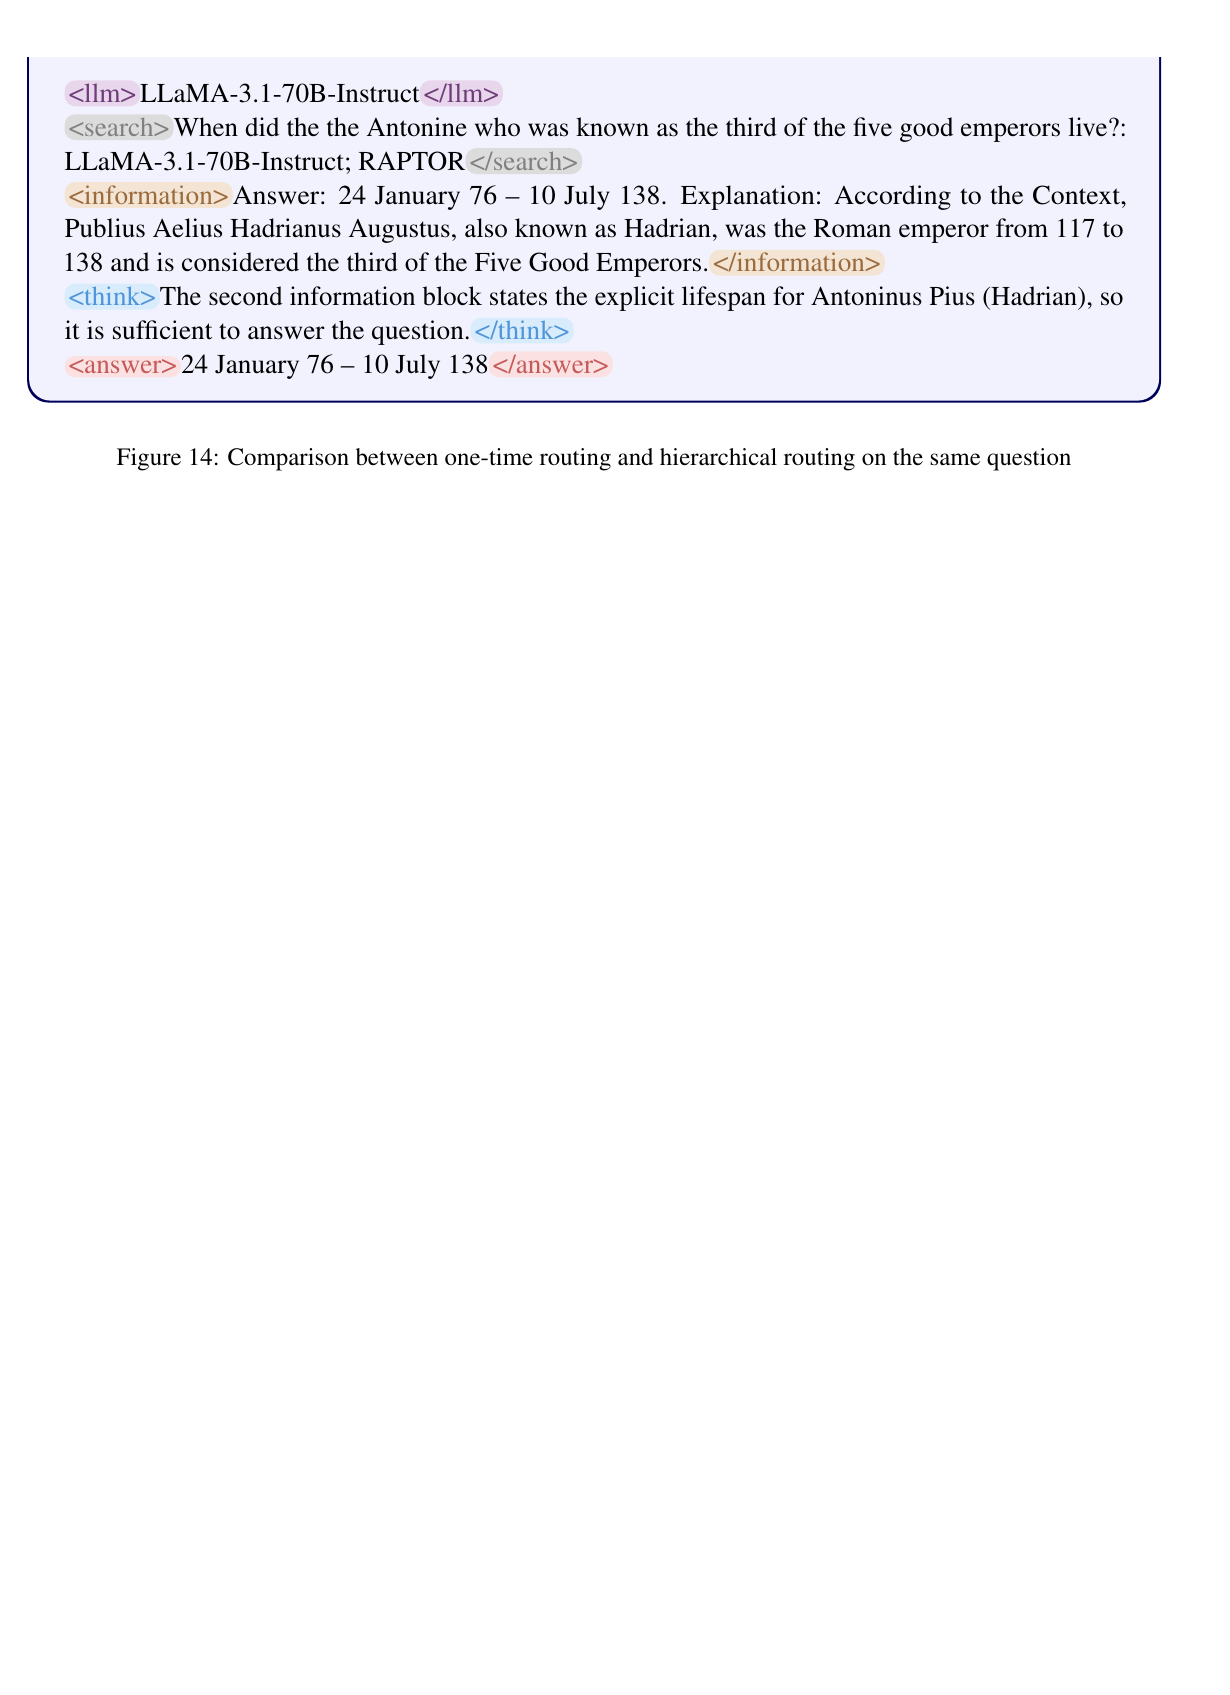
Figure 14 对比 one-time routing 和 hierarchical routing。同一问题下,一次性路由容易把不确定信息直接当答案;层次化路由会在信息不足时继续检索或改换后端,最后得到正确答案。

局限与开放问题

  • 任务范围有限:实验主要是 Wikipedia-based general QA 和 multi-hop QA,尚未证明能直接迁移到企业文档、科研论文库、代码库或长期更新知识库。

  • 离线候选固定:GraphRAG 后端、语料、图索引都预构建并固定;动态在线图更新场景仍未验证。

  • 成本口径偏生成模型:论文重点减少 large LLM overuse,没有系统报告每种 GraphRAG 的 construction time、index maintenance cost、retrieval latency 和 context length。

  • 训练轨迹依赖强模型生成:SFT trace 使用 GPT-5.2 生成,复现成本和可得性需要进一步确认。

  • GraphRAG 候选描述由强模型总结,路由质量可能受描述准确性影响。

  • 指标仍以 EM / F1 为主,对 support-set completeness、citation faithfulness、trajectory provenance 的评估不足。

  • 格式奖励依赖严格 tag 协议,真实系统中需要额外处理 tool failure、候选后端不可用、返回信息冲突等情况。

  • 作者 Future Work:

    • 扩展到更复杂的 retrieval-heavy 任务,例如长企业文档和科学文献多跳推理。
    • 验证在动态在线环境中,面对持续更新的知识源和演化检索索引时是否仍有效。
  • Agent 推断的 Research Opportunities:

    • 把 GraphRAG-Router 与 A2RAG - Adaptive Agentic Graph Retrieval 合并:A2RAG 解决单后端内部的 Local / Bridge / PPR 升级,GraphRAG-Router 解决跨后端和跨模型路由。
    • 设计 cost-amortized routing 指标:同时考虑 graph construction cost、retrieval time、LLM cost、context length 和 answer quality。
    • 给路由器加入 trajectory-level evidence reward:不仅看最终 EM,还奖励 support-set coverage、citation grounding 和证据充分性。
    • 在本地 GraphRAG 方法上复刻层次化消融:flat one-time pair selection、LLM-first、GraphRAG-first,判断“先选证据结构”是否稳定优于“先选模型”。
    • 将 curriculum cost-aware reward 改造成可解释 query complexity label,输出 easy / medium / hard 与所需 GraphRAG 强度。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略
展开原始论文笔记全文

基本信息

  • 英文标题:GraphRAG-Router: Learning Cost-Efficient Routing over GraphRAGs and LLMs with Reinforcement Learning
  • 中文标题:GraphRAG-Router:用强化学习在多种 GraphRAG 与 LLM 之间进行成本高效路由
  • 作者:Dongzhe Fan, Chuanhao Ji, Zimu Wang, Tong Chen, Qiaoyu Tan
  • 机构:New York University Shanghai, University of Liverpool
  • 年份:2026
  • 版本:arXiv v1,2026-03-31
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码链接:未见公开代码入口
  • 阅读状态:PDF级
  • 所属方向:GraphRAG backend routing、LLM routing、cost-aware agentic retrieval、query complexity routing
  • 优先级:P1 候选

Background

  • 研究问题:现有 GraphRAG 系统通常采用固定检索后端和固定生成 LLM。这个 one-size-fits-all 设计在 mixed workload 中不经济:简单问题不需要昂贵大模型,复杂多跳问题又可能需要更强的图结构和生成模型。
  • 为什么重要:这篇论文正好把 GraphRAG中的Query-Complexity与结构选择 往前推进一步:不仅要判断“要不要 GraphRAG”,还要判断“用哪一种 GraphRAG + 哪一种 LLM”。
  • 现有方法:
    • GraphRAG / RAPTOR / HippoRAG2 / HyperGraphRAG / LinearRAG 等后端各有结构偏好。
    • Router-R1 这类方法主要在多个 generator LLM 之间路由,但不同时选择 GraphRAG 后端。
    • Do We Still Need GraphRAG - Agentic Search Benchmark 已说明:显式图结构的收益随 query complexity、agentic search 能力和成本预算变化。

Gap

  • 固定 GraphRAG 后端无法覆盖所有 query 的证据粒度需求:有的问题需要局部实体事实,有的问题需要 community summary,有的问题需要多跳结构。
  • 固定大模型生成会产生过度调用成本;固定小模型又会在困难问题上牺牲准确率。
  • 如果把 GraphRAG 和 LLM 作为一个组合动作直接选择,动作空间是 |G| * |L|,优化难度高。
  • 现有 LLM routing 工作通常只路由生成模型,没有把 retrieval infrastructure 一起纳入决策。

Insight

  • 一句话创新点:GraphRAG-Router 把检索后端选择和生成 LLM 选择拆成层次化动作,并用 SFT + 两阶段 RL 学习何时使用哪种 GraphRAG-LLM 组合。
  • 核心洞察:
    • Query complexity 同时决定证据结构需求和模型容量需求。
    • 先选 GraphRAG、再选 LLM 比一次性选组合更可学习,也更符合“先决定取什么证据,再决定谁来读证据”的依赖关系。
    • 成本惩罚不能全局统一;easy query 应强惩罚大模型过用,hard query 应给更大探索空间。

Method

  • 整体框架:GraphRAG-Router 是一个 multi-round routing agent。每一轮先分析 query,选择 GraphRAG 后端,再选择 generator LLM,调用 <search> Question:LLM;GraphRAG </search> 获得信息,必要时继续换后端或换模型,最终输出答案。

GraphRAGRouter-fig1-query-heterogeneity

Figure 1 是论文动机证据。左图显示不同数据集偏好的 GraphRAG 后端不同;右图显示同一数据集内有大量问题可由 small / medium 模型回答,不必总调用 large LLM。这直接支撑“GraphRAG 后端 + LLM 规模都应按 query 路由”。

GraphRAGRouter-fig2-framework

Figure 2 展示完整流程:

  • Cold-start SFT:用 general traces 和 self-reflection traces 让模型先学会合法的路由格式、思考顺序和多轮自反思。
  • Stage 1 Routing Policy Alignment:用 format reward + outcome reward 让模型学会有效路由。
  • Stage 2 Difficulty-Aware Generator Allocation:加入 curriculum cost reward,减少不必要的大模型调用。

路由问题形式化

给定 query q、GraphRAG 候选池 G={g1,...,gn}、生成模型候选池 L={l1,...,lm},学习一个策略 πθ。在第 t 轮:

g_t, l_t \sim \pi_\theta(\cdot \mid q, s_t, G, L)

被选中的 GraphRAG-LLM pair 返回信息:

I_t = l_t(q, g_t(q))

论文把生成过程写成 reasoning 和 answer 两部分:

P(R,a\mid q,T,I)= \prod_{t=1}^{T_r}P(R_t\mid R_{<t},q,T,I_{<t}) \prod_{t=1}^{T_a}P(a_t\mid a_{<t},R,q,T)

层次化路由把每步动作空间从:

O(|G|\cdot |L|)

降为:

O(|G|+|L|)

Cold-start SFT

  • General trace:先找能答对问题的 (GraphRAG, LLM) pair,再用强模型生成合法、简短、结构化的路由轨迹。
  • Self-reflection trace:构造第一轮证据不足、第二轮改换 GraphRAG 或 LLM 后答对的轨迹,让模型学习 rerouting。

SFT 目标:

L_{SFT}=-\mathbb{E}_{(x,y)\sim D_{SFT}}\left[\sum_{t=1}^{|y|}\log P_\theta(y_t\mid x,y_{<t})\right]

两阶段 RL

Stage 1 的目标是先学会“会路由、格式合法、能答对”:

\max_{\pi_\theta}\mathbb{E}_{x\sim D,y\sim\pi_\theta(\cdot\mid x;G,L)} \left[r_\phi(x,y)-\beta D_{KL}(\pi_\theta(y\mid x;G,L)\Vert \pi_{ref}(y\mid x;G,L))\right]

奖励由格式奖励和最终答案奖励组成:

r_\phi(x,y)=r_{format}(y)+r_{outcome}

其中 outcome reward 使用 Exact Match:

r_{outcome}=EM(a,a_{gt})

格式奖励不是简单 0/1,而是按错误类型扣分:

r_{format}(y)=-\min\left(1,\sum_{k=1}^{K}\lambda_k I_k(y)\right)

Stage 2 加入 difficulty-aware cost optimization。先通过多次 direct inference 估计每个模型对问题 q 的成功率:

SR(l_m,q)=\frac{c(l_m,q)}{N}

如果 SR(l_m,q) >= \tau,说明该模型规模能可靠回答问题。问题难度定义为能可靠回答它的最小模型规模:

m(q)=\min s\in\{small,medium,large\}\ \text{s.t.}\ SR(q,s)\ge\tau

再定义最小所需成本:

C_{min}(q)=\min \{C(l_m)\mid SR(l_m,q)\ge\tau\}

若路由选择了比必要成本更高的模型,则按难度加权惩罚:

r_{cost}(y)=\beta w_{D(q)}\max(0,C(l_m)-C_{min}(q))

最终奖励:

r_\phi(x,y)=r_{format}(y)+r_{outcome}-\mathbb{1}_{Correct}r_{cost}(y)

关键点是:只有答对后才扣过度成本。这样模型不会为了省钱牺牲 correctness,而是在正确轨迹中寻找最小充分模型。

Results

主结果:GraphRAG-Router 在平均 EM 上领先,multi-hop 提升更明显

GraphRAGRouter-table1-overall-em

  • GraphRAG-Router 平均 EM 为 0.482,高于最好基线 Router-R1 的 0.394。
  • General QA 上提升较温和:NQ 0.426、PopQA 0.368、TriviaQA 0.672。
  • Multi-hop QA 上提升更明显:HotpotQA 0.461、2Wiki 0.523、MuSiQue 0.443。
  • MuSiQue 最能说明问题:Graph-R1 为 0.289,Router-R1 为 0.140,GraphRAG-Router 达到 0.443,说明“同时选 GraphRAG 后端和 LLM”比只做模型路由更适合复杂多跳。

泛化:可扩展到未见 GraphRAG 和 LLM 候选

GraphRAGRouter-table2-generalization

  • 作者在候选池中加入未训练过的 Qwen3-8B、gpt-oss-120b 和 LightRAG,不再额外训练。
  • GraphRAG-Router* 在 NQ 和 2Wiki 上进一步提升到 0.439 / 0.550,HotpotQA 基本持平。
  • 解读:路由器不是死记具体候选,而是利用候选描述做一定程度的 zero-shot 扩展。但这仍是在相近 QA setting 中扩展,不能直接等同于跨领域企业知识库泛化。

成本效率:减少 large LLM 过度调用

GraphRAGRouter-fig3-cost-efficiency

  • Router-R1 和 Stage 1 大量调用 large LLM;Stage 2 加入 curriculum cost-aware reward 后,大模型调用降到约 59.0%。
  • small model 调用升到约 32.9%,medium 约 8.1%。
  • EM 没有因省钱下降,反而在 NQ / HotpotQA / 2Wiki 上略高于 Stage 1。
  • 解读:这篇论文的“cost-efficient”主要是 generator LLM cost,而不是 GraphRAG 构建成本。它回答的是“证据后端和生成模型如何搭配”,不是“如何更便宜地建图”。

层次化路由与 SFT / RL 消融

GraphRAGRouter-table3-4-5-ablation

  • GraphRAG-first > LLM-first > one-time routing:
    • NQ:0.426 vs 0.415 vs 0.398。
    • HotpotQA:0.461 vs 0.446 vs 0.433。
    • 2Wiki:0.523 vs 0.518 vs 0.479。
  • 去掉 SFT 后 EM 从 0.426 / 0.461 降到 0.185 / 0.207,valid call 也从 1.29 降到 0.35。
  • 只做 SFT 不做 RL,EM 为 0.237 / 0.245;加 Stage 1 后 0.419 / 0.448;加 Stage 2 后 0.426 / 0.461。
  • 解读:SFT 的作用主要是把输出格式和 tool-use 行为拉到可训练区间;RL 的作用是把“会调用”优化成“调用得对且划算”。

F1 与附加消融:结论基本一致,但不是所有单项都最优

GraphRAGRouter-table10-overall-f1

  • 平均 F1:GraphRAG-Router 为 0.568,高于 Router-R1 的 0.472。
  • 但 PopQA 上 Router-R1 的 F1 为 0.418,高于 GraphRAG-Router 的 0.403。
  • 解读:论文的强结论应写成“平均和多数复杂任务上更强”,不能写成“所有指标所有数据集无条件最优”。

GraphRAGRouter-curriculum-and-pool-ablation

  • Curriculum cost-aware reward 优于统一成本惩罚:NQ 0.426 vs 0.391,HotpotQA 0.461 vs 0.406。
  • 统一惩罚会让模型过度保守,几乎总用 small model,性能下降。
  • GraphRAG routing pool 消融显示,ALL 后端池优于任一单一 GraphRAG-only 版本;HippoRAG2-only 是最强单后端,但仍低于 ALL。
  • 两阶段 RL 优于混合训练:NQ 0.426 vs 0.405,HotpotQA 0.461 vs 0.413。
  • 解读:GraphRAG-Router 的收益来自三个组合因素:多 GraphRAG 后端池、GraphRAG-first 层次化选择、先学性能再压成本的训练顺序。

Case Study:路由轨迹可解释,但需要注意格式依赖

GraphRAGRouter-case-cost-efficient-routing

Figure 13 展示 cost-efficient routing 的案例:模型先选 GraphRAG,再选 LLM,再根据返回信息判断是否足够。这种 tagged trace 对调试很有价值,因为能看到后端选择、模型选择和 evidence sufficiency 判断。

GraphRAGRouter-case-hierarchical-routing

Figure 14 对比 one-time routing 和 hierarchical routing。同一问题下,一次性路由容易把不确定信息直接当答案;层次化路由会在信息不足时继续检索或改换后端,最后得到正确答案。

Limitations

  • 任务范围有限:实验主要是 Wikipedia-based general QA 和 multi-hop QA,尚未证明能直接迁移到企业文档、科研论文库、代码库或长期更新知识库。
  • 离线候选固定:GraphRAG 后端、语料、图索引都预构建并固定;动态在线图更新场景仍未验证。
  • 成本口径偏生成模型:论文重点减少 large LLM overuse,没有系统报告每种 GraphRAG 的 construction time、index maintenance cost、retrieval latency 和 context length。
  • 训练轨迹依赖强模型生成:SFT trace 使用 GPT-5.2 生成,复现成本和可得性需要进一步确认。
  • GraphRAG 候选描述由强模型总结,路由质量可能受描述准确性影响。
  • 指标仍以 EM / F1 为主,对 support-set completeness、citation faithfulness、trajectory provenance 的评估不足。
  • 格式奖励依赖严格 tag 协议,真实系统中需要额外处理 tool failure、候选后端不可用、返回信息冲突等情况。

Future Directions

  • 作者 Future Work:
    • 扩展到更复杂的 retrieval-heavy 任务,例如长企业文档和科学文献多跳推理。
    • 验证在动态在线环境中,面对持续更新的知识源和演化检索索引时是否仍有效。
  • Agent 推断的 Research Opportunities:
    • 把 GraphRAG-Router 与 A2RAG - Adaptive Agentic Graph Retrieval 合并:A2RAG 解决单后端内部的 Local / Bridge / PPR 升级,GraphRAG-Router 解决跨后端和跨模型路由。
    • 设计 cost-amortized routing 指标:同时考虑 graph construction cost、retrieval time、LLM cost、context length 和 answer quality。
    • 给路由器加入 trajectory-level evidence reward:不仅看最终 EM,还奖励 support-set coverage、citation grounding 和证据充分性。
    • 在本地 GraphRAG 方法上复刻层次化消融:flat one-time pair selection、LLM-first、GraphRAG-first,判断“先选证据结构”是否稳定优于“先选模型”。
    • 将 curriculum cost-aware reward 改造成可解释 query complexity label,输出 easy / medium / hard 与所需 GraphRAG 强度。

与本知识库的连接

本卡片待补

  • 查找作者是否发布代码、训练数据或 GraphRAG-Router checkpoint。
  • 将 Table 1、Table 10、Table 11、Table 12 转成 CSV,便于和 A2RAG、Do We Still Need GraphRAG? 做统一成本收益表。
  • 复核论文中 GPT-5.2 / gpt-oss-120b 等未来模型引用的可得性和实现细节,避免复现实验时混用不可访问模型。