GGraphRAG 文献图谱自动同步
LIT-DF238EEE · 2026

LLM-Wiki - Retrieval as Reasoning via Self-Evolving Agent-Native Retrieval

LLM-Wiki 把外部语料编译成可读、可搜索、可沿双向链接遍历、可通过 Error Book 自修复的 Wiki,让 retrieval 从隐藏 ranking step 变成 agent 的显式推理过程。

PDF 级阅读卡优先级 P0Haoliang Ming, Feifei Li, Xiaoqing Wu, Wenhui Que发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:LLM agent 在复杂问答中不只是需要一次 top-k chunk 检索,而是需要像人一样搜索、阅读、沿链接追踪中间实体、判断证据是否足够,再决定下一步检索。

  • 为什么重要:GraphRAG、LightRAG、HippoRAG 2 等方法把结构引入检索,但很多系统仍把检索暴露成隐藏 ranking step。Agent 拿到的是压缩摘要、triples 或 passages,而不是可组合操作接口。

  • 核心场景:多跳问答、跨文档证据聚合、开放式浏览、作者/作品/事件等密集关系语料。

  • 对本知识库的意义:LLM-Wiki 把 GraphRAG 的结构从“图索引”推进到“agent 可以搜索、阅读、沿链接遍历、纠错的可操作 Wiki”。它直接连接 2026-06-09-Open-Problems 的 OP-6、OP-10、OP-17 和 OP-18。

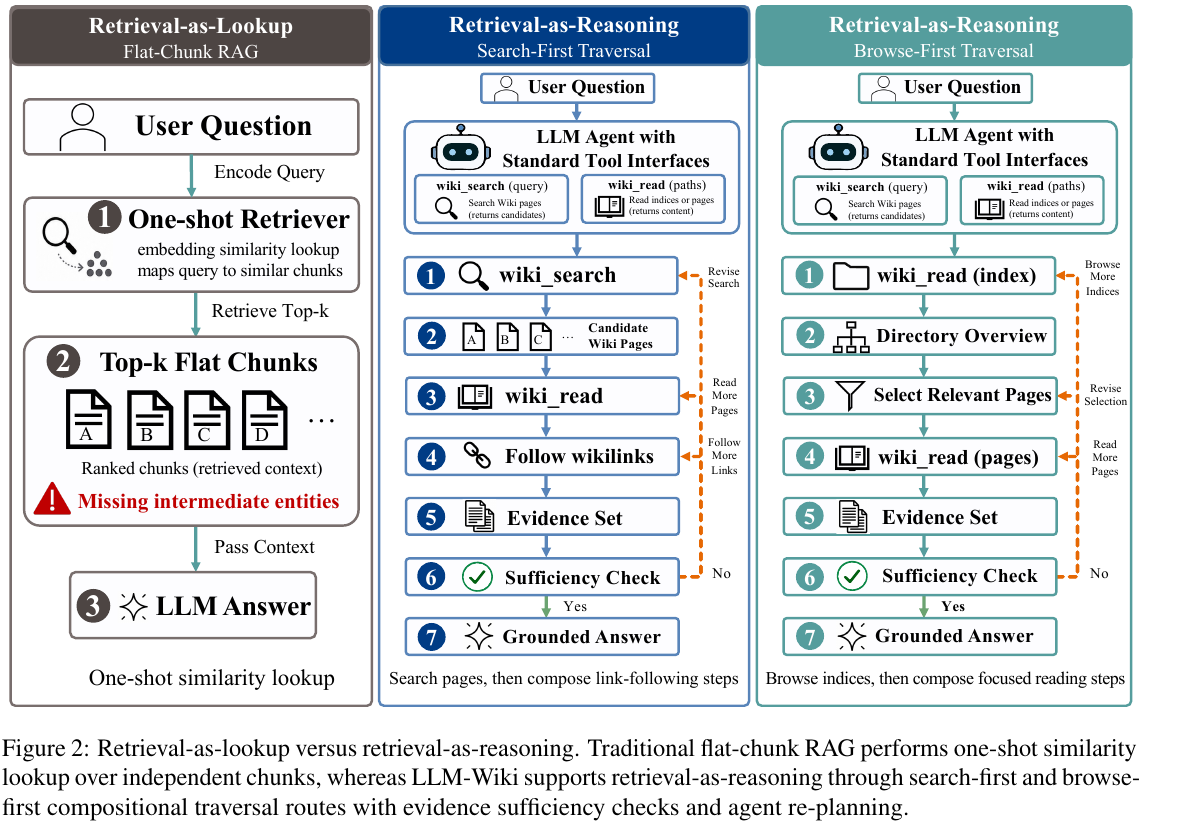
  • Flat RAG 把文档切成独立 chunk,检索动作通常是一次性相似度 top-k;它很难保证中间实体、桥接页面和最终证据同时被召回。

  • GraphRAG / RAPTOR 这类层次摘要会压缩掉细粒度实体名、日期、关系和源引用;对多跳比较、组合和枚举问题不稳定。

  • HippoRAG 2 / LightRAG 等图检索方法虽然有结构,但 agent 通常不能直接把“读到的中间实体”转成下一步可控 traversal。

  • 多数系统缺少长期维护机制:dangling links、unsupported facts、index inconsistency、cross-page contradiction 等结构错误会随着构建批次累积。

  • 现有 RAG 评估多看 answer F1 / EM,不足以衡量检索结构是否可浏览、可维护、可审计、可自修复。

方法与机制

1. 总体范式:Retrieval-as-Reasoning

LLM-Wiki 把检索过程建模为:

输入:原始文档批次 $D_t$、当前 Wiki $W_t$、Error Book $B_t$、用户问题 $q$。

计算:

W_{t+1}, B_{t+1}=Repair(Validate(Compile(D_t, W_t, B_t)))

然后 agent 在 $W_{t+1}$ 上执行多步工具调用:

\tau_q=(a_1,o_1,\ldots,a_T,o_T),\quad a_t\in\{wiki\_search,wiki\_read,follow\_link\}

输出:可追踪的 retrieval trace、读到的 Wiki pages、最终答案。

论文把 agent-native retrieval 形式化为三条原则:

  1. Compilability:原始文档被编译成结构化、显式链接、可维护的 Wiki units。
  2. Composability:检索由 search、read、link following 等原子操作组成,agent 可在推理环中组合。
  3. Evolvability:结构错误进入 Error Book,并在后续编译中形成约束和修复。

2. Wiki-Structured Knowledge:把 chunk store 变成可遍历页面

输入:source passages、当前目录索引、已有 Wiki pages、source archives、Error Book constraints。

计算:

  • 选择与新 passage 相关的既有 pages。
  • 编译或更新 structured Markdown pages。
  • 每个 page 暴露:
    • title
    • aliases
    • tags
    • facts
    • source references
    • bidirectional wikilinks
  • 更新 global index、directory _index.md 和 source digest。

可以把 Wiki 表示为:

W=(P,I,A,S,L)

其中 $P$ 是页面集合,$I$ 是目录索引,$A$ 是 aliases / tags / descriptions,$S$ 是 source archives,$L\subseteq P\times P$ 是页面间链接。

输出:human-readable 且 machine-navigable 的 Wiki。关键不是把所有文本压成 summary,而是保留可追踪事实、源引用和显式 link。

输入:问题 $q$、Wiki index、pages、links。

计算:agent 只拿到两个核心工具。

  • wiki_search(query):优先搜索 page names、aliases、tags、descriptions,再回退到 page content。
  • wiki_read(paths):批量读取目录 _index.md 或完整 pages;读取 page 时同时返回 links,供下一跳遍历。

一个简化的 search scoring 可以写成:

score(q,p)=\lambda_n Name(q,p)+\lambda_a Alias(q,p)+\lambda_t Tag(q,p)+\lambda_d Desc(q,p)+\lambda_c Content(q,p)

agent 每轮状态为:

s_t=(q,R_t,V_t,C_t)

其中 $R_t$ 是已读 pages,$V_t$ 是已访问 links / pages,$C_t$ 是当前候选证据。agent 根据读到的中间实体和 links 决定下一步 search、read 或 follow。

输出:三种 traversal strategy。

  • Direct Retrieval:已知实体事实题,搜索并读取目标页。
  • Link-Following Traversal:桥接问题先读 A,再沿 links 找 B,再读 B。
  • Browse & Aggregation:开放式或枚举问题先读目录 index,再选择页面聚合。

停止条件:

  • 最大工具调用数 $T_{max}=15$。
  • 连续空搜索超过 $P=3$。
  • 至少执行一次 wiki_read 才能回答。
  • SELECT_PAGES 最多选择 $k=5$ 个相关页面。

4. Error Book:把知识库维护变成持久约束

输入:编译后的 pages、目录索引、source references、上一轮 Error Book。

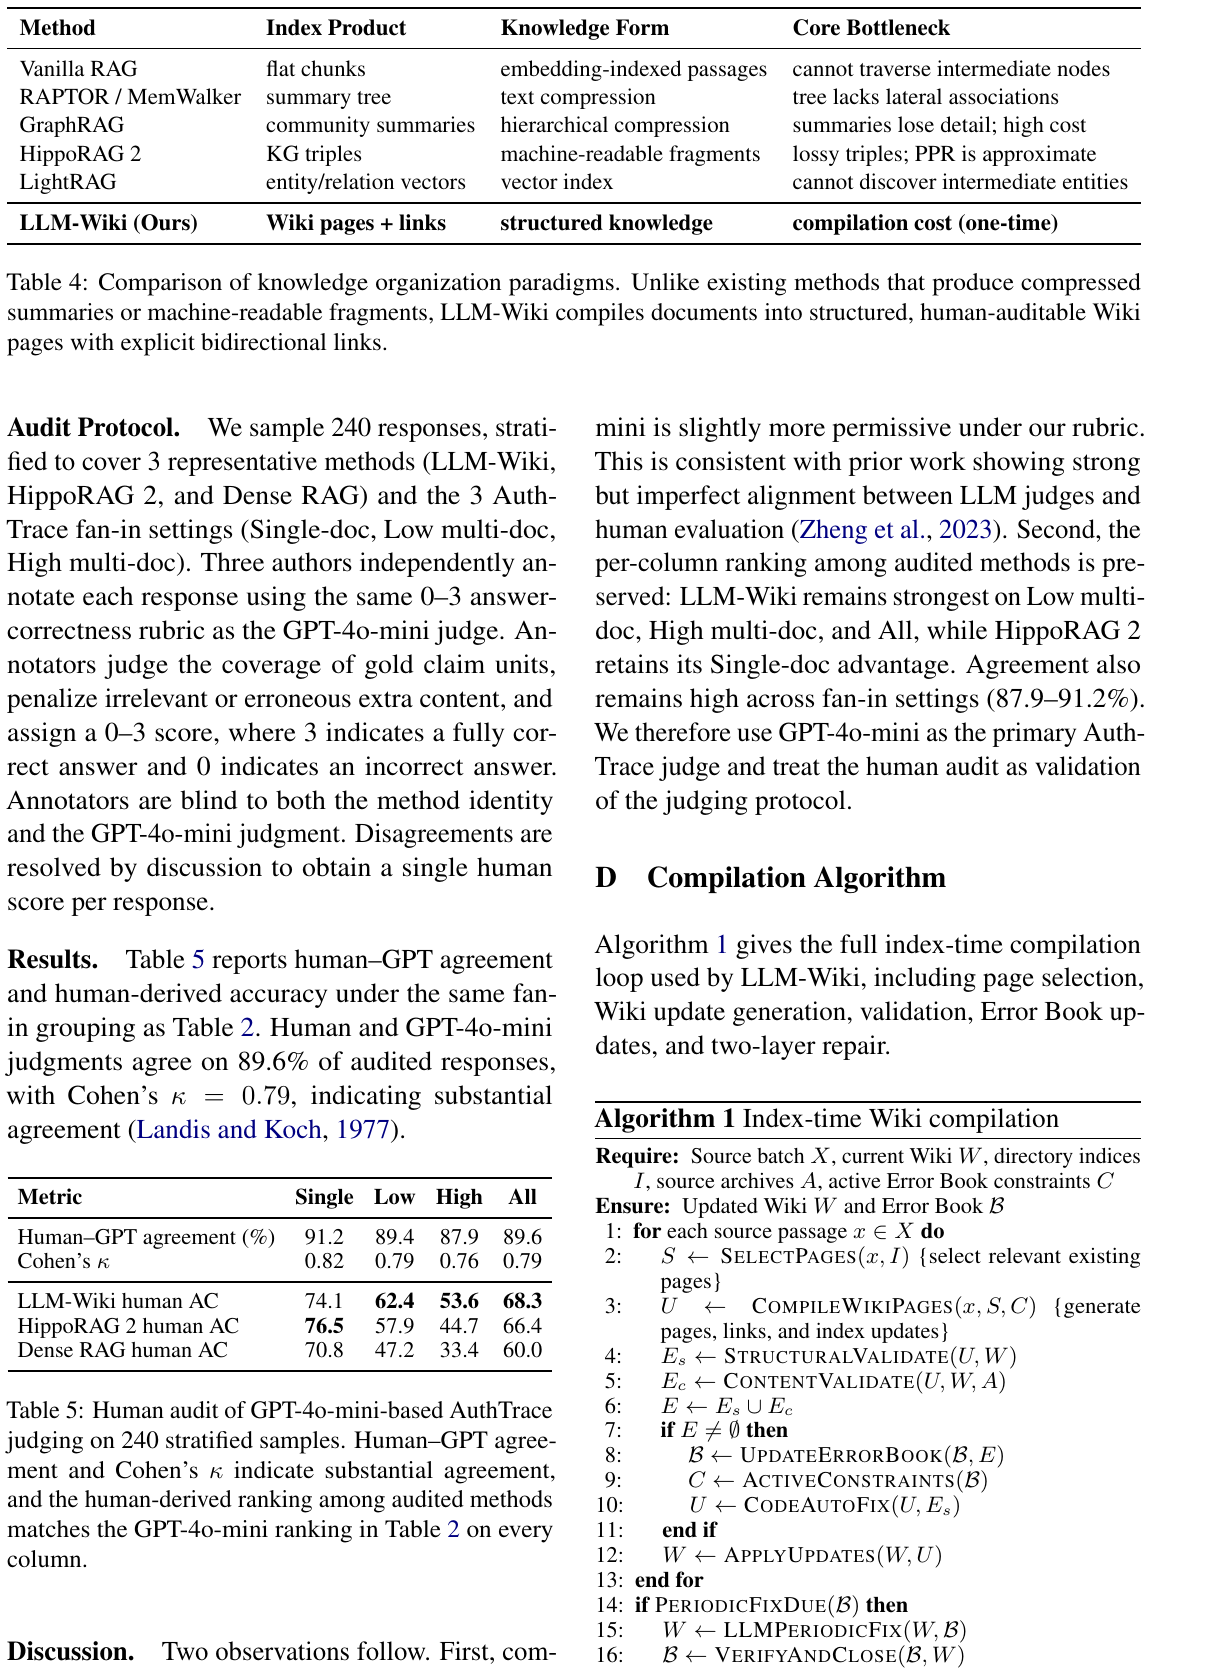
计算:Error Book 维护五阶段生命周期。

  1. Discover:批量验证 Wiki,发现结构和内容错误。
  2. Attribute:把错误归因到页面、link、source ref 或编译步骤。
  3. Constrain:把错误写成后续编译约束。
  4. Inject:在下一批 Wiki compilation 中注入这些约束。
  5. Verify & Close:修复后验证并关闭错误项。

错误约束更新可以写成:

B_{t+1}=B_t\cup Attribute(Detect(W_{t+1},S_t))
C_{t+1}=Constraints(B_{t+1})

修复分两层:

  • Code Auto-fix:处理 dangling links、formatting、index inconsistency 等可程序化错误。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

1. Public QA:多跳问答上全面领先

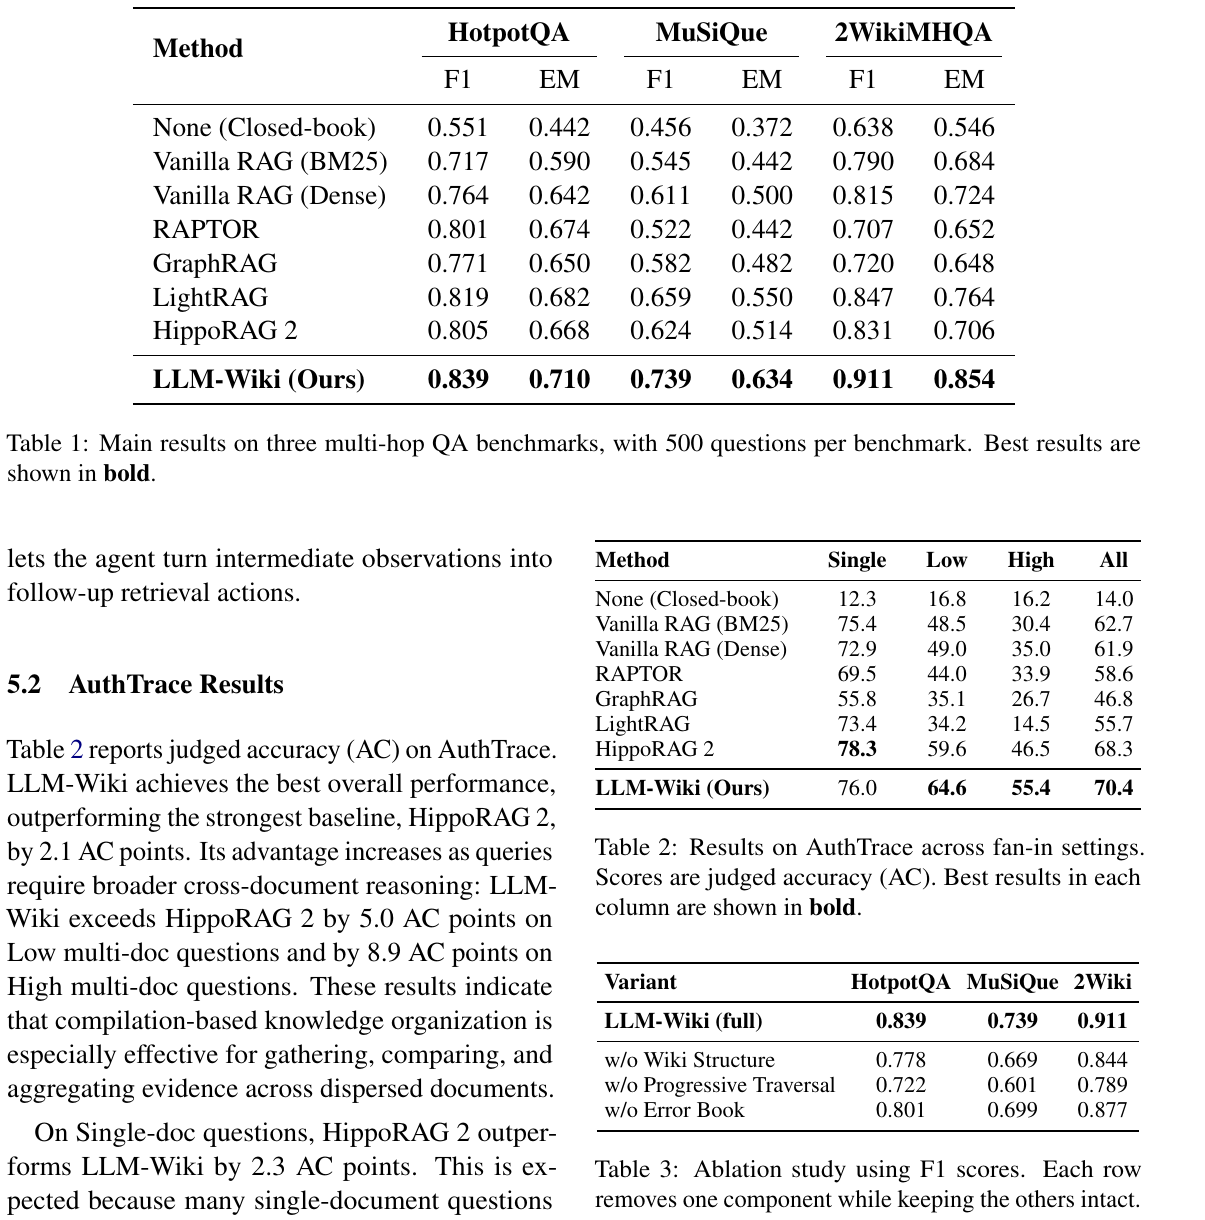
Table 1 中,LLM-Wiki 在三个 public QA benchmark 上均取得最高 F1 / EM:

  • HotpotQA:0.839 / 0.710。
  • MuSiQue:0.739 / 0.634。
  • 2WikiMultiHopQA:0.911 / 0.854。

相对最强 baseline LightRAG:

  • HotpotQA F1 +2.0。
  • MuSiQue F1 +8.0 到 +8.1。
  • 2WikiMultiHopQA F1 +6.4。

解读:LLM-Wiki 的优势在 MuSiQue 和 2Wiki 这类组合性更强的多跳任务上更明显,说明它不是简单提高 top-k 召回,而是让中间实体可被显式发现和追踪。

2. AuthTrace:跨文档 evidence fan-in 越高越有优势

AuthTrace 上 LLM-Wiki 总体 AC 为 70.4,高于 HippoRAG 2 的 68.3。分层结果:

  • Single:LLM-Wiki 76.0,HippoRAG 2 78.3。
  • Low multi-doc:LLM-Wiki 64.6,HippoRAG 2 59.6。
  • High multi-doc:LLM-Wiki 55.4,HippoRAG 2 46.5。

解读:单文档局部细节上 HippoRAG 2 略强;跨文档聚合越重,Wiki 结构和目录浏览越有价值。

3. Ablation:Progressive Traversal 是最大收益来源

Table 3 消融 F1:

  • Full:Hotpot 0.839,MuSiQue 0.739,2Wiki 0.911。
  • w/o Wiki Structure:0.778,0.669,0.844。
  • w/o Progressive Traversal:0.722,0.601,0.789。
  • w/o Error Book:0.801,0.699,0.877。

解读:去掉 progressive traversal 下降最大,说明“能在读到中间实体后继续沿结构检索”是核心收益。Error Book 的收益较小但稳定,主要提升结构可维护性和长期可靠性。

4. Hop-wise / Type-wise:hop 越深,优势越明显

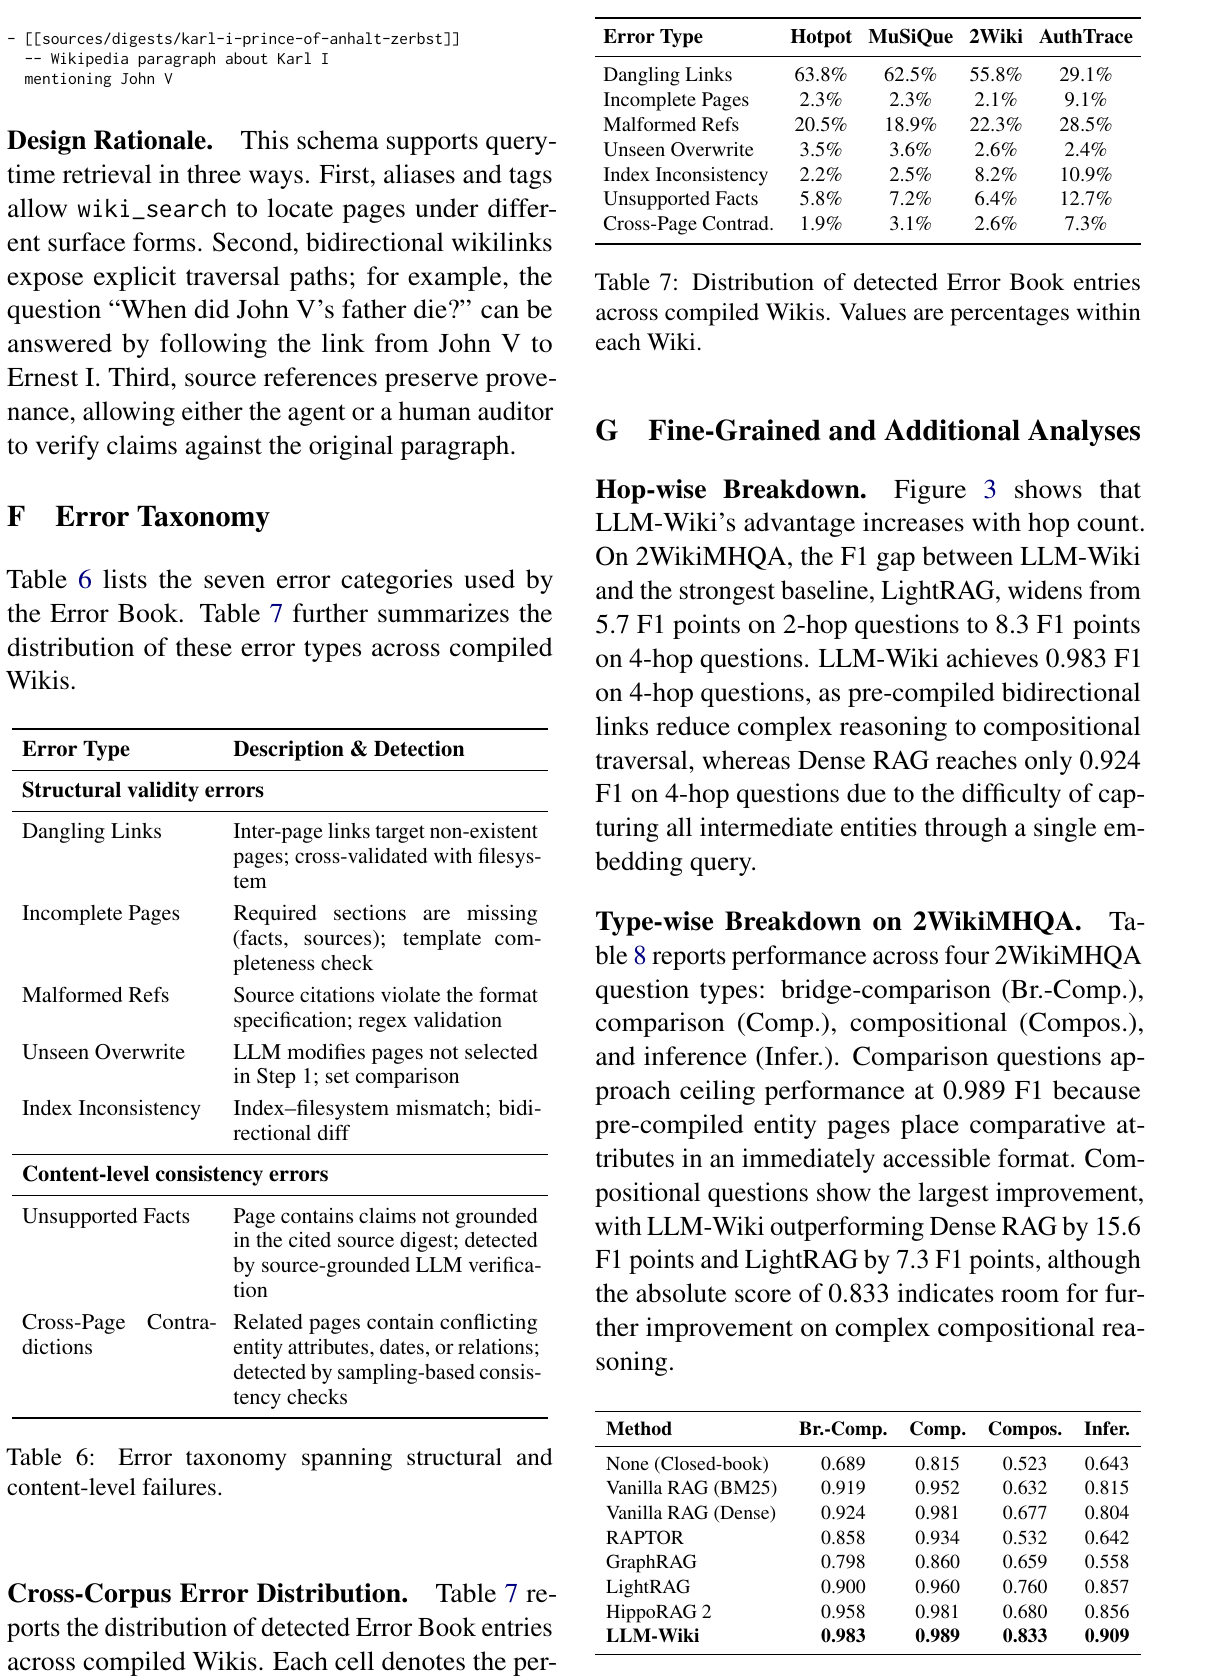
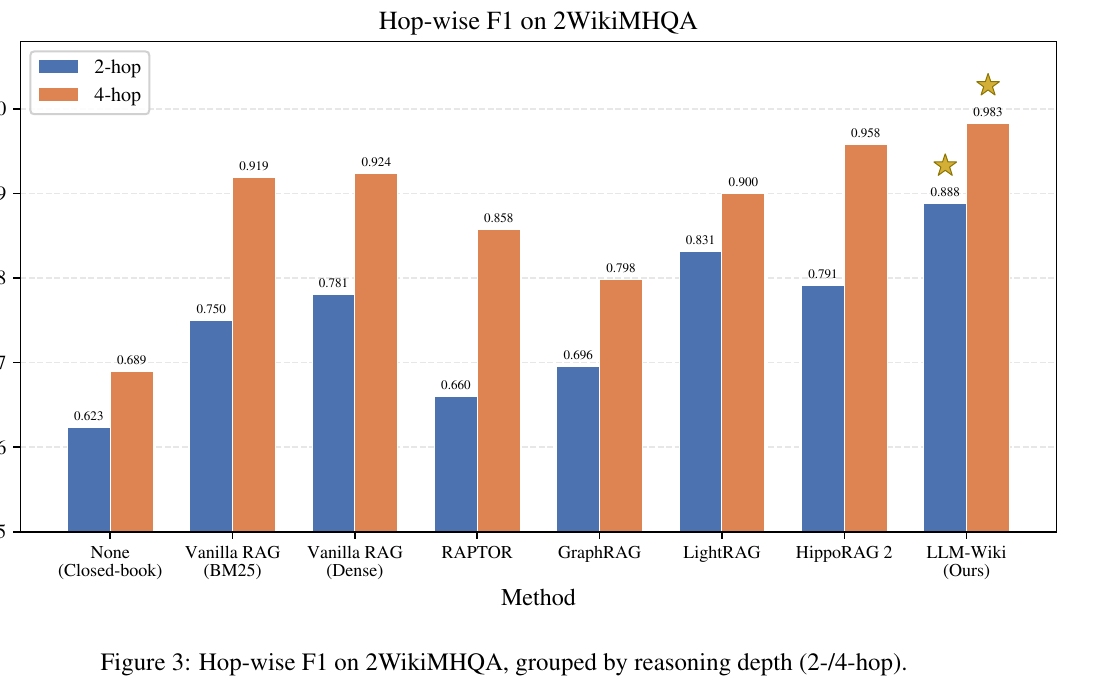
2WikiMHQA 上,LLM-Wiki 相对 LightRAG 的 F1 gap 从 2-hop 的约 5.7 扩大到 4-hop 的约 8.3。4-hop 上 LLM-Wiki F1 达 0.983。

Table 8 类型分解显示,LLM-Wiki 在 compositional 问题上 0.833,高于 LightRAG 的 0.760;在 bridge-comparison 和 comparison 上接近天花板。

解读:预编译 bidirectional links 把多跳问题拆成多个可读页面跳转,减少了 embedding query 一次性覆盖所有中间实体的压力。

5. Answer LLM 泛化与查询延迟

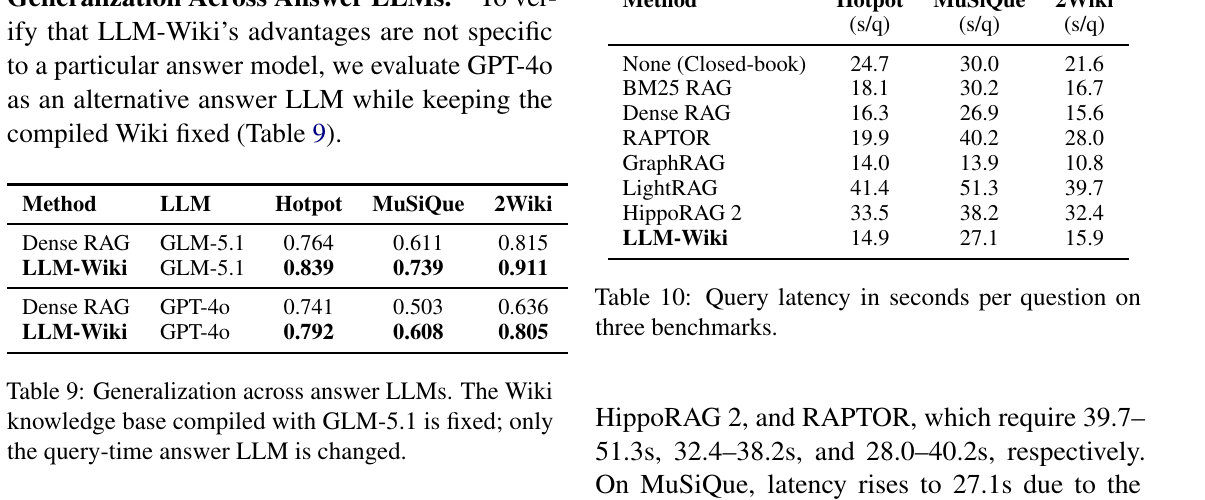
Table 9 显示换用 GPT-4o 后,LLM-Wiki 相对 Dense RAG 的优势仍存在:

  • HotpotQA:0.792 vs 0.741。
  • MuSiQue:0.608 vs 0.503。
  • 2Wiki:0.805 vs 0.636。

Table 10 查询延迟:

  • LLM-Wiki:HotpotQA 14.9s/q,MuSiQue 27.1s/q,2Wiki 15.9s/q。
  • LightRAG:41.4 / 51.3 / 39.7。
  • HippoRAG 2:33.5 / 38.2 / 32.4。
  • GraphRAG:14.0 / 13.9 / 10.8,但准确率明显低。

解读:LLM-Wiki 的一次性编译成本更高,但 query-time 可通过预编译 links 减少冗余检索。它平均每问读取 2.5-3.9 个页面,而普通 RAG 固定读 5 passages。

6. Case Studies:从相似检索失败到结构遍历成功

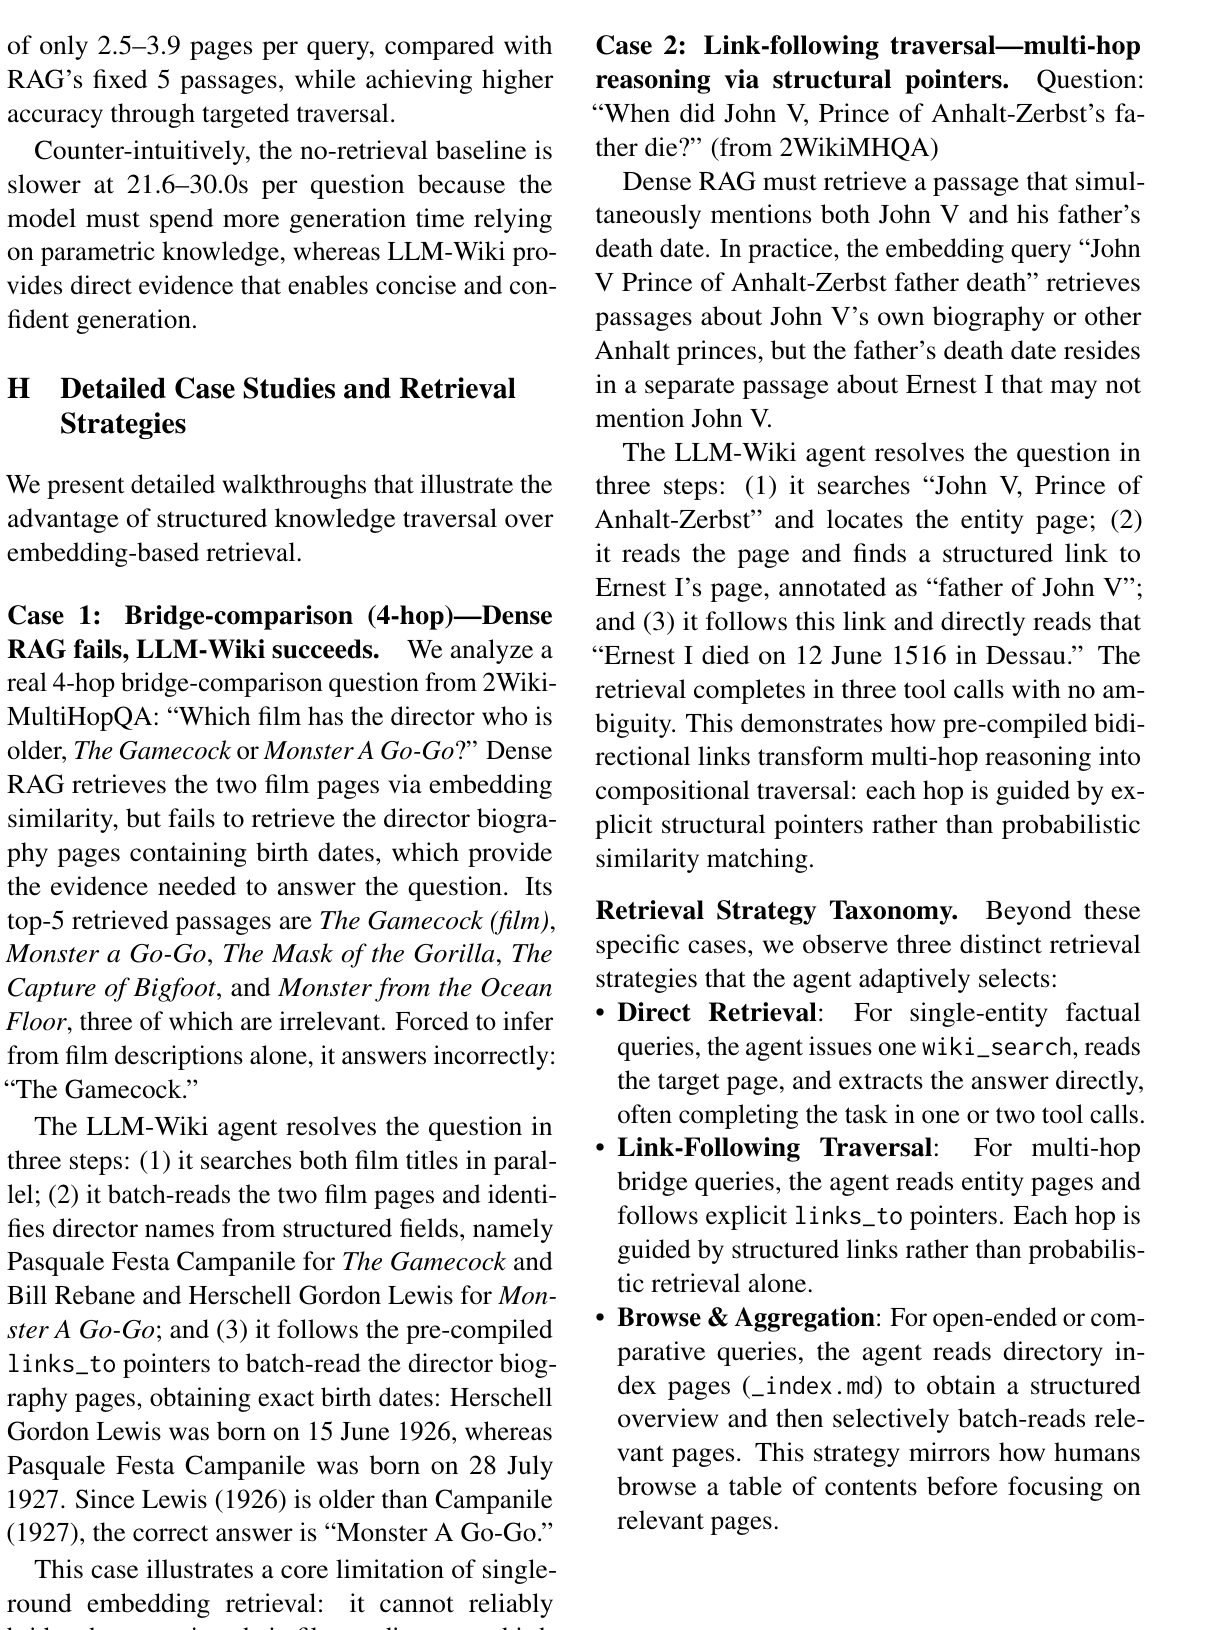
Case 1:问题要求比较 The Gamecock 和 Monster A Go-Go 哪部电影的导演更年长。Dense RAG 取回两个 film pages,但漏掉 director biography birth dates。LLM-Wiki:

  1. 搜索两个 film titles。
  2. 读取 film pages,找到 director names。
  3. 沿 links_to 读取 director biography pages。
  4. 得到 Herschell Gordon Lewis 1926 年出生,Pasquale Festa Campanile 1927 年出生。
  5. 输出 Monster A Go-Go。

Case 2:John V 父亲何时去世。LLM-Wiki 读取 John V 页面,沿 father link 到 Ernest I 页面,读取 “12 June 1516”。

解读:这里的关键不是更强 answer model,而是 retrieval substrate 把 film -> director -> birth date 和 person -> father -> death date 变成显式 traversal path。

局限与开放问题

  • 编译成本高:每批 source passages 都需要 page selection、page compilation、validation、Error Book 更新和周期性修复,比 chunk + embedding 索引更贵。

  • 实验语料不是 full Wikipedia open-domain retrieval,而是每个 benchmark 前 500 个样本对应 context paragraphs 的 union;结果更适合比较组织方式,不代表 Web-scale 检索结论。

  • 可扩展性仍待验证:当 Wiki 达到数万或更多页面时,目录索引、page selection、全局一致性维护和 stale-fact handling 都会变难。

  • 内容压缩可能漏细节:AuthTrace single-doc 上 HippoRAG 2 优于 LLM-Wiki,说明结构化页面可能省略局部细节。

  • Error Book 仍依赖 LLM 和规则验证,unsupported facts / cross-page contradiction 的检测可能有漏报和误报。

  • Frequently changing corpora 需要 hierarchical indexing、sharding、incremental stale-fact detection 和 global directory maintenance。

  • 作者方向:

    • 大规模动态 Wiki 维护。
    • 多模态 Wiki。
    • Cross-corpus transfer。
  • Agent 推断的 Research Opportunities:

    • 把 LLM-Wiki 的 Error Book 指标纳入 OP-6:dangling link rate、malformed ref rate、unsupported fact rate、repair closure rate、source-grounded fact precision。
    • 把 wiki_search / wiki_read / link-following 日志纳入 OP-10:tool calls per query、pages read per query、strategy type、traversal success、sufficiency stop accuracy。
    • 和 Reasoning Bottleneck in Graph-RAG - Structured Prompting and Context Compression 结合:比较 “retrieval-as-reasoning traversal” 与 “post-retrieval structured prompting” 分别解决哪类 covered-but-wrong 问题。
    • 和 SAGE - Self-Evolving Agentic Graph-Memory Engine 对比:SAGE 优化 writer-reader graph memory,LLM-Wiki 优化可读 Wiki substrate 和 Error Book 维护。
    • 建立 agent-native retrieval benchmark:不仅评 answer F1,还评 page selection accuracy、link validity、evidence route completeness、tool-call budget 和 human auditability。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略
展开原始论文笔记全文

基本信息

  • 英文标题:Retrieval as Reasoning: Self-Evolving Agent-Native Retrieval via LLM-Wiki
  • 中文标题:检索即推理:通过 LLM-Wiki 实现自演化的 Agent 原生检索
  • 作者:Haoliang Ming, Feifei Li, Xiaoqing Wu, Wenhui Que
  • 机构:WeChat, Tencent Inc., Beijing, China
  • 年份:2026
  • 版本:arXiv v2,2026-05-26;初版 2026-05-25
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:论文未给出公开代码链接。
  • 阅读状态:PDF级
  • 所属方向:retrieval-as-reasoning、agent-native retrieval、Wiki-structured knowledge、self-evolving memory、Error Book
  • 优先级:P0

Background

  • 研究问题:LLM agent 在复杂问答中不只是需要一次 top-k chunk 检索,而是需要像人一样搜索、阅读、沿链接追踪中间实体、判断证据是否足够,再决定下一步检索。
  • 为什么重要:GraphRAG、LightRAG、HippoRAG 2 等方法把结构引入检索,但很多系统仍把检索暴露成隐藏 ranking step。Agent 拿到的是压缩摘要、triples 或 passages,而不是可组合操作接口。
  • 核心场景:多跳问答、跨文档证据聚合、开放式浏览、作者/作品/事件等密集关系语料。
  • 对本知识库的意义:LLM-Wiki 把 GraphRAG 的结构从“图索引”推进到“agent 可以搜索、阅读、沿链接遍历、纠错的可操作 Wiki”。它直接连接 2026-06-09-Open-Problems 的 OP-6、OP-10、OP-17 和 OP-18。

Gap

  • Flat RAG 把文档切成独立 chunk,检索动作通常是一次性相似度 top-k;它很难保证中间实体、桥接页面和最终证据同时被召回。
  • GraphRAG / RAPTOR 这类层次摘要会压缩掉细粒度实体名、日期、关系和源引用;对多跳比较、组合和枚举问题不稳定。
  • HippoRAG 2 / LightRAG 等图检索方法虽然有结构,但 agent 通常不能直接把“读到的中间实体”转成下一步可控 traversal。
  • 多数系统缺少长期维护机制:dangling links、unsupported facts、index inconsistency、cross-page contradiction 等结构错误会随着构建批次累积。
  • 现有 RAG 评估多看 answer F1 / EM,不足以衡量检索结构是否可浏览、可维护、可审计、可自修复。

Insight

  • 一句话创新点:LLM-Wiki 把外部语料编译成可读、可搜索、可沿双向链接遍历、可通过 Error Book 自修复的 Wiki,让 retrieval 从隐藏 ranking step 变成 agent 的显式推理过程。
  • 核心洞察:
    • 检索结构应该满足 Compilability -> Composability -> Evolvability:原始文档能编译成持久结构,agent 能组合 search/read/link-following 操作,结构还能随错误反馈自修复。
    • Wiki page 比 flat chunk 更适合 agent:它同时包含 aliases、tags、facts、source refs 和 links,能把多跳推理拆成可解释的页面遍历。
    • Error Book 的价值不只是修 bug,而是把构建失败转成下一轮编译约束,让知识库越用越稳定。
    • LLM-Wiki 的收益主要来自知识组织和 traversal affordance,而不是特定 answer LLM;换 GPT-4o 仍保持相对 Dense RAG 的优势。

Method

1. 总体范式:Retrieval-as-Reasoning

LLM-Wiki 把检索过程建模为:

输入:原始文档批次 $D_t$、当前 Wiki $W_t$、Error Book $B_t$、用户问题 $q$。

计算:

W_{t+1}, B_{t+1}=Repair(Validate(Compile(D_t, W_t, B_t)))

然后 agent 在 $W_{t+1}$ 上执行多步工具调用:

\tau_q=(a_1,o_1,\ldots,a_T,o_T),\quad a_t\in\{wiki\_search,wiki\_read,follow\_link\}

输出:可追踪的 retrieval trace、读到的 Wiki pages、最终答案。

论文把 agent-native retrieval 形式化为三条原则:

  1. Compilability:原始文档被编译成结构化、显式链接、可维护的 Wiki units。
  2. Composability:检索由 search、read、link following 等原子操作组成,agent 可在推理环中组合。
  3. Evolvability:结构错误进入 Error Book,并在后续编译中形成约束和修复。

2. Wiki-Structured Knowledge:把 chunk store 变成可遍历页面

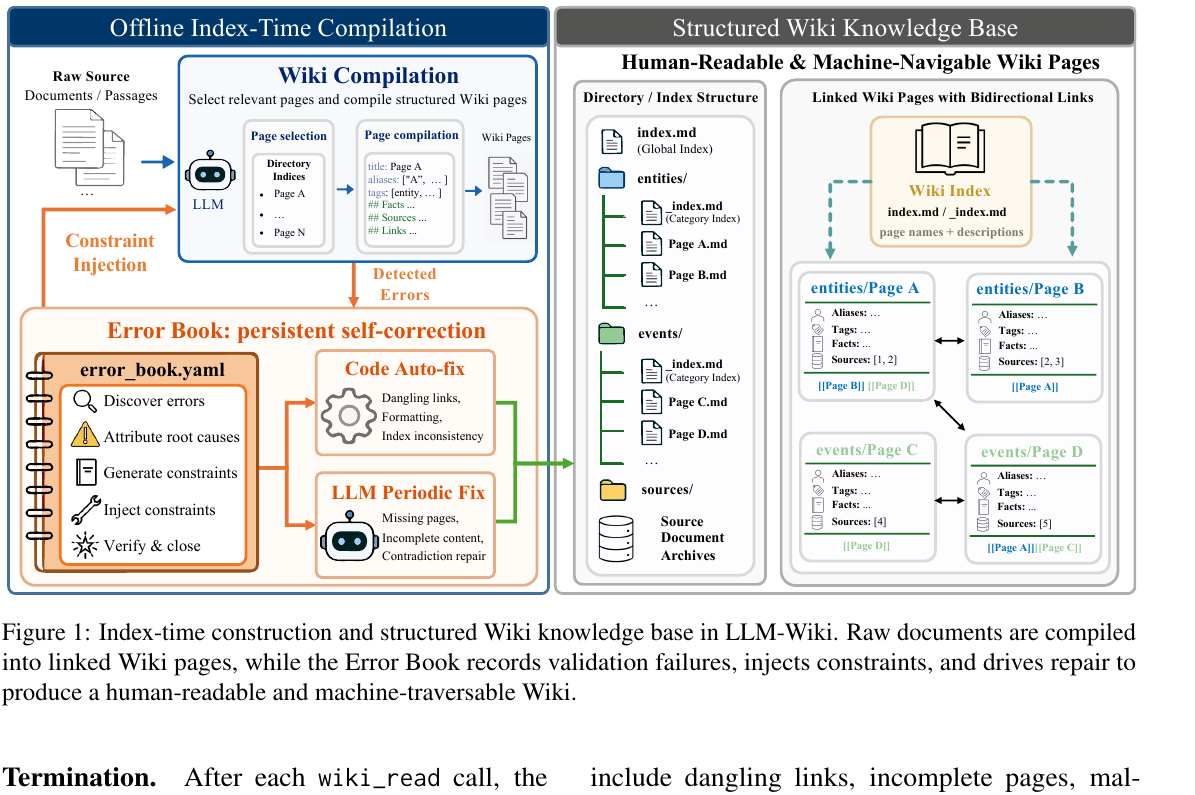
LLMWiki-fig1-index-time-wiki-error-book

输入:source passages、当前目录索引、已有 Wiki pages、source archives、Error Book constraints。

计算:

  • 选择与新 passage 相关的既有 pages。
  • 编译或更新 structured Markdown pages。
  • 每个 page 暴露:
    • title
    • aliases
    • tags
    • facts
    • source references
    • bidirectional wikilinks
  • 更新 global index、directory _index.md 和 source digest。

可以把 Wiki 表示为:

W=(P,I,A,S,L)

其中 $P$ 是页面集合,$I$ 是目录索引,$A$ 是 aliases / tags / descriptions,$S$ 是 source archives,$L\subseteq P\times P$ 是页面间链接。

输出:human-readable 且 machine-navigable 的 Wiki。关键不是把所有文本压成 summary,而是保留可追踪事实、源引用和显式 link。

LLMWiki-fig2-retrieval-as-reasoning

输入:问题 $q$、Wiki index、pages、links。

计算:agent 只拿到两个核心工具。

  • wiki_search(query):优先搜索 page names、aliases、tags、descriptions,再回退到 page content。
  • wiki_read(paths):批量读取目录 _index.md 或完整 pages;读取 page 时同时返回 links,供下一跳遍历。

一个简化的 search scoring 可以写成:

score(q,p)=\lambda_n Name(q,p)+\lambda_a Alias(q,p)+\lambda_t Tag(q,p)+\lambda_d Desc(q,p)+\lambda_c Content(q,p)

agent 每轮状态为:

s_t=(q,R_t,V_t,C_t)

其中 $R_t$ 是已读 pages,$V_t$ 是已访问 links / pages,$C_t$ 是当前候选证据。agent 根据读到的中间实体和 links 决定下一步 search、read 或 follow。

输出:三种 traversal strategy。

  • Direct Retrieval:已知实体事实题,搜索并读取目标页。
  • Link-Following Traversal:桥接问题先读 A,再沿 links 找 B,再读 B。
  • Browse & Aggregation:开放式或枚举问题先读目录 index,再选择页面聚合。

停止条件:

  • 最大工具调用数 $T_{max}=15$。
  • 连续空搜索超过 $P=3$。
  • 至少执行一次 wiki_read 才能回答。
  • SELECT_PAGES 最多选择 $k=5$ 个相关页面。

4. Error Book:把知识库维护变成持久约束

LLMWiki-table4-algorithm1-paradigm-compilation

输入:编译后的 pages、目录索引、source references、上一轮 Error Book。

计算:Error Book 维护五阶段生命周期。

  1. Discover:批量验证 Wiki,发现结构和内容错误。
  2. Attribute:把错误归因到页面、link、source ref 或编译步骤。
  3. Constrain:把错误写成后续编译约束。
  4. Inject:在下一批 Wiki compilation 中注入这些约束。
  5. Verify & Close:修复后验证并关闭错误项。

错误约束更新可以写成:

B_{t+1}=B_t\cup Attribute(Detect(W_{t+1},S_t))
C_{t+1}=Constraints(B_{t+1})

修复分两层:

  • Code Auto-fix:处理 dangling links、formatting、index inconsistency 等可程序化错误。
  • LLM Periodic Fix:处理 missing pages、incomplete content、unsupported facts、cross-page contradiction 等内容级错误。

输出:带有 persistent correction history 的 Wiki。这个机制把“图构建质量”从一次性抽取问题变成持续维护问题。

5. Error Taxonomy:结构错误和内容错误分开治理

LLMWiki-table6-table8-error-typewise

论文定义七类 Error Book 错误:

  • Dangling Links:wikilink 指向不存在页面。
  • Incomplete Pages:facts / sources 等必要段落缺失。
  • Malformed Refs:source citation 不满足格式。
  • Unseen Overwrite:LLM 修改了未被选中的页面。
  • Index Inconsistency:目录索引和文件系统不一致。
  • Unsupported Facts:页面事实没有 source digest 支持。
  • Cross-Page Contradictions:相关页面之间实体属性、日期或关系冲突。

这些错误直接给 OP-6 提供了可测指标:link validity、source-grounded fact precision、index consistency、repair closure rate。

Results

1. Public QA:多跳问答上全面领先

LLMWiki-table1-table3-main-authtrace-ablation

Table 1 中,LLM-Wiki 在三个 public QA benchmark 上均取得最高 F1 / EM:

  • HotpotQA:0.839 / 0.710。
  • MuSiQue:0.739 / 0.634。
  • 2WikiMultiHopQA:0.911 / 0.854。

相对最强 baseline LightRAG:

  • HotpotQA F1 +2.0。
  • MuSiQue F1 +8.0 到 +8.1。
  • 2WikiMultiHopQA F1 +6.4。

解读:LLM-Wiki 的优势在 MuSiQue 和 2Wiki 这类组合性更强的多跳任务上更明显,说明它不是简单提高 top-k 召回,而是让中间实体可被显式发现和追踪。

2. AuthTrace:跨文档 evidence fan-in 越高越有优势

AuthTrace 上 LLM-Wiki 总体 AC 为 70.4,高于 HippoRAG 2 的 68.3。分层结果:

  • Single:LLM-Wiki 76.0,HippoRAG 2 78.3。
  • Low multi-doc:LLM-Wiki 64.6,HippoRAG 2 59.6。
  • High multi-doc:LLM-Wiki 55.4,HippoRAG 2 46.5。

解读:单文档局部细节上 HippoRAG 2 略强;跨文档聚合越重,Wiki 结构和目录浏览越有价值。

3. Ablation:Progressive Traversal 是最大收益来源

Table 3 消融 F1:

  • Full:Hotpot 0.839,MuSiQue 0.739,2Wiki 0.911。
  • w/o Wiki Structure:0.778,0.669,0.844。
  • w/o Progressive Traversal:0.722,0.601,0.789。
  • w/o Error Book:0.801,0.699,0.877。

解读:去掉 progressive traversal 下降最大,说明“能在读到中间实体后继续沿结构检索”是核心收益。Error Book 的收益较小但稳定,主要提升结构可维护性和长期可靠性。

4. Hop-wise / Type-wise:hop 越深,优势越明显

LLMWiki-fig3-hopwise-f1

2WikiMHQA 上,LLM-Wiki 相对 LightRAG 的 F1 gap 从 2-hop 的约 5.7 扩大到 4-hop 的约 8.3。4-hop 上 LLM-Wiki F1 达 0.983。

Table 8 类型分解显示,LLM-Wiki 在 compositional 问题上 0.833,高于 LightRAG 的 0.760;在 bridge-comparison 和 comparison 上接近天花板。

解读:预编译 bidirectional links 把多跳问题拆成多个可读页面跳转,减少了 embedding query 一次性覆盖所有中间实体的压力。

5. Answer LLM 泛化与查询延迟

LLMWiki-table9-table10-llm-latency

Table 9 显示换用 GPT-4o 后,LLM-Wiki 相对 Dense RAG 的优势仍存在:

  • HotpotQA:0.792 vs 0.741。
  • MuSiQue:0.608 vs 0.503。
  • 2Wiki:0.805 vs 0.636。

Table 10 查询延迟:

  • LLM-Wiki:HotpotQA 14.9s/q,MuSiQue 27.1s/q,2Wiki 15.9s/q。
  • LightRAG:41.4 / 51.3 / 39.7。
  • HippoRAG 2:33.5 / 38.2 / 32.4。
  • GraphRAG:14.0 / 13.9 / 10.8,但准确率明显低。

解读:LLM-Wiki 的一次性编译成本更高,但 query-time 可通过预编译 links 减少冗余检索。它平均每问读取 2.5-3.9 个页面,而普通 RAG 固定读 5 passages。

6. Case Studies:从相似检索失败到结构遍历成功

LLMWiki-case-studies-traversal

Case 1:问题要求比较 The Gamecock 和 Monster A Go-Go 哪部电影的导演更年长。Dense RAG 取回两个 film pages,但漏掉 director biography birth dates。LLM-Wiki:

  1. 搜索两个 film titles。
  2. 读取 film pages,找到 director names。
  3. 沿 links_to 读取 director biography pages。
  4. 得到 Herschell Gordon Lewis 1926 年出生,Pasquale Festa Campanile 1927 年出生。
  5. 输出 Monster A Go-Go。

Case 2:John V 父亲何时去世。LLM-Wiki 读取 John V 页面,沿 father link 到 Ernest I 页面,读取 “12 June 1516”。

解读:这里的关键不是更强 answer model,而是 retrieval substrate 把 film -> director -> birth date 和 person -> father -> death date 变成显式 traversal path。

Limitations

  • 编译成本高:每批 source passages 都需要 page selection、page compilation、validation、Error Book 更新和周期性修复,比 chunk + embedding 索引更贵。
  • 实验语料不是 full Wikipedia open-domain retrieval,而是每个 benchmark 前 500 个样本对应 context paragraphs 的 union;结果更适合比较组织方式,不代表 Web-scale 检索结论。
  • 可扩展性仍待验证:当 Wiki 达到数万或更多页面时,目录索引、page selection、全局一致性维护和 stale-fact handling 都会变难。
  • 内容压缩可能漏细节:AuthTrace single-doc 上 HippoRAG 2 优于 LLM-Wiki,说明结构化页面可能省略局部细节。
  • Error Book 仍依赖 LLM 和规则验证,unsupported facts / cross-page contradiction 的检测可能有漏报和误报。
  • Frequently changing corpora 需要 hierarchical indexing、sharding、incremental stale-fact detection 和 global directory maintenance。

Future Directions

  • 作者方向:
    • 大规模动态 Wiki 维护。
    • 多模态 Wiki。
    • Cross-corpus transfer。
  • Agent 推断的 Research Opportunities:
    • 把 LLM-Wiki 的 Error Book 指标纳入 OP-6:dangling link rate、malformed ref rate、unsupported fact rate、repair closure rate、source-grounded fact precision。
    • 把 wiki_search / wiki_read / link-following 日志纳入 OP-10:tool calls per query、pages read per query、strategy type、traversal success、sufficiency stop accuracy。
    • 和 Reasoning Bottleneck in Graph-RAG - Structured Prompting and Context Compression 结合:比较 “retrieval-as-reasoning traversal” 与 “post-retrieval structured prompting” 分别解决哪类 covered-but-wrong 问题。
    • 和 SAGE - Self-Evolving Agentic Graph-Memory Engine 对比:SAGE 优化 writer-reader graph memory,LLM-Wiki 优化可读 Wiki substrate 和 Error Book 维护。
    • 建立 agent-native retrieval benchmark:不仅评 answer F1,还评 page selection accuracy、link validity、evidence route completeness、tool-call budget 和 human auditability。

与本知识库的连接

一句话定位

LLM-Wiki 的核心价值是把 GraphRAG 从“检索一批图/文本上下文”推进到“agent 在可维护 Wiki 上搜索、阅读、沿链接推理并通过 Error Book 自修复”:它提供的是 agent-native retrieval substrate,而不只是另一个 top-k retriever。