研究问题与动机
- 研究问题:现有 GraphRAG 多数按 chunk 独立抽取实体和关系,再把局部结果合并成图。这个过程缺少跨文档的全局状态,容易把局部抽取错误放大成全局检索噪声。
- 为什么重要:GraphRAG 的优势来自图结构,但图结构一旦由孤立、冲突、碎片化的 triples 构成,检索阶段会更容易召回表面相关但逻辑不一致的上下文。
- 对本知识库的意义:MemGraphRAG 是 2026-06-09-Open-Problems 中 OP-6
Incremental graph memory update的重要补充。SAGE - Self-Evolving Agentic Graph-Memory Engine 关注 writer-reader feedback 如何让长期 graph memory 自演化;MemGraphRAG 关注共享全局记忆如何在图构建时做 schema 稳定、冲突裁决和跨 chunk 桥接。
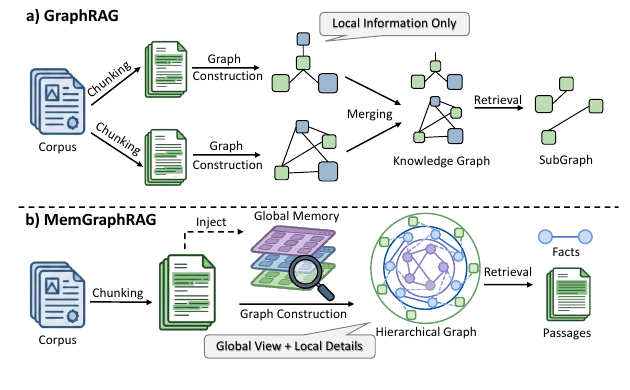
Figure 1 的核心对比是:普通 GraphRAG 从局部 chunk 抽取图,合并后再检索;MemGraphRAG 在抽取和建图之间加入 Global Memory,使系统同时保留局部细节和全局一致性。
Figure 2 说明现有 GraphRAG 往往提高 recall 但降低 relevance。右图还显示,按 schema 频率过滤低频 triples 反而可能提升 LLM-ACC,说明很多低频抽取并不是有效知识,而是主题噪声。
- 现有 GraphRAG 依赖 isolated chunk-level extraction,缺少跨 chunk 的全局视角。
- 局部 OpenIE 或 LLM triple extraction 会引入 off-topic triples,导致 thematic irrelevance。
- 多文档中可能出现互斥事实、时间冲突和粒度冲突,普通合并策略会把冲突边同时写入图。
- 分块抽取会产生 disconnected subgraphs,桥接实体和跨文档长程关系缺失,削弱多跳推理。
- 许多系统把图构建和图检索分开优化,缺少一个持续保存 schema、fact、passage provenance 的共享工作记忆。
方法与机制
1. 总体框架:Global Memory + Multi-Agent Group + Hierarchical Graph
MemGraphRAG 分成两个阶段:
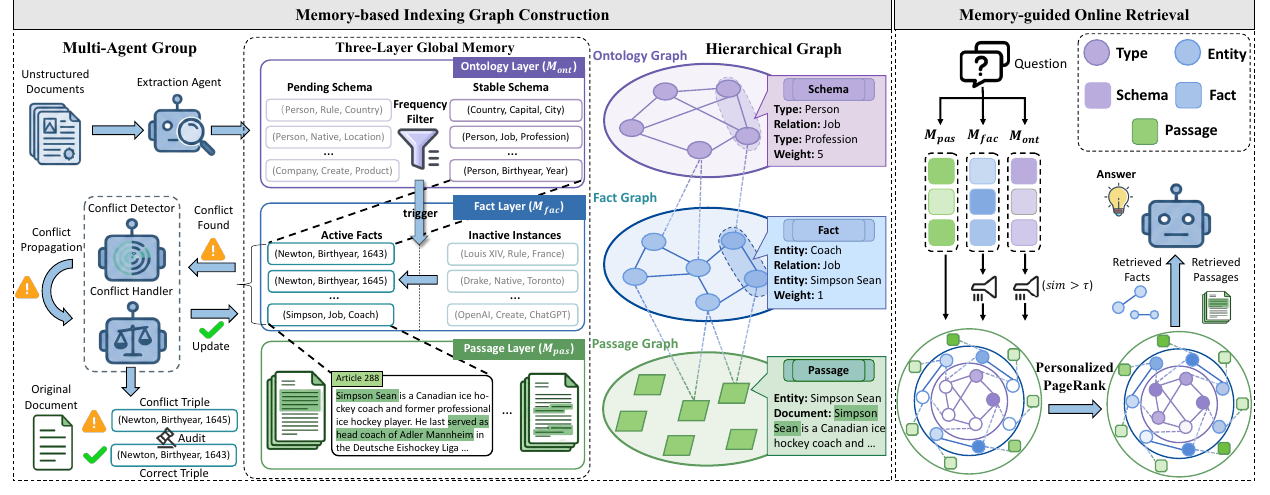
- Memory-based Indexing Graph Construction:文档 chunk 进入多智能体组,抽取结果先写入三层 Global Memory,再经过 schema 过滤、冲突裁决和 memory-guided bridging,投影成层次图。
- Memory-guided Online Retrieval:查询同时访问 ontology、fact、passage 三层记忆,经过结构感知节点初始化和 Personalized PageRank,选出事实、实体和 passage 作为生成上下文。
三层 Global Memory 为:
- Ontology Layer $M_{ont}$:保存 schema patterns 和抽取频率,例如
(Person, Job, Profession)。 - Fact Layer $M_{fac}$:保存具体事实 triples,例如
(Simpson, Job, Coach)。 - Passage Layer $M_{pas}$:保存 source passages,用于 provenance grounding。
三类 Agent 为:
- Extraction Agent $A_{ext}$:从 chunk 中抽取 candidate schemas、facts 和 source passages。
- Conflict Detection Agent $A_{det}$:监控 fact layer 中的冗余、结构异常和逻辑冲突。
- Conflict Resolution Agent $A_{res}$:利用 schema 约束和 passage provenance 裁决冲突,更新或丢弃事实。
最终图 $G$ 是三视图层次图:
- Semantic Ontology Graph $G_{ont}$:抽象 schema/type 关系。
- Fact Graph $G_{fac}$:实体和实例化 facts,是主要多跳推理底座。
- Source Evidence Graph $G_{pas}$:把 facts/entities 连接回原始 passages。
2. Composite Extraction:把局部抽取写入共享记忆
输入是文档流 $D$ 中的 chunk $c_i$。Extraction Agent 不直接生成最终图边,而是生成候选 memory entries:
输出是三类暂存对象:candidate schemas、candidate triples、source passages。关键点是,局部抽取只被当作假设,不立即进入可检索图。
3. Unified Schema Filtering:只激活稳定 schema 下的 facts
为了降低主题噪声,MemGraphRAG 将新 schema 先标记为 Pending,只有抽取频率超过阈值后才升为 Stable:
只有满足 stable schema 的 triples 才会进入 active fact layer。输入是 candidate schemas 和 candidate facts,计算是频率过滤和 schema-fact alignment,输出是 active facts。这个步骤对应 Figure 2 中的经验发现:去掉低频 schema 相关 triples 可能提升回答质量。
4. Global Adjudication:用 provenance 解决三类冲突
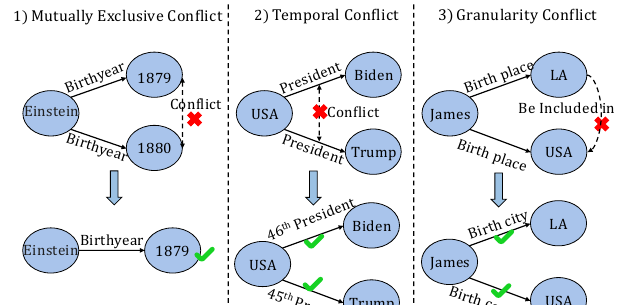
MemGraphRAG 识别三类冲突:
- Mutually exclusive conflict:同一实体的互斥属性,例如出生年份冲突。
- Temporal conflict:时间范围缺失或重叠导致的状态冲突。
- Granularity conflict:同一事实以不同抽象层级表达,例如 city/country 混用。
当新事实 $t_{new}$ 被激活后,系统在 fact memory 中扫描潜在冲突集合:
如果 $F_{conf}$ 非空,Resolution Agent 会取回新事实和冲突事实的来源 passage:
输入是 active fact 和历史 facts,计算是相似度/符号匹配 + provenance evidence adjudication,输出是 discard、refine、temporal augmentation 或 coexistence。这个设计把冲突处理从“文本合并”变成“基于证据的图事实裁决”。
5. Memory-guided Bridging:把三层记忆投影成可导航图
索引构建最后将 memory 投影为三张图:
- 从 $M_{ont}$ 构造 $G_{ont}$,保存 schema 级类型关系。
- 从 $M_{fac}$ 构造 $G_{fac}$,保存实体事实边。
- 从 $M_{pas}$ 构造 $G_{pas}$,保存 source evidence grounding。
原始笔记摘录已截断;请打开来源笔记阅读完整内容。
证据与结果
1. 主结果:整体平均 59.25,略高于 LinearRAG 和 HippoRAG2
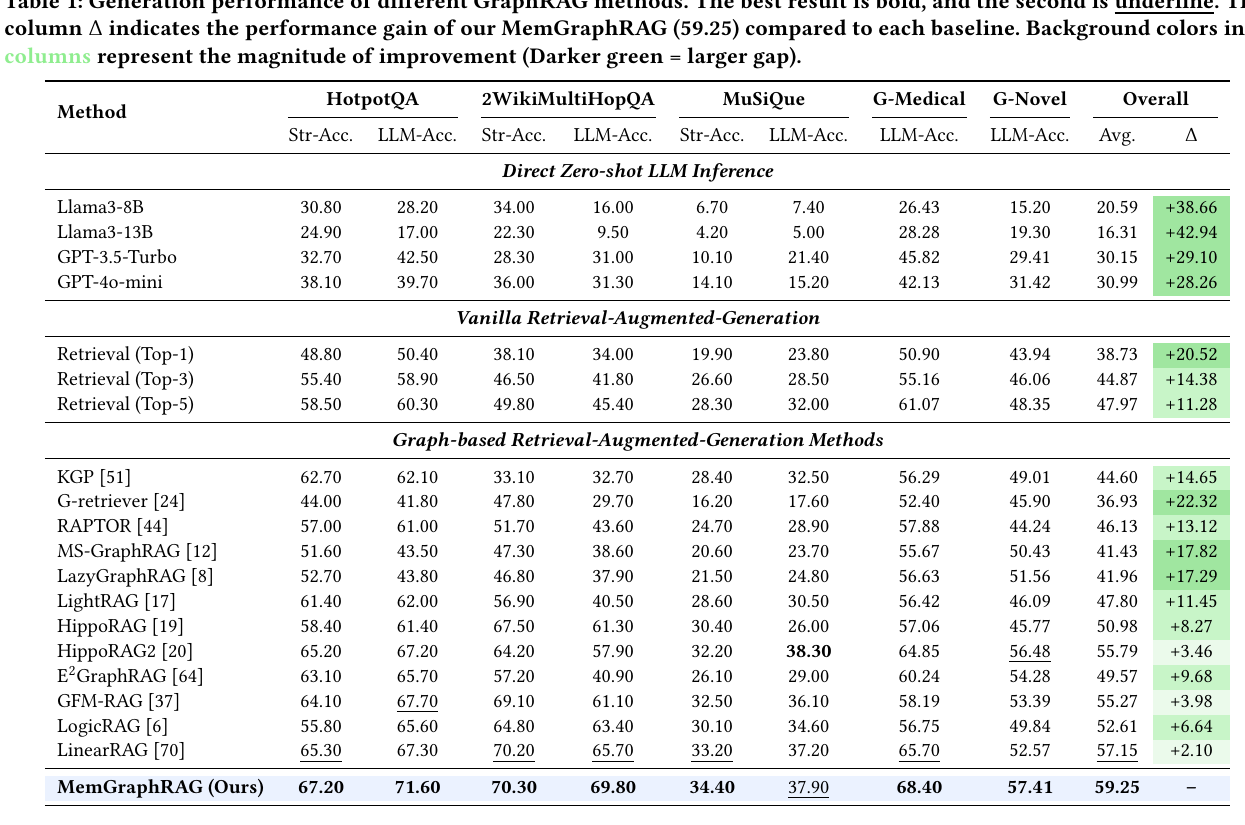
Table 1 报告 HotpotQA、2WikiMultiHopQA、MuSiQue、G-Medical、G-Novel 上的生成表现。MemGraphRAG Overall Avg. 为 59.25,高于 LinearRAG 57.15、HippoRAG2 55.79、GFM-RAG 55.27。
关键数字:
- HotpotQA LLM-Acc = 71.60。
- 2Wiki LLM-Acc = 69.80。
- MuSiQue LLM-Acc = 37.90。
- G-Medical LLM-Acc = 68.40。
- G-Novel LLM-Acc = 57.41。
解读:MemGraphRAG 不是只在单一数据集上提升,而是在通用多跳 QA 和领域 GraphRAG benchmark 上都保持较强平均表现。提升幅度相对最强基线并不夸张,但方向稳定。
2. Retrieval performance:高 recall、高 relevance 和低在线延迟
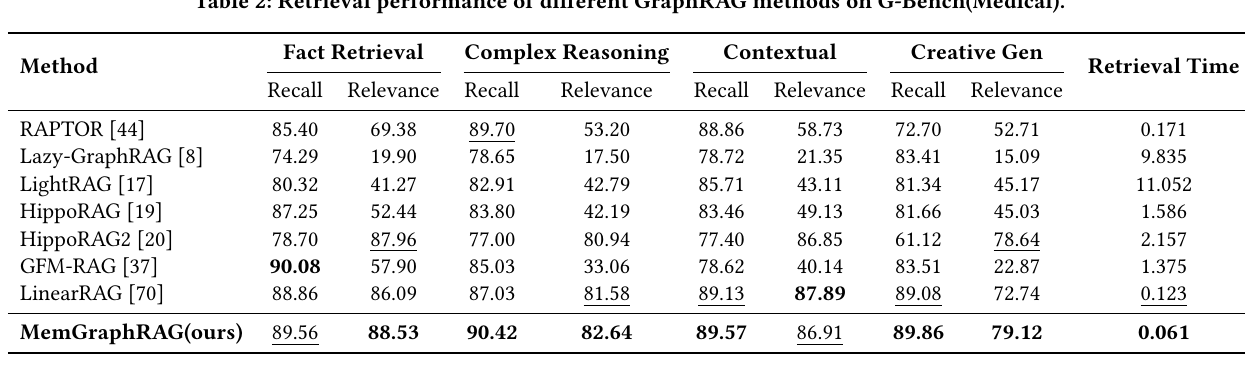
Table 2 在 G-Bench(Medical) 上报告检索质量:
- Fact Retrieval:Recall/Relevance = 89.56/88.53。
- Complex Reasoning:90.42/82.64。
- Contextual:89.57/86.91。
- Creative Gen:89.86/79.12。
- Retrieval time = 0.061s,低于 LinearRAG 0.123s、HippoRAG2 2.157s、LightRAG 11.052s。
解读:这篇论文的检索主张不是“返回更多”,而是同时保持 recall 和 relevance。在线速度快的原因是 query-time 主要做 memory lookup + PPR,而不是多轮 LLM 过滤。
3. Graph adaptability:MemGraphRAG graph 可作为其他检索器的构图器
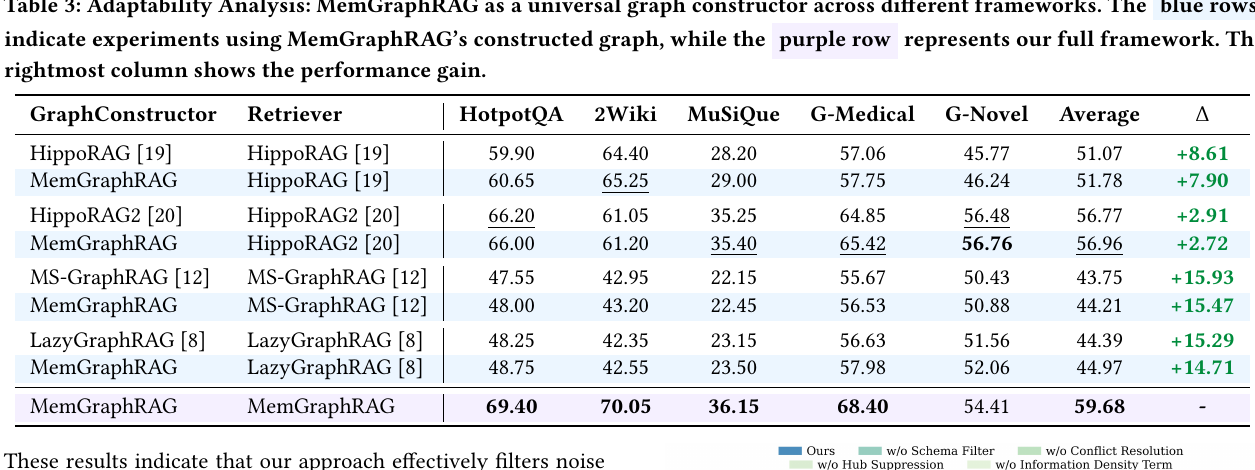
Table 3 把其他方法的原生 graph constructor 替换为 MemGraphRAG graph,再保留原 retriever:
- HippoRAG 平均 51.07 -> 51.78。
- HippoRAG2 平均 56.77 -> 56.96。
- MS-GraphRAG 平均 43.75 -> 44.21。
- LazyGraphRAG 平均 44.39 -> 44.97。
- 完整 MemGraphRAG 平均 59.68。
解读:替换构图器带来的是小幅但一致的改善,说明它更像“图构建质量增强器 + 轻量检索器组合”,不是单纯依赖特定 retriever 的 pipeline trick。
4. Ablation:schema filter、conflict resolution、hub suppression 都有贡献
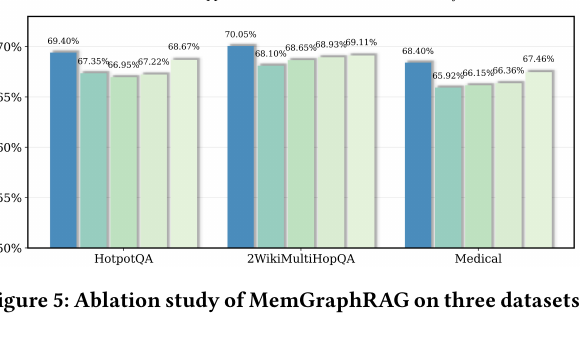
Figure 5 显示完整模型在 HotpotQA、2WikiMultiHopQA、G-Medical 上都最好。去掉 conflict resolution 在 HotpotQA 上下降最大;去掉 schema filter 在 2Wiki 和 G-Medical 上明显变差;去掉 hub suppression 会引入 semantic drift;去掉 information density term 也有小幅下降。
解读:方法收益来自图构建和检索初始化的共同控制,而不是单一组件。对本知识库来说,最值得借鉴的是把 schema stability、conflict adjudication、hub suppression 当成 GraphRAG 质量控制日志,而不只是最终 QA 分数。
5. Graph quality:更高平均度和聚类系数,但需要谨慎解释
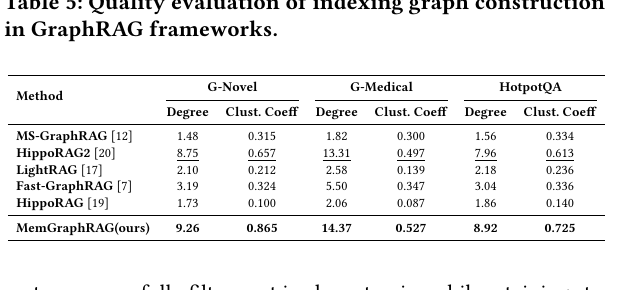
Table 5 显示 MemGraphRAG 的索引图在 G-Novel、G-Medical、HotpotQA 上具有最高平均 degree 和 clustering coefficient:
- G-Novel:Degree 9.26,Clust. Coeff 0.865。
- G-Medical:Degree 14.37,Clust. Coeff 0.527。
- HotpotQA:Degree 8.92,Clust. Coeff 0.725。
解读:更高 degree 和 clustering 说明图更连通、更聚合,但这不是质量充分条件。结合 Table 1/2/3 才能说明这些结构特征确实改善了检索和生成。
局限与开放问题
-
Schema frequency filter 会偏向高频模式,可能压制长尾但关键的稀有 schema。
-
Conflict detection 和 resolution 依赖 LLM/agent 判断及 passage provenance 质量;如果源 passage 本身错误或证据不足,global adjudication 仍可能误判。
-
Type-based bridging 和 similarity-based bridging 能缓解 fragmentation,但也可能引入新的 shortcut edges;hub suppression 只能部分控制 semantic drift。
-
Graph quality 指标使用 degree 和 clustering coefficient,不能直接证明事实正确性、证据可用性或多跳 support-set completion。
-
实验主要是文本输入,论文限制部分指出当前框架尚未覆盖图表、布局、图片等 multimodal repositories。
-
作为 KDD 2026 论文,其代码仓库虽已给出,但本轮还没有复查实现细节、默认阈值和成本配置。
-
作者方向:
- 将 Global Hierarchical Graph 扩展到 multimodal repository,把图表、图片、布局和视觉 patch 纳入记忆层。
- 提高 MemGraphRAG 在更复杂真实语料中的泛化能力。
-
Agent 推断的 Research Opportunities:
- 将 MemGraphRAG 的 global adjudication 和 SAGE - Self-Evolving Agentic Graph-Memory Engine 的 writer-reader feedback 合并:前者保证写入一致性,后者评估写入是否可读、可推理。
- 为 OP-6 设计
memory update audit log:每条 schema/fact/passage 记录 state、frequency、conflict set、resolution decision、source evidence 和后续 retrieval usage。 - 与 CrossAug - Cross-Chunk Graph Augmentation for GraphRAG 结合:CrossAug 找缺失跨 chunk 边,MemGraphRAG 判断这些新增边是否符合稳定 schema 和 provenance。
- 与 LogicPoison - Logical Attacks on GraphRAG 结合:全局 memory 既可能帮助发现冲突,也可能在没有攻击检测时把 poisoned topology 稳定写入图。
- 做 graph construction quality benchmark:同时评估 schema purity、fact correctness、conflict resolution accuracy、bridge edge utility、support-set completion 和 answer faithfulness。
关联与拓展
- 图记忆与增量更新:SAGE - Self-Evolving Agentic Graph-Memory Engine、GraphRAG中的Graph-Memory与Verbalized-Graph带宽比较。
- 图构建质量:GraphRAG中的图构建质量、表示保真与下游回答质量、CrossAug - Cross-Chunk Graph Augmentation for GraphRAG。
- 噪声、冲突与鲁棒性:GraphRAG中的知识图谱噪声传播、GraphRAG的鲁棒性框架、LogicPoison - Logical Attacks on GraphRAG。
- 桥接与证据效用:GraphRAG中的Bridge Evidence 为什么关键、GraphRAG中的Evidence Utility 而非 Evidence Quantity。
- 图结构成本收益:GraphRAG中的图结构强度、构建成本与收益边界。
- 工作流入口:GraphRAG研究工作流索引、2026-06-09-Paper-Pool、2026-06-09-Open-Problems。
研究问题入口
Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q6 证据来源与可解释性