GGraphRAG 文献图谱自动同步
LIT-B8922F45 · 2026

CrossAug - Cross-Chunk Graph Augmentation for GraphRAG

先用 GNN 识别可能缺失跨 chunk 关系的高价值子图,再只对这些区域调用 LLM 做 evidence-grounded completion。

PDF 级阅读卡优先级 P0Jiaming Zhang, Yibo Zhao, Jing Yu, Jianxiang Yu, Xiang Li发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:GraphRAG 依赖实体和关系图,但很多框架在单个 chunk 内抽取关系。

  • 为什么重要:多跳问题经常需要跨 passage 的关系,chunk-local KG 会系统性漏掉这些边。

  • 现有方法:常见 GraphRAG pipeline 先把语料切 chunk,再做局部实体关系抽取;后续检索只能在这个不完整图上做图遍历、community summary 或路径召回。

  • 跨 chunk 关系的证据分布在多个 passage,局部抽取无法覆盖。

  • 全量枚举 chunk 组合再让 LLM 补关系成本不可接受。

  • 缺少在离线索引阶段识别“哪里可能缺边”的低成本机制。

  • GraphRAG 的结构缺陷不能完全靠 query-time top-k 扩大解决,因为缺失关系不在索引里。

方法与机制

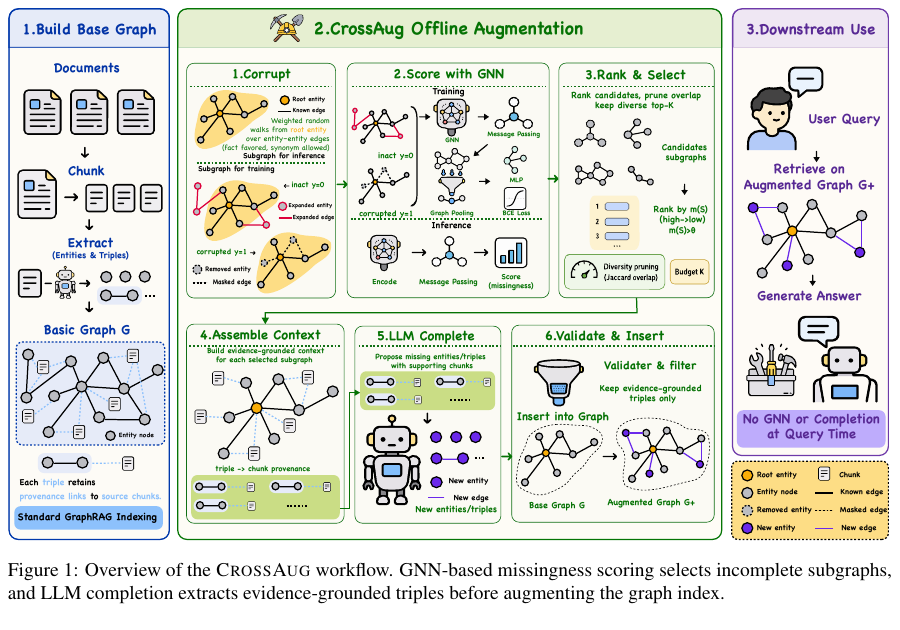
  • 整体框架:已有 GraphRAG index -> 自监督图腐蚀构造训练信号 -> topology-aware GNN 预测缺边区域 -> 选择高分子图 -> LLM 做证据支撑的跨 chunk 关系补全 -> 增强后的 GraphRAG index。
  • 模块分解:
    • Build Base Graph:沿用标准 GraphRAG indexing,从 documents/chunks 中抽取 entities 和 triples,每个 triple 保留 source chunk provenance。
    • Self-supervised Graph Corruption:围绕 root entity 采样局部实体子图,通过 mask fact edges 和 delete entity nodes 构造 corrupted view,把 intact view 标为 y=0,corrupted view 标为 y=1。
    • Topology-aware GNN Scoring:GNN 基于节点语义特征、节点类型和 typed edges 做 message passing,输出子图 missingness score m(S)。
    • Rank & Select:按 m(S) 从高到低排序,去除重叠候选,保留多样的 top-K 子图。
    • Assemble Context:为每个选中子图收集 known triples、候选实体和 provenance chunks。
    • LLM Complete:让 LLM 只返回 evidence-supported new triples / entities。
    • Validate & Insert:过滤不可信补全,把 validated triples 写回 base graph,得到 augmented graph G+。
  • 训练目标:GNN missingness detector 使用 binary cross-entropy,完整采样视图为负例,corrupted view 为正例。它不是预测某条具体缺失边,而是预测局部子图是否“像是不完整”。
  • 推理流程:CrossAug 是离线增强步骤;query-time 不再调用 GNN 或 LLM completion,只在增强后的 graph G+ 上执行下游 GraphRAG 检索和生成。
  • Method Figure 解读:

图 1 把 CrossAug 定位为标准 GraphRAG indexing 和 downstream retrieval 之间的离线增强层。左侧先建立 base graph;中间 CrossAug 先通过 corruption 训练 GNN,再用 GNN 给候选子图打 missingness 分数,选出高分且多样的子图,组装 evidence-grounded context 交给 LLM 补全,最后验证并插入新 triples;右侧强调 query-time 只在 augmented graph 上检索,不再触发 GNN 或 LLM completion。这一点使它更像“索引质量增强器”,不是新的在线检索器。

证据与结果

  • 实验设置:
    • 数据集:MuSiQue、2WikiMultiHopQA、HotpotQA、LiteraryQA。
    • 框架:LightRAG、GFM-RAG、HippoRAG2 三个 LLM-based GraphRAG 框架;LinearRAG 作为额外对比但不应用 CrossAug。
    • Base LLM:Qwen3-32B。
    • Embedding:BGE-M3;reranker:BAAI-bge-reranker-v2-m3。
    • 指标:EM 和 F1;多跳数据集各抽 1,000 个问题,LiteraryQA 使用 test set 前 50 本书共 1,358 queries。
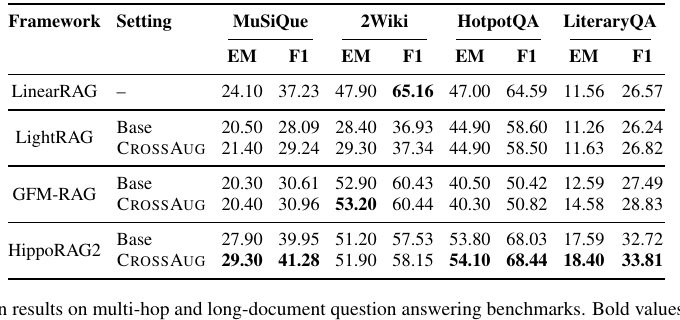
  • Table 2 解读:

CrossAug 在三种 GraphRAG 框架上多数带来小幅稳定增益。HippoRAG2+CrossAug 是整体最强设置:MuSiQue 29.30/41.28,2Wiki 51.90/58.15,HotpotQA 54.10/68.44,LiteraryQA 18.40/33.81。提升最明显的场景是 MuSiQue 和 LiteraryQA,说明跨 chunk 关系对多跳组合和长文档叙事更重要。但提升幅度整体偏稳健而非大幅跃迁,需要结合成本看收益。

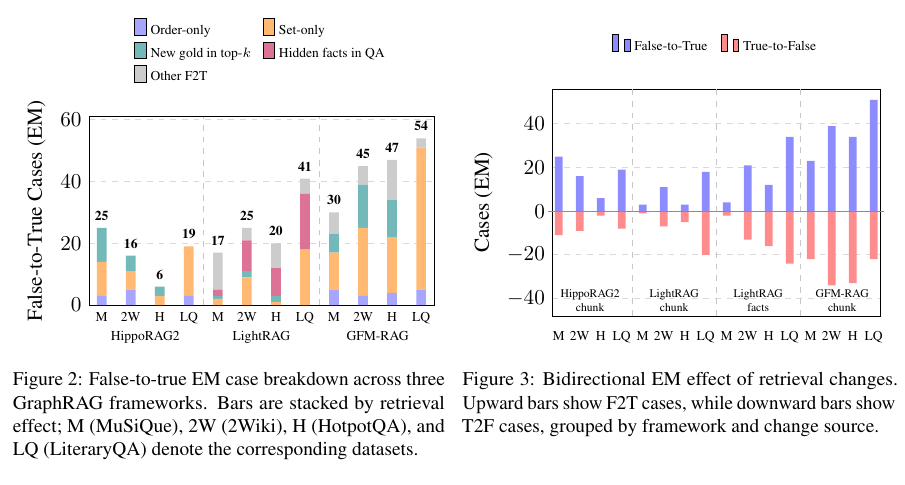
  • Retrieval effect 解读:

Figure 2/3 把成功案例拆成 false-to-true:有些来自 chunk order change,即原本有用证据已经在 top-k 内但被排得更低;有些来自 chunk set change,即 CrossAug 把新的 gold chunks 或 bridge chunks 拉进 top-k;还有一部分来自 hidden facts 直接进入 QA prompt。Figure 3 显示 false-to-true 多于 true-to-false,说明增强图总体让检索更容易命中缺失跨 chunk 证据,而不是主要引入误导证据。

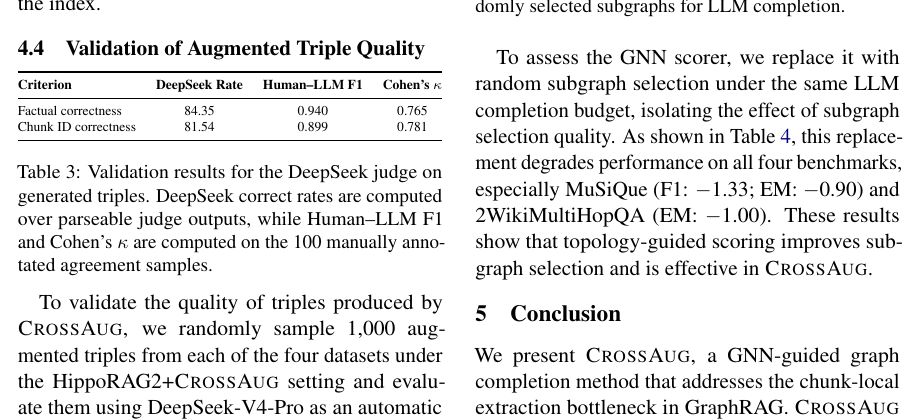
  • Triple quality 与 GNN 消融:

Table 3 显示自动 judge 对增强 triples 的 factual correctness 为 84.35%,chunk citation correctness 为 81.54%;人工-LLM 一致性 F1 分别为 0.940 和 0.899,Cohen's kappa 为 0.765 和 0.781。Table 4 显示把 GNN scorer 替换为同预算随机子图选择会下降:MuSiQue F1 -1.33、2Wiki EM -1.00,说明 topology-guided selection 有价值,但它的提升幅度仍属于“稳定小增益”。

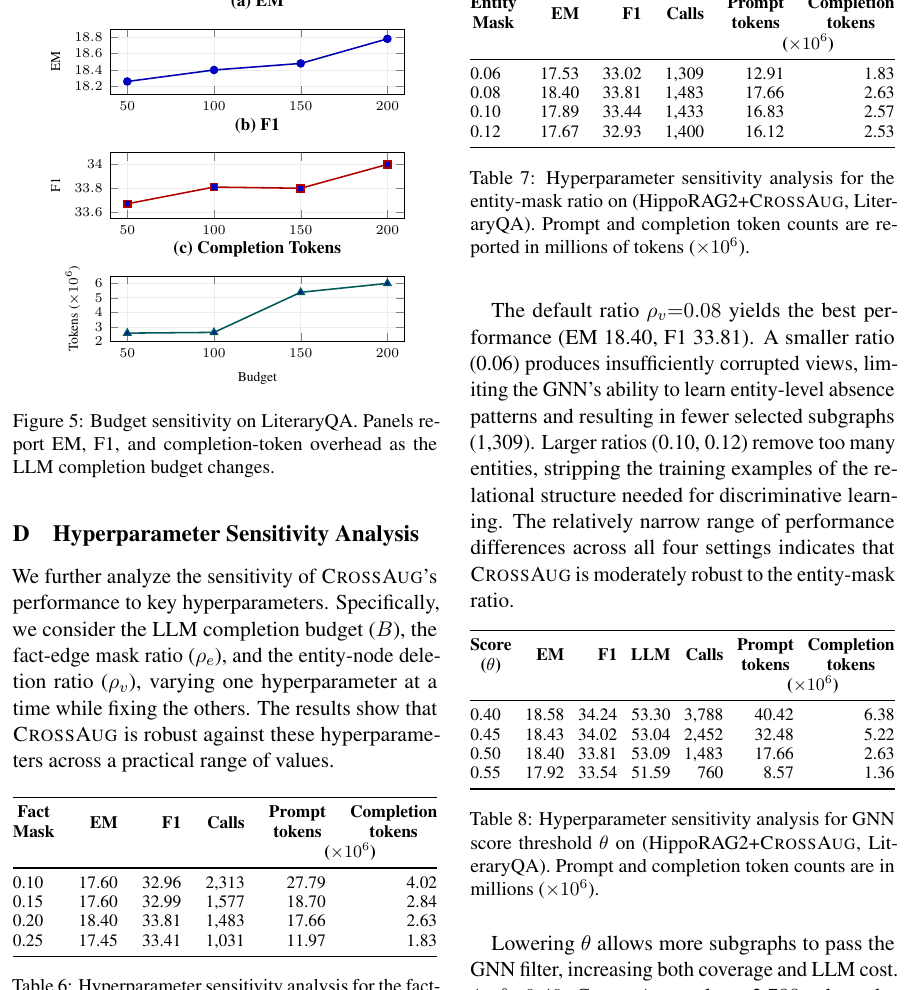
  • 成本与敏感性:

CrossAug 额外成本发生在离线 indexing。默认 LiteraryQA 设置下,额外 1,483 次 LLM calls、17.66M prompt tokens、2.63M completion tokens、5.7h indexing time;论文指出这约为 base pipeline calls 的 8.2%、wall-clock time 的 15.3%。Figure 5 显示预算从 50 到 200 增加时 EM/F1 上升,但 completion tokens 也近似随预算增加。Table 8 显示降低 threshold 会放更多子图通过 GNN filter,效果更高但 token 成本显著增加。

局限与开放问题

  • GNN scorer 依赖已有图拓扑,如果初始图太差,候选缺边区域可能偏。

  • LLM completion 仍有幻觉和成本问题。

  • 跨 chunk 关系的 gold 标注可能难获得。

  • 主结果提升幅度通常较小,需要和离线 token 成本、wall-clock time、存储增量一起评估。

  • 增强 triples 的正确率不是 100%,错误补边可能在高风险领域传播到下游 QA。

  • 方法主要适用于 LLM-extracted graph;对 deterministic structure graph 或非三元组图结构的适配需要额外验证。

  • 作者 Future Work:论文限制部分提出可探索更高效的 context compression 或 selective evidence retrieval,降低每次 LLM completion 的 prompt overhead。

  • Agent 推断的 Research Opportunities:

    • 把 cross-chunk relation recovery 转成 support-set completion 训练信号。
    • 比较“补边”和“增加 top-k 文本”哪一个更有效。
    • 在 BERDG-RAG / QueryShift 类方法中加入 bridge edge candidate mining。
    • 把 GNN missingness score 和 query-time evidence sufficiency score 统一起来:离线预测哪里缺边,在线预测是否需要触发更强检索。
    • 把 enhanced triples 的 citation correctness 作为 GraphRAG 质量控制指标,和 结构化检索中的Faithfulness与Coverage 连接。

关联与拓展

研究问题入口

Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:Beyond Chunk-Local Extraction: Cross-Chunk Graph Augmentation for GraphRAG
  • 中文标题:超越 chunk 内抽取的 GraphRAG 跨 chunk 图增强
  • 作者:Jiaming Zhang, Yibo Zhao, Jing Yu, Jianxiang Yu, Xiang Li
  • 年份:2026
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码链接:https://github.com/DonFinliani/CrossAug
  • 阅读状态:PDF级
  • 所属方向:图构建质量、跨 chunk 关系、多跳 QA
  • 优先级:P0 精读

Background

  • 研究问题:GraphRAG 依赖实体和关系图,但很多框架在单个 chunk 内抽取关系。
  • 为什么重要:多跳问题经常需要跨 passage 的关系,chunk-local KG 会系统性漏掉这些边。
  • 现有方法:常见 GraphRAG pipeline 先把语料切 chunk,再做局部实体关系抽取;后续检索只能在这个不完整图上做图遍历、community summary 或路径召回。

Gap

  • 跨 chunk 关系的证据分布在多个 passage,局部抽取无法覆盖。
  • 全量枚举 chunk 组合再让 LLM 补关系成本不可接受。
  • 缺少在离线索引阶段识别“哪里可能缺边”的低成本机制。
  • GraphRAG 的结构缺陷不能完全靠 query-time top-k 扩大解决,因为缺失关系不在索引里。

Insight

  • 一句话创新点:先用 GNN 识别可能缺失跨 chunk 关系的高价值子图,再只对这些区域调用 LLM 做 evidence-grounded completion。
  • 核心洞察:补图不应该全量展开,而应该由拓扑和自监督缺边信号指导;GNN 做便宜的全局过滤,LLM 只在高 missingness 子图上做昂贵补全。

Method

  • 整体框架:已有 GraphRAG index -> 自监督图腐蚀构造训练信号 -> topology-aware GNN 预测缺边区域 -> 选择高分子图 -> LLM 做证据支撑的跨 chunk 关系补全 -> 增强后的 GraphRAG index。
  • 模块分解:
    • Build Base Graph:沿用标准 GraphRAG indexing,从 documents/chunks 中抽取 entities 和 triples,每个 triple 保留 source chunk provenance。
    • Self-supervised Graph Corruption:围绕 root entity 采样局部实体子图,通过 mask fact edges 和 delete entity nodes 构造 corrupted view,把 intact view 标为 y=0,corrupted view 标为 y=1。
    • Topology-aware GNN Scoring:GNN 基于节点语义特征、节点类型和 typed edges 做 message passing,输出子图 missingness score m(S)。
    • Rank & Select:按 m(S) 从高到低排序,去除重叠候选,保留多样的 top-K 子图。
    • Assemble Context:为每个选中子图收集 known triples、候选实体和 provenance chunks。
    • LLM Complete:让 LLM 只返回 evidence-supported new triples / entities。
    • Validate & Insert:过滤不可信补全,把 validated triples 写回 base graph,得到 augmented graph G+。
  • 训练目标:GNN missingness detector 使用 binary cross-entropy,完整采样视图为负例,corrupted view 为正例。它不是预测某条具体缺失边,而是预测局部子图是否“像是不完整”。
  • 推理流程:CrossAug 是离线增强步骤;query-time 不再调用 GNN 或 LLM completion,只在增强后的 graph G+ 上执行下游 GraphRAG 检索和生成。
  • Method Figure 解读:

CrossAug-method-figure

图 1 把 CrossAug 定位为标准 GraphRAG indexing 和 downstream retrieval 之间的离线增强层。左侧先建立 base graph;中间 CrossAug 先通过 corruption 训练 GNN,再用 GNN 给候选子图打 missingness 分数,选出高分且多样的子图,组装 evidence-grounded context 交给 LLM 补全,最后验证并插入新 triples;右侧强调 query-time 只在 augmented graph 上检索,不再触发 GNN 或 LLM completion。这一点使它更像“索引质量增强器”,不是新的在线检索器。

Results

  • 实验设置:
    • 数据集:MuSiQue、2WikiMultiHopQA、HotpotQA、LiteraryQA。
    • 框架:LightRAG、GFM-RAG、HippoRAG2 三个 LLM-based GraphRAG 框架;LinearRAG 作为额外对比但不应用 CrossAug。
    • Base LLM:Qwen3-32B。
    • Embedding:BGE-M3;reranker:BAAI-bge-reranker-v2-m3。
    • 指标:EM 和 F1;多跳数据集各抽 1,000 个问题,LiteraryQA 使用 test set 前 50 本书共 1,358 queries。
  • Table 2 解读:

CrossAug-table2-results

CrossAug 在三种 GraphRAG 框架上多数带来小幅稳定增益。HippoRAG2+CrossAug 是整体最强设置:MuSiQue 29.30/41.28,2Wiki 51.90/58.15,HotpotQA 54.10/68.44,LiteraryQA 18.40/33.81。提升最明显的场景是 MuSiQue 和 LiteraryQA,说明跨 chunk 关系对多跳组合和长文档叙事更重要。但提升幅度整体偏稳健而非大幅跃迁,需要结合成本看收益。

  • Retrieval effect 解读:

CrossAug-fig2-fig3-retrieval-effects

Figure 2/3 把成功案例拆成 false-to-true:有些来自 chunk order change,即原本有用证据已经在 top-k 内但被排得更低;有些来自 chunk set change,即 CrossAug 把新的 gold chunks 或 bridge chunks 拉进 top-k;还有一部分来自 hidden facts 直接进入 QA prompt。Figure 3 显示 false-to-true 多于 true-to-false,说明增强图总体让检索更容易命中缺失跨 chunk 证据,而不是主要引入误导证据。

  • Triple quality 与 GNN 消融:

CrossAug-table3-table4-validation-ablation

Table 3 显示自动 judge 对增强 triples 的 factual correctness 为 84.35%,chunk citation correctness 为 81.54%;人工-LLM 一致性 F1 分别为 0.940 和 0.899,Cohen's kappa 为 0.765 和 0.781。Table 4 显示把 GNN scorer 替换为同预算随机子图选择会下降:MuSiQue F1 -1.33、2Wiki EM -1.00,说明 topology-guided selection 有价值,但它的提升幅度仍属于“稳定小增益”。

  • 成本与敏感性:

CrossAug-budget-and-sensitivity

CrossAug 额外成本发生在离线 indexing。默认 LiteraryQA 设置下,额外 1,483 次 LLM calls、17.66M prompt tokens、2.63M completion tokens、5.7h indexing time;论文指出这约为 base pipeline calls 的 8.2%、wall-clock time 的 15.3%。Figure 5 显示预算从 50 到 200 增加时 EM/F1 上升,但 completion tokens 也近似随预算增加。Table 8 显示降低 threshold 会放更多子图通过 GNN filter,效果更高但 token 成本显著增加。

Limitations

  • GNN scorer 依赖已有图拓扑,如果初始图太差,候选缺边区域可能偏。
  • LLM completion 仍有幻觉和成本问题。
  • 跨 chunk 关系的 gold 标注可能难获得。
  • 主结果提升幅度通常较小,需要和离线 token 成本、wall-clock time、存储增量一起评估。
  • 增强 triples 的正确率不是 100%,错误补边可能在高风险领域传播到下游 QA。
  • 方法主要适用于 LLM-extracted graph;对 deterministic structure graph 或非三元组图结构的适配需要额外验证。

Future Directions

  • 作者 Future Work:论文限制部分提出可探索更高效的 context compression 或 selective evidence retrieval,降低每次 LLM completion 的 prompt overhead。
  • Agent 推断的 Research Opportunities:
    • 把 cross-chunk relation recovery 转成 support-set completion 训练信号。
    • 比较“补边”和“增加 top-k 文本”哪一个更有效。
    • 在 BERDG-RAG / QueryShift 类方法中加入 bridge edge candidate mining。
    • 把 GNN missingness score 和 query-time evidence sufficiency score 统一起来:离线预测哪里缺边,在线预测是否需要触发更强检索。
    • 把 enhanced triples 的 citation correctness 作为 GraphRAG 质量控制指标,和 结构化检索中的Faithfulness与Coverage 连接。

与本知识库的连接

本卡片待补

  • 检查代码中 GNN scorer 的具体采样参数和默认 budget。
  • 将 Table 2/3/4/5 转成结构化表,便于与 SubQRAG、A2RAG 做成本收益比较。
  • 复查 CrossAug 是否能用于当前 QueryShift / BERDG-RAG 的 support-set completion 诊断。