研究问题与动机
- 研究问题:Knowledge Hypergraph 可以把 n-ary relation 作为一个 hyperedge 表达,但现有 KH-based RAG 往往仍用固定 pipeline 做一次性检索,没有把 query 分解、图搜索和中间答案反馈放进同一个动态规划过程。
- 为什么重要:复杂多跳问题经常需要在多个实体和多个 hyperedge 之间跳转。若只按原始 query 做相似度检索,系统容易拿到语义相近但推理链不完整的证据。
- 现有路线:
- 普通 KG / GraphRAG 多把关系拆成二元边,表达多实体事实时会丢失整体语义。
- HyperGraphRAG 等 KH 路线能表达 hyperedge,但检索过程仍偏 static retrieval plan。
- Agentic GraphRAG / RL GraphRAG 强调多轮轨迹,但不一定显式利用 hyperedge overlap 的结构语义。
- 对本知识库的意义:PRoH 把 Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning 的 hypergraph environment、GraphRAG作为Query-Planning 的 query planning、以及 DOTRAG - Retrieval-Time Reasoning Along Paths 的 path-first retrieval 连接起来:它不是单纯换成超图索引,而是把“规划 DAG -> 状态搜索 -> EWO 路径检索”做成一条可归因的执行链。
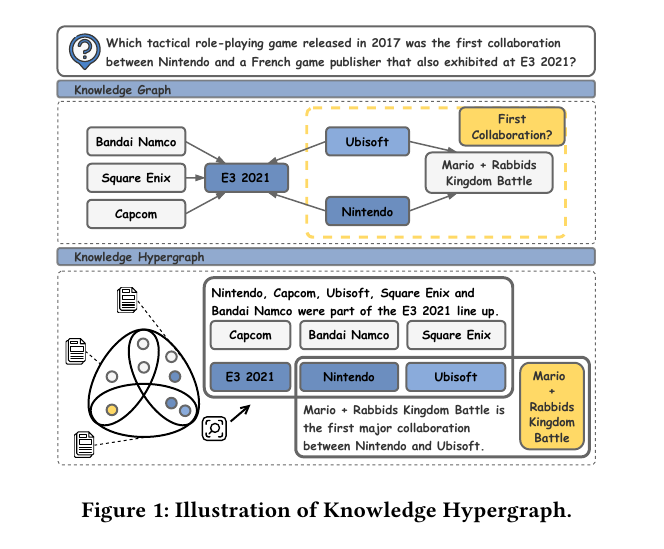
Figure 1 的关键不是“超图更复杂”,而是 n-ary fact 在超图里以一个 hyperedge 承载完整语义;如果拆成普通二元边,Nintendo、Ubisoft、Mario + Rabbids Kingdom Battle 和 E3 2021 的联合事实会被切碎。
- Static retrieval planning:KH-based RAG 通常使用预定义检索步骤,不能根据问题语义和局部图结构改变检索计划。
- Non-adaptive retrieval execution:检索多为 one-shot,不能用中间 subquestion answer 反向修正后续子问题和检索方向。
- Superficial hyperedge use:很多方法把 hyperedge 视作访问 text chunk 的入口,而不是可评分、可遍历、可组合的推理对象。
- 复杂多跳中的 branch ambiguity 没被显式处理:一个子问题可能有多个候选答案和路径,线性分解会过早锁死错误分支。
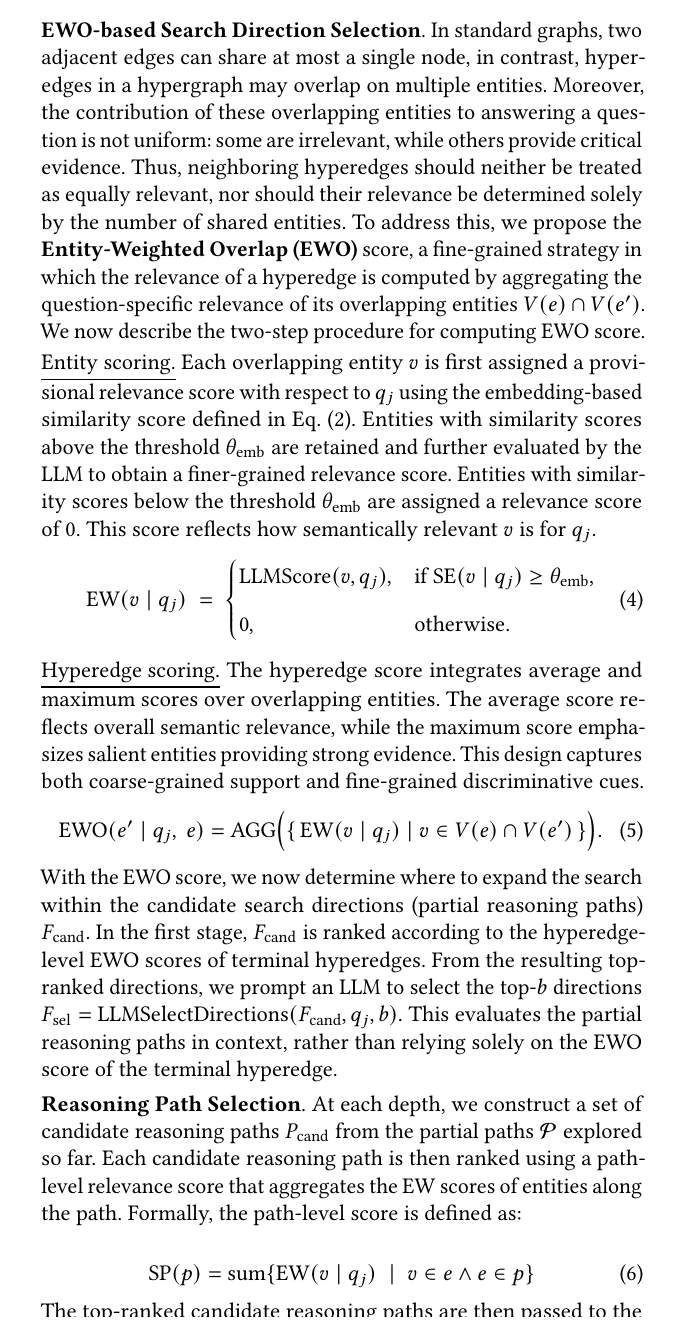
- 缺少细粒度路径选择信号:普通 overlap 或相似度无法判断两个 hyperedge 共享的实体是否真的支持当前 subquestion。
方法与机制
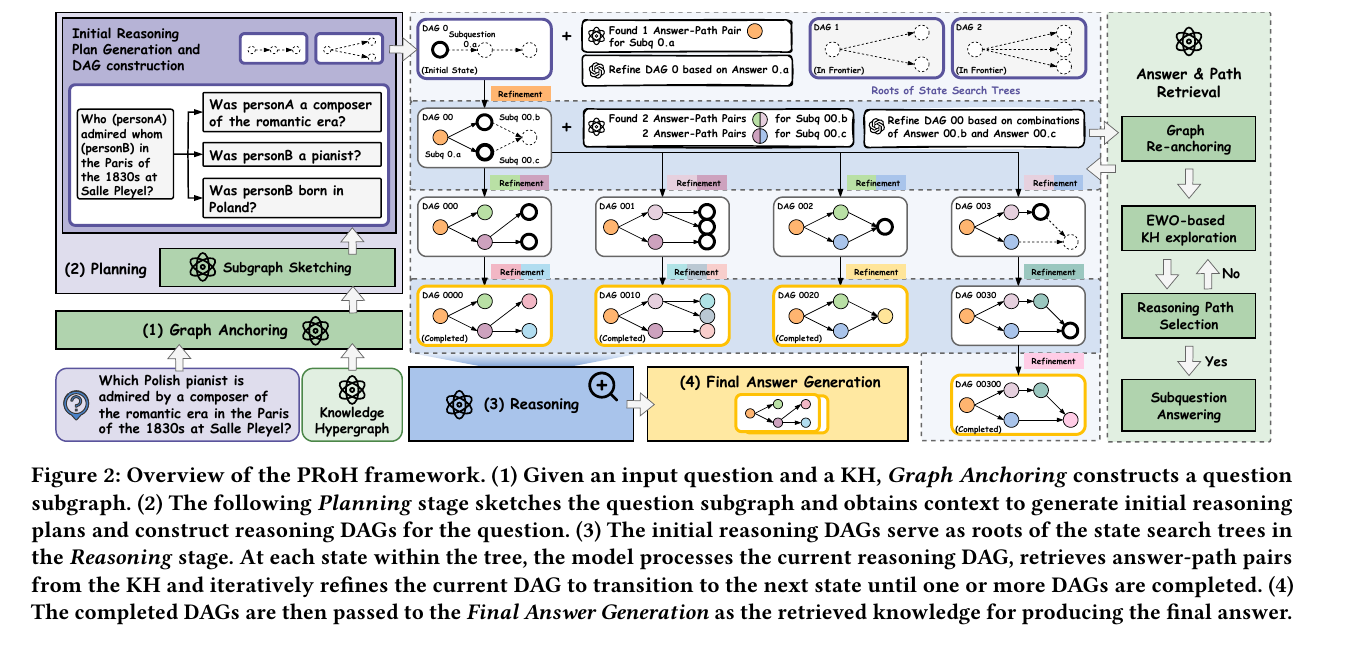
1. 总体框架:Graph Anchoring -> Planning -> Reasoning -> Final Answer
输入:问题 $q$ 和知识超图:
其中实体 $v=(v_{nm},v_{desc})$,hyperedge $e=(e_{nm},V(e),e_{ref})$。
计算链路:
- Graph Anchoring:从 $q$ 中识别 topic entities,并匹配 target hyperedges,构造 question subgraph $H_q$。
- Planning:在 $H_q$ 的局部 plan context 上生成多个初始 reasoning DAG。
- Reasoning:把每个 DAG 当作状态搜索树的根,逐层求解 subquestions;每个子问题调用 answer-and-path retrieval。
- Final Answer Generation:把 completed DAGs 中的 answer-path pairs 聚合为候选答案,再由 LLM judge 选出最终答案。
输出:最终答案 $a^*(q)$,以及可追踪的 completed reasoning DAG、answer-path pairs 和超图路径证据。
直观解释:PRoH 把 GraphRAG 的检索从“取一批相似节点/文本”改成“围绕问题生成可执行 DAG,并在每个 DAG 状态下取可解释路径”。
2. Graph Construction and Synonym Hyperedge Augmentation
输入:从语料构建的 KH,以及实体名、实体描述、hyperedge name 的向量索引。
计算链路:
- 采用 HyperGraphRAG 风格构建 KH:
- 对实体名 embedding 计算相似度:
- 若 $sim(v_i,v_j)\ge \tau$,先形成相似实体图,再取 connected components。
- LLM 判断 component 内实体是否同义。
- 对确认同义的实体组添加 synonym hyperedge。
输出:带 synonym hyperedges 的 KH。
直观解释:这一步减少同义实体分裂导致的 anchor miss。它不是最终推理模块,但会影响 topic entity initialization、target hyperedge match 和后续 path search 的召回。
3. Graph Anchoring:把问题固定到局部超图
输入:问题 $q$、KH $H$、topic keyword candidates、hyperedge name vector index。
计算链路:
- LLM 从问题中抽取 topic keywords。
- 用 keyword embedding 与 entity name embedding 做 cosine matching,得到 topic entities $\mathcal{T}$。
- 用 question embedding 与 hyperedge name embedding 匹配 target hyperedges $\mathcal{R}$。
- 取 $\mathcal{T}$ 和 $\mathcal{R}$ 的 $D_{max}$-hop neighborhood,形成 question subgraph:
输出:面向当前问题的局部 KH scope。
直观解释:Graph Anchoring 决定 planner 能看到什么。如果 anchor 错,后续 DAG 再聪明也会在错误子图里搜索。
4. Planning:从局部 KH 生成可执行 reasoning DAG
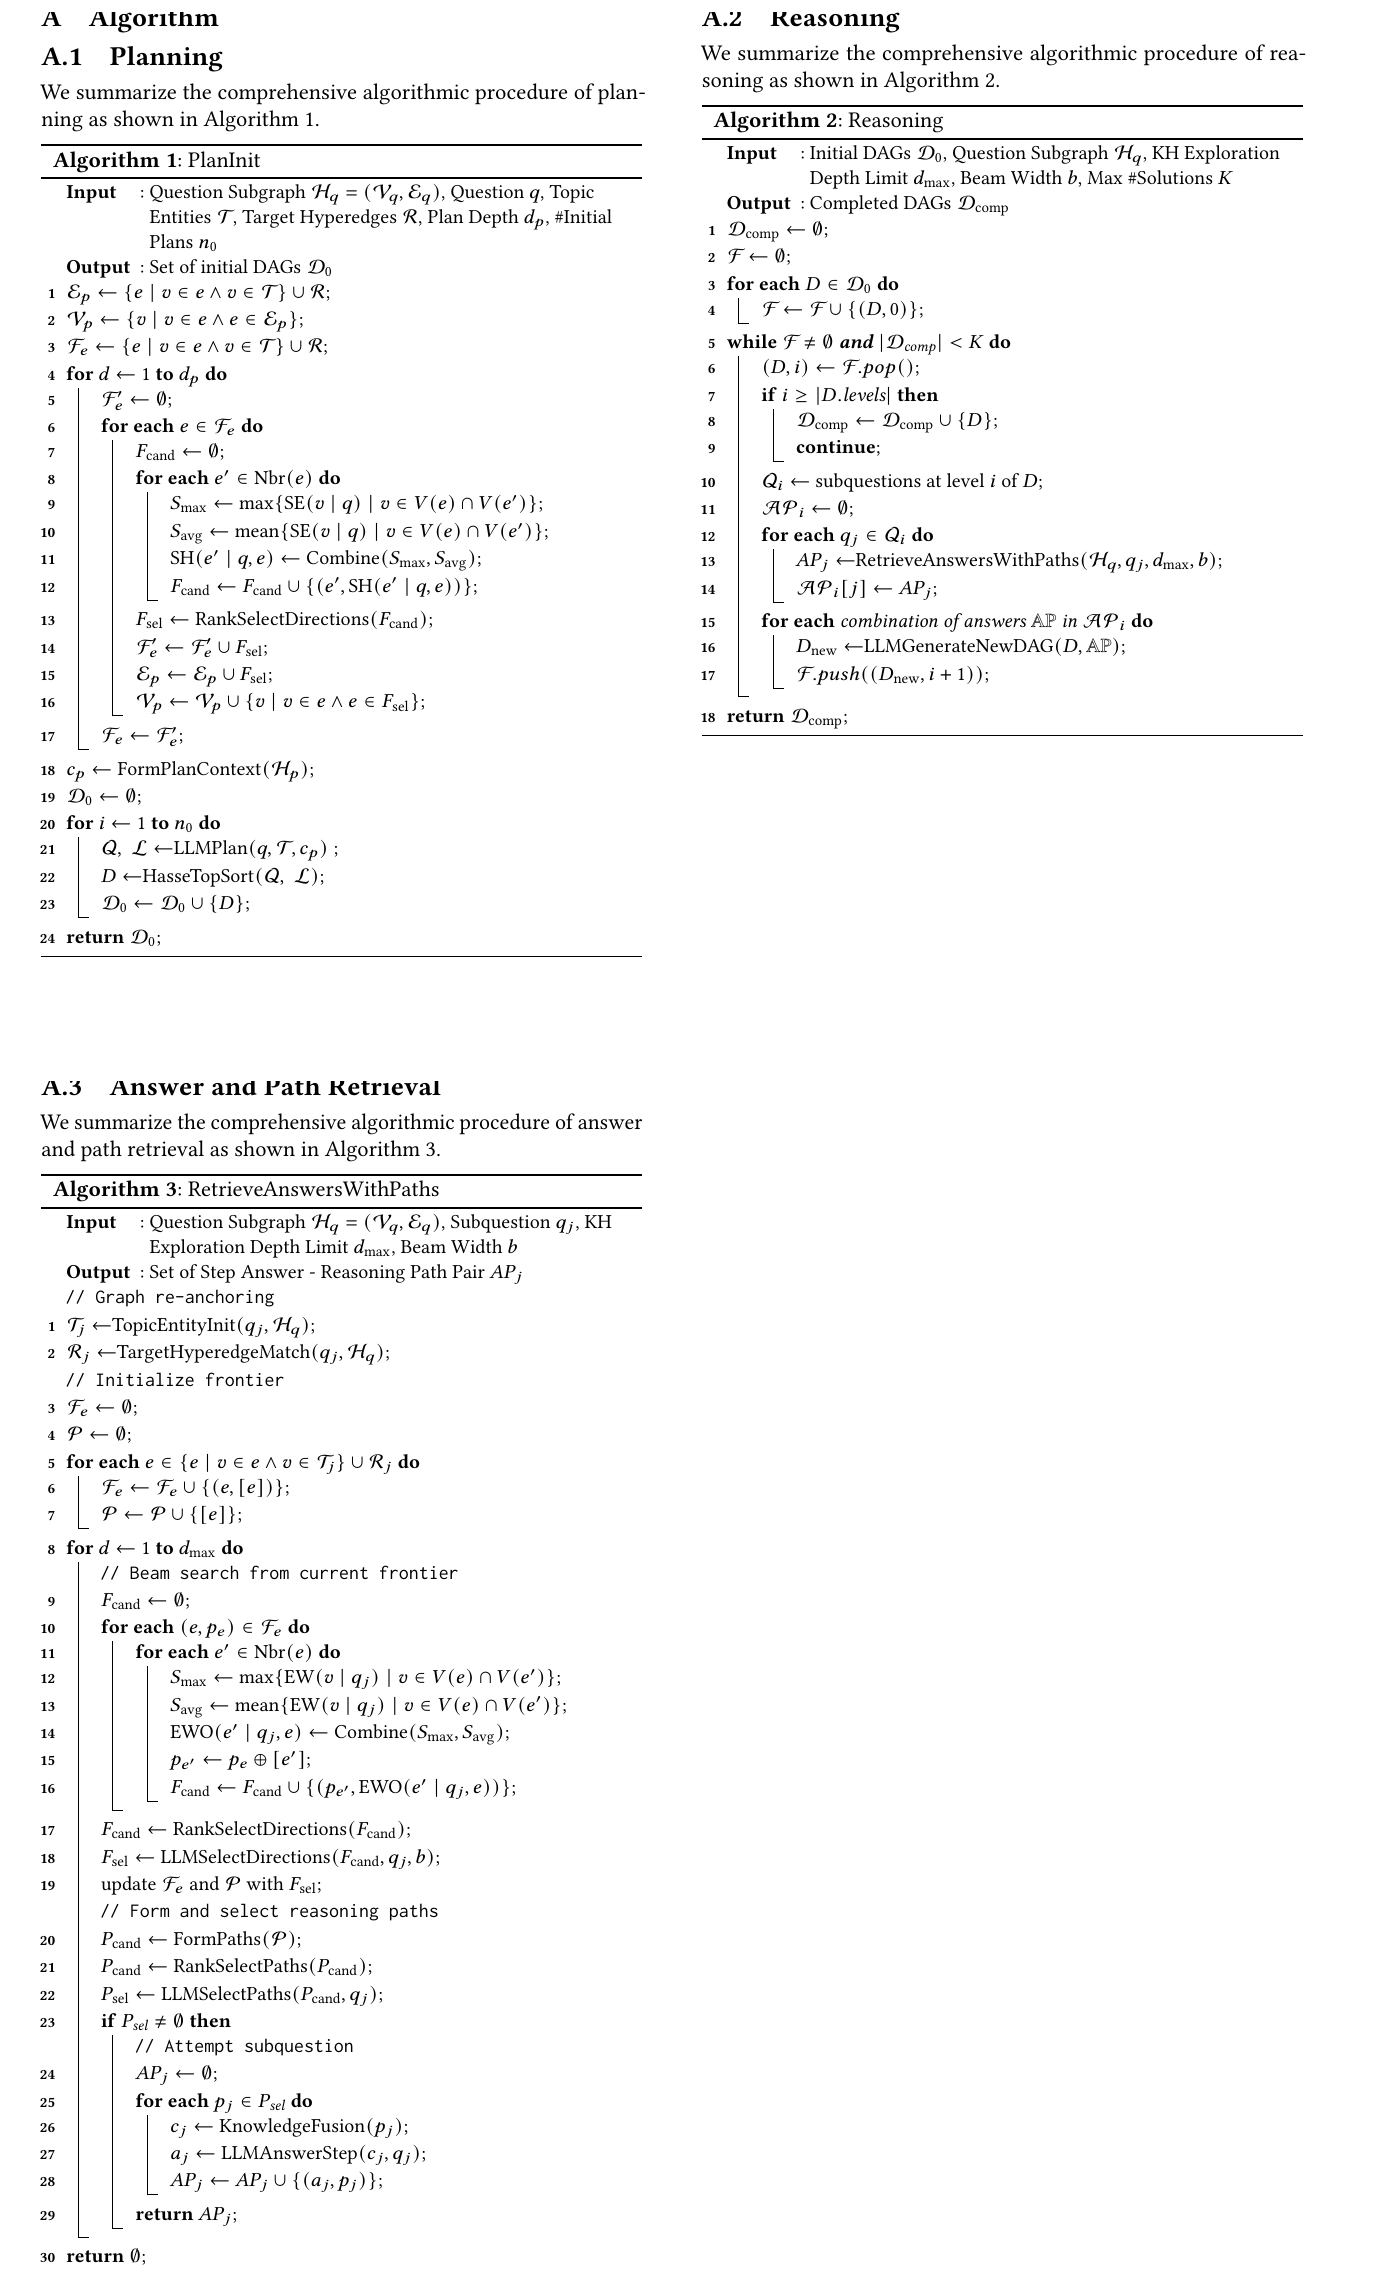
输入:question subgraph $H_q$、问题 $q$、topic entities $\mathcal{T}$、target hyperedges $\mathcal{R}$、plan depth $d_p$、初始 plan 数 $n_0$。
计算链路:
- 先围绕 topic entities / target hyperedges 构造 plan context graph:
- 对实体计算 question relevance:
- 对候选 hyperedge 与当前 hyperedge 的 overlap 计算 relevance:
- 按 $SH$ 选择局部搜索方向,形成 plan context $c_p$。
- LLM 基于 $(q,\mathcal{T},c_p)$ 生成候选 subquestions 和 dependencies:
- 对 dependency graph 做 Hasse reduction,去掉传递冗余边:
输出:一组初始 reasoning DAGs $\mathcal{D}0={D_1,\ldots,D{n_0}}$。
直观解释:这里的 planner 不是纯语言分解器,而是先用局部超图约束 LLM:它生成的 subquestion 必须更贴近可检索的实体和 hyperedge。
5. Reasoning:在 DAG 状态空间中迭代求解和改写
原始笔记摘录已截断;请打开来源笔记阅读完整内容。
证据与结果
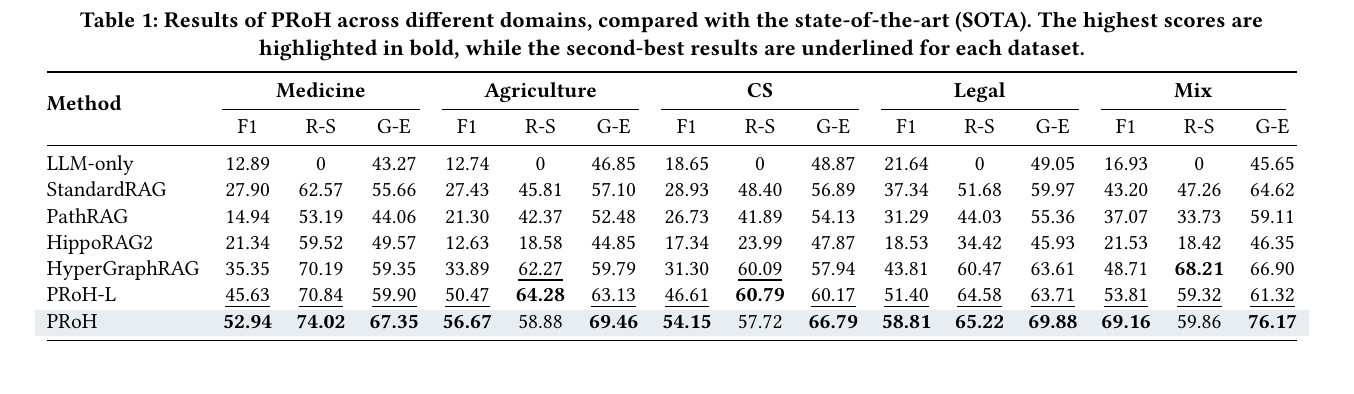
1. 主结果:PRoH 在五个 KHQA domain 上超过 HyperGraphRAG
Table 1 显示 PRoH 在 Medicine、Agriculture、CS、Legal、Mix 上整体优于 HyperGraphRAG:
- PRoH F1:52.94、56.67、54.15、58.81、69.16。
- HyperGraphRAG F1:35.35、33.89、31.30、43.81、48.71。
- PRoH G-E:67.35、69.46、66.79、69.88、76.17。
- 论文报告相对 HyperGraphRAG 平均提升:F1 +19.73%,G-E +8.41%。
解读:PRoH 的提升集中在 answer F1 和 generation evaluation,而 R-S 不总是最高。这说明它不是简单追求检索片段语义相似,而是通过路径和 DAG 让证据更服务最终推理。
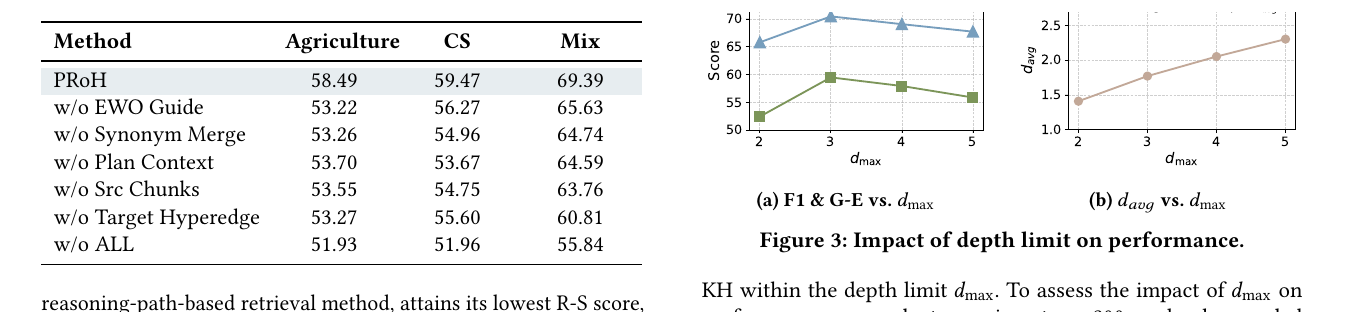
2. 消融与搜索深度:目标 hyperedge、plan context、EWO 都有贡献
Table 2 的 F1 消融显示:
- 去掉 Target Hyperedge,Mix 从 69.39 降到 60.81,是最明显的单模块下降之一。
- 去掉 Plan Context,Agriculture / CS / Mix 变为 53.70 / 53.67 / 64.59,说明 graph-aware planning 确实影响初始 DAG 质量。
- 去掉 EWO Guide 后为 53.22 / 56.27 / 65.63,说明路径方向选择需要语义化 overlap,而不是只看结构连接。
- w/o ALL 下降到 51.93 / 51.96 / 55.84,证明多个模块互补。
Figure 3 显示 $d_{max}=3$ 时 F1/G-E 达到峰值;继续增加深度会带来冗余上下文和轻微性能下降,同时平均实际深度 $d_{avg}$ 继续增加。
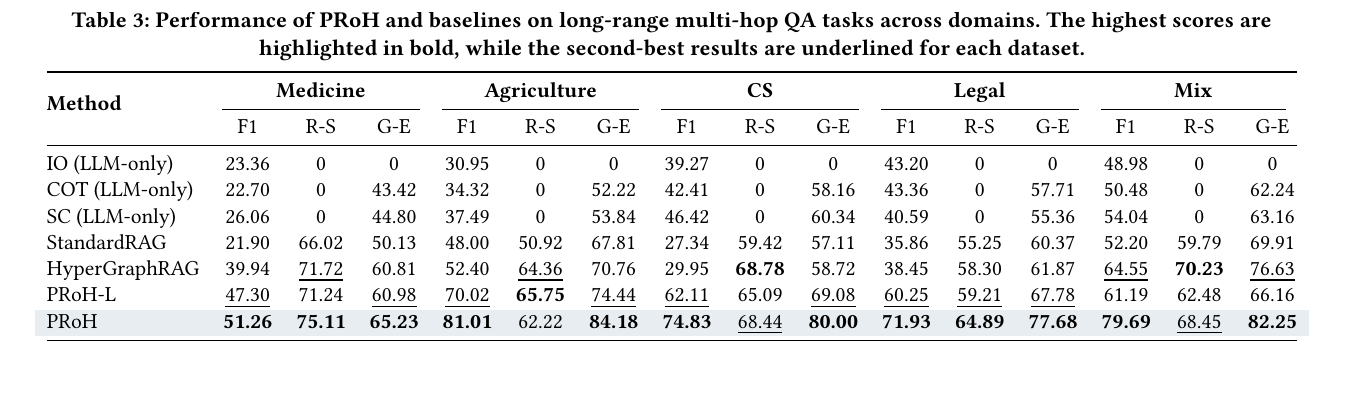
3. 长程多跳:3-6 hop 下优势更明显
Table 3 针对 long-range multi-hop QA:
- PRoH F1:Medicine 51.26,Agriculture 81.01,CS 74.83,Legal 71.93,Mix 79.69。
- HyperGraphRAG F1:Medicine 39.94,Agriculture 52.40,CS 29.95,Legal 38.45,Mix 64.55。
- 论文报告平均 F1 +26.68%,CS 最高提升到 +44.87%。
解读:PRoH 的优势在长程多跳更强,符合它的设计假设:动态 DAG 和 EWO 路径搜索主要解决的是长链、分支和跨 hyperedge 组合问题。
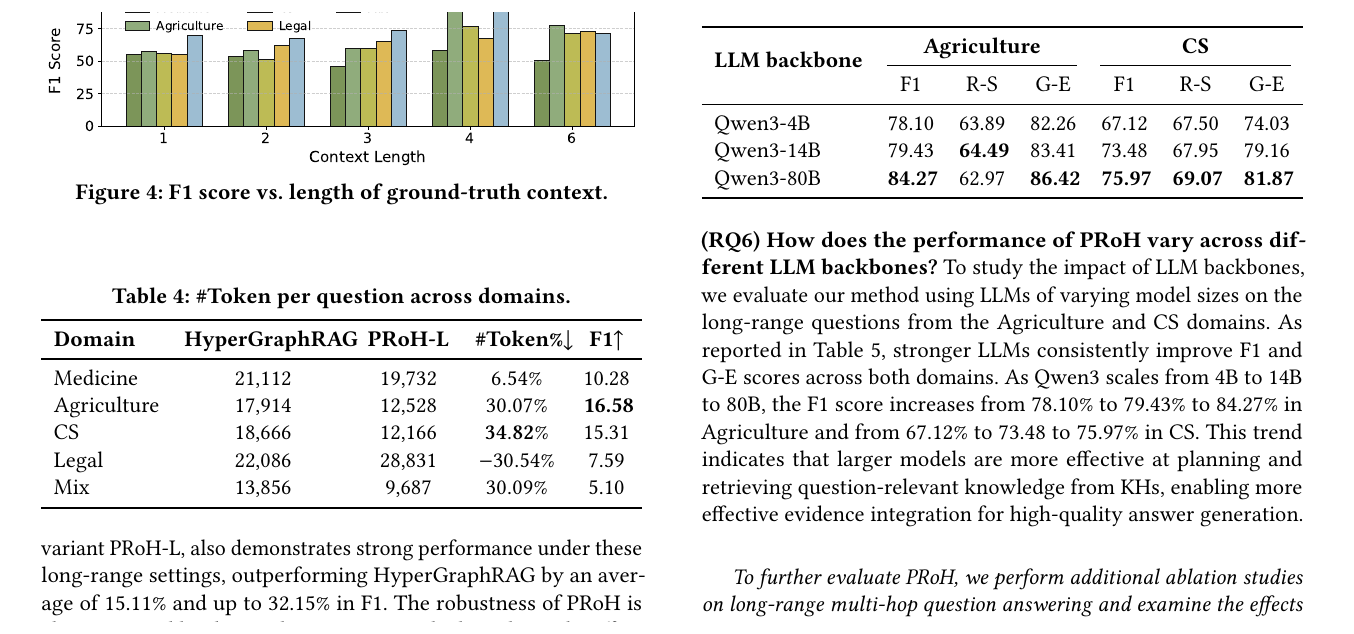
4. 效率与 backbone:PRoH-L 降 token,较强 LLM 提升规划/检索质量
Table 4 比较 PRoH-L 与 HyperGraphRAG 的 token:
- Medicine 少 6.54%,F1 +10.28。
- Agriculture 少 30.07%,F1 +16.58。
- CS 少 34.82%,F1 +15.31。
- Legal token 增加 30.54%,但 F1 +7.59。
- Mix 少 30.09%,F1 +5.10。
Table 5 显示 Qwen3 backbone 从 4B 到 80B,Agriculture / CS 的 F1 和 G-E 整体提高。解读上,PRoH 依赖 LLM 做 planning、path selection 和 final judge,因此模型规模会影响规划质量和路径筛选质量。
局限与开放问题
-
Final answer generation 仍是最大误差来源:附录 Figure 7 报告 Final Answer Generation 占 43% error,Planning 占 33%,Reasoning State Search 和 Graph Anchoring 各 10%,Answer and Path Retrieval 约 5%。
-
Answer and Path Retrieval 是 token 大户:附录 Figure 6 显示该模块消耗最多 token,尤其是 LLM-based entity scoring 和 path selection。
-
规划质量仍依赖 LLM:PRoH 把 planning 显式化,但没有训练 planner;错误 subquestion 或 dependency 仍会让搜索树扩大或偏离。
-
Anchor 仍是上游瓶颈:topic entity 和 target hyperedge 匹配错误会限制 plan context,进而影响整个 DAG。
-
搜索成本与轨迹数量相关:BFS 在部分设置中 F1 更高,但 state visits 明显增多;论文选择 DFS 是性能/成本折中。
-
实验主要围绕 KHQA domain,尚未证明在开放域文档 GraphRAG、动态增量图、多模态图或用户私有知识库中的泛化。
-
EWO 中的
LLMScore和 path selection 仍是黑盒判断,缺少可学习的、可校准的路径效用模型。 -
把 PRoH 的 DAG state search 变成可训练策略:对接 Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning 和 GraphRAG-R1 - Process-Constrained Reinforcement Learning for GraphRAG,用过程奖励优化
LLMSelectDirections、LLMSelectPaths和LLMGenerateNewDAG。 -
做 query complexity routing:不是所有问题都需要 PRoH 级别的动态超图规划,可在 2026-06-09-Open-Problems 下比较 flat RAG、light graph、PRoH-style hypergraph planning 和 RL agentic graph environment。
-
建立 evidence path utility:围绕 2026-06-09-Open-Problems,把 EWO、path score、support coverage、semantic shortcut rate、tail path miss 统一到一个路径效用诊断框架。
-
做 planning-guided attribution:在 2026-06-09-Open-Problems 中记录
plan_context_graph、initial_reasoning_DAG、state=(D,i)、frontier F、answer_path_pairs、EWO、selected_directions、selected_paths、D_new、completed_DAGs、d_max、d_avg、n0、K、state visits 和 support gain。 -
用可学习 scorer 替代部分 LLM judge:把 EWO entity score、direction choice、path acceptance 和 final answer consistency 分别蒸馏成轻量模型,降低 token 成本。
-
将 PRoH 与 NaviRAG - Active Knowledge Navigation for RAG 对照:NaviRAG 处理 hierarchical document navigation,PRoH 处理 knowledge hypergraph traversal,两者可以统一为“局部 scope 选择 -> 分支展开 -> sufficiency stop”。
关联与拓展
- Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning:Graph-R1 把 hypergraph 检索做成 RL environment;PRoH 提供非训练式的 planning + state search baseline,可作为 RL action/state 设计参考。
- GraphRAG-R1 - Process-Constrained Reinforcement Learning for GraphRAG:GraphRAG-R1 强调 process reward 和 retrieval masked loss;PRoH 的
answer_path_pairs、completed_DAGs、EWO可转成过程监督信号。 - DOTRAG - Retrieval-Time Reasoning Along Paths:两者都把 path 作为 first-class evidence;DOTRAG 偏路径工作区和路径判断,PRoH 偏超图 DAG planning 和 EWO 方向选择。
- NaviRAG - Active Knowledge Navigation for RAG:NaviRAG 是 knowledge tree 上的 active navigation,PRoH 是 knowledge hypergraph 上的 active planning/reasoning。
- GraphRAG中的Agentic轨迹质量:PRoH 的 trajectory 可以拆成 graph anchoring、DAG planning、state search、path selection、step answer、final judge,每一段都能定义质量指标。
- GraphRAG作为Query-Planning:PRoH 是一个直接案例:query planning 不是 prompt trick,而是显式生成、执行、修正 DAG。
- GraphRAG中的接口-代理-停止决策闭环:PRoH 的停止条件包括
K个 completed DAG、DFS frontier、path sufficiency 和 final judge,可用于分析 agentic 检索何时停止。 - Graph搜索的完备性与Beam-Search偏差:PRoH 用 beam width 和 DFS 控制成本,但也会引入 top-k path bias;Table 7 的 BFS/DFS 对比可作为搜索策略证据。
- 2026-06-09-Open-Problems:重点连接 OP-3、OP-9、OP-10。
研究问题入口
Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略, Q6 证据来源与可解释性