GGraphRAG 文献图谱自动同步
LIT-8B4C4C6F · 2026

NaviRAG - Active Knowledge Navigation for RAG

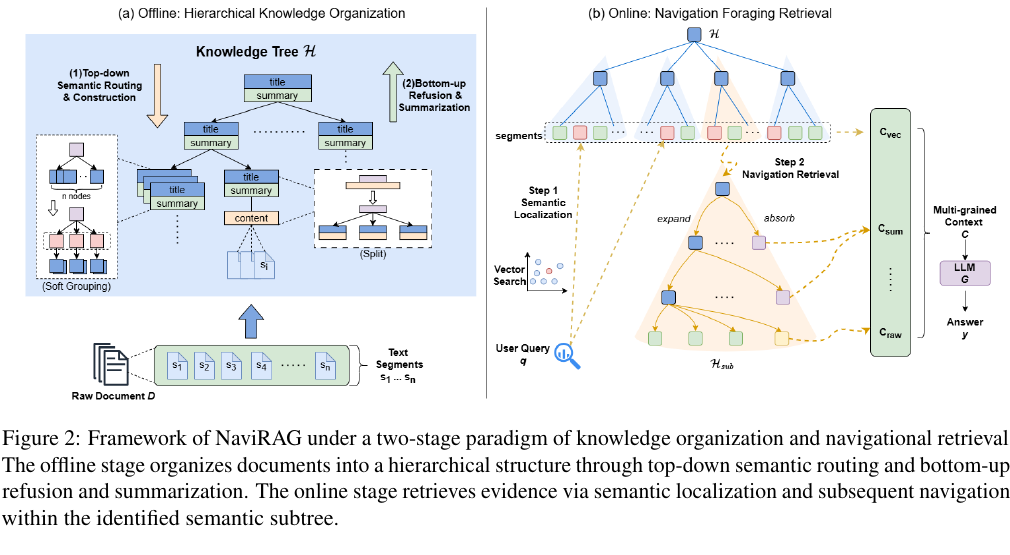
NaviRAG 把证据获取从 passive segment retrieval 改写成 active knowledge navigation:先把文档组织成可导航的 hierarchical Knowledge Tree,再让 LLM agent 在 query-time 先定位语义子树、再自顶向下逐步展开证据。

PDF 级阅读卡优先级 P1Jihao Dai, Dingjun Wu, Yuxuan Chen, Zheni Zeng, Yukun Yan, Zhenghao Liu, Maosong Sun发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:传统 RAG 通常把 query 映射到固定粒度、相互孤立的 text chunks。复杂长链推理任务需要先定位粗粒度语义区域,再沿着上下文约束逐步找到细粒度证据。

  • 为什么重要:NarrativeQA、LooGLE-long、LongBench-v2 这类长文档 / 长依赖任务中,答案往往不在单个局部 chunk 里,而是需要跨段落、跨语义层级整合证据。

  • 现有路线:

    • Flat vector RAG:简单、快,但 fixed chunking 有粒度冲突。
    • GraphRAG / LightRAG:能建结构,但 global aggregation 成本高,local subgraph 又可能漏掉完整证据。
    • HippoRAG2:强调认知启发的 associative retrieval,但仍不是显式的 coarse-to-fine navigation。
  • 对本知识库的意义:NaviRAG 把 GraphRAG 的“图遍历 / 计划检索 / 停止判断”问题具体化为 knowledge tree 上的 active navigation,可直接连接 GraphRAG作为Query-Planning、GraphRAG中的接口-代理-停止决策闭环 和 OP-10。

  • Granularity trade-off:细粒度 chunks 精确但缺上下文;粗粒度 chunks 保留上下文但引入噪声、削弱匹配。

  • Single-step retrieval 不够:一次性 top-k 相似检索无法根据已经获得的证据继续决定“停在当前层级”还是“向下展开到更细证据”。

  • 结构化 RAG 成本/覆盖两难:全局图或全局摘要成本高;局部子图检索可能错过跨区域证据。

  • 缺少可操作的 navigation state:很多 agentic RAG 只记录 tool calls 或检索轮数,但没有把知识库组织成可分层进入、可局部展开、可回到原文的结构。

  • 停止与证据充分性仍弱:NaviRAG 有 branch termination,但还没有把 evidence sufficiency / global goal / retrieval budget 学成明确控制策略。

方法与机制

1. Motivation:从固定 chunks 转向可导航知识空间

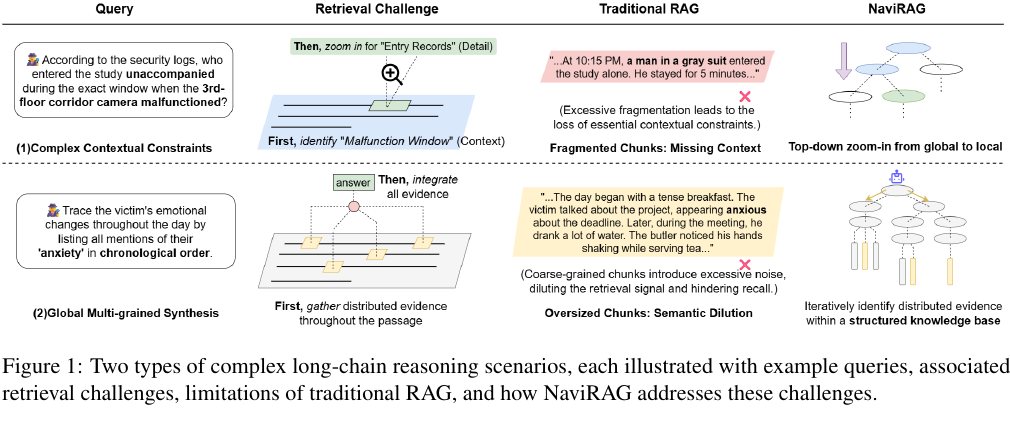
Figure 1 对比了两类复杂长链推理:

  • Complex contextual constraints:需要先识别特定 context window,再 zoom in 到细节。
  • Global multi-grained synthesis:需要聚合分散证据,而不是把 oversized chunks 一次性塞给 LLM。

NaviRAG 的回应是:先把文档变成从全局主题到局部细节的可导航结构,再按 query 的证据缺口逐层探索。

2. 总体范式:Knowledge Organization + Navigational Retrieval

输入是文档集合 $D$ 和 query $q$。NaviRAG 把流程拆成两阶段:

H = F_{org}(D)
C = F_{nav}(q,H)

其中:

  • $F_{org}$:离线构建 hierarchical knowledge base $H$。
  • $F_{nav}$:在线执行 query-driven staged evidence acquisition。
  • $C$:最终 multi-granularity context。

最终上下文由三部分组成:

C = C_{vec} \cup C_{sum} \cup C_{raw}
  • $C_{vec}$:初始向量检索得到的 chunks。
  • $C_{sum}$:导航过程中吸收的中间层 summaries。
  • $C_{raw}$:按需展开的底层原文。

答案生成:

y = G(q,C)

3. Offline:构建 Knowledge Tree

每个文档 $D_0$ 先切成 chunks:

S=\{s_1,s_2,\ldots,s_n\}

然后用 LLM-guided organization 构造 Knowledge Tree。节点统一包含:

  • title:语义标识。
  • value:节点内容;中间节点对应 child nodes,叶子节点对应 text segments。
  • summary:支持跨层访问的摘要。

先生成高层 outline:

H_0 = Outline(D_0)

再逐个插入 chunks:

H_i = U(H_{i-1},s_i), \quad i=1,2,\ldots,n

最后做内容融合与自底向上摘要:

H = Refusion(Sum(H_n))

4. Segment Insertion:递归插入、拆分与 regrouping

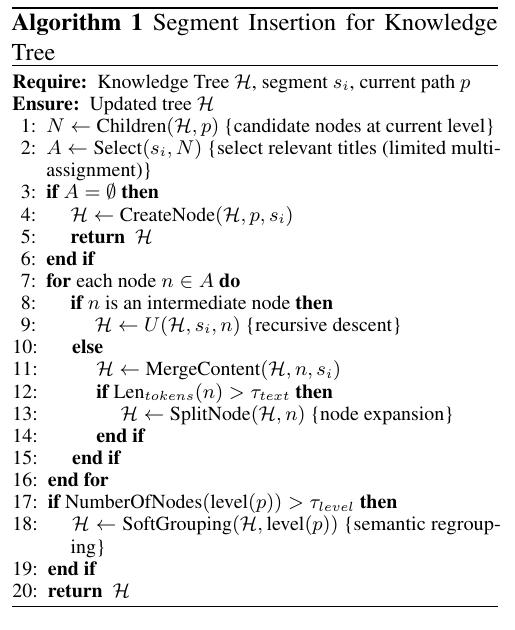
Algorithm 1 的输入是当前 Knowledge Tree $H$、待插入 segment $s_i$ 和当前路径 $p$:

  1. 取当前层候选 children:
N = Children(H,p)
  1. 选择与 segment 相关的标题集合:
A = Select(s_i,N)
  1. 如果没有匹配节点,就创建新节点:
H \leftarrow CreateNode(H,p,s_i)
  1. 如果匹配中间节点,递归下降:
H \leftarrow U(H,s_i,n)
  1. 如果匹配叶子节点,则 merge 内容;若节点过长则 split:
Len_{tokens}(n) > \tau_{text} \Rightarrow SplitNode(H,n)
  1. 如果同层节点数超过阈值,则做 semantic regrouping:
NumberOfNodes(level(p)) > \tau_{level} \Rightarrow SoftGrouping(H,level(p))

这一步的关键不是“抽实体关系”,而是把连续文本组织成可进入、可展开、可摘要的层级树。

5. Online:先定位语义子树,再自顶向下导航

NaviRAG 先对原始 chunk set $S$ 做向量检索:

R = TopK(q,S)

再把 retrieved chunks 映射到 Knowledge Tree 中的对应节点,得到候选语义子树:

H_{sub}

在导航阶段,第 $t$ 层的候选节点为 $N_t$,LLM 选择与 query 相关的子集:

A_t = Select(q,N_t)

对每个被选节点,系统决定:

\pi(n) \in \{absorb, expand\}
  • absorb:吸收当前节点 summary,适合当前层级已经足够表达证据。
  • expand:继续进入 child nodes,适合需要细粒度原文证据。
  • 到达 leaf node 后抽取 raw text。
  • 如果某一层 $A_t=\varnothing$,对应 branch 终止。

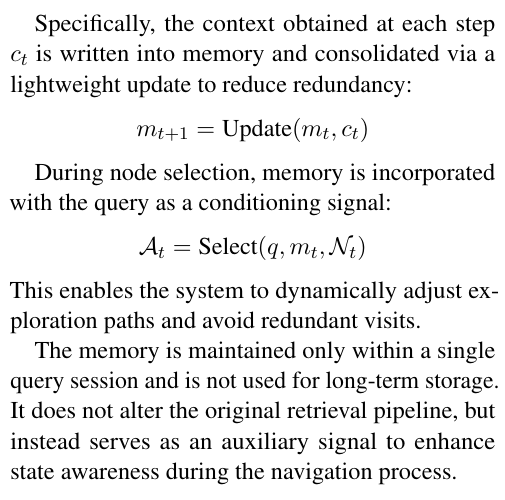
6. Memory-guided Navigation:单 query 内的状态积累

默认 NaviRAG 只由 query 驱动导航。探索性 memory module 维护单轮 query session 内的动态状态 $m_t$:

m_{t+1}=Update(m_t,c_t)

下一步节点选择时,把 memory 和 query 一起作为条件:

A_t=Select(q,m_t,N_t)

注意:这不是长期记忆,不改变原始知识树,也不是全局 planner;它只是在一次检索过程中帮助减少重复访问、保存已经获得的局部证据。

7. 实现设置

  • Knowledge organization model:Qwen2.5-72B。
  • Embedding model:bge-m3。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

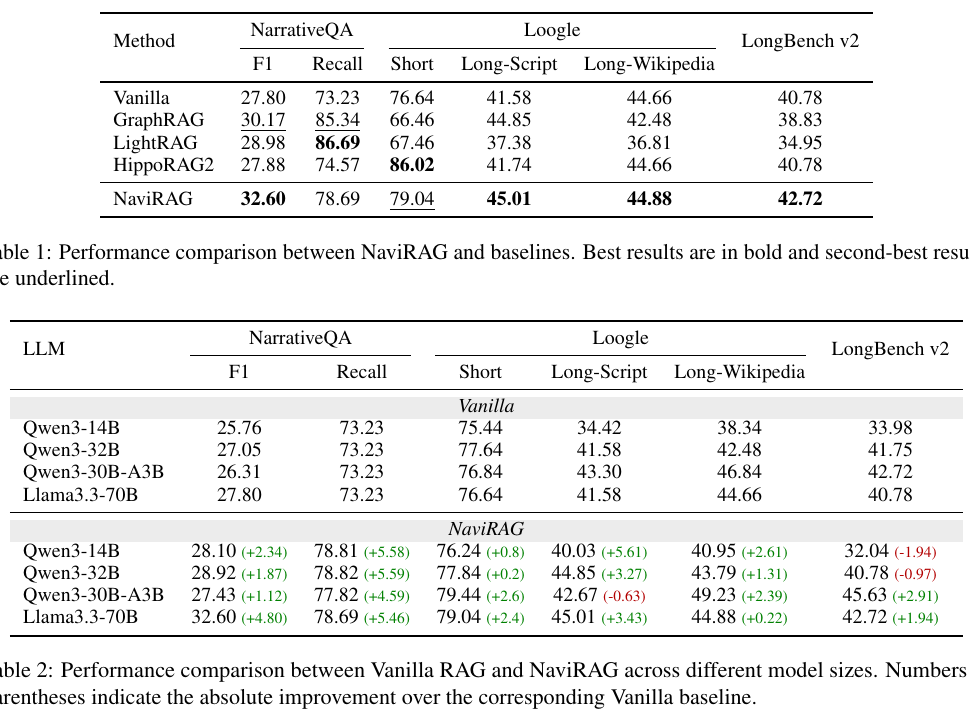
1. 主结果:长依赖任务收益更明显

Table 1 / 2 的核心结论:

  • LLaMA3.3-70B 上,NaviRAG 的 NarrativeQA F1 为 32.60,高于 Vanilla 27.80、GraphRAG 30.17、LightRAG 28.98、HippoRAG2 27.88。
  • NarrativeQA Recall@1 为 78.69,低于 GraphRAG 85.34 和 LightRAG 86.69,但 F1 最高。这说明 NaviRAG 的价值不只是召回更多,而是把更合适的多粒度上下文交给生成器。
  • LooGLE Long-Script 上 NaviRAG 45.01,优于 Vanilla 41.58 和 HippoRAG2 41.74;Long-Wikipedia 44.88 只比 Vanilla / HippoRAG2 44.66 小幅提升。
  • LooGLE-short 上 HippoRAG2 86.02 最强,NaviRAG 79.04。这说明主动导航对“单局部证据即可回答”的任务不是最优。
  • LongBench-v2 上,NaviRAG 在 LLaMA3.3-70B 为 42.72,比 Vanilla 40.78 高 +1.94;但在 Qwen3-14B / Qwen3-32B 上有负增益,提示导航决策依赖模型能力。

2. 消融与效率:结构和导航都不可少

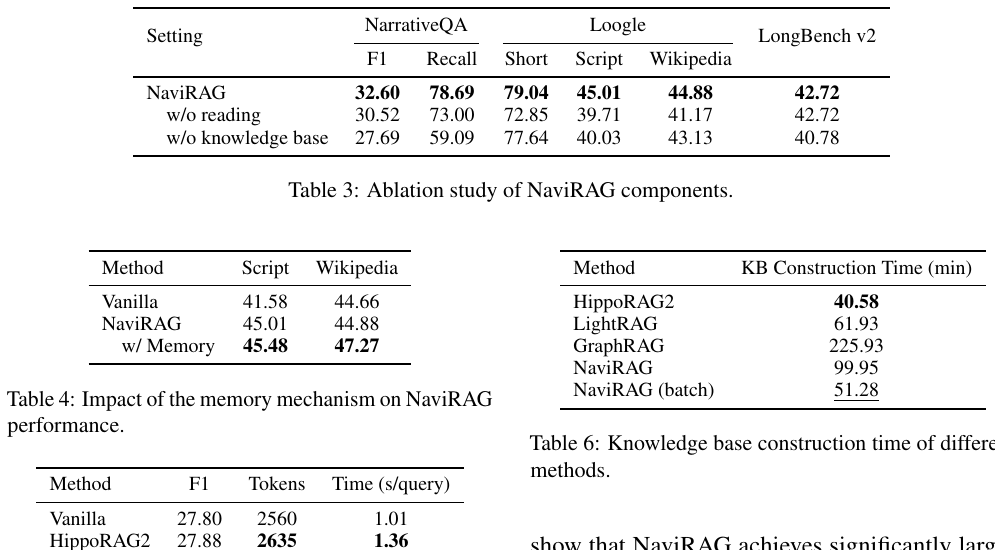
Table 3 说明收益来自“层级结构 + 导航”协同:

  • NaviRAG:NarrativeQA F1 32.60,Recall 78.69。
  • w/o reading:F1 降到 30.52,Recall 降到 73.00;LooGLE Script 从 45.01 降到 39.71。
  • w/o knowledge base:F1 降到 27.69,Recall 降到 59.09。

Table 4 说明 memory module 有边际收益:

  • LooGLE Script:45.01 -> 45.48。
  • LooGLE Wikipedia:44.88 -> 47.27。

Table 5 / 6 给出成本边界:

  • 单 query latency:NaviRAG 3.23s,高于 Vanilla 1.01s 和 HippoRAG2 1.36s,但低于 GraphRAG 14.30s 和 LightRAG 4.27s。
  • context tokens:NaviRAG 3305,远低于 LightRAG 18896 和 GraphRAG 7249。
  • KB construction time:NaviRAG 99.95min,高于 HippoRAG2 40.58 和 LightRAG 61.93,低于 GraphRAG 225.93;batch 版本可降到 51.28min。

解读:NaviRAG 不是最低成本方法,而是在较低 context token 和中等 latency 下换取更好的长依赖回答质量。

3. Case Study:memory 能改善导航路径

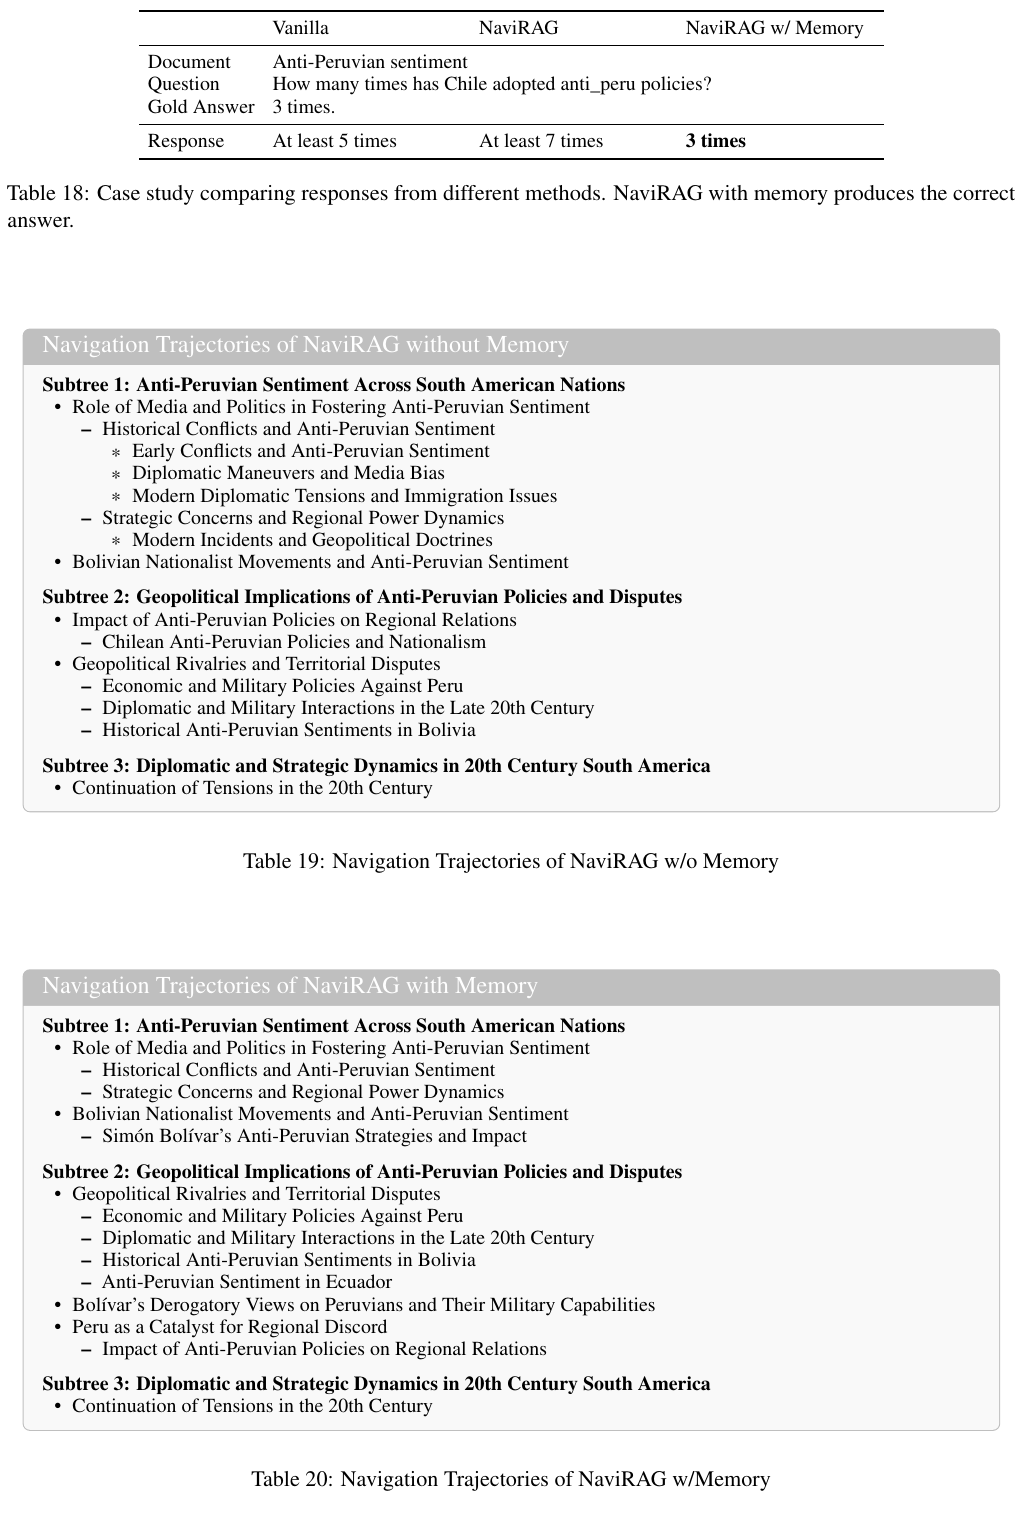
案例问题是 “How many times has Chile adopted anti_peru policies?”:

  • Vanilla 回答至少 5 次。
  • NaviRAG without memory 回答至少 7 次。
  • NaviRAG with memory 回答 3 次,命中 gold answer。

轨迹对比显示,without memory 的路径更分散,容易重复访问泛化区域;with memory 能保留已经访问过的语义状态,并把下一步导航推向更具体的历史政策 / 地缘冲突分支。

4. Top-k 效率:NaviRAG 更会用上下文

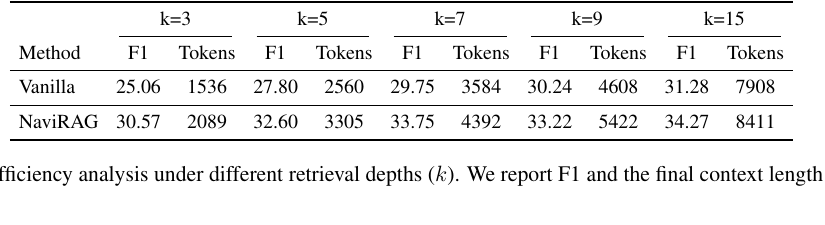
Table 24 显示:

  • Vanilla top-k=15:F1 31.28,tokens 7908。
  • NaviRAG top-k=3:F1 30.57,tokens 2089,已接近 Vanilla top-k=15。
  • NaviRAG top-k=5:F1 32.60,tokens 3305,超过 Vanilla top-k=15。
  • NaviRAG top-k=15:F1 34.27,tokens 8411。

解读:NaviRAG 的优势是 context efficiency。它不是单纯塞更多 chunks,而是利用 hierarchical navigation 让较少 context 包含更有效证据。

局限与开放问题

  • 多源场景未充分覆盖:论文主要评估 single-document QA;作者也指出 future work 应扩展到 multi-source settings。

  • 构建阶段仍依赖强 LLM:Knowledge Tree 的 outline、segment insertion、refusion 和 summarization 使用 Qwen2.5-72B,不是低成本或 extraction-free graph construction。

  • navigation 决策仍是 prompt-driven:Select、absorb / expand、memory update 都依赖 LLM 判断,缺少可学习、可校准的 global policy。

  • memory module 只是 exploratory:只在单 query session 内维护状态,不是长期记忆,也没有显式 goal-oriented retrieval objective。

  • 小模型可能无法稳定受益:LongBench-v2 中 Qwen3-14B 和 Qwen3-32B 相比 Vanilla 出现负增益,说明 navigation 可能增加小模型决策负担。

  • 文本类型偏好明显:Script 这类语义连续文本收益更大;Wikipedia 这种原生 section 结构较强的文本收益较小。

  • 停止准则还不够显式:分支可终止,但没有单独报告 sufficiency stop accuracy、无效 expand rate、branch utility 或 retrieval-turn utility。

  • 作者方向:

    • 扩展到 multi-source settings。
    • 更好利用 native section structures,尤其是 Wikipedia / structured documents。
    • 发展更系统的 memory mechanisms 和 globally guided navigation strategies。
  • Agent 推断的 Research Opportunities:

    • navigation policy learning:把 absorb / expand / stop 做成可训练策略,而不是纯 prompt 决策。
    • sufficiency-aware navigation:记录每层 support gain、branch utility、stop reason,连接 GraphRAG中的停止准则与预算分配形式化。
    • trajectory attribution:把导航树、visited nodes、absorbed summaries、expanded leaves 与 final answer evidence 对齐,连接 OP-10 / OP-18。
    • document-structure routing:对 script、Wikipedia、标准文档、代码库分别选择 tree navigation、native section traversal、parser graph 或 symbolic execution。
    • memory-guided navigation benchmark:比较 no-memory、short-term memory、Error Book、long-term graph memory 在长链任务中的贡献。
    • cost-aware tree construction:研究是否能用 smaller LLM / local LLM / deterministic section parser 降低 Knowledge Tree 构建成本。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略
展开原始论文笔记全文

基本信息

  • 英文标题:NaviRAG: Towards Active Knowledge Navigation for Retrieval-Augmented Generation
  • 中文标题:NaviRAG:面向 RAG 的主动知识导航
  • 方法名:NaviRAG
  • 作者:Jihao Dai, Dingjun Wu, Yuxuan Chen, Zheni Zeng, Yukun Yan, Zhenghao Liu, Maosong Sun
  • 机构:Tsinghua University, Nanjing University, Northeastern University
  • 年份:2026
  • 版本:arXiv v2,2026-05-17;首版 2026-04-14
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:ZzzDJH/NaviRAG,2026-06-09 检查可访问,默认分支 main
  • Semantic Scholar:paperId 4598b6bba31c0ec24aeba88e90103f6f8b7f4192,citationCount=1(2026-06-09 检查)
  • 阅读状态:PDF级
  • 所属方向:Agentic GraphRAG、active knowledge navigation、long-document QA、retrieval planning、multi-granularity retrieval
  • 优先级:P1

Background

  • 研究问题:传统 RAG 通常把 query 映射到固定粒度、相互孤立的 text chunks。复杂长链推理任务需要先定位粗粒度语义区域,再沿着上下文约束逐步找到细粒度证据。
  • 为什么重要:NarrativeQA、LooGLE-long、LongBench-v2 这类长文档 / 长依赖任务中,答案往往不在单个局部 chunk 里,而是需要跨段落、跨语义层级整合证据。
  • 现有路线:
    • Flat vector RAG:简单、快,但 fixed chunking 有粒度冲突。
    • GraphRAG / LightRAG:能建结构,但 global aggregation 成本高,local subgraph 又可能漏掉完整证据。
    • HippoRAG2:强调认知启发的 associative retrieval,但仍不是显式的 coarse-to-fine navigation。
  • 对本知识库的意义:NaviRAG 把 GraphRAG 的“图遍历 / 计划检索 / 停止判断”问题具体化为 knowledge tree 上的 active navigation,可直接连接 GraphRAG作为Query-Planning、GraphRAG中的接口-代理-停止决策闭环 和 OP-10。

Gap

  • Granularity trade-off:细粒度 chunks 精确但缺上下文;粗粒度 chunks 保留上下文但引入噪声、削弱匹配。
  • Single-step retrieval 不够:一次性 top-k 相似检索无法根据已经获得的证据继续决定“停在当前层级”还是“向下展开到更细证据”。
  • 结构化 RAG 成本/覆盖两难:全局图或全局摘要成本高;局部子图检索可能错过跨区域证据。
  • 缺少可操作的 navigation state:很多 agentic RAG 只记录 tool calls 或检索轮数,但没有把知识库组织成可分层进入、可局部展开、可回到原文的结构。
  • 停止与证据充分性仍弱:NaviRAG 有 branch termination,但还没有把 evidence sufficiency / global goal / retrieval budget 学成明确控制策略。

Insight

  • 一句话创新点:NaviRAG 把证据获取从 passive segment retrieval 改写成 active knowledge navigation:先把文档组织成可导航的 hierarchical Knowledge Tree,再让 LLM agent 在 query-time 先定位语义子树、再自顶向下逐步展开证据。
  • 核心洞察:
    • 检索不是一次性定位,而是类似 Information Foraging 的 sequential exploration。
    • 复杂长链推理需要 multi-granularity context:初始相似 chunk、树中间层 summaries、按需展开的 raw text。
    • Hierarchical organization 提供局部语义 scope,navigation mechanism 决定在 scope 内 absorb summary 还是 expand children。
    • Memory-guided navigation 可以在单个 query session 内积累已读信息,减少冗余路径并增强跨区域证据整合,但目前只是 exploratory module。

Method

1. Motivation:从固定 chunks 转向可导航知识空间

NaviRAG-fig1-long-chain-scenarios

Figure 1 对比了两类复杂长链推理:

  • Complex contextual constraints:需要先识别特定 context window,再 zoom in 到细节。
  • Global multi-grained synthesis:需要聚合分散证据,而不是把 oversized chunks 一次性塞给 LLM。

NaviRAG 的回应是:先把文档变成从全局主题到局部细节的可导航结构,再按 query 的证据缺口逐层探索。

2. 总体范式:Knowledge Organization + Navigational Retrieval

NaviRAG-fig2-framework

输入是文档集合 $D$ 和 query $q$。NaviRAG 把流程拆成两阶段:

H = F_{org}(D)
C = F_{nav}(q,H)

其中:

  • $F_{org}$:离线构建 hierarchical knowledge base $H$。
  • $F_{nav}$:在线执行 query-driven staged evidence acquisition。
  • $C$:最终 multi-granularity context。

最终上下文由三部分组成:

C = C_{vec} \cup C_{sum} \cup C_{raw}
  • $C_{vec}$:初始向量检索得到的 chunks。
  • $C_{sum}$:导航过程中吸收的中间层 summaries。
  • $C_{raw}$:按需展开的底层原文。

答案生成:

y = G(q,C)

3. Offline:构建 Knowledge Tree

每个文档 $D_0$ 先切成 chunks:

S=\{s_1,s_2,\ldots,s_n\}

然后用 LLM-guided organization 构造 Knowledge Tree。节点统一包含:

  • title:语义标识。
  • value:节点内容;中间节点对应 child nodes,叶子节点对应 text segments。
  • summary:支持跨层访问的摘要。

先生成高层 outline:

H_0 = Outline(D_0)

再逐个插入 chunks:

H_i = U(H_{i-1},s_i), \quad i=1,2,\ldots,n

最后做内容融合与自底向上摘要:

H = Refusion(Sum(H_n))

4. Segment Insertion:递归插入、拆分与 regrouping

NaviRAG-algorithm1-segment-insertion

Algorithm 1 的输入是当前 Knowledge Tree $H$、待插入 segment $s_i$ 和当前路径 $p$:

  1. 取当前层候选 children:
N = Children(H,p)
  1. 选择与 segment 相关的标题集合:
A = Select(s_i,N)
  1. 如果没有匹配节点,就创建新节点:
H \leftarrow CreateNode(H,p,s_i)
  1. 如果匹配中间节点,递归下降:
H \leftarrow U(H,s_i,n)
  1. 如果匹配叶子节点,则 merge 内容;若节点过长则 split:
Len_{tokens}(n) > \tau_{text} \Rightarrow SplitNode(H,n)
  1. 如果同层节点数超过阈值,则做 semantic regrouping:
NumberOfNodes(level(p)) > \tau_{level} \Rightarrow SoftGrouping(H,level(p))

这一步的关键不是“抽实体关系”,而是把连续文本组织成可进入、可展开、可摘要的层级树。

5. Online:先定位语义子树,再自顶向下导航

NaviRAG 先对原始 chunk set $S$ 做向量检索:

R = TopK(q,S)

再把 retrieved chunks 映射到 Knowledge Tree 中的对应节点,得到候选语义子树:

H_{sub}

在导航阶段,第 $t$ 层的候选节点为 $N_t$,LLM 选择与 query 相关的子集:

A_t = Select(q,N_t)

对每个被选节点,系统决定:

\pi(n) \in \{absorb, expand\}
  • absorb:吸收当前节点 summary,适合当前层级已经足够表达证据。
  • expand:继续进入 child nodes,适合需要细粒度原文证据。
  • 到达 leaf node 后抽取 raw text。
  • 如果某一层 $A_t=\varnothing$,对应 branch 终止。

6. Memory-guided Navigation:单 query 内的状态积累

NaviRAG-memory-guided-navigation-formulas

默认 NaviRAG 只由 query 驱动导航。探索性 memory module 维护单轮 query session 内的动态状态 $m_t$:

m_{t+1}=Update(m_t,c_t)

下一步节点选择时,把 memory 和 query 一起作为条件:

A_t=Select(q,m_t,N_t)

注意:这不是长期记忆,不改变原始知识树,也不是全局 planner;它只是在一次检索过程中帮助减少重复访问、保存已经获得的局部证据。

7. 实现设置

  • Knowledge organization model:Qwen2.5-72B。
  • Embedding model:bge-m3。
  • Downstream generation models:Qwen3-14B、Qwen3-32B、Qwen3-30B-A3B、LLaMA3.3-70B。
  • 默认 retrieval top-k:5。
  • NaviRAG chunk token size:512。
  • overlap rate:0.2。
  • max content length:1536。
  • max titles num:12。
  • max context tokens:8192。

Results

1. 主结果:长依赖任务收益更明显

NaviRAG-table1-table2-main-results

Table 1 / 2 的核心结论:

  • LLaMA3.3-70B 上,NaviRAG 的 NarrativeQA F1 为 32.60,高于 Vanilla 27.80、GraphRAG 30.17、LightRAG 28.98、HippoRAG2 27.88。
  • NarrativeQA Recall@1 为 78.69,低于 GraphRAG 85.34 和 LightRAG 86.69,但 F1 最高。这说明 NaviRAG 的价值不只是召回更多,而是把更合适的多粒度上下文交给生成器。
  • LooGLE Long-Script 上 NaviRAG 45.01,优于 Vanilla 41.58 和 HippoRAG2 41.74;Long-Wikipedia 44.88 只比 Vanilla / HippoRAG2 44.66 小幅提升。
  • LooGLE-short 上 HippoRAG2 86.02 最强,NaviRAG 79.04。这说明主动导航对“单局部证据即可回答”的任务不是最优。
  • LongBench-v2 上,NaviRAG 在 LLaMA3.3-70B 为 42.72,比 Vanilla 40.78 高 +1.94;但在 Qwen3-14B / Qwen3-32B 上有负增益,提示导航决策依赖模型能力。

2. 消融与效率:结构和导航都不可少

NaviRAG-table3-6-ablation-efficiency

Table 3 说明收益来自“层级结构 + 导航”协同:

  • NaviRAG:NarrativeQA F1 32.60,Recall 78.69。
  • w/o reading:F1 降到 30.52,Recall 降到 73.00;LooGLE Script 从 45.01 降到 39.71。
  • w/o knowledge base:F1 降到 27.69,Recall 降到 59.09。

Table 4 说明 memory module 有边际收益:

  • LooGLE Script:45.01 -> 45.48。
  • LooGLE Wikipedia:44.88 -> 47.27。

Table 5 / 6 给出成本边界:

  • 单 query latency:NaviRAG 3.23s,高于 Vanilla 1.01s 和 HippoRAG2 1.36s,但低于 GraphRAG 14.30s 和 LightRAG 4.27s。
  • context tokens:NaviRAG 3305,远低于 LightRAG 18896 和 GraphRAG 7249。
  • KB construction time:NaviRAG 99.95min,高于 HippoRAG2 40.58 和 LightRAG 61.93,低于 GraphRAG 225.93;batch 版本可降到 51.28min。

解读:NaviRAG 不是最低成本方法,而是在较低 context token 和中等 latency 下换取更好的长依赖回答质量。

3. Case Study:memory 能改善导航路径

NaviRAG-table18-20-memory-case-navigation

案例问题是 “How many times has Chile adopted anti_peru policies?”:

  • Vanilla 回答至少 5 次。
  • NaviRAG without memory 回答至少 7 次。
  • NaviRAG with memory 回答 3 次,命中 gold answer。

轨迹对比显示,without memory 的路径更分散,容易重复访问泛化区域;with memory 能保留已经访问过的语义状态,并把下一步导航推向更具体的历史政策 / 地缘冲突分支。

4. Top-k 效率:NaviRAG 更会用上下文

NaviRAG-table24-topk-efficiency

Table 24 显示:

  • Vanilla top-k=15:F1 31.28,tokens 7908。
  • NaviRAG top-k=3:F1 30.57,tokens 2089,已接近 Vanilla top-k=15。
  • NaviRAG top-k=5:F1 32.60,tokens 3305,超过 Vanilla top-k=15。
  • NaviRAG top-k=15:F1 34.27,tokens 8411。

解读:NaviRAG 的优势是 context efficiency。它不是单纯塞更多 chunks,而是利用 hierarchical navigation 让较少 context 包含更有效证据。

Limitations

  • 多源场景未充分覆盖:论文主要评估 single-document QA;作者也指出 future work 应扩展到 multi-source settings。
  • 构建阶段仍依赖强 LLM:Knowledge Tree 的 outline、segment insertion、refusion 和 summarization 使用 Qwen2.5-72B,不是低成本或 extraction-free graph construction。
  • navigation 决策仍是 prompt-driven:Select、absorb / expand、memory update 都依赖 LLM 判断,缺少可学习、可校准的 global policy。
  • memory module 只是 exploratory:只在单 query session 内维护状态,不是长期记忆,也没有显式 goal-oriented retrieval objective。
  • 小模型可能无法稳定受益:LongBench-v2 中 Qwen3-14B 和 Qwen3-32B 相比 Vanilla 出现负增益,说明 navigation 可能增加小模型决策负担。
  • 文本类型偏好明显:Script 这类语义连续文本收益更大;Wikipedia 这种原生 section 结构较强的文本收益较小。
  • 停止准则还不够显式:分支可终止,但没有单独报告 sufficiency stop accuracy、无效 expand rate、branch utility 或 retrieval-turn utility。

Future Directions

  • 作者方向:
    • 扩展到 multi-source settings。
    • 更好利用 native section structures,尤其是 Wikipedia / structured documents。
    • 发展更系统的 memory mechanisms 和 globally guided navigation strategies。
  • Agent 推断的 Research Opportunities:
    • navigation policy learning:把 absorb / expand / stop 做成可训练策略,而不是纯 prompt 决策。
    • sufficiency-aware navigation:记录每层 support gain、branch utility、stop reason,连接 GraphRAG中的停止准则与预算分配形式化。
    • trajectory attribution:把导航树、visited nodes、absorbed summaries、expanded leaves 与 final answer evidence 对齐,连接 OP-10 / OP-18。
    • document-structure routing:对 script、Wikipedia、标准文档、代码库分别选择 tree navigation、native section traversal、parser graph 或 symbolic execution。
    • memory-guided navigation benchmark:比较 no-memory、short-term memory、Error Book、long-term graph memory 在长链任务中的贡献。
    • cost-aware tree construction:研究是否能用 smaller LLM / local LLM / deterministic section parser 降低 Knowledge Tree 构建成本。

与本知识库的连接

一句话定位

NaviRAG 是把长文档 RAG 从“一次性 top-k chunk 检索”推进到“先建 Knowledge Tree、再按 query 主动导航语义子树”的 agentic retrieval planning 方法,最适合分析长依赖、多粒度证据和导航式停止决策。