GGraphRAG 文献图谱自动同步
LIT-AB0C8F2D · 2026

CacheRAG - Semantic Caching for KGQA

CacheRAG 把 KGQA planner 从 stateless prompt 变成带语义计划缓存的 continual learner,用 ISR 解耦用户语言和物理 schema,用 Domain -> Aspect + MMR 取多样历史计划,再用有界图算子补全不足证据。

PDF 级阅读卡优先级 P1Yushi Sun, Lei ChenarXiv 2026;PDF 模板仍保留 ACM 占位会议和 DOI 信息,正式发表状态待复查
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

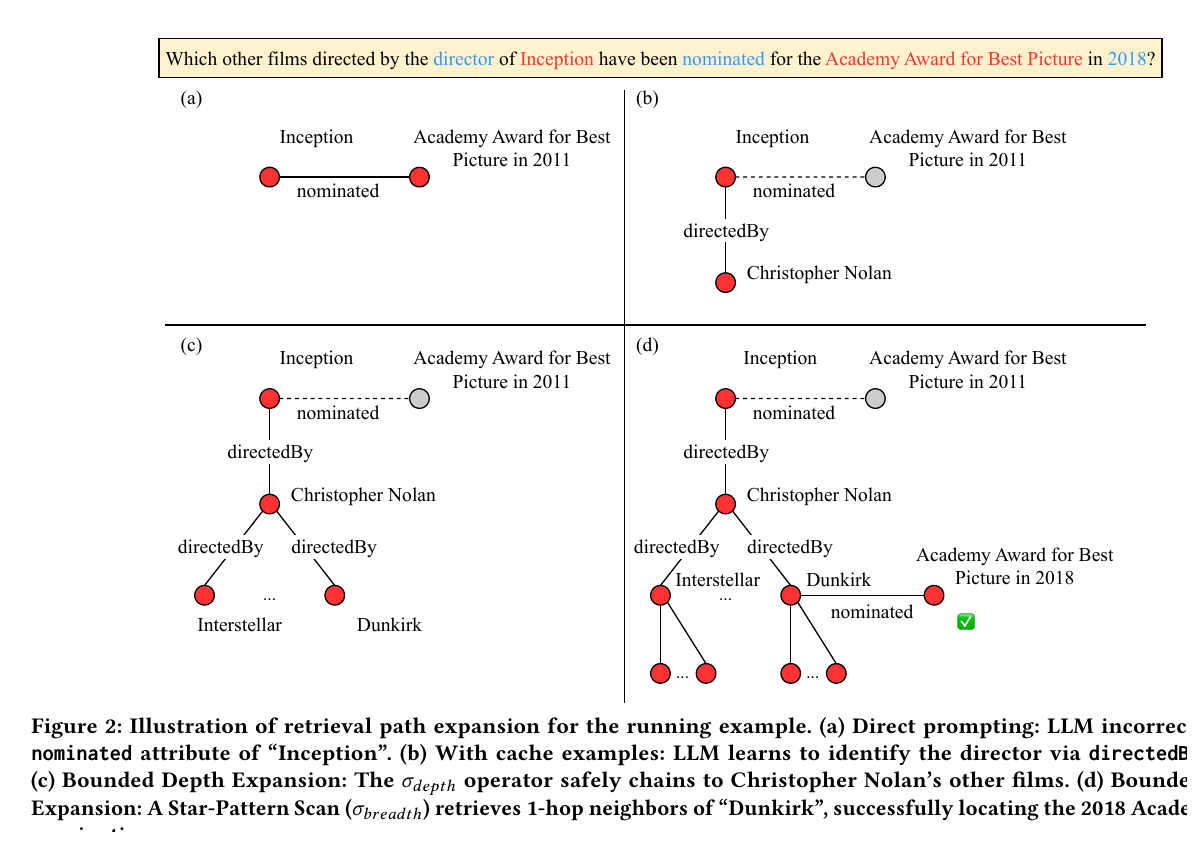
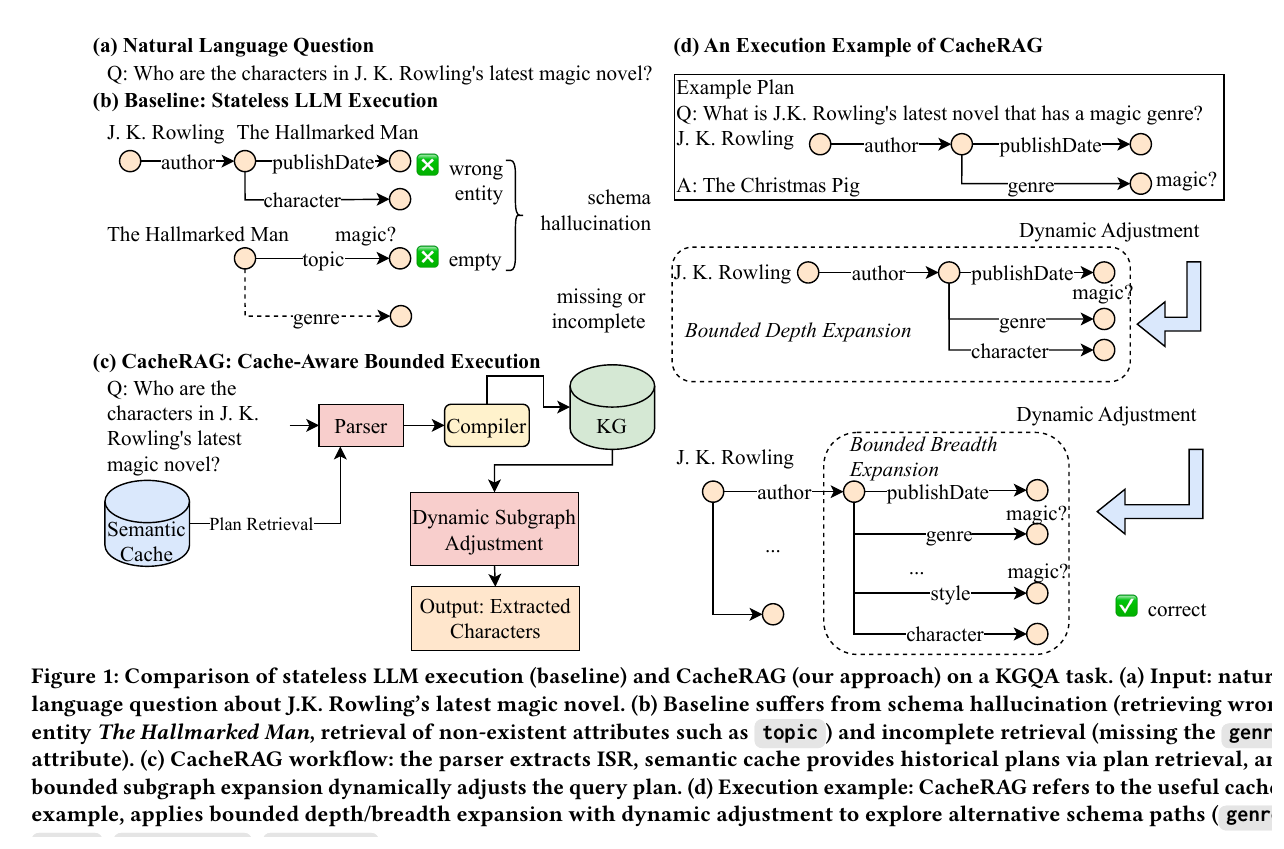
Figure 1 的关键对比是:baseline 在每次问题上重新猜 schema,可能取错实体、访问不存在属性或停在不完整子图;CacheRAG 先从语义缓存取历史计划,再用 bounded depth / breadth expansion 修正执行路径。

  • Stateless planning:LLM 每次独立生成 query plan,不能从历史成功计划中学习 reusable schema path。
  • Schema hallucination:直接让 LLM 输出 KG predicate / API call 容易生成图中不存在的属性或 relation。
  • Cache retrieval redundancy:如果只按语义相似取 top-k,容易拿到一组结构相同的历史问题,浪费 prompt context,不能覆盖多种 query topology。
  • Incomplete retrieval:初始 query plan 可能只拿到局部子图,缺少多跳链路或关键 1-hop 邻域。
  • Cold-start:语义缓存一开始为空或很稀疏,系统需要在 cache miss 时仍能退化运行并把新成功计划写回缓存。
  • 部署边界:论文展示了 CRAG / QALD / WebQSP / CWQ 结果,但正式代码、完整人工评测、动态 KG description 的定量图表仍需复查。

方法与机制

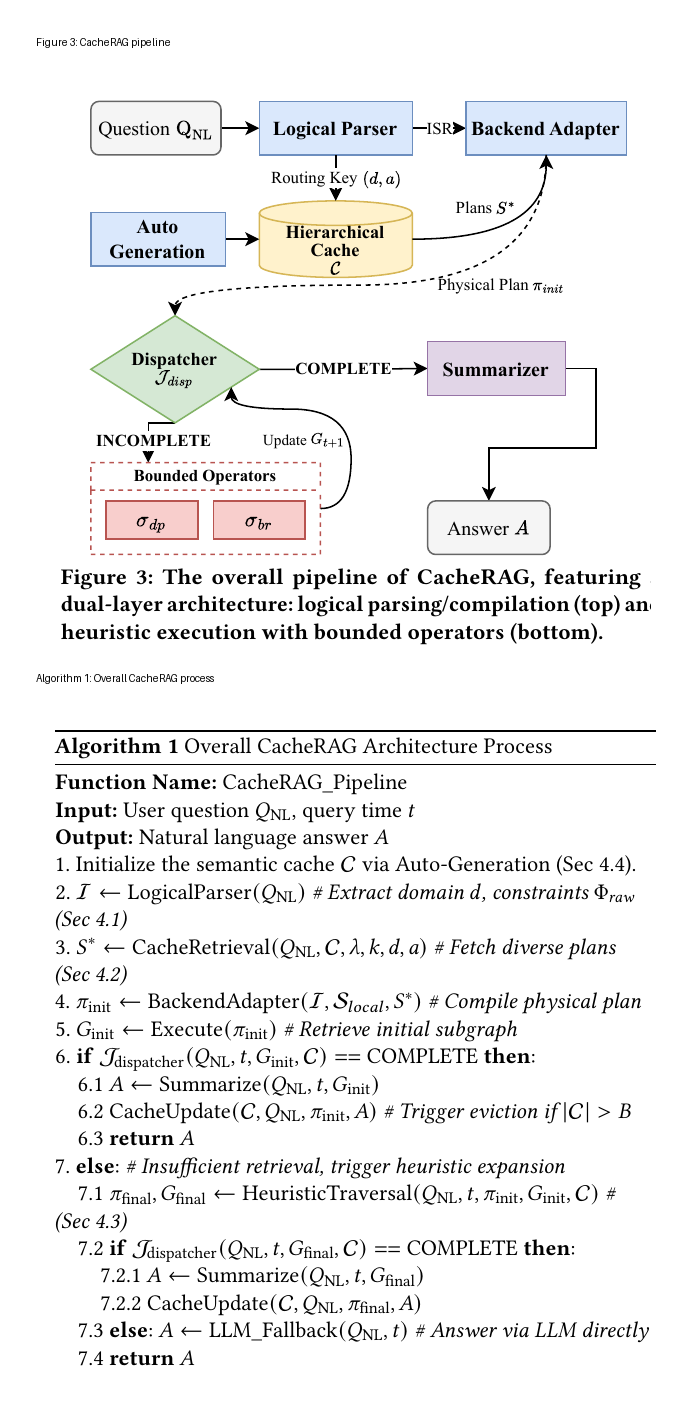
1. 总体框架:Logical Parsing -> Cache Retrieval -> Physical Compilation -> Bounded Execution

输入:自然语言问题 $Q_{NL}$、查询时间 $t$、知识图谱 $K$、本地 schema $S$、语义缓存 $C$。

计算链路:

  1. Auto-Generation 预热缓存,得到一批可执行历史计划。
  2. Logical Parser 把问题转成 schema-agnostic ISR:
I=(e_{raw}, \Phi_{raw}, d)

其中 $e_{raw}$ 是原始主题实体,$\Phi_{raw}$ 是自然语言约束集合,$d$ 是 domain hint。

  1. Cache Retrieval 用 $(d,a)$ 定位缓存桶,并取多样历史计划 $S^*$。
  2. Backend Adapter 读取 topic entity 周围的本地物理 schema $S_{local}$,把 $\Phi_{raw}$ 映射为合法 predicate / API / SPARQL,形成初始计划:
\pi_{init}=\langle op_1,op_2,\ldots,op_m\rangle,\quad op_i\in\{\text{SPARQL},\text{API call}\}
  1. 执行 $\pi_{init}$ 得到初始子图 $G_{init}$。
  2. Dispatcher 判断 $G_{init}$ 是否足够回答问题;若不足,触发有界 depth / breadth expansion。
  3. Summarizer 基于最终子图生成答案,并把成功轨迹写回缓存。

输出:自然语言答案 $A$、最终物理计划 $\pi_{final}$、最终证据子图 $G_{final}$、更新后的缓存 $C$。

直观解释:CacheRAG 把 KGQA 拆成“逻辑计划”和“物理执行”两层。LLM 不再直接猜 KG predicate,而是在本地合法 schema 和历史计划的约束下编译查询。

2. Semantic Cache:缓存的是可复用计划,而不是只缓存回答

输入:历史问题、已执行 query plan、已验证答案。

计算链路:

  1. 每条缓存项定义为:
C=\{(Q_i,\pi_i,A_i)\}_{i=1}^{N}

其中 $Q_i\in NL$,$\pi_i$ 是 query plan,$A_i$ 是 verified answer。

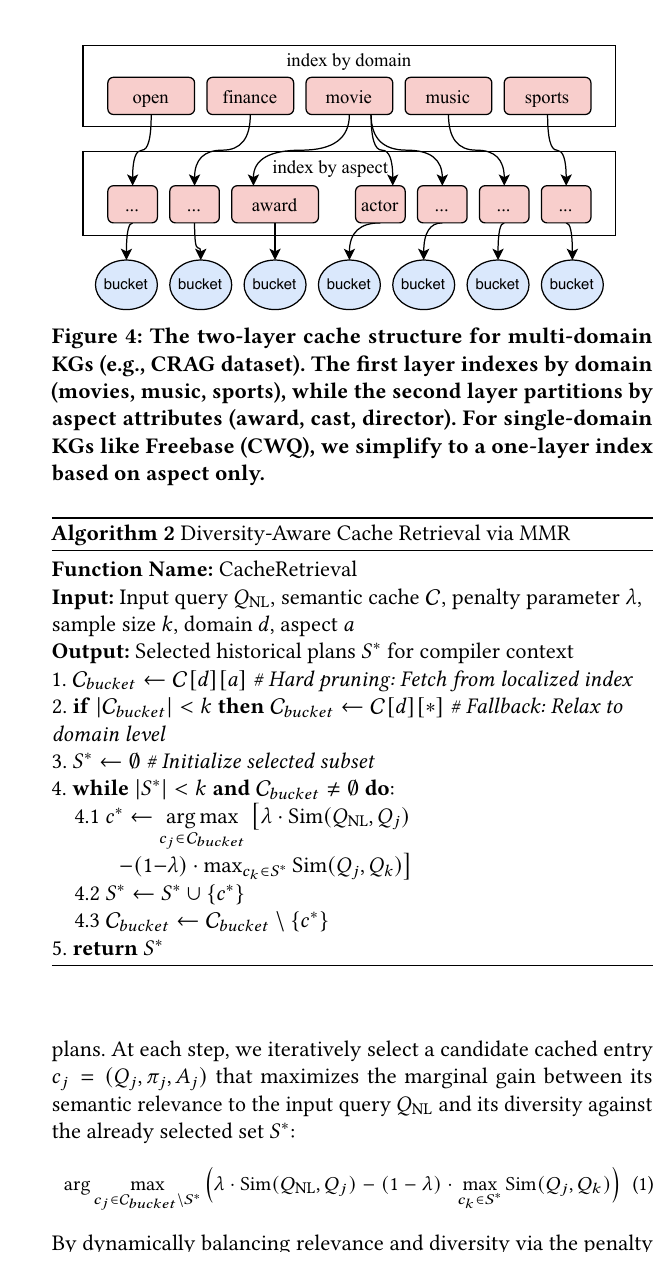
  1. 每条缓存项按 domain $d$ 和 aspect $a$ 建二级索引:
C[d][a]
  1. 对多 domain KG,第一层按 domain 分桶,如 open / finance / movie / music / sports;第二层按 query aspect 分桶,如 award / actor / director。
  2. 对单 domain KG,退化成只按 aspect 的一层索引。

输出:可被 ISR routing key 快速定位的 plan memory。

直观解释:这一步把“历史 QA 经验”变成 planner 的可检索外部记忆。它不是 answer memoization,因为新问题可以复用旧计划结构但生成不同答案。

3. Diversity-Aware Cache Retrieval:Domain -> Aspect 硬剪枝 + MMR 软多样化

输入:当前问题 $Q_{NL}$、缓存 $C$、domain $d$、aspect $a$、样本数 $k$、权衡参数 $\lambda$。

计算链路:

  1. 先用 ISR routing key 取本地缓存桶:
C_{bucket}\leftarrow C[d][a]
  1. 若桶内样本不足,则退化到 domain-level:
C_{bucket}\leftarrow C[d][*]
  1. 在桶内用 MMR 逐个选择历史计划:
c^*=\arg\max_{c_j\in C_{bucket}\setminus S^*} \lambda \cdot Sim(Q_{NL},Q_j) -(1-\lambda)\cdot \max_{c_k\in S^*}Sim(Q_j,Q_k)
  1. 默认设置:$\lambda=0.5$,$k=5$,相似度 $Sim(\cdot)$ 用 BM25。

输出:结构上更互补的历史计划集合 $S^*$。

直观解释:Domain -> Aspect 负责把搜索空间从全局缓存缩到局部桶,MMR 负责避免取到 5 个几乎一样的示例。论文报告去掉 MMR 后 CRAG truthfulness 从 0.711 降到 0.682。

4. Two-Stage Compilation:先抽 ISR,再编译到合法物理 schema

输入:ISR $I=(e_{raw},\Phi_{raw},d)$、本地 schema $S_{local}$、历史计划 $S^*$。

计算链路:

  1. Logical Parser 只抽自然语言实体和约束,不允许生成 KG-specific predicate。
  2. Backend Adapter 针对 $e_{raw}$ 拉取合法本地 schema:
S_{local}=\{p\mid p\text{ is valid around }e_{raw}\}
  1. Query Compiler 接收 $\Phi_{raw}$、$S_{local}$ 和 $S^*$,将自然语言约束 grounding 到合法 predicate / API / SPARQL。
  2. 若无法映射,则转入 breadth expansion 查找可能的多跳 schema path。

输出:可执行物理查询计划 $\pi_{init}$。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

CRAG 主结果

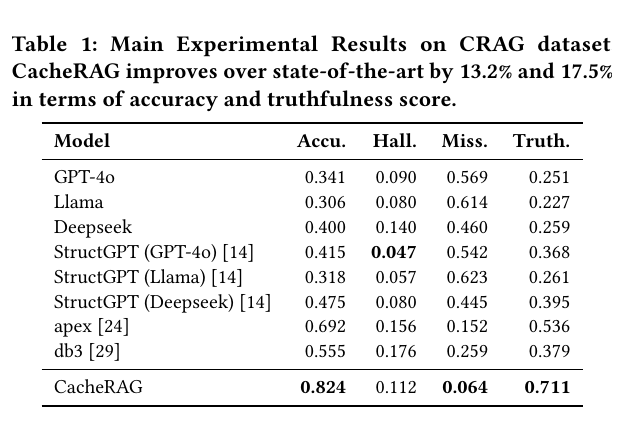
  • CRAG 上 CacheRAG 的 Accu / Hall / Miss / Truth 为 0.824 / 0.112 / 0.064 / 0.711。
  • 相比 SOTA,论文报告 accuracy 提升 13.2%,truthfulness 提升 17.5%。
  • Retrieval recall 从 0.756 提升到 0.927,说明主要收益来自更完整的 KG evidence coverage。
  • 代价是 hallucination 指标不总是最低:CacheRAG 的 Hall 0.112 高于 StructGPT(GPT-4o) 的 0.047。论文解释为召回更多长尾多跳上下文后,final summarizer 面对更复杂 synthesis。

泛化、消融和 backbone 鲁棒性

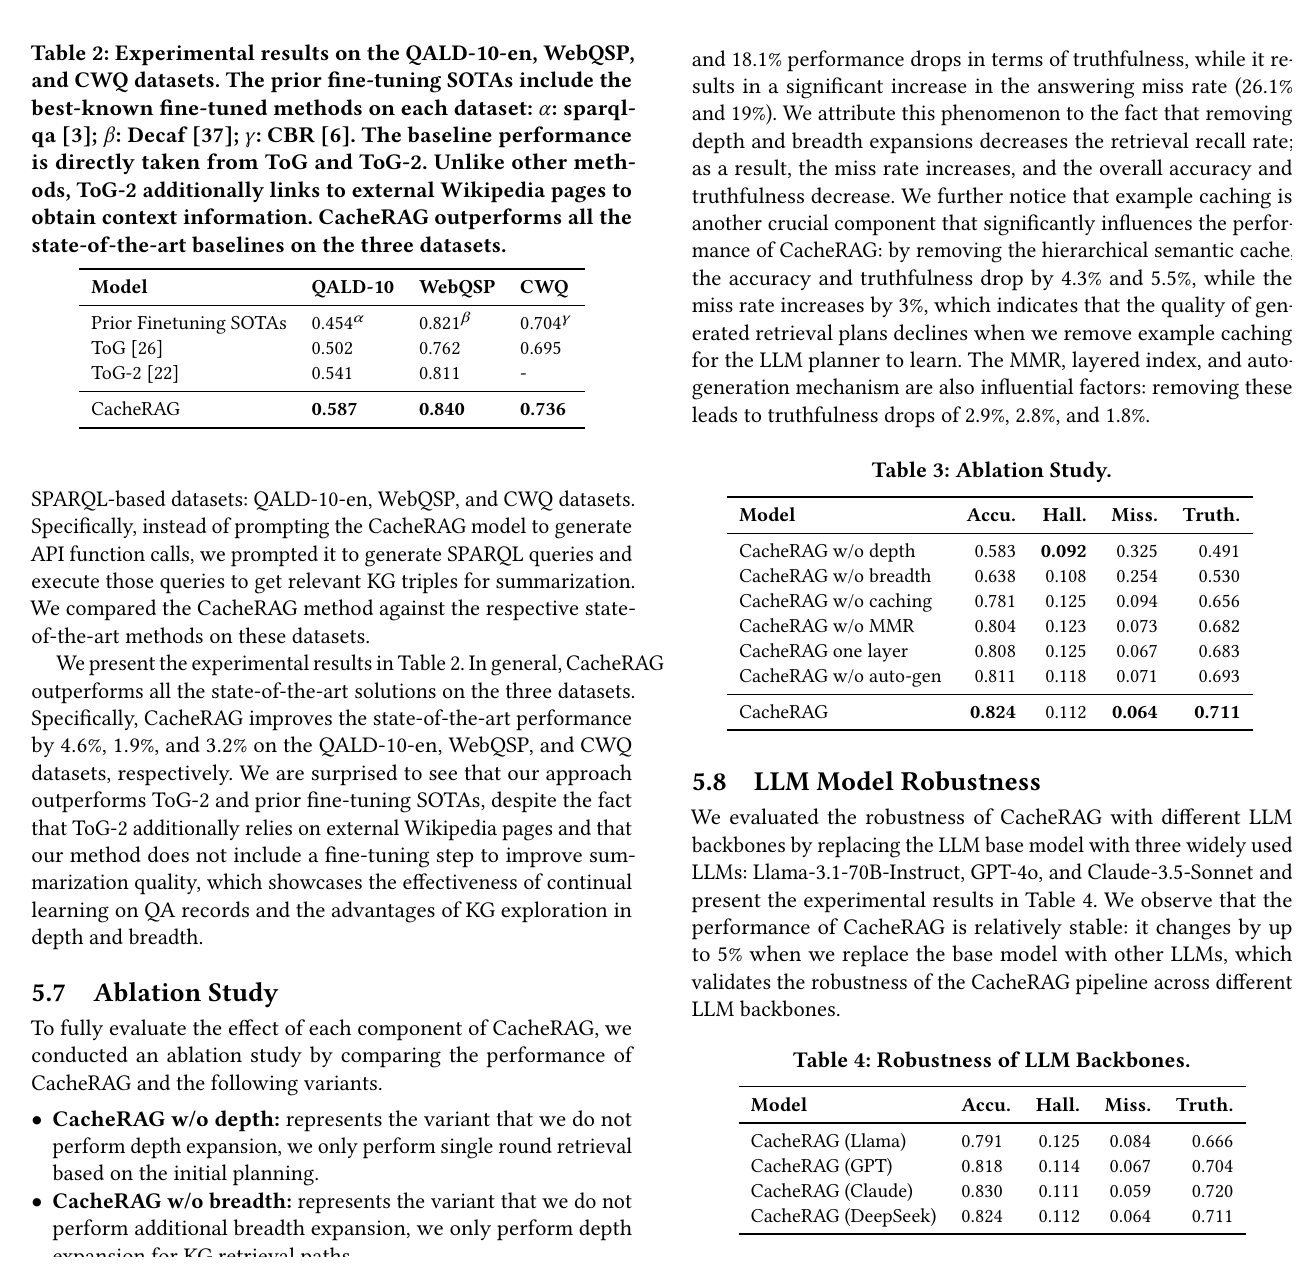
  • QALD-10 / WebQSP / CWQ 上 CacheRAG 分别达到 0.587 / 0.840 / 0.736,高于 ToG / ToG-2 或 prior fine-tuning SOTA。
  • 消融显示 depth / breadth expansion 是最大收益来源:去掉 depth 后 Accu 降到 0.583,去掉 breadth 后降到 0.638。
  • 去掉 semantic caching 后 Accu / Truth 为 0.781 / 0.656,说明 plan memory 对质量有实质贡献。
  • 去掉 MMR 后 Truth 为 0.682;one-layer cache 为 0.683,说明多样化检索和二级索引都有贡献。
  • Backbone 替换下结果相对稳定:Llama / GPT / Claude / DeepSeek 的 Accu 在 0.791 到 0.830 之间。

效率、扩展性和 LRU cache

  • CRAG 平均 inference time 为 9.44s,Apex 为 5.96s;CacheRAG 用额外 depth / breadth expansion 换准确率和 miss rate。
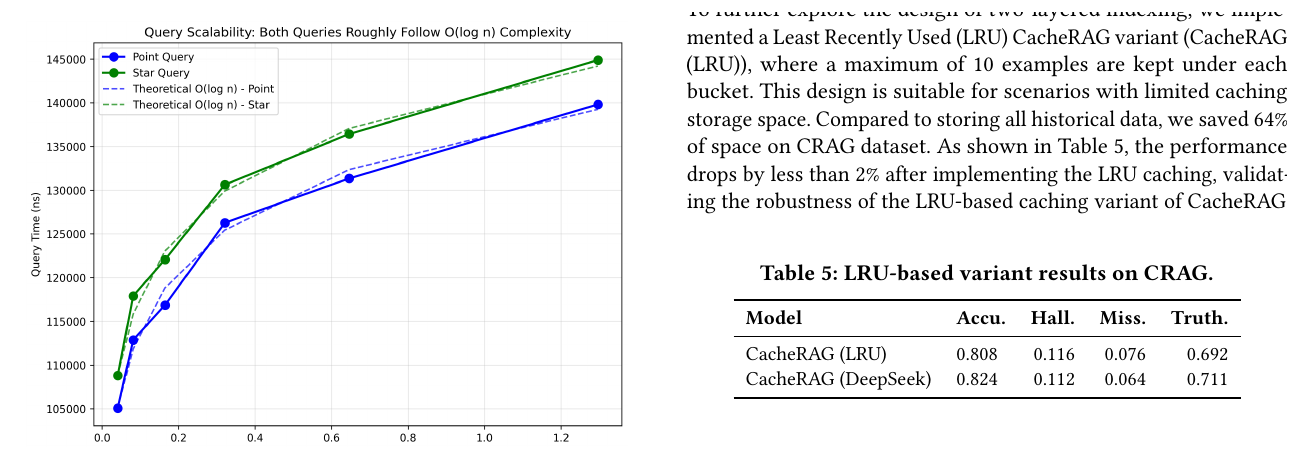
  • 论文的合成 KG 实验显示 point query 和 star query 随 triple 数从 40K 到 1.28M 增长时呈近似 logarithmic growth。
  • LRU variant 在每个 bucket 保留最多 10 个 examples,节省 64% storage,Accu / Truth 从 0.824 / 0.711 降到 0.808 / 0.692,性能下降小于 2%。

局限与开放问题

  • 代码暂未找到,复现实验、prompt、cache construction 和 evaluator 细节仍需二次确认。

  • PDF 模板存在会议和 DOI 占位信息,正式发表状态不清晰。

  • Semantic Scholar 本轮查询遇到 429,citation、venue、external metadata 需要后续补查。

  • Auto-generation 依赖 LLM 生成和过滤训练样例,可能把错误 plan 写入缓存;论文没有充分展开错误缓存的清洗机制。

  • CacheRAG 主要验证 KGQA 和 SPARQL-based QA,对开放域文本 GraphRAG、文档级 GraphRAG、multi-modal GraphRAG 的泛化仍未知。

  • Hallucination 指标并非最低,说明检索覆盖提高后,summarizer 的 answer synthesis / evidence selection 仍是风险点。

  • Dynamic KG description cache 的附录定量结果有 Figure ?? 占位,当前只能把它视为思路,不应当作强证据。

  • 缓存命中和 cache bucket 质量没有细粒度报告,例如 cache-hit type、retrieved-plan utility、plan reuse precision、cache poisoning 或 stale plan 风险。

  • Plan-cache routing:把 query complexity router 从“选 GraphRAG / LLM”扩展到“是否需要历史 plan cache、取多少 plans、是否需要 MMR 多样化”。

  • Cache attribution:记录每个 retrieved cached plan 是否实际改变 Backend Adapter 的 predicate choice、join path 或 fallback decision。

  • Error-aware cache update:加入 verified evidence、execution trace、answer verifier 和 rollback,避免错误计划进入长期缓存。

  • Hybrid interface router:把 CacheRAG 的 ISR + Backend Adapter 扩展成 semantic retrieval / lexical logical retrieval / SPARQL execution / API call / graph traversal 的统一路由器。

  • Post-retrieval reasoning:在 evidence 已召回但 summarizer 出错的样本上,加入 structured prompt、SPARQL CoT 或 answer verifier。

  • Cache + RL:把 cache hit、plan reuse、support gain、retrieval cost 和 final correctness 变成过程奖励,连接 Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning 和 GraphRAG-R1 - Process-Constrained Reinforcement Learning for GraphRAG。

  • Cache robustness:评估 stale cache、wrong plan cache、schema update、cache poisoning、domain misrouting 对 KGQA 的影响。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略
展开原始论文笔记全文

基本信息

  • 英文标题:CacheRAG: A Semantic Caching System for Retrieval-Augmented Generation in Knowledge Graph Question Answering
  • 中文标题:CacheRAG:面向知识图谱问答的语义缓存式 RAG 系统
  • 方法名:CacheRAG
  • 作者:Yushi Sun, Lei Chen
  • 机构:HKUST, HKUST(GZ) / HKUST
  • 年份:2026
  • 会议:arXiv 2026;PDF 模板仍保留 ACM 占位会议和 DOI 信息,正式发表状态待复查
  • 版本:arXiv v4,2026-06-08 更新;初版 2026-04-28
  • 链接:arXiv
  • DOI:待复查
  • PDF:查看论文原文
  • 代码:2026-06-09 GitHub 标题检索未发现公开仓库,待复查
  • Semantic Scholar:2026-06-09 直接查询 arXiv ID 多次遇到 429,待复查
  • 阅读状态:PDF级
  • 所属方向:KGQA semantic caching、retrieval-plan reuse、schema-constrained planning、bounded graph expansion、GraphRAG interface routing
  • 优先级:P1

Background

CacheRAG-fig1-stateless-vs-cache

Figure 1 的关键对比是:baseline 在每次问题上重新猜 schema,可能取错实体、访问不存在属性或停在不完整子图;CacheRAG 先从语义缓存取历史计划,再用 bounded depth / breadth expansion 修正执行路径。

Gap

  • Stateless planning:LLM 每次独立生成 query plan,不能从历史成功计划中学习 reusable schema path。
  • Schema hallucination:直接让 LLM 输出 KG predicate / API call 容易生成图中不存在的属性或 relation。
  • Cache retrieval redundancy:如果只按语义相似取 top-k,容易拿到一组结构相同的历史问题,浪费 prompt context,不能覆盖多种 query topology。
  • Incomplete retrieval:初始 query plan 可能只拿到局部子图,缺少多跳链路或关键 1-hop 邻域。
  • Cold-start:语义缓存一开始为空或很稀疏,系统需要在 cache miss 时仍能退化运行并把新成功计划写回缓存。
  • 部署边界:论文展示了 CRAG / QALD / WebQSP / CWQ 结果,但正式代码、完整人工评测、动态 KG description 的定量图表仍需复查。

Insight

  • 一句话创新点:CacheRAG 把 KGQA planner 从 stateless prompt 变成带语义计划缓存的 continual learner,用 ISR 解耦用户语言和物理 schema,用 Domain -> Aspect + MMR 取多样历史计划,再用有界图算子补全不足证据。
  • 核心洞察:
    • 用户接口应该 schema-agnostic:LLM 先抽自然语言实体和约束,不直接写 predicate。
    • 计划缓存比普通答案缓存更有价值:缓存的是 question -> query plan -> verified answer,可教会 planner 复用 query topology。
    • cache retrieval 不能只看相似度,还要看结构多样性,否则 in-context examples 会重复。
    • 图扩展应有硬边界:用 depth / breadth operators 代替无限 LLM exploration,可以把召回提升和成本上界同时写清楚。
    • 多 KG / 多 domain 场景下,domain routing 和 aspect routing 本身就是检索计划的一部分。

Method

1. 总体框架:Logical Parsing -> Cache Retrieval -> Physical Compilation -> Bounded Execution

CacheRAG-fig3-pipeline-algorithm1

输入:自然语言问题 $Q_{NL}$、查询时间 $t$、知识图谱 $K$、本地 schema $S$、语义缓存 $C$。

计算链路:

  1. Auto-Generation 预热缓存,得到一批可执行历史计划。
  2. Logical Parser 把问题转成 schema-agnostic ISR:
I=(e_{raw}, \Phi_{raw}, d)

其中 $e_{raw}$ 是原始主题实体,$\Phi_{raw}$ 是自然语言约束集合,$d$ 是 domain hint。

  1. Cache Retrieval 用 $(d,a)$ 定位缓存桶,并取多样历史计划 $S^*$。
  2. Backend Adapter 读取 topic entity 周围的本地物理 schema $S_{local}$,把 $\Phi_{raw}$ 映射为合法 predicate / API / SPARQL,形成初始计划:
\pi_{init}=\langle op_1,op_2,\ldots,op_m\rangle,\quad op_i\in\{\text{SPARQL},\text{API call}\}
  1. 执行 $\pi_{init}$ 得到初始子图 $G_{init}$。
  2. Dispatcher 判断 $G_{init}$ 是否足够回答问题;若不足,触发有界 depth / breadth expansion。
  3. Summarizer 基于最终子图生成答案,并把成功轨迹写回缓存。

输出:自然语言答案 $A$、最终物理计划 $\pi_{final}$、最终证据子图 $G_{final}$、更新后的缓存 $C$。

直观解释:CacheRAG 把 KGQA 拆成“逻辑计划”和“物理执行”两层。LLM 不再直接猜 KG predicate,而是在本地合法 schema 和历史计划的约束下编译查询。

2. Semantic Cache:缓存的是可复用计划,而不是只缓存回答

输入:历史问题、已执行 query plan、已验证答案。

计算链路:

  1. 每条缓存项定义为:
C=\{(Q_i,\pi_i,A_i)\}_{i=1}^{N}

其中 $Q_i\in NL$,$\pi_i$ 是 query plan,$A_i$ 是 verified answer。

  1. 每条缓存项按 domain $d$ 和 aspect $a$ 建二级索引:
C[d][a]
  1. 对多 domain KG,第一层按 domain 分桶,如 open / finance / movie / music / sports;第二层按 query aspect 分桶,如 award / actor / director。
  2. 对单 domain KG,退化成只按 aspect 的一层索引。

输出:可被 ISR routing key 快速定位的 plan memory。

直观解释:这一步把“历史 QA 经验”变成 planner 的可检索外部记忆。它不是 answer memoization,因为新问题可以复用旧计划结构但生成不同答案。

3. Diversity-Aware Cache Retrieval:Domain -> Aspect 硬剪枝 + MMR 软多样化

CacheRAG-fig4-cache-structure-algorithm2-mmr

输入:当前问题 $Q_{NL}$、缓存 $C$、domain $d$、aspect $a$、样本数 $k$、权衡参数 $\lambda$。

计算链路:

  1. 先用 ISR routing key 取本地缓存桶:
C_{bucket}\leftarrow C[d][a]
  1. 若桶内样本不足,则退化到 domain-level:
C_{bucket}\leftarrow C[d][*]
  1. 在桶内用 MMR 逐个选择历史计划:
c^*=\arg\max_{c_j\in C_{bucket}\setminus S^*} \lambda \cdot Sim(Q_{NL},Q_j) -(1-\lambda)\cdot \max_{c_k\in S^*}Sim(Q_j,Q_k)
  1. 默认设置:$\lambda=0.5$,$k=5$,相似度 $Sim(\cdot)$ 用 BM25。

输出:结构上更互补的历史计划集合 $S^*$。

直观解释:Domain -> Aspect 负责把搜索空间从全局缓存缩到局部桶,MMR 负责避免取到 5 个几乎一样的示例。论文报告去掉 MMR 后 CRAG truthfulness 从 0.711 降到 0.682。

4. Two-Stage Compilation:先抽 ISR,再编译到合法物理 schema

输入:ISR $I=(e_{raw},\Phi_{raw},d)$、本地 schema $S_{local}$、历史计划 $S^*$。

计算链路:

  1. Logical Parser 只抽自然语言实体和约束,不允许生成 KG-specific predicate。
  2. Backend Adapter 针对 $e_{raw}$ 拉取合法本地 schema:
S_{local}=\{p\mid p\text{ is valid around }e_{raw}\}
  1. Query Compiler 接收 $\Phi_{raw}$、$S_{local}$ 和 $S^*$,将自然语言约束 grounding 到合法 predicate / API / SPARQL。
  2. 若无法映射,则转入 breadth expansion 查找可能的多跳 schema path。

输出:可执行物理查询计划 $\pi_{init}$。

直观解释:这一步把 schema hallucination 限制在编译阶段。论文在 CRAG 上报告 entity extraction accuracy 为 98%,physical compilation executable rate 为 98.9%。

5. Bounded Subgraph Operators:用有界算子补全初始检索不足

CacheRAG-fig2-path-expansion

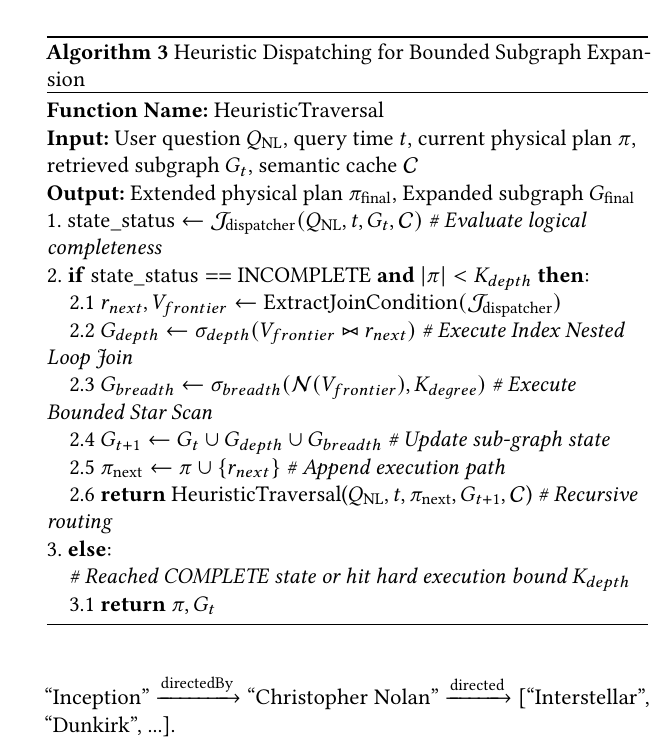
CacheRAG-algorithm3-bounded-expansion

输入:用户问题 $Q_{NL}$、当前物理计划 $\pi$、当前子图 $G_t$、缓存 $C$。

计算链路:

  1. Dispatcher 判断当前子图是否 complete:
J_{dispatcher}(Q_{NL},t,G_t,C)\in\{\text{COMPLETE},\text{INCOMPLETE}\}
  1. 若 incomplete 且 $|\pi|<K_{depth}$,提取下一跳 join condition $(r_{next},V_{frontier})$。
  2. Depth expansion 执行 Graph-based Index Nested Loop Join:
G_{depth}\leftarrow \sigma_{depth}(V_{frontier}\bowtie r_{next})

复杂度:

O(K_{depth}\log n),\quad K_{depth}\le 3
  1. Breadth expansion 执行 bounded star scan:
G_{breadth}\leftarrow \sigma_{breadth}(N(V_{frontier}),K_{degree})

空间上界:

O(K_{depth}\cdot K_{degree})

论文默认 $K_{degree}=30$。

  1. 合并新证据:
G_{t+1}=G_t\cup G_{depth}\cup G_{breadth}
  1. 递归判断直到 complete 或达到硬边界。

输出:扩展后的 $\pi_{final}$ 和 $G_{final}$。

直观解释:Depth expansion 负责沿明确 relation 继续多跳链路,breadth expansion 负责在 bottleneck entity 周围补 1-hop 邻域,避免只沿单一路径漏掉答案。

6. Auto-Generation and Cache Update:冷启动时先造基本经验,再在线补充

输入:KG 中采样实体、1-hop star schema、LLM 生成的问题模板。

计算链路:

  1. 从 KG 中采样实体和局部 star schema。
  2. LLM 基于 triples 生成简单和复杂问题。
  3. LLM 过滤不合逻辑或不可回答的样本。
  4. 编译并执行问题,形成 $(Q_{NL},\pi,A)$。
  5. 成功样本写入缓存;严重 cache miss 时系统退化到 zero-shot + bounded expansion,成功后再写回缓存。

输出:冷启动可用的初始 semantic cache,以及随交互增长的 plan memory。

直观解释:CacheRAG 的 continual learning 不更新模型权重,而是更新 plan cache。这样更容易部署到新 KG,但缓存质量、eviction 策略和错误写入控制会成为长期风险。

7. Complexity and Deployment Bounds

输入:缓存桶大小 $b$、KG triple 数 $n$、depth bound $K_{depth}$、breadth bound $K_{degree}$、LLM latency $L$。

计算链路:

  1. Cache routing 是字典查找,近似 $O(1)$。
  2. MMR 在局部桶中运行:
O(b\log b)
  1. Depth expansion:
O(K_{depth}\log n)
  1. Breadth expansion:
O(K_{depth}\cdot K_{degree})
  1. LLM 调用由 parser、adapter、dispatcher loop 和 summarizer 组成:
O(L\cdot K_{depth})
  1. 总在线复杂度写为:
O(b\log b+K_{depth}\log n+K_{depth}K_{degree}+L K_{depth})

若 $b,K_{depth},K_{degree},L$ 作为系统常数,随 KG 规模主要呈 $O(\log n)$ 增长。

输出:可解释的成本上界和部署参数。

直观解释:CacheRAG 的强项不是最短 latency,而是在更高召回和更低 miss rate 下仍给出硬边界。它把“多探索一点”转成可配置的 depth / degree / cache bucket。

Results

CRAG 主结果

CacheRAG-table1-main-crag

  • CRAG 上 CacheRAG 的 Accu / Hall / Miss / Truth 为 0.824 / 0.112 / 0.064 / 0.711。
  • 相比 SOTA,论文报告 accuracy 提升 13.2%,truthfulness 提升 17.5%。
  • Retrieval recall 从 0.756 提升到 0.927,说明主要收益来自更完整的 KG evidence coverage。
  • 代价是 hallucination 指标不总是最低:CacheRAG 的 Hall 0.112 高于 StructGPT(GPT-4o) 的 0.047。论文解释为召回更多长尾多跳上下文后,final summarizer 面对更复杂 synthesis。

泛化、消融和 backbone 鲁棒性

CacheRAG-table2-table3-table4-results

  • QALD-10 / WebQSP / CWQ 上 CacheRAG 分别达到 0.587 / 0.840 / 0.736,高于 ToG / ToG-2 或 prior fine-tuning SOTA。
  • 消融显示 depth / breadth expansion 是最大收益来源:去掉 depth 后 Accu 降到 0.583,去掉 breadth 后降到 0.638。
  • 去掉 semantic caching 后 Accu / Truth 为 0.781 / 0.656,说明 plan memory 对质量有实质贡献。
  • 去掉 MMR 后 Truth 为 0.682;one-layer cache 为 0.683,说明多样化检索和二级索引都有贡献。
  • Backbone 替换下结果相对稳定:Llama / GPT / Claude / DeepSeek 的 Accu 在 0.791 到 0.830 之间。

效率、扩展性和 LRU cache

CacheRAG-efficiency-scalability-lru

  • CRAG 平均 inference time 为 9.44s,Apex 为 5.96s;CacheRAG 用额外 depth / breadth expansion 换准确率和 miss rate。
  • 论文的合成 KG 实验显示 point query 和 star query 随 triple 数从 40K 到 1.28M 增长时呈近似 logarithmic growth。
  • LRU variant 在每个 bucket 保留最多 10 个 examples,节省 64% storage,Accu / Truth 从 0.824 / 0.711 降到 0.808 / 0.692,性能下降小于 2%。

Limitations

  • 代码暂未找到,复现实验、prompt、cache construction 和 evaluator 细节仍需二次确认。
  • PDF 模板存在会议和 DOI 占位信息,正式发表状态不清晰。
  • Semantic Scholar 本轮查询遇到 429,citation、venue、external metadata 需要后续补查。
  • Auto-generation 依赖 LLM 生成和过滤训练样例,可能把错误 plan 写入缓存;论文没有充分展开错误缓存的清洗机制。
  • CacheRAG 主要验证 KGQA 和 SPARQL-based QA,对开放域文本 GraphRAG、文档级 GraphRAG、multi-modal GraphRAG 的泛化仍未知。
  • Hallucination 指标并非最低,说明检索覆盖提高后,summarizer 的 answer synthesis / evidence selection 仍是风险点。
  • Dynamic KG description cache 的附录定量结果有 Figure ?? 占位,当前只能把它视为思路,不应当作强证据。
  • 缓存命中和 cache bucket 质量没有细粒度报告,例如 cache-hit type、retrieved-plan utility、plan reuse precision、cache poisoning 或 stale plan 风险。

Future Directions

  • Plan-cache routing:把 query complexity router 从“选 GraphRAG / LLM”扩展到“是否需要历史 plan cache、取多少 plans、是否需要 MMR 多样化”。
  • Cache attribution:记录每个 retrieved cached plan 是否实际改变 Backend Adapter 的 predicate choice、join path 或 fallback decision。
  • Error-aware cache update:加入 verified evidence、execution trace、answer verifier 和 rollback,避免错误计划进入长期缓存。
  • Hybrid interface router:把 CacheRAG 的 ISR + Backend Adapter 扩展成 semantic retrieval / lexical logical retrieval / SPARQL execution / API call / graph traversal 的统一路由器。
  • Post-retrieval reasoning:在 evidence 已召回但 summarizer 出错的样本上,加入 structured prompt、SPARQL CoT 或 answer verifier。
  • Cache + RL:把 cache hit、plan reuse、support gain、retrieval cost 和 final correctness 变成过程奖励,连接 Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning 和 GraphRAG-R1 - Process-Constrained Reinforcement Learning for GraphRAG。
  • Cache robustness:评估 stale cache、wrong plan cache、schema update、cache poisoning、domain misrouting 对 KGQA 的影响。

与本知识库的连接

一句话定位

CacheRAG 把 KGQA 的历史成功查询计划做成可检索、可多样化、可持续更新的 semantic cache,并用 ISR + Backend Adapter + bounded graph expansion 把 LLM planner 约束成可执行的 schema-aware GraphRAG 系统。