研究问题与动机
-
研究问题:RL-based Agentic GraphRAG 让 LLM 在多轮推理中调用图检索工具,但现有方法常把检索看成语义相似度匹配,把训练奖励看成最终答案是否正确,难以学习“哪一步检索真正推动了多跳推理”。
-
为什么重要:多跳 QA 的失败经常不是缺少语义相关文本,而是证据链不连贯、检索跳到孤立事实、或中间检索虽然看似相关但没有把推理推进到答案。GraphRAG 的训练信号需要同时看结构连通性和中间进展。
-
现有路线:
- Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning 把 GraphRAG 变成可 RL 训练的多轮图检索 agent,但检索仍偏语义相似度。
- GraphRAG-R1 - Process-Constrained Reinforcement Learning for GraphRAG 用 PRA / CAF 控制检索次数和成本,但过程奖励更关注调用行为与最终 F1。
- PRoH - Dynamic Planning over Knowledge Hypergraphs 把知识超图用于动态 DAG 规划和路径检索,但不以 stepwise RL policy optimization 为核心。
-
对本知识库的意义:HyperGraphPro 把 OP-10 的 “planning-guided traversal attribution” 和 OP-9 的 “evidence subgraph/path optimization” 合并到训练信号里:它不仅问“检索几次”,还问“当前 hyperedge 是否结构上接续前一步,并是否让答案概率上升”。
-
Semantic-only retrieval 不够:只按 query / hyperedge embedding 相似度检索,容易选到语义相关但结构上不接续的事实。
-
Outcome-level reward 太稀疏:最终答案正确性不能告诉模型哪一个中间 query、哪条 hyperedge 或哪一步 graph context 对成功有贡献。
-
Credit assignment 不细:多轮轨迹中早期检索决定后续是否可行,但标准 GRPO 对整条输出使用同一个 trajectory-level advantage,容易强化偶然成功的噪声路径。
-
Graph structure 没进入 dense reward:现有过程奖励常约束格式、检索次数或答案 F1,较少直接奖励“当前检索是否沿着知识图谱连通链推进”。
方法与机制
1. 总体框架:Hypergraph construction -> structure-guided retrieval -> stepwise RL
输入:问题 $x$、知识语料 $\mathcal{K}={d_1,\ldots,d_N}$、由语料抽取的知识超图 $G_K=(V,E)$、策略模型 $\pi_\theta$、参考模型 $\pi_{ref}$。
计算链路:
- Hypergraph construction:用 LLM extractor 把文档片段转成 hyperedge 与实体集合:
其中 $e_i$ 是一个 hyperedge,$V_{e_i}={v_1,\ldots,v_n}$ 是参与该 n-ary fact 的实体。
- Multi-turn agent:LLM 在第 $t$ 步生成检索 query $q_t$,调用 hypergraph retriever 得到事实集合 $F_t^{ret}$,再继续推理。
- Structure-guided retrieval:retriever 结合实体语义相关性和 query-conditioned structural distinctiveness 重排 hyperedges。
- Step progress-aware policy optimization:训练时把每一步的答案概率增量、结构连通性和答案实体命中作为 step-level reward,调制 GRPO advantage。
输出:一个能在知识超图上多轮检索、减少结构漂移并生成答案的 GraphRAG agent。
直观解释:HyperGraphPro 的核心不是“多一个超图索引”,而是让检索排序和 RL 奖励都看见图结构。
2. Structure-guided hypergraph retrieval:语义相关 + 结构区分度
输入:第 $t$ 步 query $q_t$、query 中识别出的实体集合 $V(q_t)$、知识超图 $G_K=(V,E)$、embedding function $\phi(\cdot)$。
计算链路:
- Entity-query semantic relevance:先计算 query entity 聚合向量:
然后计算实体 $v$ 与当前 query entity set 的语义相似度:
- Query-conditioned distinctiveness:先找和当前 query entity 相邻的 hyperedges:
再计算实体 $v$ 在 query-neighborhood 中的相对区分度:
直观解释:如果一个实体在全图里到处出现,它即使语义相似也不一定有判别力;如果它集中出现在当前 query 附近的 hyperedges 中,就更可能推动当前多跳检索。
- Hyperedge re-scoring:对候选 hyperedge $e$ 内实体的语义相关性做归一化:
结合结构区分度得到实体贡献:
再汇总为 hyperedge score:
- Top-k retrieval:
输出:既语义相关、又在 hypergraph 上更有结构判别力的 retrieved facts。
3. Step progress-aware reward:奖励推理进度,而不是只奖励最终答案
输入:第 $t$ 步之前的状态 $s_{<t}$、第 $t$ 步后状态 $s_{\le t}$、之前检索到的图上下文 $G_{<t}$、当前检索后上下文 $G_{\le t}$、gold answer $y^*$。
计算链路:
- Step progress reward:看当前 step 是否提升了到达 gold answer 的概率:
论文用 sampling 多个输出并平均 outcome reward 来估计这个概率变化。
- Connectivity reward:看当前 retrieved hyperedge $G_t$ 是否和之前 reasoning state 共享实体:
- Answer reachness reward:看当前 retrieved hyperedge 是否包含答案实体:
原始笔记摘录已截断;请打开来源笔记阅读完整内容。
证据与结果
1. 主结果:HyperGraphPro 超过 Graph-R1 和 Search-R1
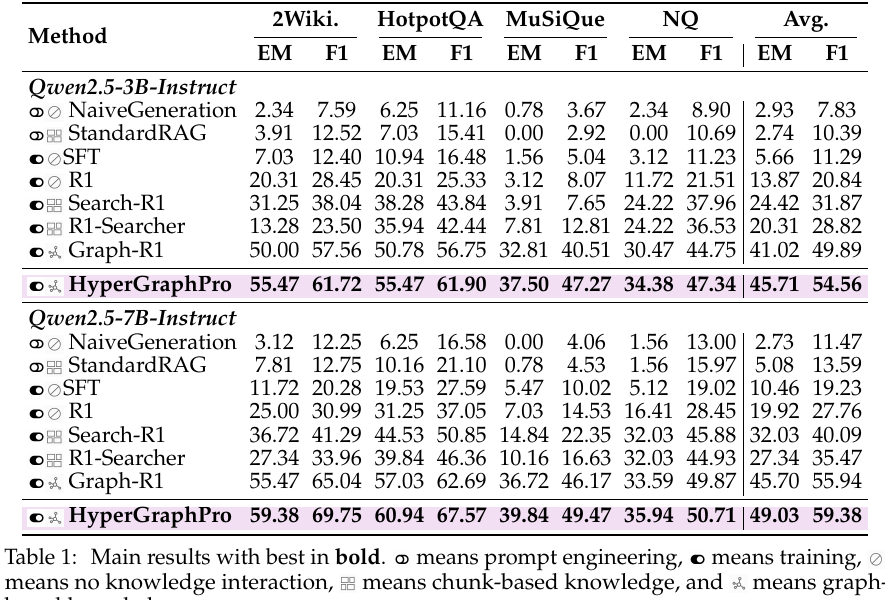
Table 1 显示,在 Qwen2.5-3B 上,HyperGraphPro 平均 F1 为 54.56,高于 Graph-R1 的 49.89;在 Qwen2.5-7B 上,平均 F1 为 59.38,高于 Graph-R1 的 55.94。提升主要来自 2Wiki、HotpotQA、MuSiQue 这类多跳任务,NQ 单跳任务提升较小,说明方法主要解决多步结构推理。
2. 小模型和消融:结构检索与 progress-aware PO 都有贡献
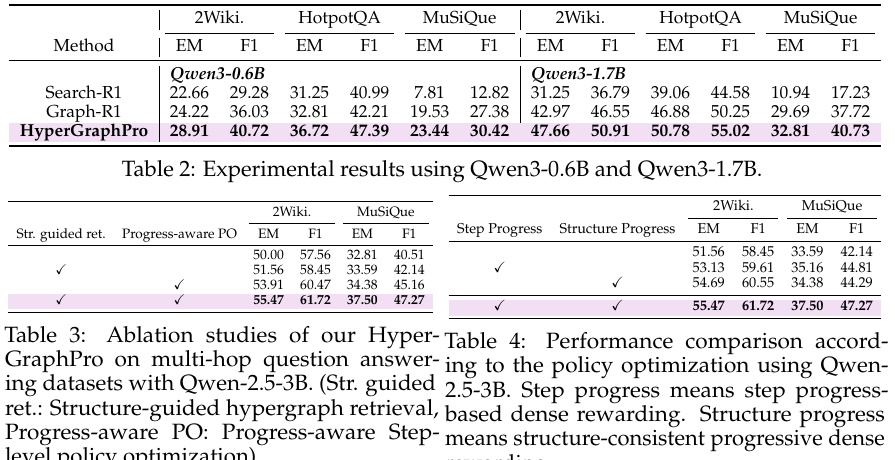
Table 2 说明在 Qwen3-0.6B 和 Qwen3-1.7B 上,HyperGraphPro 仍优于 Search-R1 和 Graph-R1,说明不是只对 Qwen2.5 特定模型有效。Table 3 显示 structure-guided retrieval 和 progress-aware policy optimization 单独打开都有提升,合并后最好;Table 4 进一步说明 step progress 和 structure progress 是互补信号。
3. 检索与效率:结构信号提高 F1,同时减少 reasoning turns
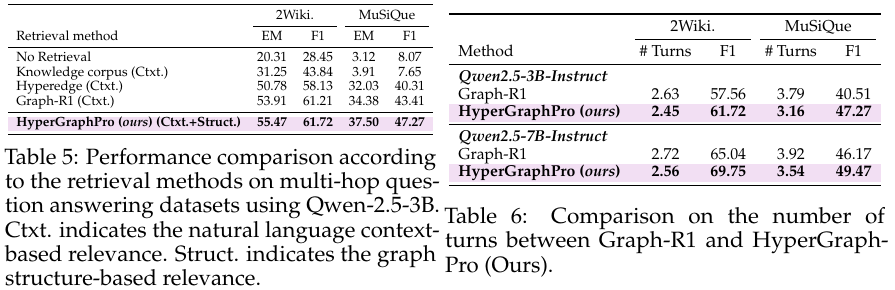
Table 5 对比不同 retrieval strategy:只用 knowledge corpus / hyperedge context 不如 Graph-R1,而 HyperGraphPro 的 context + structure 组合在 2Wiki 和 MuSiQue 上最高。Table 6 显示 HyperGraphPro 没有直接把 turn count 作为 reward,却比 Graph-R1 用更少 turns 得到更高 F1;这说明结构检索和 step reward 减少了无效绕路。
4. Case study:减少 redundant / conflicting reasoning
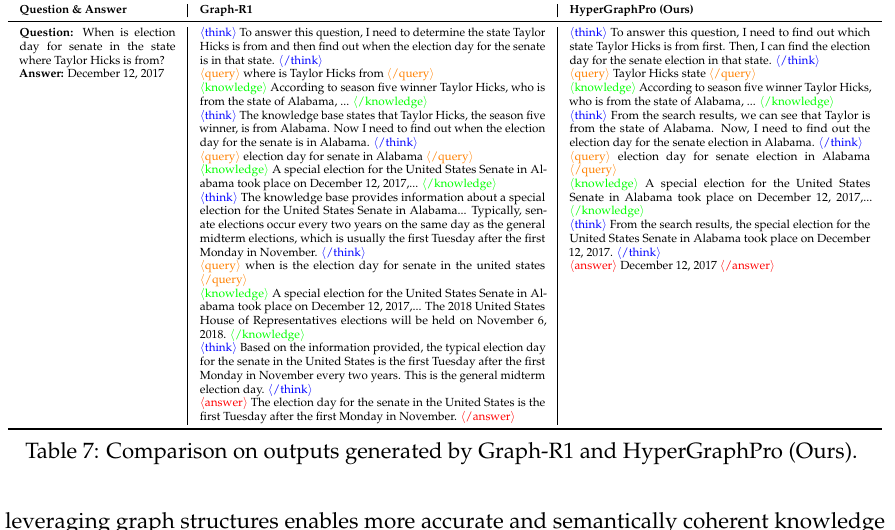
Table 7 的例子中,Graph-R1 已经检索到 Alabama special election 的正确信息,但后续又泛化到美国参议院常规选举日,最终答错。HyperGraphPro 在确认 Taylor Hicks 来自 Alabama 后直接使用 special election 证据回答 2017-12-12,说明它改善的不只是 retrieval recall,也包括后检索 reasoning drift。
局限与开放问题
-
缺少代码和可复现实验细节:论文未直接给出官方代码链接,当前只能从 PDF 判断算法和结果,复现实验需要后续查仓库或作者页面。
-
Reward 依赖 gold answer/entity:$r_t^{sp}$、$r_t^{ans}$ 在训练中需要 gold answer 或 outcome reward;开放域、弱监督或无标准答案任务中如何构造 progress signal 仍不清楚。
-
图构建仍依赖 LLM extractor:论文关注 retrieval 和 RL policy,hypergraph extraction 的质量、成本和噪声传播没有成为主实验变量。
-
结构奖励可能偏向实体重叠:$r_t^{con}$ 和 $r_t^{ans}$ 用 entity overlap 衡量结构进展,未充分处理 relation semantics、时间约束、qualifier 或 n-ary fact 内角色差异。
-
数据集仍以 QA 为主:2Wiki、HotpotQA、MuSiQue、NQ 能验证多跳 QA,但还不能证明在企业文档、工程图纸、标准文档、代码库等结构化场景中的稳定性。
-
没有细粒度失败归因表:论文展示了主结果、消融和一个案例,但没有系统统计失败来自 anchor miss、hyperedge miss、progress reward 误判、结构断链还是 final synthesis。
-
与 GraphRAG-R1 / PRoH 对照:把 PRA / CAF、PRoH EWO、HyperGraphPro step reward 放在同一环境下比较,区分“检索次数控制”“超图路径规划”“结构进度奖励”的真实贡献。
-
Progress reward without gold answer:研究弱监督或 verifier-based progress signal,用 entailment、evidence sufficiency、answer verifier 或 citation gain 替代 gold answer entity overlap。
-
Structure-aware retrieval diagnostics:记录每一步的 query entity、candidate hyperedges、$I_t(v)$、$R_t(e)$、$r_t^{con}$、$r_t^{ans}$ 和最终使用证据,形成 OP-10 的 trajectory attribution schema。
-
Robust hypergraph construction:结合 CrossAug - Cross-Chunk Graph Augmentation for GraphRAG 和 CS-RAG - Robust GraphRAG over Imperfect KGs,检查 hypergraph 抽取缺边、错边、hub entity 对 progress reward 的影响。
-
Extend beyond QA:在标准文档、企业流程、工程图纸、代码库和医学 guideline 上验证 step progress reward 是否仍能稳定指导检索。
关联与拓展
- 2026-06-09-Paper-Pool:第四批 P0 候选,已从摘要级提升到 PDF级。
- 2026-06-09-Open-Problems OP-9:可补 evidence subgraph and path optimization,尤其是 structure-guided hyperedge retrieval 和 $R_t(e)$。
- 2026-06-09-Open-Problems OP-10:直接补 planning-guided traversal attribution,把 turn-level support gain 推进到 step-level reward。
- 2026-06-09-Open-Problems OP-17:Table 7 说明 retrieval 已命中后仍会 reasoning drift,HyperGraphPro 用 step progress 减少这种后检索错误。
- Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning:HyperGraphPro 继承 RL-based agentic GraphRAG 设定,但更强调结构引导检索和 step-level dense reward。
- GraphRAG-R1 - Process-Constrained Reinforcement Learning for GraphRAG:二者都用 RL 训练 GraphRAG agent;GraphRAG-R1 约束检索成本 / 次数,HyperGraphPro 约束结构进展 / 中间贡献。
- PRoH - Dynamic Planning over Knowledge Hypergraphs:二者都使用 hypergraph 结构;PRoH 偏 planning DAG + EWO path retrieval,HyperGraphPro 偏 retrieval re-score + RL step reward。
- DOTRAG - Retrieval-Time Reasoning Along Paths:都把 reasoning 前移到检索阶段;DOTRAG 用 path judge,HyperGraphPro 用 structure-guided hyperedge score 和 progress-aware policy optimization。
- GraphRAG中的Agentic轨迹质量:HyperGraphPro 提供可操作的 step reward 设计,可用于定义轨迹中每一步是否真的推动答案。
- Graph搜索的完备性与Beam-Search偏差:结构区分度 $I_t(v)$ 可作为缓解语义 shortcut 和 hub entity 干扰的候选信号。
研究问题入口
Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略, Q6 证据来源与可解释性