GGraphRAG 文献图谱自动同步
LIT-A718906E · 2026

XGRAG - Graph-Native Framework for Explaining KG-based RAG

XGRAG 把扰动解释从文本 token / sentence 提升到图节点和边,通过“扰动图组件 -> 重新生成答案 -> 比较语义变化”来估计每个 graph component 对答案的因果贡献。

PDF 级阅读卡优先级 P1Zhuoling Li, Ha Linh Hong Tran Nguyen, Valeria Bladinieres, Maxim Romanovsky发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:GraphRAG 通过知识图谱给 LLM 提供结构化上下文,但最终答案仍是黑盒生成。用户很难知道哪些节点、边或关系真正影响了答案。

  • 为什么重要:在金融、医疗、合规等高风险场景,仅返回最终答案和引用不够。系统需要说明答案依赖了哪些结构化知识单元,以及移除这些单元是否会改变答案。

  • 现有方法:RAG-Ex、RAGE 等 RAG explainability 方法主要在文本 chunk、word 或 sentence 上做扰动;它们不能自然解释 GraphRAG 中的节点、边、路径和图拓扑贡献。

  • 对本知识库的意义:XGRAG 是 2026-06-09-Open-Problems OP-18 的直接补充。它不像 Ex-GraphRAG - Interpretable Evidence Routing for Graph-Augmented LLMs 那样解释 graph encoder 的内部贡献,而是用 graph-native perturbation 解释最终答案对节点/边的因果敏感性。

  • Text-level perturbation 不能对应 GraphRAG 的结构单元:删一个词或一句话,不等于删掉某个实体、关系或子图路径。

  • GraphRAG 的 citation 或 retrieved subgraph 只说明“系统看到了什么”,不能说明“哪些图组件一旦被扰动会改变答案”。

  • 现有 KG/RAG 解释工作缺少系统化评估:即使能输出节点或路径解释,也常缺少 F1、MRR、P@k、中心性相关性等可复现实验口径。

  • 直接在 Microsoft GraphRAG 上做扰动解释成本很高,因为每个 query 需要多次重跑检索/生成管线;如果 backbone 太重,graph perturbation 会不可用。

  • 图中 alias、近义实体和重复节点会让解释分散:同一概念被拆成多个节点,重要性分数会被稀释。

方法与机制

1. 总体框架:Graph-native Perturb-Generate-Compare

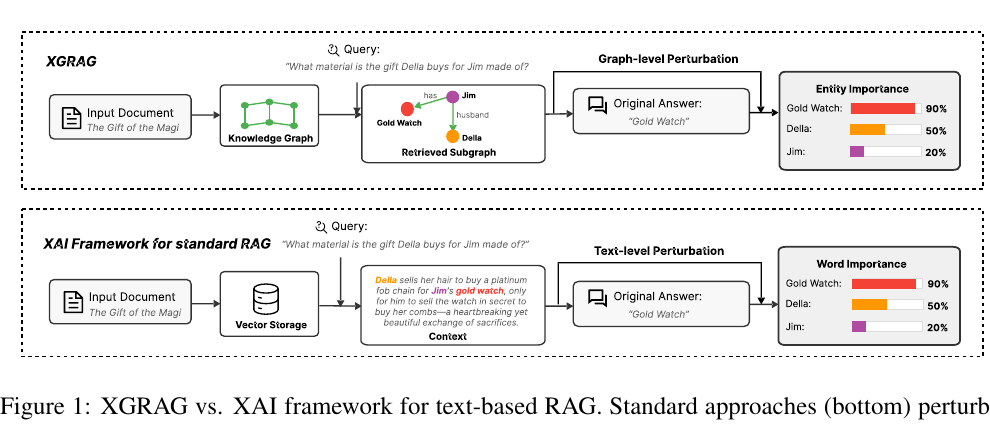
Figure 1 对比了 XGRAG 与标准 text-based RAG XAI:

  • 标准 RAG-XAI:从 vector store 取文本 context,扰动 word / sentence,再看答案变化。
  • XGRAG:从 KG / GraphRAG 检索子图,扰动 graph node / edge,再看答案变化。

输入:

  • 文档集合 $D$。
  • 用户问题 $q$。
  • GraphRAG / LightRAG backbone。

计算:

  1. 构建全局知识图:
G=(V,E)
  1. 对问题 $q$ 检索相关子图:
G_{ret}=(V_{ret},E_{ret})
  1. 做实体去重,得到干净子图:
G_{dedup}=(V_{dedup},E_{dedup})
  1. 生成 baseline answer:
a_0=g(G_{dedup})
  1. 对图组件 $p\in V_{dedup}\cup E_{dedup}$ 做扰动,得到 counterfactual graph:
G'_{dedup}=Perturb(G_{dedup},p)
  1. 重跑生成器:
a_p=g(G'_{dedup})

输出:每个节点或边的 normalized importance score。

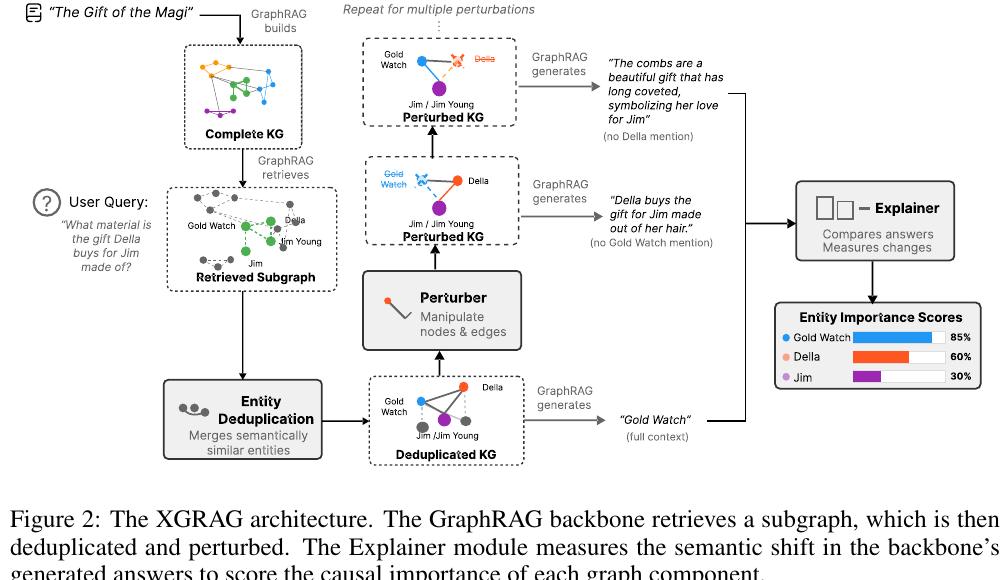
2. XGRAG Architecture:Backbone + Deduplication + Perturber + Explainer

输入:query $q$ 和 source documents。

计算链路:

  1. GraphRAG backbone 构建完整 KG。
  2. Backbone 检索 query-relevant subgraph。
  3. Entity Deduplication 合并语义等价节点。
  4. Perturber 生成多个 counterfactual KGs。
  5. Backbone 对每个 counterfactual KG 重新生成答案。
  6. Explainer 比较 baseline answer 与 counterfactual answer 的语义差异。

输出:

  • 节点重要性分数,例如 Gold Watch 85%、Della 60%、Jim 30%。
  • 可用于审计的“答案依赖哪些图组件”解释。

3. Entity Deduplication:避免 alias fragmentation

输入:检索子图 $G_{ret}=(V_{ret},E_{ret})$,实体名 embedding 模型 $E$,阈值 $\theta_{sim}$。

计算:

先构造 similarity graph:

G_{sim}=(V_{ret},E_{sim})

若两个实体同类型且名字 embedding 相似度超过阈值,则连边:

(v_i,v_j)\in E_{sim}\Longleftrightarrow type(v_i)=type(v_j)\land sim(E(name(v_i)),E(name(v_j)))\ge \theta_{sim}

然后对 $G_{sim}$ 求连通分量:

C=\{C_1,C_2,\ldots,C_k\}

每个 cluster 选择在原检索子图中度数最高的节点作为 canonical representative:

v_i^*=\arg\max_{v\in C_i}deg_{G_{ret}}(v)

用映射 $\phi:V_{ret}\rightarrow V_{dedup}$ 合并节点,并重映射边:

E_{dedup}=\{(\phi(u),l,\phi(v))\mid (u,l,v)\in E_{ret}\land \phi(u)\ne \phi(v)\}

输出:去重后的 $G_{dedup}$。同一概念的文本描述会合并到 canonical node,减少解释分数被 alias 拆散。

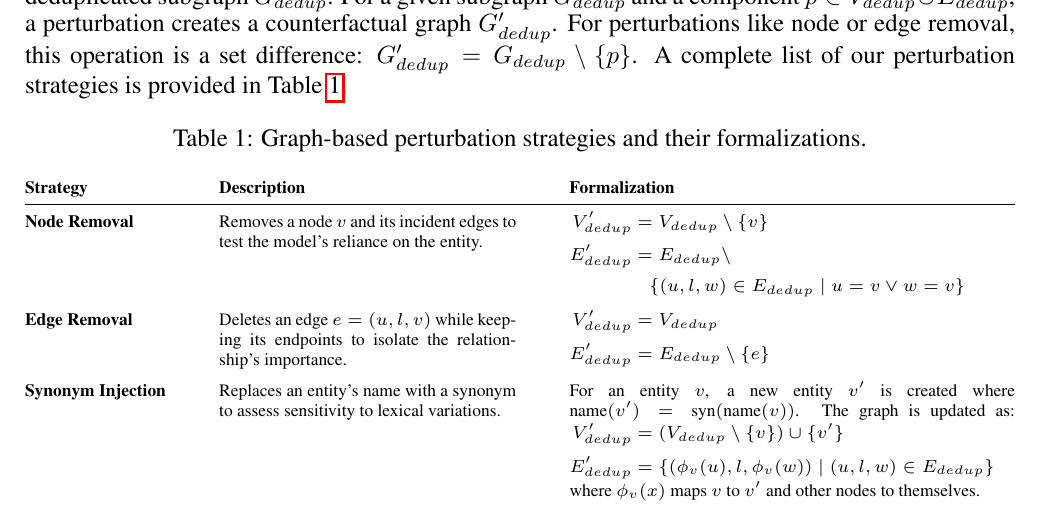
4. Perturbation Strategies:节点、边、同义词三类扰动

输入:去重子图 $G_{dedup}$ 和待解释组件 $p$。

计算:XGRAG 定义三类图原生扰动。

  • Node Removal:删除节点 $v$ 及其 incident edges。
V'_{dedup}=V_{dedup}\setminus\{v\}
E'_{dedup}=E_{dedup}\setminus\{(u,l,w)\in E_{dedup}\mid u=v\vee w=v\}
  • Edge Removal:删除边 $e=(u,l,v)$,保留端点。
V'_{dedup}=V_{dedup}
E'_{dedup}=E_{dedup}\setminus\{e\}
  • Synonym Injection:把实体名替换为 synonym,测试 lexical sensitivity。

输出:每个扰动对应的 counterfactual subgraph $G'_{dedup}$。

5. Explainer:用答案语义变化定义因果重要性

输入:baseline answer $a_0$,扰动后答案 $a_p$。

计算:

Imp(p)=1-sim(a_0,a_p)

其中 $sim$ 是答案 embedding 的 cosine similarity。答案变化越大,说明 $p$ 越重要。

对同一 query 的所有扰动单元 $P$ 做归一化:

Imp_{norm}(p)=\frac{Imp(p)}{\max_{p'\in P}Imp(p')}

输出:

  • 接近 1:该节点/边对答案影响强。
  • 接近 0:扰动后答案基本不变。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

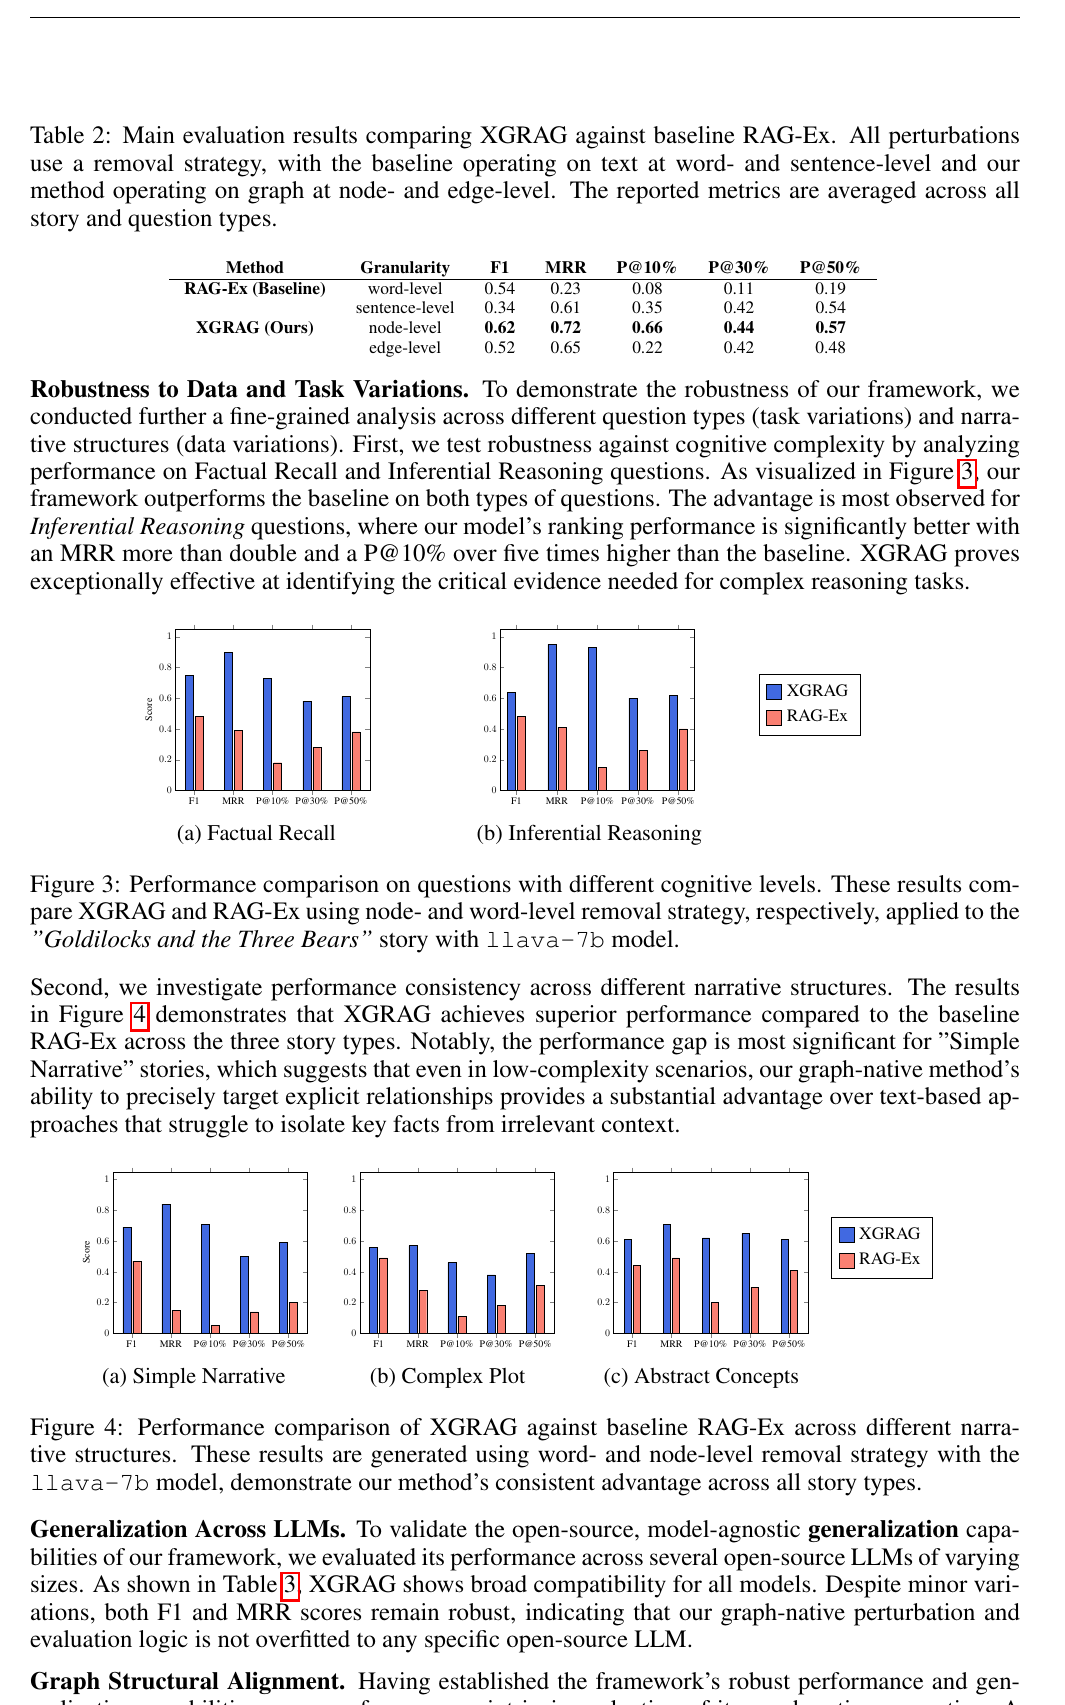
1. 主结果:graph-native perturbation 明显优于 text-level RAG-Ex

Table 2 报告 XGRAG 与 RAG-Ex 的整体比较:

  • RAG-Ex word-level:F1 0.54,MRR 0.23,P@10% 0.08。
  • RAG-Ex sentence-level:F1 0.34,MRR 0.61,P@10% 0.35。
  • XGRAG node-level:F1 0.62,MRR 0.72,P@10% 0.66。
  • XGRAG edge-level:F1 0.52,MRR 0.65,P@10% 0.22。

论文摘要给出的总体解释质量提升为 14.81%。从表中看,node-level perturbation 是最强设置,尤其 P@10% 明显高于文本扰动,说明它更容易把最关键证据排在前面。

2. 任务和文本结构鲁棒性:inferential reasoning 上优势更明显

Figure 3 显示 XGRAG 在 factual recall 和 inferential reasoning 上均优于 RAG-Ex。Inferential reasoning 中,XGRAG 的 MRR 超过 baseline 两倍,P@10% 超过五倍。

Figure 4 显示在 Simple Narrative、Complex Plot、Abstract Concepts 三类故事结构上,XGRAG 都保持优势。

解读:图扰动解释对复杂推理更有价值,因为这类问题依赖实体关系链,而不是单个文本片段。

3. 跨开源 LLM 泛化与图结构对齐

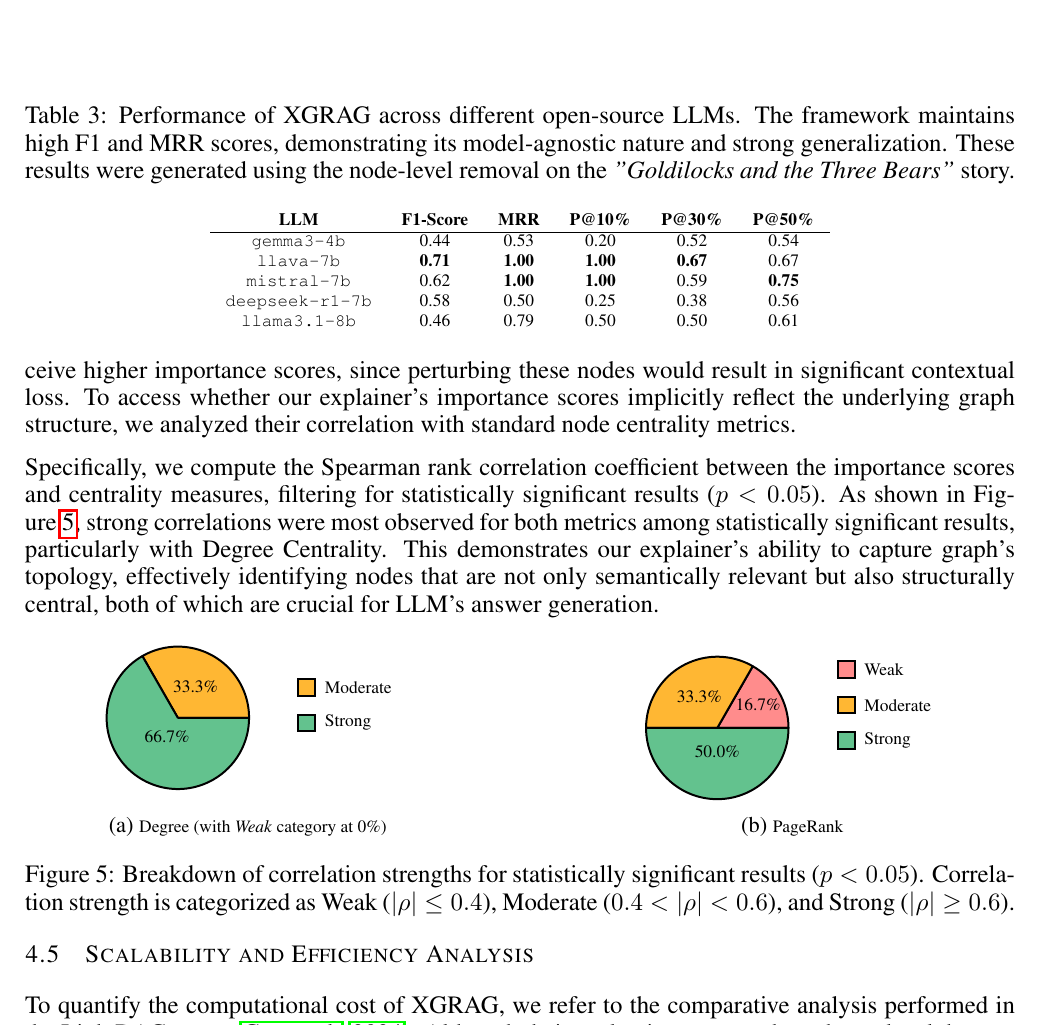
Table 3 在不同开源模型上测试 XGRAG:

  • llava-7b:F1 0.71,MRR 1.00,P@10% 1.00。
  • mistral-7b:F1 0.62,MRR 1.00,P@10% 1.00。
  • deepseek-r1-7b:F1 0.58。
  • llama3.1-8b:F1 0.46。
  • gemma3-4b:F1 0.44。

Figure 5 检验 importance score 与图中心性指标的相关性。统计显著结果中:

  • Degree centrality:66.7% 是 strong correlation,33.3% 是 moderate。
  • PageRank:50.0% strong,33.3% moderate,16.7% weak。

解读:XGRAG 的重要性不是纯文本相似度噪声,它和图拓扑中心性存在一定一致性。但这也提示一个风险:central node 可能被高估,bridge / low-degree 但关键的节点需要单独审计。

4. 成本:扰动解释依赖轻量 backbone

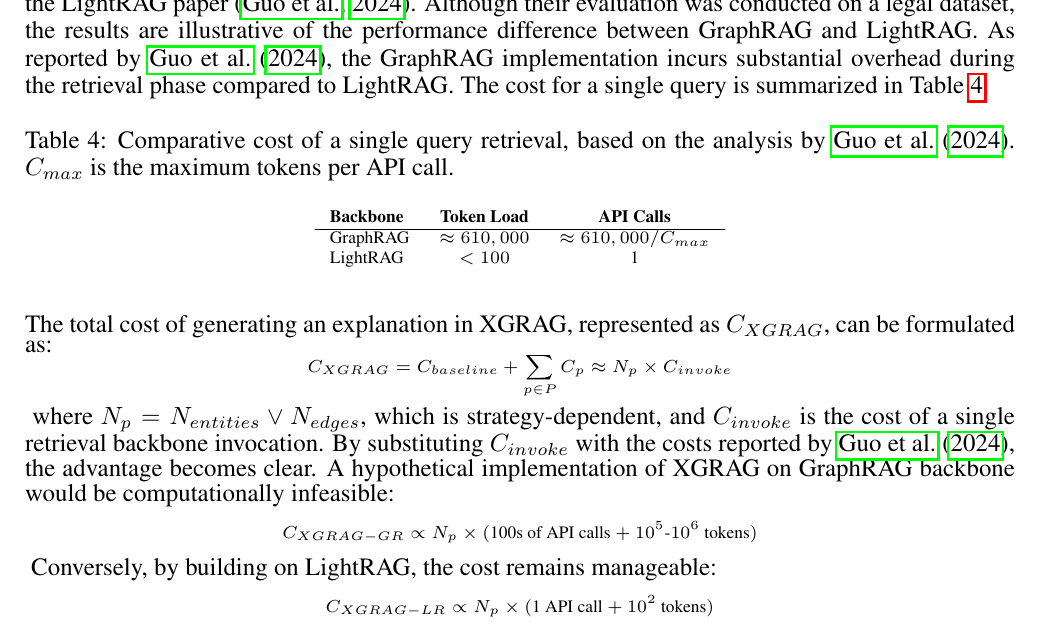
论文引用 LightRAG 的成本分析说明:

  • GraphRAG 单次 query token load 约 610,000,API calls 约 $610000/C_{max}$。
  • LightRAG token load 小于 100,API calls 为 1。

XGRAG 的解释成本:

C_{XGRAG}=C_{baseline}+\sum_{p\in P}C_p\approx N_p\times C_{invoke}

其中:

N_p=N_{entities}\vee N_{edges}

如果 backbone 是重型 GraphRAG:

C_{XGRAG-GR}\propto N_p\times(100s\ of\ API\ calls+10^5-10^6\ tokens)

如果 backbone 是 LightRAG:

C_{XGRAG-LR}\propto N_p\times(1\ API\ call+10^2\ tokens)

解读:XGRAG 的核心代价来自“每个组件都要重跑一次生成”。因此它不是任何 GraphRAG 上都可直接套用,必须配合轻量、可重复调用的 retrieval/generation backbone。

5. 消融:entity dedup 和 node removal 最关键

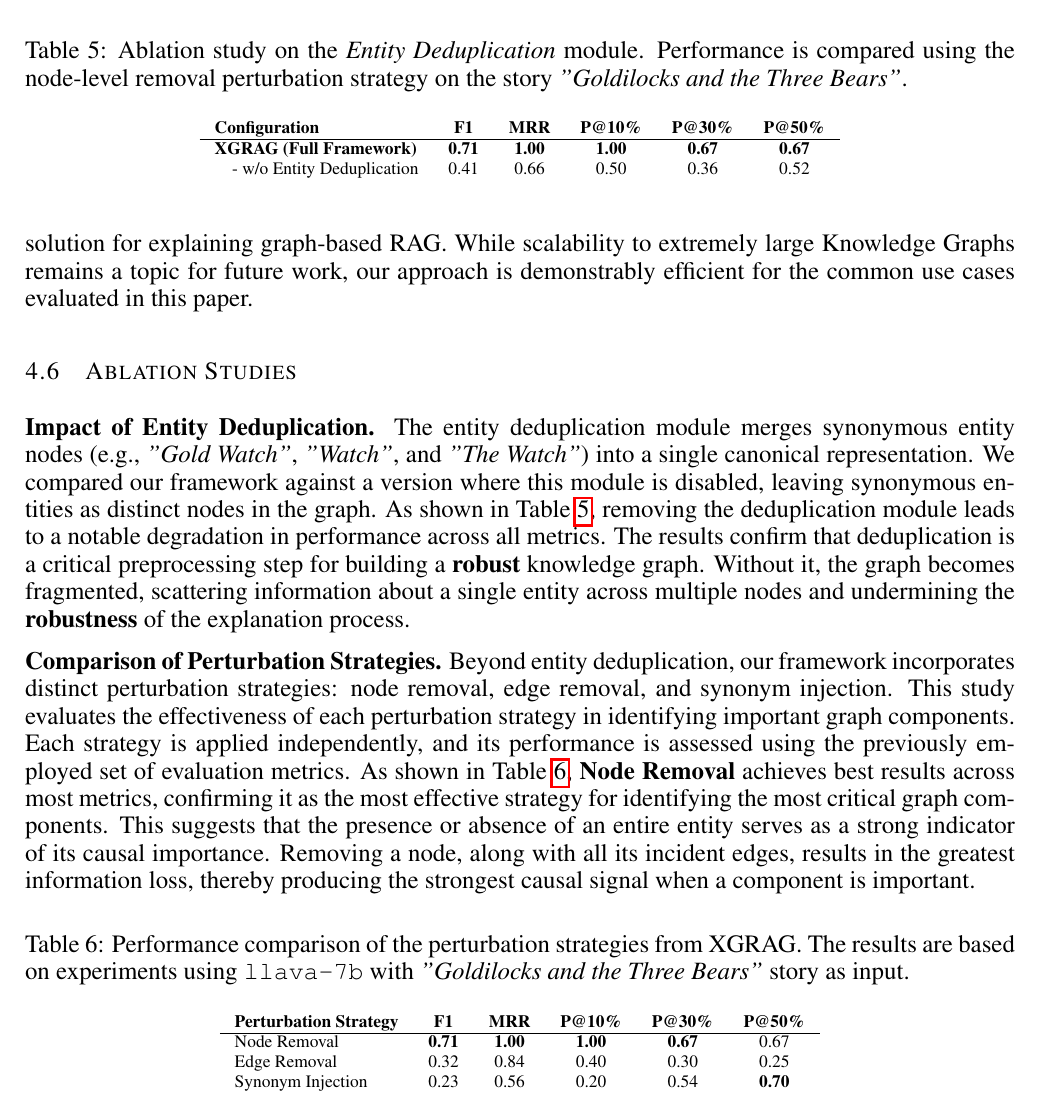
Table 5:

  • Full XGRAG:F1 0.71,MRR 1.00,P@10% 1.00。
  • w/o Entity Deduplication:F1 0.41,MRR 0.66,P@10% 0.50。

解读:去重不是工程细节,而是解释质量的关键前置条件。alias fragmentation 会让重要概念分散到多个节点,扰动信号变弱。

Table 6:

  • Node Removal:F1 0.71,MRR 1.00,P@10% 1.00。
  • Edge Removal:F1 0.32,MRR 0.84,P@10% 0.40。
  • Synonym Injection:F1 0.23,MRR 0.56,P@50% 0.70。

解读:node removal 最能产生强因果信号;edge removal 排序尚可但分类 F1 较低;synonym injection 更像鲁棒性测试,不适合作为主解释策略。

6. Qualitative Case:Della gift 子图解释

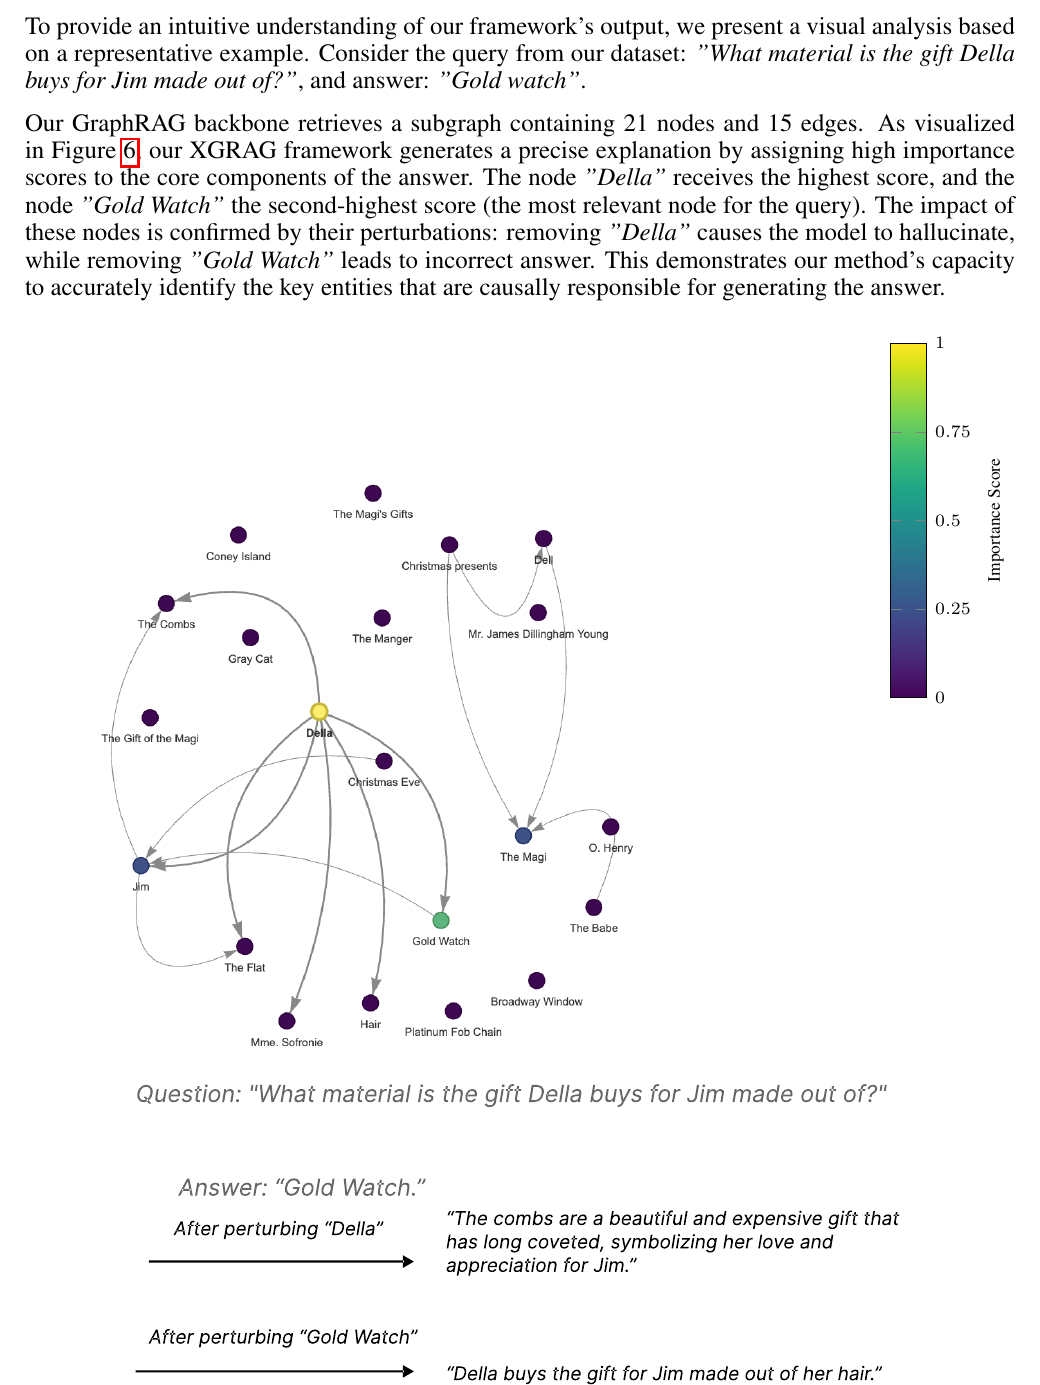
案例问题:What material is the gift Della buys for Jim made out of?,答案是 Gold watch。

GraphRAG backbone 检索到 21 nodes / 15 edges 的子图。XGRAG 给出重要性:

  • Della 最高。
  • Gold Watch 第二高,也是最直接答案节点。

扰动验证:

  • 删除 Della 会让模型 hallucinate。
  • 删除 Gold Watch 会导致错误答案。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

局限与开放问题

  • Ground truth 不是人工标注的“真实解释”,而是用 answer 与 graph component 的语义相似度构造的可复现近似,可能把表面语义相似误当成因果支持。

  • 评估只覆盖本地开源 LLM 和英文 narrative / QA 数据集,尚未验证多语言、金融/医疗等真实高风险 KG。

  • XGRAG 需要对每个待解释组件重跑 generation,成本随 nodes / edges 数量线性增长;大图或重型 GraphRAG backbone 下成本会很高。

  • Node centrality 相关性既是优点也是风险:如果系统过度偏向中心节点,可能忽视低中心性但路径必要的 bridge node。

  • Edge removal 和 synonym injection 的效果明显弱于 node removal,说明目前框架对 relation-level explanation 仍不足。

  • Explanation quality 依赖 prompt 稳定、temperature 设置和 entity dedup 阈值,工程参数会影响解释排序。

  • 作者方向:

    • 更稳健的 ground-truth 方法,包括 LLM-as-judge 和人工细粒度 relevance annotation。
    • 扩展到更大 proprietary LLM、多语言和领域知识图谱。
    • 继续研究极大 KG 下的解释成本和可扩展性。
  • Agent 推断的 Research Opportunities:

    • 和 Ex-GraphRAG - Interpretable Evidence Routing for Graph-Augmented LLMs 结合:一个解释 encoder 内部贡献,一个解释答案对 graph component 的 counterfactual sensitivity。
    • 将 OP-18 的 evidence-flow audit 拆成四层:retrieved / encoded / perturbed-sensitive / cited-final-used。
    • 为 relation-level explanation 设计更强扰动:path removal、edge label masking、relation rewrite、bridge-node isolation。
    • 建立人工标注解释集,区分 semantic similarity、causal necessity、citation support 和 structural bridge necessity。
    • 把 XGRAG 用于 GraphRAG debugging:当答案错时,检查高 importance 节点是否是错误实体、hub shortcut、poisoned bridge 或 unsupported fact。

关联与拓展

研究问题入口

Q2 图构建与表示, Q3 证据检索与集合形成, Q6 证据来源与可解释性, Q7 鲁棒性与安全, Q8 效率与部署

展开原始论文笔记全文

基本信息

  • 英文标题:XGRAG: A Graph-Native Framework for Explaining KG-based Retrieval-Augmented Generation
  • 中文标题:XGRAG:面向基于知识图谱 RAG 的图原生解释框架
  • 作者:Zhuoling Li, Ha Linh Hong Tran Nguyen, Valeria Bladinieres, Maxim Romanovsky
  • 机构:Berlin Technology Centre, Deutsche Bank
  • 年份:2026
  • 版本:arXiv v1,2026-04-27;OpenReview / ICLR 2026 submission
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:论文正文未给出公开代码仓库。
  • 阅读状态:PDF级
  • 所属方向:GraphRAG explainability、graph-native perturbation、causal attribution、evidence routing audit
  • 优先级:P1

Background

  • 研究问题:GraphRAG 通过知识图谱给 LLM 提供结构化上下文,但最终答案仍是黑盒生成。用户很难知道哪些节点、边或关系真正影响了答案。
  • 为什么重要:在金融、医疗、合规等高风险场景,仅返回最终答案和引用不够。系统需要说明答案依赖了哪些结构化知识单元,以及移除这些单元是否会改变答案。
  • 现有方法:RAG-Ex、RAGE 等 RAG explainability 方法主要在文本 chunk、word 或 sentence 上做扰动;它们不能自然解释 GraphRAG 中的节点、边、路径和图拓扑贡献。
  • 对本知识库的意义:XGRAG 是 2026-06-09-Open-Problems OP-18 的直接补充。它不像 Ex-GraphRAG - Interpretable Evidence Routing for Graph-Augmented LLMs 那样解释 graph encoder 的内部贡献,而是用 graph-native perturbation 解释最终答案对节点/边的因果敏感性。

Gap

  • Text-level perturbation 不能对应 GraphRAG 的结构单元:删一个词或一句话,不等于删掉某个实体、关系或子图路径。
  • GraphRAG 的 citation 或 retrieved subgraph 只说明“系统看到了什么”,不能说明“哪些图组件一旦被扰动会改变答案”。
  • 现有 KG/RAG 解释工作缺少系统化评估:即使能输出节点或路径解释,也常缺少 F1、MRR、P@k、中心性相关性等可复现实验口径。
  • 直接在 Microsoft GraphRAG 上做扰动解释成本很高,因为每个 query 需要多次重跑检索/生成管线;如果 backbone 太重,graph perturbation 会不可用。
  • 图中 alias、近义实体和重复节点会让解释分散:同一概念被拆成多个节点,重要性分数会被稀释。

Insight

  • 一句话创新点:XGRAG 把扰动解释从文本 token / sentence 提升到图节点和边,通过“扰动图组件 -> 重新生成答案 -> 比较语义变化”来估计每个 graph component 对答案的因果贡献。
  • 核心洞察:
    • GraphRAG 的解释粒度应该是 node / edge / subgraph,而不是 word / sentence。
    • 重要性应由 counterfactual answer shift 定义:删除或替换某个图组件后,答案变化越大,该组件越关键。
    • LightRAG 这类轻量 backbone 是 XGRAG 可扩展的工程前提;重型 GraphRAG 每次扰动都重跑会成本过高。
    • Entity deduplication 是解释质量的前置条件:如果同一实体被拆成多个节点,扰动会低估该概念的真实影响。

Method

1. 总体框架:Graph-native Perturb-Generate-Compare

XGRAG-fig1-graph-native-vs-text-rag-xai

Figure 1 对比了 XGRAG 与标准 text-based RAG XAI:

  • 标准 RAG-XAI:从 vector store 取文本 context,扰动 word / sentence,再看答案变化。
  • XGRAG:从 KG / GraphRAG 检索子图,扰动 graph node / edge,再看答案变化。

输入:

  • 文档集合 $D$。
  • 用户问题 $q$。
  • GraphRAG / LightRAG backbone。

计算:

  1. 构建全局知识图:
G=(V,E)
  1. 对问题 $q$ 检索相关子图:
G_{ret}=(V_{ret},E_{ret})
  1. 做实体去重,得到干净子图:
G_{dedup}=(V_{dedup},E_{dedup})
  1. 生成 baseline answer:
a_0=g(G_{dedup})
  1. 对图组件 $p\in V_{dedup}\cup E_{dedup}$ 做扰动,得到 counterfactual graph:
G'_{dedup}=Perturb(G_{dedup},p)
  1. 重跑生成器:
a_p=g(G'_{dedup})

输出:每个节点或边的 normalized importance score。

2. XGRAG Architecture:Backbone + Deduplication + Perturber + Explainer

XGRAG-fig2-architecture

输入:query $q$ 和 source documents。

计算链路:

  1. GraphRAG backbone 构建完整 KG。
  2. Backbone 检索 query-relevant subgraph。
  3. Entity Deduplication 合并语义等价节点。
  4. Perturber 生成多个 counterfactual KGs。
  5. Backbone 对每个 counterfactual KG 重新生成答案。
  6. Explainer 比较 baseline answer 与 counterfactual answer 的语义差异。

输出:

  • 节点重要性分数,例如 Gold Watch 85%、Della 60%、Jim 30%。
  • 可用于审计的“答案依赖哪些图组件”解释。

3. Entity Deduplication:避免 alias fragmentation

输入:检索子图 $G_{ret}=(V_{ret},E_{ret})$,实体名 embedding 模型 $E$,阈值 $\theta_{sim}$。

计算:

先构造 similarity graph:

G_{sim}=(V_{ret},E_{sim})

若两个实体同类型且名字 embedding 相似度超过阈值,则连边:

(v_i,v_j)\in E_{sim}\Longleftrightarrow type(v_i)=type(v_j)\land sim(E(name(v_i)),E(name(v_j)))\ge \theta_{sim}

然后对 $G_{sim}$ 求连通分量:

C=\{C_1,C_2,\ldots,C_k\}

每个 cluster 选择在原检索子图中度数最高的节点作为 canonical representative:

v_i^*=\arg\max_{v\in C_i}deg_{G_{ret}}(v)

用映射 $\phi:V_{ret}\rightarrow V_{dedup}$ 合并节点,并重映射边:

E_{dedup}=\{(\phi(u),l,\phi(v))\mid (u,l,v)\in E_{ret}\land \phi(u)\ne \phi(v)\}

输出:去重后的 $G_{dedup}$。同一概念的文本描述会合并到 canonical node,减少解释分数被 alias 拆散。

4. Perturbation Strategies:节点、边、同义词三类扰动

XGRAG-table1-perturbation-strategies

输入:去重子图 $G_{dedup}$ 和待解释组件 $p$。

计算:XGRAG 定义三类图原生扰动。

  • Node Removal:删除节点 $v$ 及其 incident edges。
V'_{dedup}=V_{dedup}\setminus\{v\}
E'_{dedup}=E_{dedup}\setminus\{(u,l,w)\in E_{dedup}\mid u=v\vee w=v\}
  • Edge Removal:删除边 $e=(u,l,v)$,保留端点。
V'_{dedup}=V_{dedup}
E'_{dedup}=E_{dedup}\setminus\{e\}
  • Synonym Injection:把实体名替换为 synonym,测试 lexical sensitivity。

输出:每个扰动对应的 counterfactual subgraph $G'_{dedup}$。

5. Explainer:用答案语义变化定义因果重要性

输入:baseline answer $a_0$,扰动后答案 $a_p$。

计算:

Imp(p)=1-sim(a_0,a_p)

其中 $sim$ 是答案 embedding 的 cosine similarity。答案变化越大,说明 $p$ 越重要。

对同一 query 的所有扰动单元 $P$ 做归一化:

Imp_{norm}(p)=\frac{Imp(p)}{\max_{p'\in P}Imp(p')}

输出:

  • 接近 1:该节点/边对答案影响强。
  • 接近 0:扰动后答案基本不变。

6. Evaluation:解释准确性、排序质量、结构对齐

输入:每个 query 的 graph components、baseline answer、XGRAG importance scores。

Ground truth 构造方式:

rel(p)=sim(a_0,p)

若:

rel(p)>\theta_r

则 $p$ 被标为 positive ground-truth component。论文用这种可复现近似替代人工细粒度标注。

评估指标:

  • Explanation Accuracy:F1,把组件分类为 important / not important。
  • Ranking Quality:MRR、P@10%、P@30%、P@50%。
  • Graph Structural Alignment:importance score 与 Degree Centrality / PageRank 的 Spearman correlation。

Results

1. 主结果:graph-native perturbation 明显优于 text-level RAG-Ex

XGRAG-table2-fig3-fig4-main-robustness

Table 2 报告 XGRAG 与 RAG-Ex 的整体比较:

  • RAG-Ex word-level:F1 0.54,MRR 0.23,P@10% 0.08。
  • RAG-Ex sentence-level:F1 0.34,MRR 0.61,P@10% 0.35。
  • XGRAG node-level:F1 0.62,MRR 0.72,P@10% 0.66。
  • XGRAG edge-level:F1 0.52,MRR 0.65,P@10% 0.22。

论文摘要给出的总体解释质量提升为 14.81%。从表中看,node-level perturbation 是最强设置,尤其 P@10% 明显高于文本扰动,说明它更容易把最关键证据排在前面。

2. 任务和文本结构鲁棒性:inferential reasoning 上优势更明显

Figure 3 显示 XGRAG 在 factual recall 和 inferential reasoning 上均优于 RAG-Ex。Inferential reasoning 中,XGRAG 的 MRR 超过 baseline 两倍,P@10% 超过五倍。

Figure 4 显示在 Simple Narrative、Complex Plot、Abstract Concepts 三类故事结构上,XGRAG 都保持优势。

解读:图扰动解释对复杂推理更有价值,因为这类问题依赖实体关系链,而不是单个文本片段。

3. 跨开源 LLM 泛化与图结构对齐

XGRAG-table3-fig5-llm-centrality

Table 3 在不同开源模型上测试 XGRAG:

  • llava-7b:F1 0.71,MRR 1.00,P@10% 1.00。
  • mistral-7b:F1 0.62,MRR 1.00,P@10% 1.00。
  • deepseek-r1-7b:F1 0.58。
  • llama3.1-8b:F1 0.46。
  • gemma3-4b:F1 0.44。

Figure 5 检验 importance score 与图中心性指标的相关性。统计显著结果中:

  • Degree centrality:66.7% 是 strong correlation,33.3% 是 moderate。
  • PageRank:50.0% strong,33.3% moderate,16.7% weak。

解读:XGRAG 的重要性不是纯文本相似度噪声,它和图拓扑中心性存在一定一致性。但这也提示一个风险:central node 可能被高估,bridge / low-degree 但关键的节点需要单独审计。

4. 成本:扰动解释依赖轻量 backbone

XGRAG-table4-cost-formula

论文引用 LightRAG 的成本分析说明:

  • GraphRAG 单次 query token load 约 610,000,API calls 约 $610000/C_{max}$。
  • LightRAG token load 小于 100,API calls 为 1。

XGRAG 的解释成本:

C_{XGRAG}=C_{baseline}+\sum_{p\in P}C_p\approx N_p\times C_{invoke}

其中:

N_p=N_{entities}\vee N_{edges}

如果 backbone 是重型 GraphRAG:

C_{XGRAG-GR}\propto N_p\times(100s\ of\ API\ calls+10^5-10^6\ tokens)

如果 backbone 是 LightRAG:

C_{XGRAG-LR}\propto N_p\times(1\ API\ call+10^2\ tokens)

解读:XGRAG 的核心代价来自“每个组件都要重跑一次生成”。因此它不是任何 GraphRAG 上都可直接套用,必须配合轻量、可重复调用的 retrieval/generation backbone。

5. 消融:entity dedup 和 node removal 最关键

XGRAG-table5-table6-ablation-perturbation

Table 5:

  • Full XGRAG:F1 0.71,MRR 1.00,P@10% 1.00。
  • w/o Entity Deduplication:F1 0.41,MRR 0.66,P@10% 0.50。

解读:去重不是工程细节,而是解释质量的关键前置条件。alias fragmentation 会让重要概念分散到多个节点,扰动信号变弱。

Table 6:

  • Node Removal:F1 0.71,MRR 1.00,P@10% 1.00。
  • Edge Removal:F1 0.32,MRR 0.84,P@10% 0.40。
  • Synonym Injection:F1 0.23,MRR 0.56,P@50% 0.70。

解读:node removal 最能产生强因果信号;edge removal 排序尚可但分类 F1 较低;synonym injection 更像鲁棒性测试,不适合作为主解释策略。

6. Qualitative Case:Della gift 子图解释

XGRAG-fig6-qualitative-della-gift

案例问题:What material is the gift Della buys for Jim made out of?,答案是 Gold watch。

GraphRAG backbone 检索到 21 nodes / 15 edges 的子图。XGRAG 给出重要性:

  • Della 最高。
  • Gold Watch 第二高,也是最直接答案节点。

扰动验证:

  • 删除 Della 会让模型 hallucinate。
  • 删除 Gold Watch 会导致错误答案。

解读:这个案例说明 XGRAG 不只输出“相关节点”,而是用 counterfactual generation 验证节点删除后答案是否变化。

7. Prompt / temperature / dedup 阈值稳定性

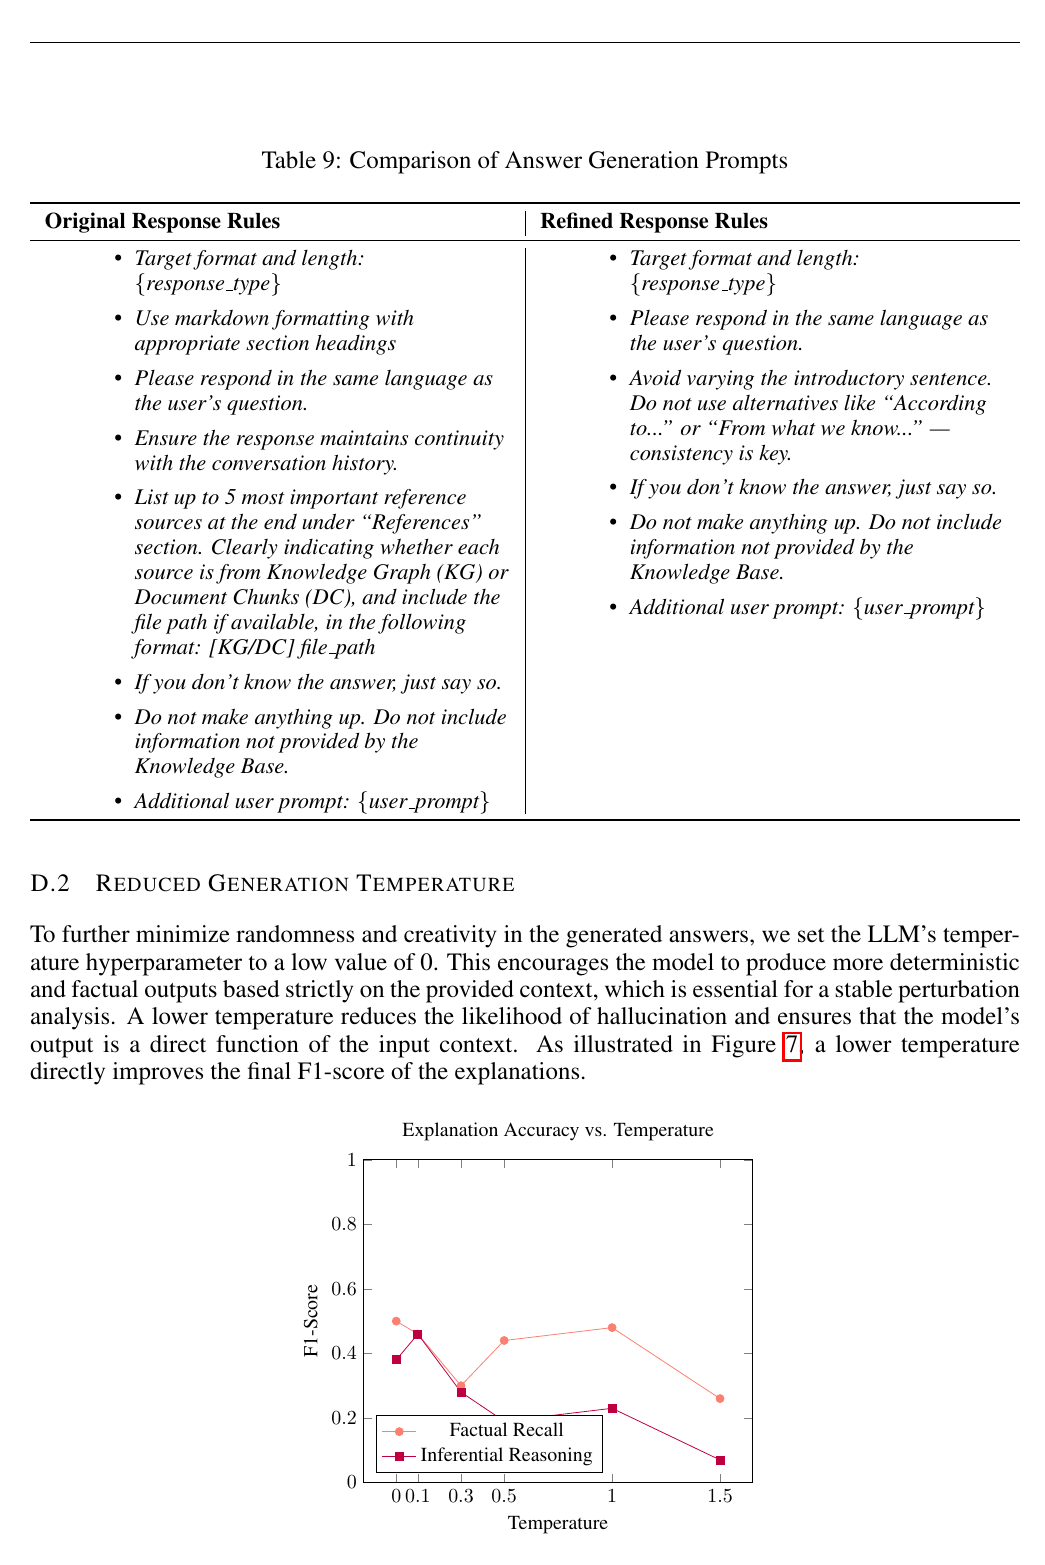
XGRAG-table9-fig7-prompt-temperature

附录说明作者修改了 generation prompt,让答案更简洁、更少随机开场,并设置低 temperature 以减少生成随机性。Figure 7 显示低 temperature 能提高 explanation F1。

XGRAG-fig8-entity-dedup-threshold

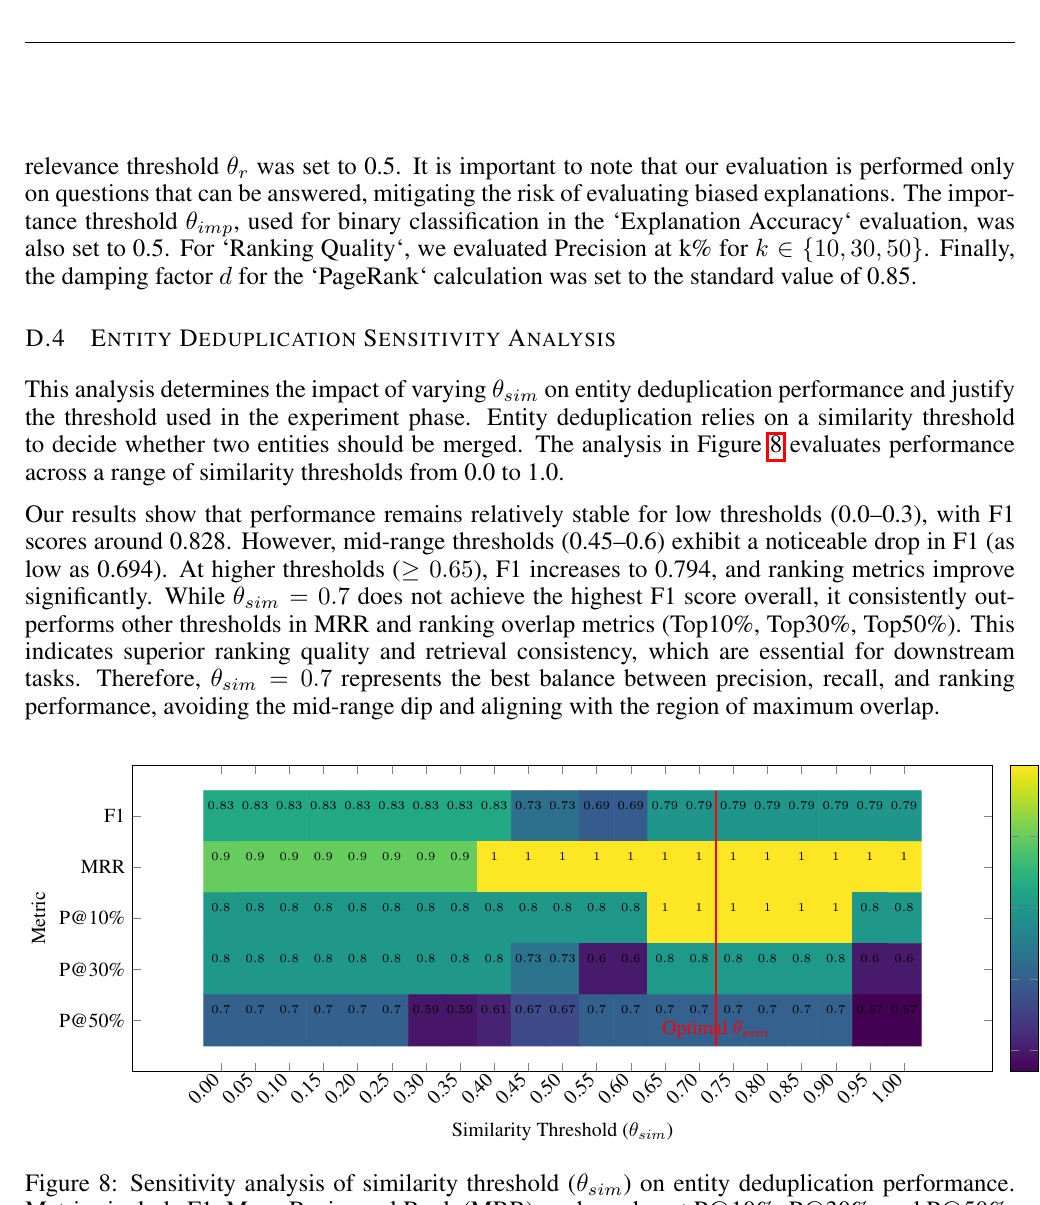
Figure 8 分析 entity deduplication similarity threshold $\theta_{sim}$:

  • 低阈值 0.0-0.3 附近 F1 约 0.828。
  • 中间 0.45-0.6 出现明显下降,最低约 0.694。
  • 高阈值大于等于 0.65 后 F1 回升到约 0.794,MRR 和 overlap 指标更稳。
  • 作者最终使用 $\theta_{sim}=0.7$,强调 ranking quality 和 retrieval consistency。

解读:扰动解释对生成稳定性和实体去重阈值敏感。若 answer generation 本身随机,importance score 会混入生成噪声;若 dedup 阈值不稳,图组件边界会改变解释目标。

Limitations

  • Ground truth 不是人工标注的“真实解释”,而是用 answer 与 graph component 的语义相似度构造的可复现近似,可能把表面语义相似误当成因果支持。
  • 评估只覆盖本地开源 LLM 和英文 narrative / QA 数据集,尚未验证多语言、金融/医疗等真实高风险 KG。
  • XGRAG 需要对每个待解释组件重跑 generation,成本随 nodes / edges 数量线性增长;大图或重型 GraphRAG backbone 下成本会很高。
  • Node centrality 相关性既是优点也是风险:如果系统过度偏向中心节点,可能忽视低中心性但路径必要的 bridge node。
  • Edge removal 和 synonym injection 的效果明显弱于 node removal,说明目前框架对 relation-level explanation 仍不足。
  • Explanation quality 依赖 prompt 稳定、temperature 设置和 entity dedup 阈值,工程参数会影响解释排序。

Future Directions

  • 作者方向:
    • 更稳健的 ground-truth 方法,包括 LLM-as-judge 和人工细粒度 relevance annotation。
    • 扩展到更大 proprietary LLM、多语言和领域知识图谱。
    • 继续研究极大 KG 下的解释成本和可扩展性。
  • Agent 推断的 Research Opportunities:
    • 和 Ex-GraphRAG - Interpretable Evidence Routing for Graph-Augmented LLMs 结合:一个解释 encoder 内部贡献,一个解释答案对 graph component 的 counterfactual sensitivity。
    • 将 OP-18 的 evidence-flow audit 拆成四层:retrieved / encoded / perturbed-sensitive / cited-final-used。
    • 为 relation-level explanation 设计更强扰动:path removal、edge label masking、relation rewrite、bridge-node isolation。
    • 建立人工标注解释集,区分 semantic similarity、causal necessity、citation support 和 structural bridge necessity。
    • 把 XGRAG 用于 GraphRAG debugging:当答案错时,检查高 importance 节点是否是错误实体、hub shortcut、poisoned bridge 或 unsupported fact。

与本知识库的连接

一句话定位

XGRAG 的核心价值是把 GraphRAG 可解释性从“引用了哪些文本/节点”推进到“扰动哪些图组件会改变答案”:它提供了 graph-native counterfactual explanation,是 OP-18 证据流审计中 perturbed-sensitive evidence 这一层的代表方法。