研究问题与动机
-
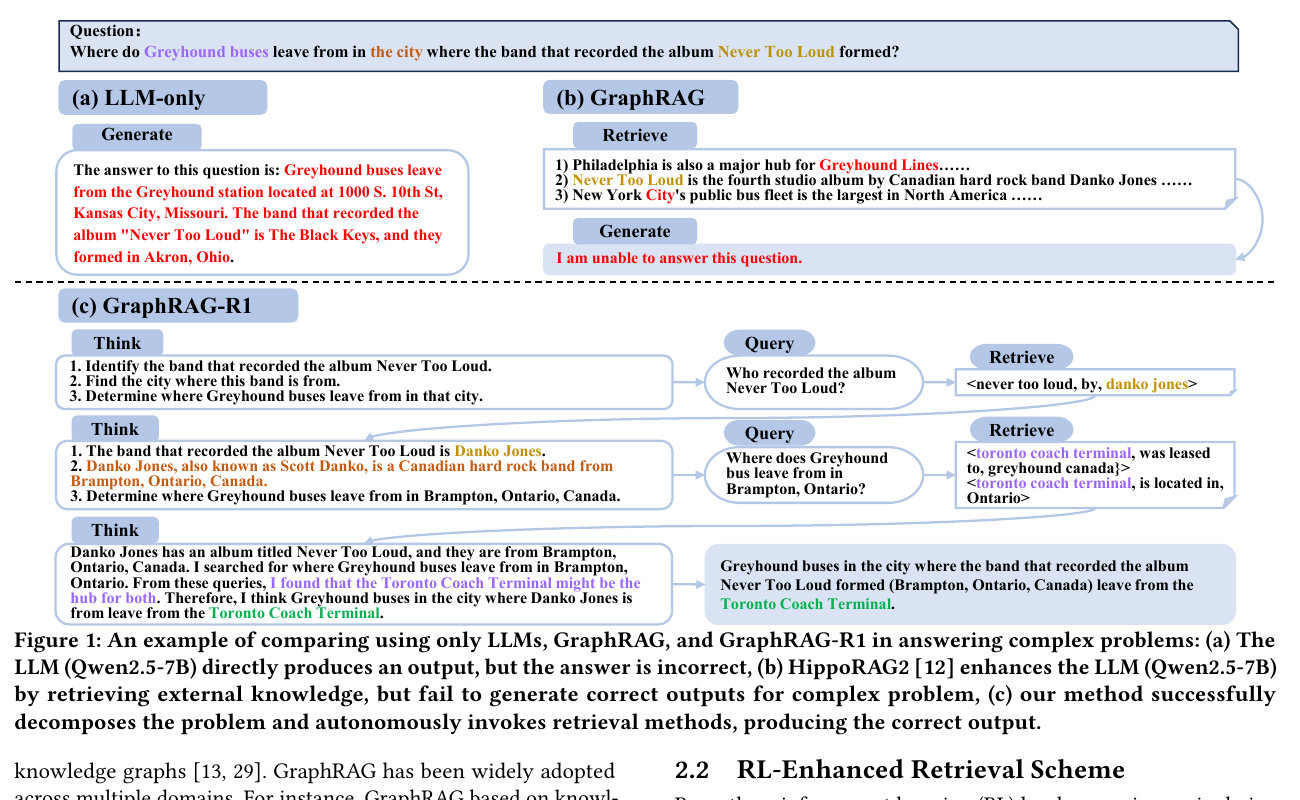
研究问题:复杂多跳问题需要把问题拆解、外部检索和中间推理交织起来。传统 GraphRAG 通常依赖预定义 query processing、固定 hop、BFS / PPR / subgraph retrieval 等规则,无法根据问题难度动态决定检索深度。
-
为什么重要:如果检索太浅,模型拿不到必要桥接证据;如果检索过多,模型会产生 over-thinking、token 成本上升并引入噪声。GraphRAG 的关键控制点因此从“是否使用图”推进到“何时检索、检索几次、每次检索什么、什么时候停止”。
-
现有方法:
- HippoRAG2、LightRAG、KGP、ToG、PropRAG 等方法提供图检索或路径搜索,但策略多数是规则化的。
- R1-Searcher / Search-R1 证明 RL 可以训练检索调用行为,但主要面向通用 RAG search,GraphRAG 中的检索深度、图文本混合和过程约束仍未充分展开。
- Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning 把 GraphRAG 做成 hypergraph environment 上的 end-to-end RL agent;GraphRAG-R1 则更强调用过程奖励控制 shallow retrieval 和 over-thinking。
-
Heuristic retrieval bottleneck:复杂 query 被语义向量平均后会丢失不同语义元素,lexical search 又只能抓表层词;固定路径或固定 hop 难以覆盖远距离、隐式或断裂关系。
-
Reward hacking 风险:只用最终答案正确性做 reward 时,模型可能学到只检索一次的 shallow retrieval,也可能为了探索而过度调用工具。
-
过程信号缺失:传统答案 F1 只能评价最终输出,无法约束检索调用数量、工具调用格式、外部 retrieved tokens 是否参与 loss、以及不同阶段 reward 是否冲突。
-
图文本融合边界不清:纯文本检索语义丰富但 token 高;纯 graph triplet 紧凑但语义细节不足;需要同时评估 F1 和 token cost。
方法与机制
总体框架
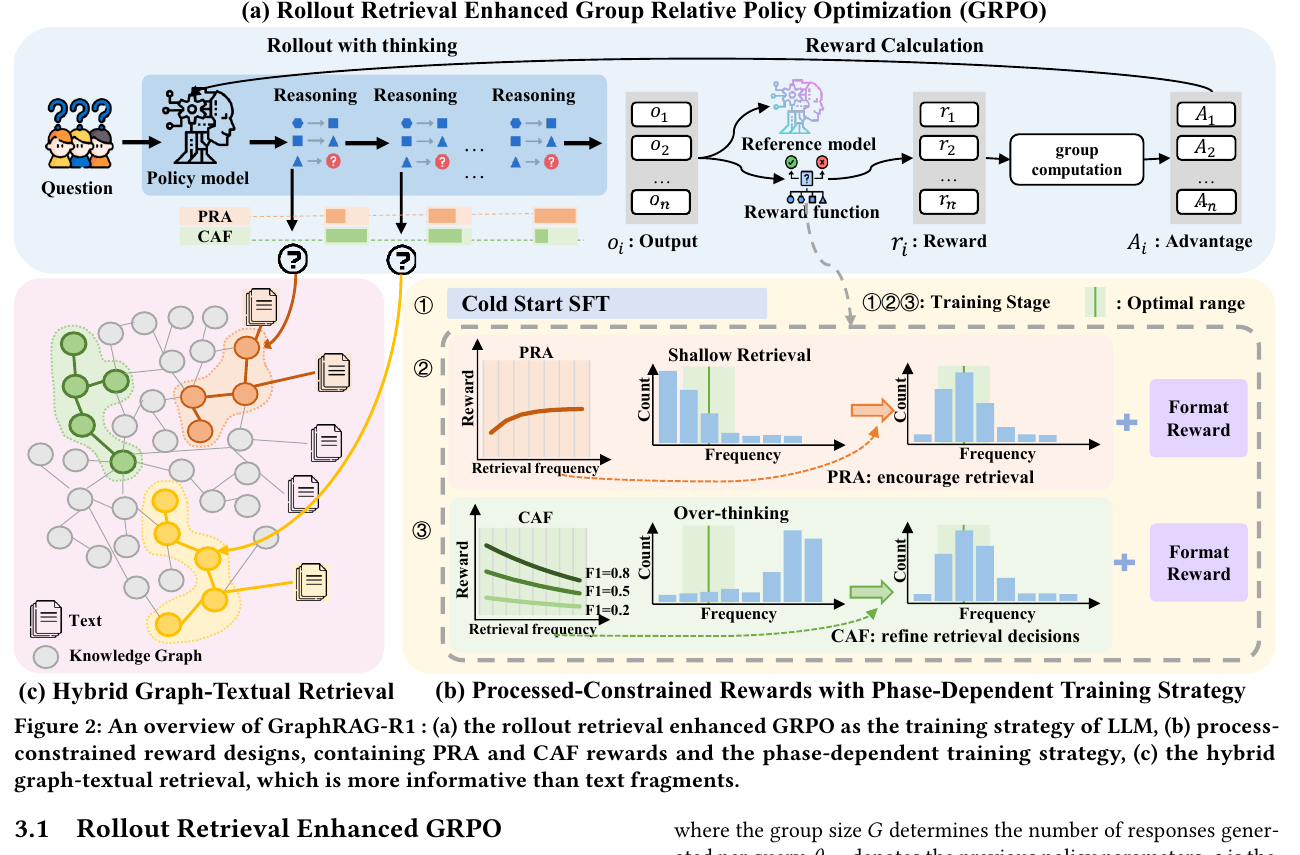
Figure 2 把 GraphRAG-R1 拆成三块:上方是 rollout retrieval enhanced GRPO,中间是 PRA / CAF 过程约束奖励和三阶段训练,左下是 graph-text hybrid retrieval。它不是只把 GraphRAG 接到一个 RL 外壳上,而是把“工具调用格式、检索次数、答案质量、检索内容形态”一起放入训练和推理流程。
1. Rollout retrieval enhanced GRPO
输入:训练问题 q、外部检索工具 R、策略模型 πθ、参考模型 πref、reward function r(q,o)。
计算:模型在生成过程中可以输出 <|begin_of_query|>...<|end_of_query|> 来暂停生成并调用检索器;检索结果被包在 <|begin_of_documents|>...<|end_of_documents|> 中,再继续后续 reasoning。
整体优化目标:
GRPO 对同一个 query 采样一组输出 {o1,...,oG},用组内相对 reward 计算 advantage:
训练目标使用 clipped policy update:
输出:一个能在推理中自主决定是否检索、生成何种 query、何时回答的 GraphRAG policy。
2. Retrieval-Masked Loss
输入:一次 rollout 序列,其中同时包含模型生成 token 和外部检索返回 token。
计算:检索返回内容不应被当作模型要学习生成的 token,所以用 <|begin_of_documents|> 和 <|end_of_documents|> 标记区间并在 loss 中 mask。
可写成:
输出:policy gradient 只更新 LLM 自己生成的 reasoning、query 和 answer token,避免外部文档 token 污染训练信号。
3. Format Reward
输入:模型完整输出,包括 retrieval query、retrieved documents 和 final answer。
计算:检查最终答案是否放在 <answer>...</answer> 中,检索 query 是否用指定标签包住,检索结果是否在 document 标签内,整体是否可读。
输出:稳定的工具调用和答案格式,为后续 RL 阶段降低冷启动难度。
4. PRA:Progressive Retrieval Attenuation
输入:第 n 次检索调用、基础奖励 R0、衰减因子 0<k<1。
计算:第一次检索给基础奖励,后续检索仍给奖励但逐步衰减,鼓励模型不要只检索一次就回答。
几何级数保证检索奖励有上界:
输出:模型在复杂问题上更愿意进行必要的多次检索,但不会因为检索次数无限增长而得到无限 reward。
5. CAF:Cost-Aware F1
输入:最终答案 F1、检索次数 N、系数 a 和 b。
计算:在答案质量相同的情况下,检索越少 reward 越高;如果答案 F1 很低,少检索也不会获得高 reward。
输出:把 answer correctness 和 retrieval cost 放在同一个 reward 中,缓解 over-thinking。
6. 三阶段训练策略
输入:基础 LLM、格式化冷启动数据、PRA / CAF reward。
计算:
- Cold-start SFT:用另一个 LLM 生成格式跟随数据,先让模型学会
<query>/<documents>/<answer>等工具调用协议。 - Behavior shaping:组合 format reward + PRA,重点训练“何时检索、不要浅检索”。
原始笔记摘录已截断;请打开来源笔记阅读完整内容。
证据与结果
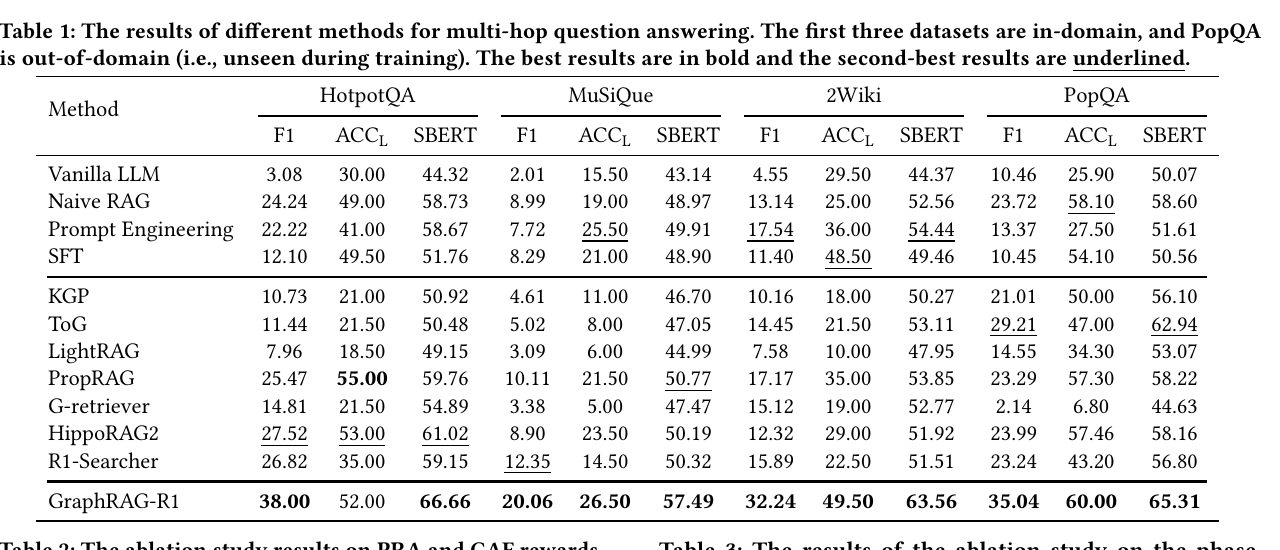
主结果:GraphRAG-R1 在四个多跳 QA 数据集上领先
- Qwen2.5-7B base 设置下,GraphRAG-R1 在 HotpotQA / MuSiQue / 2Wiki / PopQA 上 F1 分别为 38.00 / 20.06 / 32.24 / 35.04。
- 相比强基线 HippoRAG2,GraphRAG-R1 在 HotpotQA 从 27.52 提到 38.00,在 MuSiQue 从 8.90 提到 20.06,在 2Wiki 从 12.32 提到 32.24。
- PopQA 是训练未见的 OOD 数据集,GraphRAG-R1 F1 为 35.04,高于 HippoRAG2 的 23.99 和 R1-Searcher 的 23.24,说明 process-constrained retrieval policy 不是只在训练集内有效。
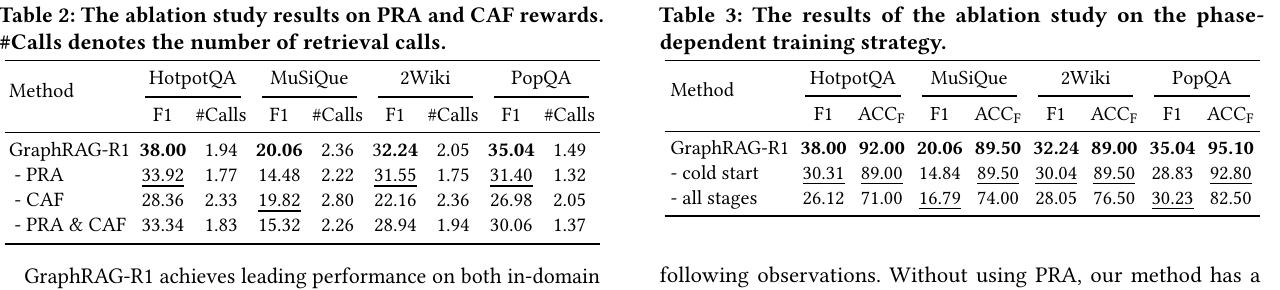
PRA / CAF 与三阶段训练消融
- 去掉 PRA 后,检索调用次数下降,F1 也下降,说明模型更容易 shallow retrieval。
- 去掉 CAF 后,检索调用次数上升,但 F1 下降,说明更多检索并不自动转化为更好答案,可能进入 over-thinking。
- 去掉 cold-start 或直接混合全部 reward 都会降低 F1 或格式准确率
ACCF;三阶段训练的意义是把格式学习、检索行为塑形、成本质量折中分开优化。
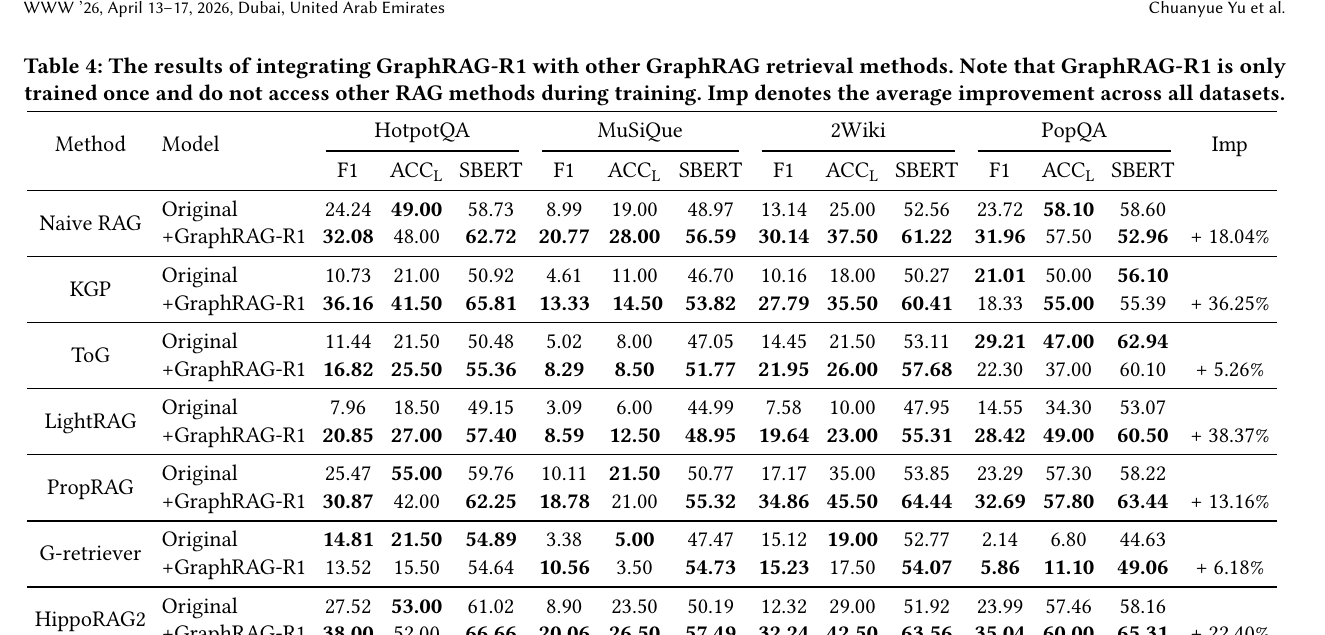
与其他检索器集成:训练一次可迁移到多种 GraphRAG 后端
- GraphRAG-R1 训练时只接触 HippoRAG2,但集成到 Naive RAG、KGP、ToG、LightRAG、PropRAG、G-retriever、HippoRAG2 后多数指标都有提升。
- 平均提升包括 Naive RAG +18.04%、KGP +36.25%、LightRAG +38.37%、HippoRAG2 +22.40%。
- 解读:这篇论文训练的不是某个固定检索器的参数,而是一种“如何用检索工具辅助推理”的 LLM-side policy。
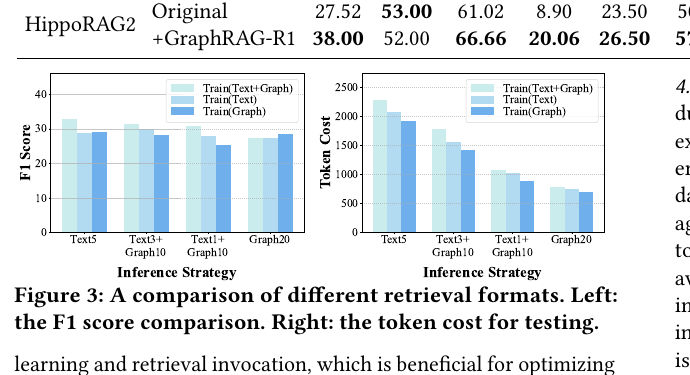
Hybrid retrieval:图比例提高能明显降 token cost
- 混合 Text+Graph 训练整体优于只用 Text 或只用 Graph。
- 推理时从
Text5转向Text3+Graph10、Text1+Graph10、Graph20,token cost 明显下降;F1 只轻微变化。 - 这支持一个可迁移结论:图结构的价值不仅是多跳关系,还包括压缩上下文带宽。
更强 backbone 和附录结果
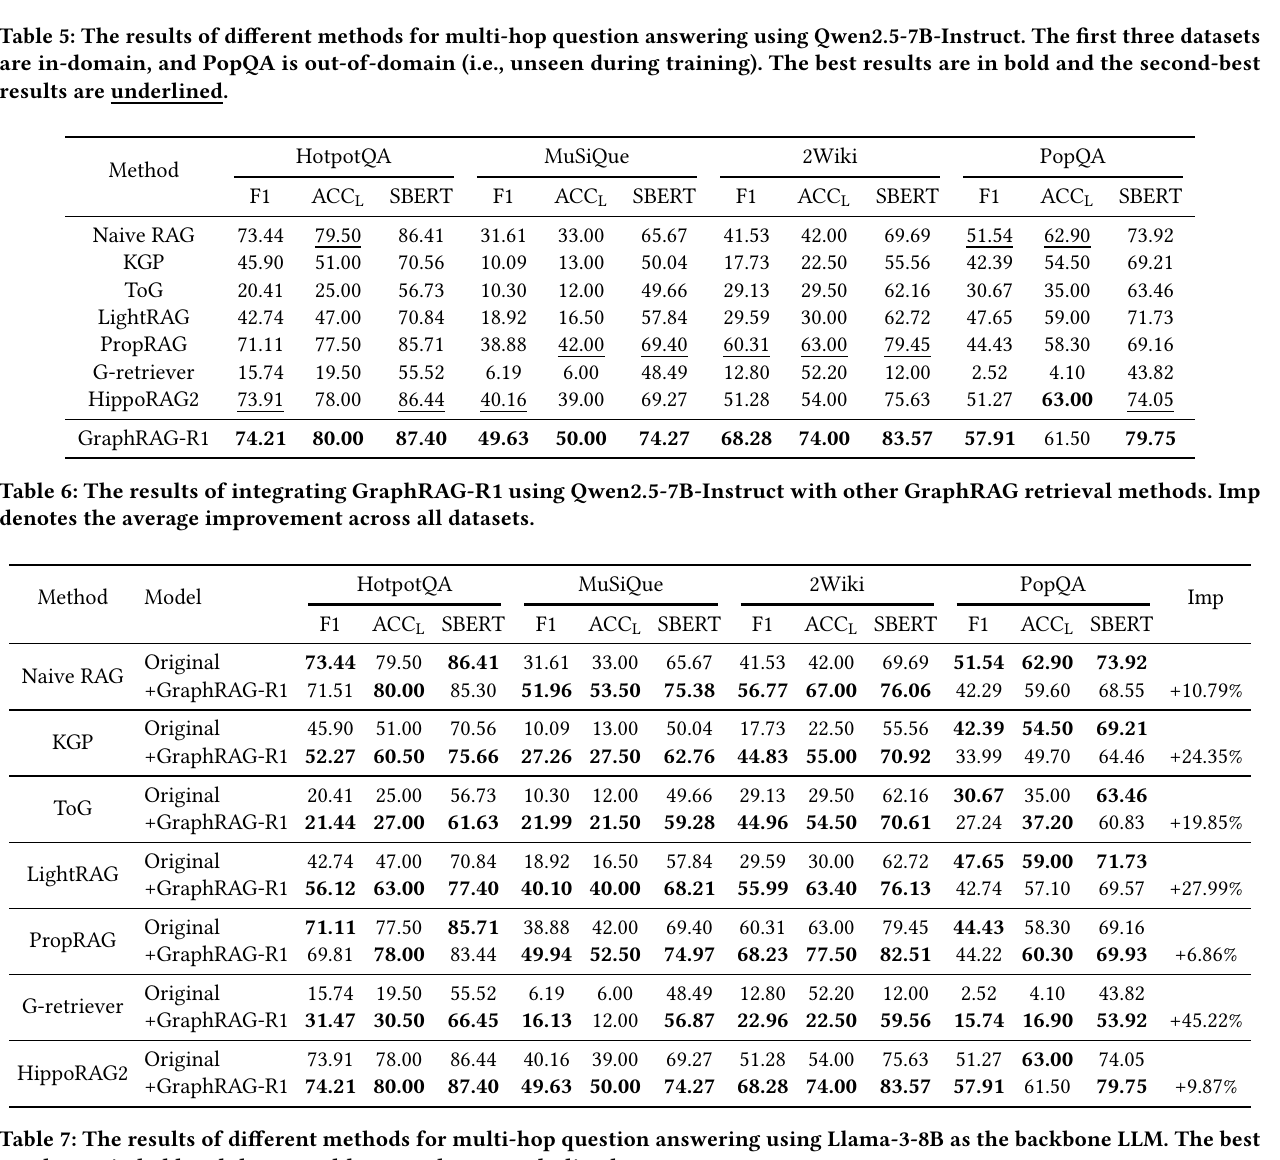
- Qwen2.5-7B-Instruct 上,GraphRAG-R1 在 HotpotQA / MuSiQue / 2Wiki / PopQA 上 F1 为 74.21 / 49.63 / 68.28 / 57.91,显著高于 base 模型设置。
- Instruct 集成实验中,GraphRAG-R1 对 G-retriever 的平均提升达到 +45.22%,对 LightRAG 为 +27.99%,对 KGP 为 +24.35%。
- 这说明 process-constrained GraphRAG RL 可与指令微调模型叠加,而不是只补偿 base 模型弱能力。
成本、DALK 跨域适配和数据规模
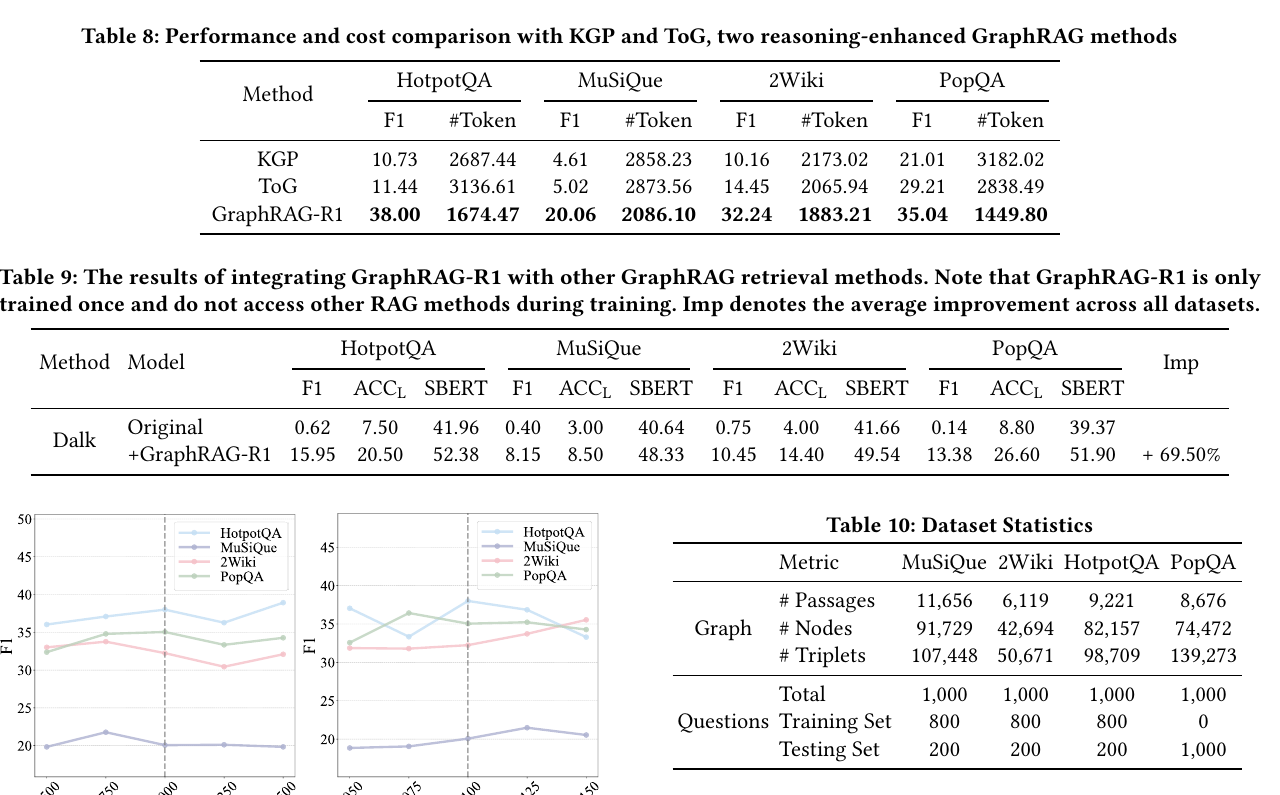
- 与 KGP / ToG 这类 reasoning-enhanced retrieval 相比,GraphRAG-R1 同时获得更高 F1 和更低 token cost。例如 HotpotQA token cost 为 1674.47,低于 KGP 的 2687.44 和 ToG 的 3136.61。
- DALK 作为医疗域检索器接入后,平均相对 F1 提升为 +69.50%,说明该 policy 有跨检索器/跨领域适配潜力。
- 数据统计显示 MuSiQue / 2Wiki / HotpotQA / PopQA 的图规模分别达到 91,729 / 42,694 / 82,157 / 74,472 nodes,说明实验不是极小图 toy setting。
局限与开放问题
-
训练 rollout 默认使用 HippoRAG2 作为外部检索器;虽然后续集成实验显示可迁移,但训练时 retriever choice 仍可能影响学到的 retrieval policy。
-
Reward 仍主要围绕格式、检索次数和答案 F1,没有直接奖励 evidence correctness、path faithfulness、support-set completion 或 citation faithfulness。
-
PRA / CAF 控制的是检索次数分布,不等于证明每一轮检索都带来了新证据;还需要 turn-level utility 和 support gain 记录。
-
Graph-text hybrid retrieval 的最优比例可能依赖数据集、图抽取质量和模型上下文能力,不能直接假设
Graph20或固定 triplet 数对所有任务最优。 -
实验集中在 QA benchmark;企业知识库、代码库、医疗指南、法律裁判文书等高风险场景还需要验证 evidence applicability 和更新成本。
-
作者 Future Work:将 GraphRAG-R1 应用于更多类型图和应用场景。
-
Agent 推断的 Research Opportunities:
- 与 Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning 做细粒度对照:Graph-R1 偏 outcome-directed hypergraph environment,GraphRAG-R1 偏 process-constrained reward。
- 把 PRA / CAF 扩展为更可解释的过程 reward:retrieval-turn utility、support-set completion、path coherence、citation faithfulness。
- 在日志里保存每轮
query -> retrieved triples/text -> support gain -> answer delta -> cost,判断哪些检索是必要、冗余或误导。 - 把 graph-text ratio 纳入 query complexity routing:简单问题少图少检索,复杂多跳问题增加 graph triplet 和检索轮数。
- 结合 OP-17 的 post-retrieval reasoning diagnosis,区分“检索深度不够”和“证据已在上下文但推理失败”。
关联与拓展
- 相关论文:Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning、Do We Still Need GraphRAG - Agentic Search Benchmark、GraphRAG-Router - Cost-Efficient Routing over GraphRAGs and LLMs、A2RAG - Adaptive Agentic Graph Retrieval、Why Neighborhoods Matter - Traversal Context and Provenance in Agentic GraphRAG
- 相关理论:GraphRAG中的Agentic轨迹质量、GraphRAG作为Query-Planning、GraphRAG中的接口-代理-停止决策闭环、GraphRAG中的Query-Complexity与结构选择、GraphRAG中的停止准则与预算分配形式化
- 可接到的 Open Problems:
- 2026-06-09-Open-Problems OP-3:把是否触发多轮 GraphRAG-R1 式检索和 graph-text ratio 纳入 query complexity routing。
- 2026-06-09-Open-Problems OP-10:用 PRA / CAF 和
#Calls作为 planning-guided traversal attribution 的基础过程指标。 - 2026-06-09-Open-Problems OP-17:在 gold evidence 已进入上下文时检查 CAF 是否只是减少检索,还是能真正改善后检索推理。
- 2026-06-09-Open-Problems OP-18:把 reward、retrieval count、retrieved triplets/text 和最终 citation 连接成 evidence-flow audit。
研究问题入口
Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略