GGraphRAG 文献图谱自动同步
LIT-9E494CF3 · 2026

Rethinking Agentic RAG - LLM-Driven Logical Retrieval Beyond Embeddings

LogicalRAG 让 LLM 用 Boolean logic、phrase matching、field targeting 和 matching granularity 表达检索意图,再用倒排索引忠实执行候选过滤,用 BM25 只负责候选集内排序。

PDF 级阅读卡优先级 P0Yuqi Zeng, Qixiang Deng, Yulei Wan, Ruiquan Jiang, Xiaoqing Zheng, Xuanjing Huang发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:Agentic RAG 已经从单次检索变成多轮 plan -> retrieve -> observe -> revise -> answer。当 LLM 能逐步改写检索意图时,系统瓶颈不一定是更复杂的 dense / hybrid / graph backend,而可能是检索接口是否能忠实执行 LLM 给出的结构化意图。

  • 为什么重要:embedding retrieval 擅长语义相似,但对专名、罕见实体、排除条件和精确词组不够可控;GraphRAG 能组织多跳结构,但大规模图构建和维护成本高。本文提出一个反向设计:让 LLM 做“重脑”,把检索后端降为可执行逻辑约束的“精确手”。

  • 对本知识库的意义:这篇论文把 GraphRAG中的图接口选择与任务类型、Query Execution 与 Retrieval 的区别 和 OP-11 进一步推向 agentic 场景:不是所有复杂问答都要先建重图;有些问题更需要一个可控、可修复、低成本的逻辑检索接口。

  • Agentic Hybrid 的 query repair 不够有效:自然语言 query 小幅改写后,在 embedding / hybrid 空间中仍可能返回高度重叠的候选,导致多轮检索只是反复取相似干扰项。

  • 复杂后端成本高:dense / hybrid 需要 corpus-wide embedding 和向量索引;graph-based retrieval 还需要实体关系抽取、图构建和持续更新。

  • 图接口被过度默认:很多系统把 graph / dense / sparse 都称为 retrieval,没有先判断 query 到底需要语义相似、符号执行、逻辑过滤还是局部图遍历。

  • 缺少 failed search signal:semantic backend 即使找不到目标证据,也会返回相似段落,可能鼓励 LLM 编造;显式逻辑检索失败反而更容易让模型拒答。

方法与机制

1. Agentic Loop:把检索看作接口控制问题

输入是问题 $q$、语料 $C$、检索接口 $I$ 和 LLM agent $\pi_\theta$。每一轮 agent 观察已有证据和历史动作:

h_t=(q,a_{<t},R_{<t})

其中 $a_{<t}$ 是历史检索动作,$R_{<t}$ 是历史返回结果。agent 选择下一步:

a_t \sim \pi_\theta(\cdot \mid h_t)

$a_t$ 可以是继续检索,也可以是最终回答 / 拒答。本文的核心不是换更复杂的后端,而是改变动作空间:

a_t \in \mathcal{A}_{logic}

让 agent 能显式执行 broaden、narrow、exclude、exact phrase、field targeting 和 one-hop-at-a-time search。

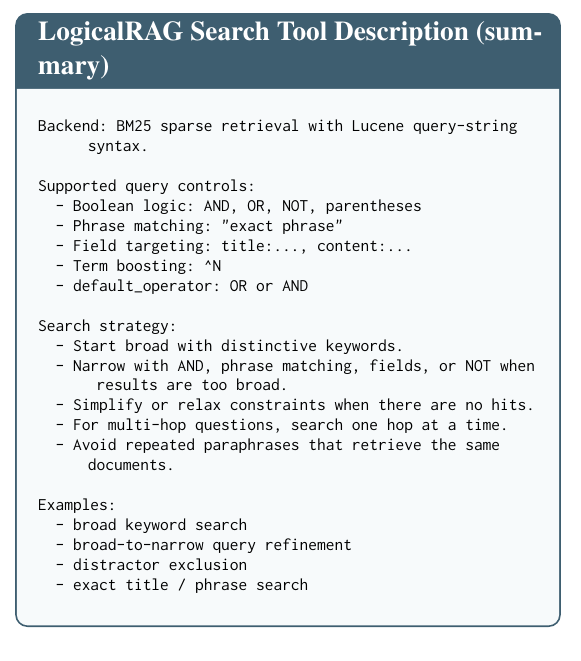
2. LogicalRAG Search Tool:给 LLM 一个可执行逻辑查询接口

输入是 LLM 生成的 Lucene-style query-string,例如:

(Manuel AND Díaz AND Rodríguez) AND NOT Juan
title:"Mona Tyndall" birth date

检索接口支持:

  • Boolean logic:AND / OR / NOT / parentheses
  • Phrase matching:"exact phrase"
  • Field targeting:title:...、content:...
  • Term boosting:^N
  • Default operator:OR 或 AND

这使 agent 可以从宽松关键词开始,再根据失败反馈逐步收紧:

Q_1 \rightarrow Q_2 \rightarrow \cdots \rightarrow Q_T

其中每次 $Q_t$ 的修改都应直接改变候选集合,而不是只在 latent semantic space 中产生相近 query embedding。

3. Candidate Filtering:逻辑约束先决定“谁有资格被取回”

倒排索引把语料表示为 term 到 document 的映射:

\mathcal{I}: term \mapsto \{d_i \in C\}

给定逻辑查询 $Q_t$,系统先按词项、短语、字段和布尔表达式求候选集:

D_t = Exec(Q_t,\mathcal{I})

例如:

Exec(A \;AND\; B)=Post(A)\cap Post(B)
Exec(A \;OR\; B)=Post(A)\cup Post(B)
Exec(A \;AND\; NOT\; B)=Post(A)\setminus Post(B)

这里的关键是:逻辑约束控制可检索集合 $D_t$,而不是只改变排序分数。

4. BM25 Ranking:只在满足逻辑约束的候选内排序

候选集确定后,LogicalRAG 用 BM25 对 $D_t$ 内的文档排序:

score(d,Q_t)=\sum_{w\in Q_t} IDF(w)\cdot \frac{tf(w,d)(k_1+1)} {tf(w,d)+k_1(1-b+b\cdot |d|/avgdl)}

输出 top-$k$:

R_t=TopK_{d\in D_t} score(d,Q_t)

因此 LogicalRAG 的职责分离很清楚:

  • logical query 决定 candidate eligibility;
  • BM25 决定 eligible candidates 的相对排序;
  • LLM 根据返回结果决定下一轮 broaden / narrow / exclude / answer / refuse。

5. Query Repair:用低重叠和高恢复率衡量多轮修复能力

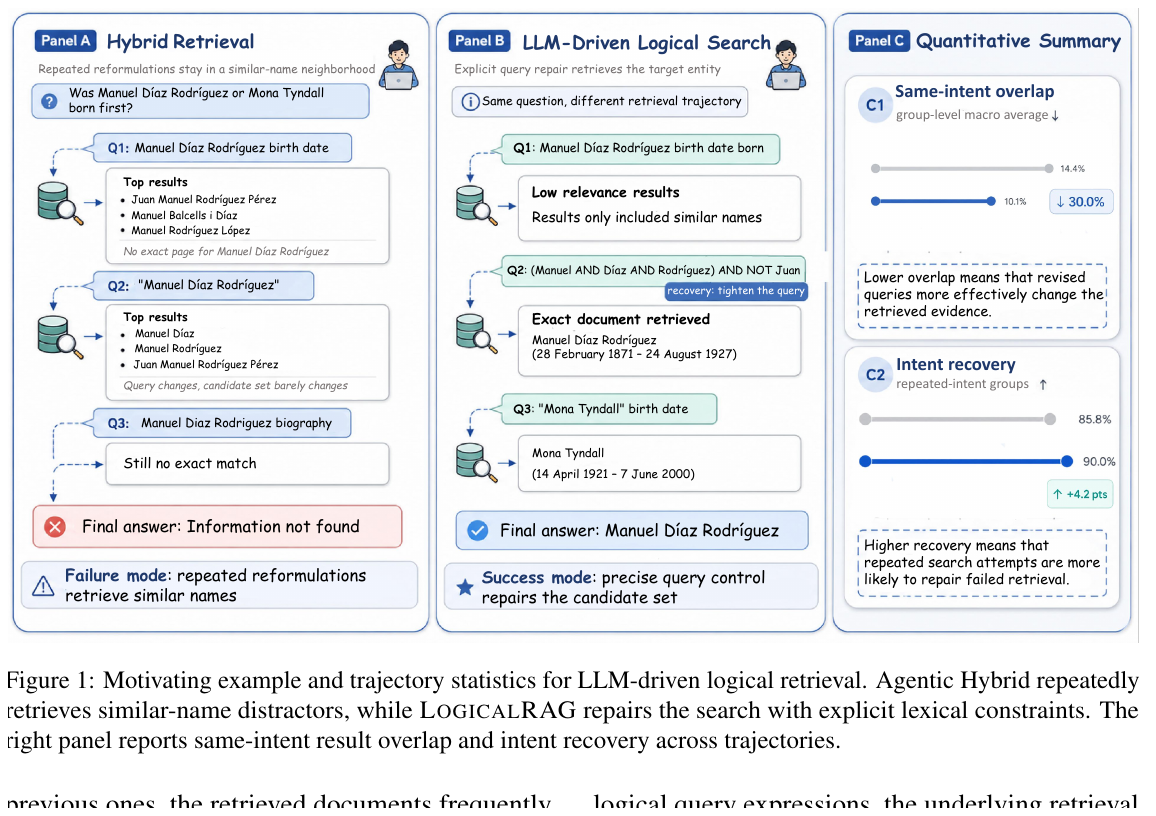
Figure 1 展示典型失败与修复:Agentic Hybrid 多次改写 “Manuel Díaz Rodríguez” 仍返回相似姓名干扰项;LogicalRAG 用 AND NOT Juan 收紧候选集,取回目标实体,再检索 Mona Tyndall 生日并完成比较。

论文用两个轨迹指标衡量 agentic query repair:

Same-intent overlap:对同一检索意图下相邻两次检索结果计算 top-$K$ 重叠:

Overlap(R_t,R_{t+1})=\frac{|R_t^{K}\cap R_{t+1}^{K}|}{K}

然后对同一 intent group 求平均。越低说明改写 query 后真正改变了 evidence set。

Intent recovery:如果某个 intent 的首次检索失败,后续同 intent 检索至少一次成功,则记为 recovered:

Recovery=\frac{\#\{g: first(g)=fail \land \exists t\in g, success(t)\}}{\#\{g: first(g)=fail\}}

Figure 1 右侧显示 LogicalRAG 的 same-intent overlap 更低,intent recovery 更高,说明逻辑查询更适合修复失败检索。

6. Controlled Baseline:只换 retrieval action space

论文把 LogicalRAG 和 Agentic Hybrid 放在同一个轻量 agent loop 中比较:

System = AgentLoop(\pi_\theta, Tool)

两者区别仅在 tool:

$$

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

1. Main Results:LogicalRAG 在大规模 KILT 上接近 Agentic Hybrid

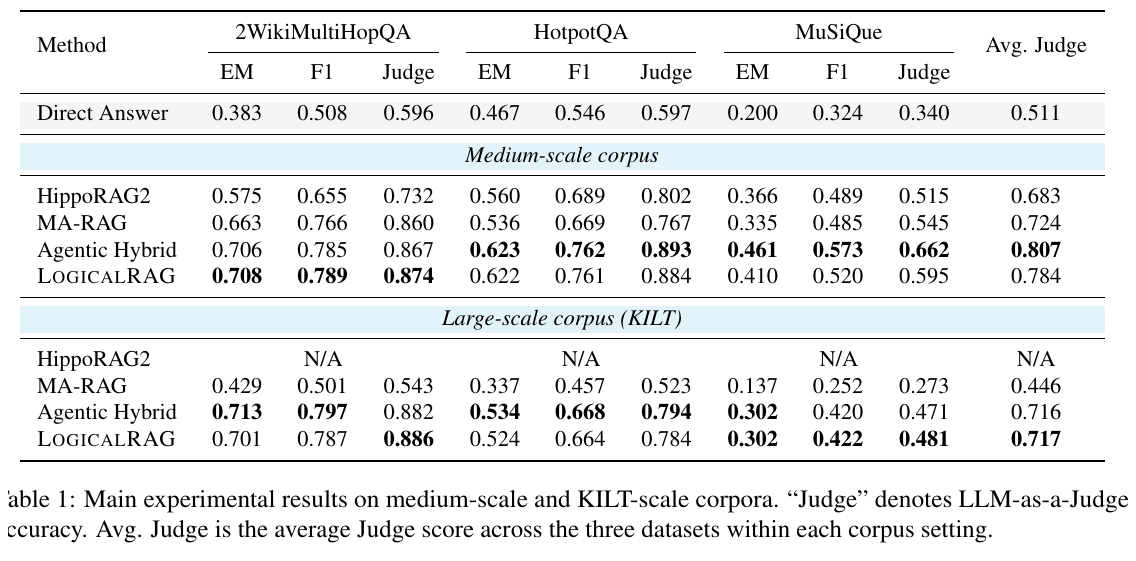
Table 1 比较 Direct Answer、HippoRAG2、MA-RAG、Agentic Hybrid 和 LogicalRAG:

  • Medium-scale:LogicalRAG 在 2WikiMultiHopQA 上略高于 Agentic Hybrid,Judge 为 0.874 vs 0.867;HotpotQA 和 MuSiQue 上 Agentic Hybrid 更强。
  • KILT-scale:LogicalRAG Avg. Judge 为 0.717,Agentic Hybrid 为 0.716,基本持平。
  • Graph-based HippoRAG2 没有在 KILT-scale 上评估,因为语料级图构建成本过高。

解读:如果任务允许 LLM 分多轮表达明确检索意图,轻量逻辑接口可以在开放域大语料上接近 hybrid backend,不一定需要默认上 graph construction 或 dense index。

2. Construction Cost:倒排索引比 hybrid 和 graph backend 低得多

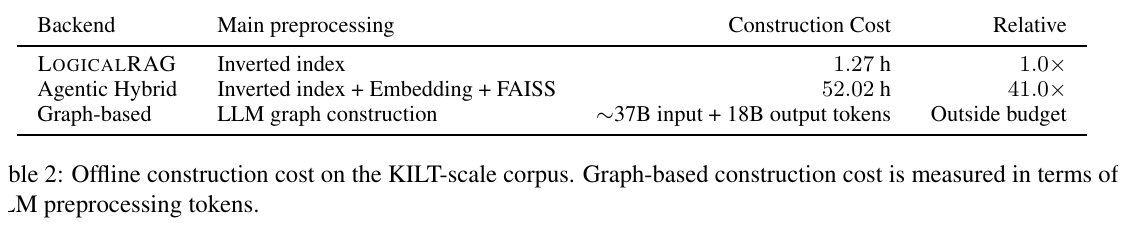
Table 2 显示 KILT-scale offline construction cost:

  • LogicalRAG:只建 inverted index,1.27 h。
  • Agentic Hybrid:inverted index + embedding + FAISS,52.02 h,约 41.0x。
  • Graph-based:估算需要约 37B input tokens + 18B output tokens 做 LLM graph construction,超出预算。

解读:这篇论文对 GraphRAG 的直接提醒是,图构建成本必须被纳入 query-interface routing。不是所有 multi-hop QA 都值得先付语料级图构建成本。

3. Online Efficiency:吞吐更高、延迟更低

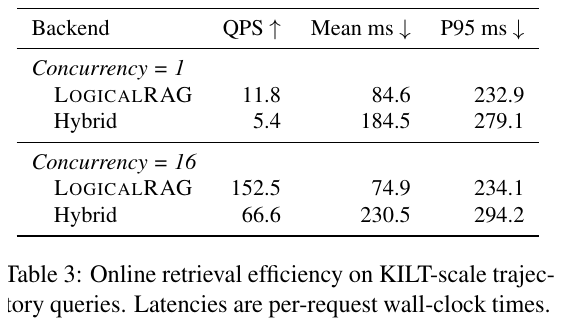
Table 3 显示在线检索效率:

  • Concurrency = 16 时,LogicalRAG QPS 152.5,Hybrid QPS 66.6。
  • LogicalRAG mean latency 74.9 ms,Hybrid 230.5 ms。
  • 这对应约 2.3x throughput 和 3.1x lower mean latency。

注意:这不是因为 LogicalRAG 少检索。论文报告 LogicalRAG 平均 3.77 search turns / question,Agentic Hybrid 为 3.55。收益主要来自每次检索调用更轻。

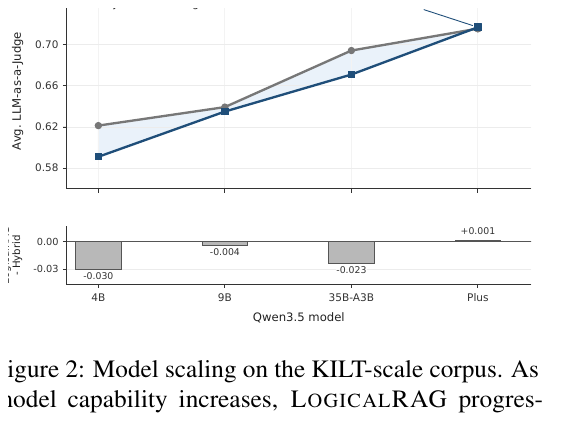
4. Model Scaling:强 agent 才能充分利用高控制接口

Figure 2 显示随着 Qwen3.5 模型能力增强,LogicalRAG 与 Agentic Hybrid 的 Judge gap 缩小:

  • 4B:LogicalRAG 低约 0.030。
  • 9B:gap 约 -0.004。
  • 35B-A3B:gap 约 -0.023。
  • Plus:LogicalRAG 略高 +0.001。

解读:逻辑检索不是无条件替代 dense / hybrid retrieval。弱 agent 可能不会写好约束,仍需要 semantic smoothing;强 agent 才能把推理意图稳定转成可执行 query。

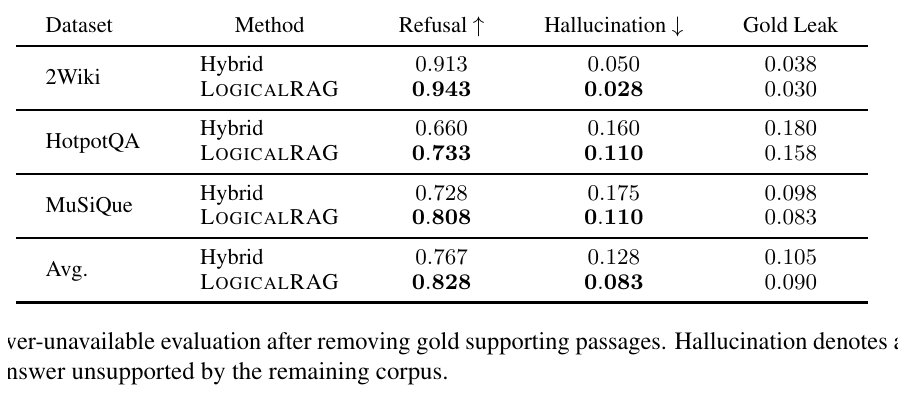
5. Answer-Unavailable:逻辑失败信号降低幻觉

Table 4 在移除 gold supporting passages 后评估拒答与幻觉:

  • 平均 refusal:Hybrid 0.767,LogicalRAG 0.828。
  • 平均 hallucination:Hybrid 0.128,LogicalRAG 0.083。
  • 2Wiki、HotpotQA、MuSiQue 三个数据集上 LogicalRAG 的 refusal 更高,hallucination 更低。

解读:显式逻辑约束多次失败时,agent 更容易判断“证据缺失”。Hybrid 检索仍可能返回语义相关但不支持答案的段落,反而增加 unsupported answer。

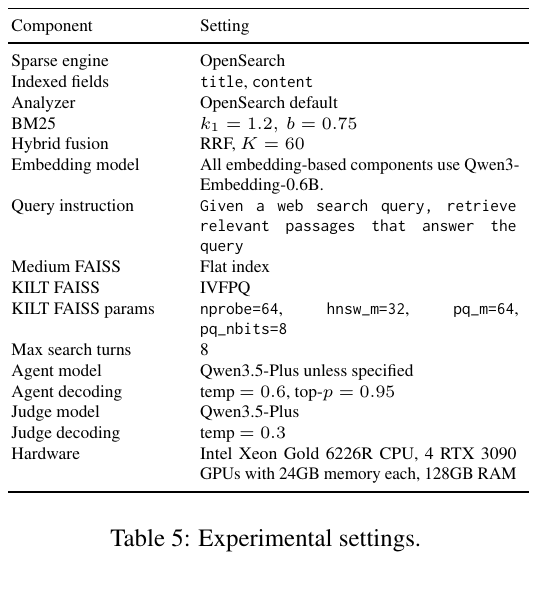
6. Experimental Settings:复现边界

Table 5 的关键设置:

  • Sparse engine:OpenSearch。
  • Indexed fields:title, content。
  • BM25:$k_1=1.2, b=0.75$。
  • Hybrid fusion:RRF, $K=60$。
  • Embedding model:Qwen3-Embedding-0.6B。
  • Max search turns:8。
  • Agent / Judge:Qwen3.5-Plus unless specified。

解读:LogicalRAG 的结论依赖一个可用的倒排检索基础设施和较强 agent。它不是“关键词检索万能”,而是“强 agent + 可控逻辑接口 + 标准倒排索引”的组合。

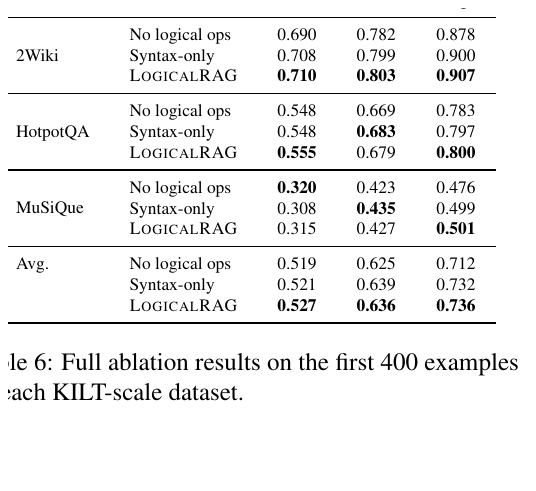
7. Ablation:逻辑操作符有贡献,prompt 不是唯一来源

Table 6 做两个轻量消融:

  • No logical ops:禁用 AND / OR / NOT,保留关键词和短语查询。
  • Syntax-only:保留 query grammar,但移除 BM25 解释和策略提示。

平均 Judge:

  • No logical ops:0.712。
  • Syntax-only:0.732。
  • LogicalRAG:0.736。

解读:Boolean operators 有稳定收益;但 syntax-only 接近完整 LogicalRAG,说明主要收益来自可执行语法本身,而不是长 prompt 说明。

局限与开放问题

  • 依赖 LLM 写出正确逻辑查询:如果 agent 识别错实体、约束、别名或关系词,检索质量会下降。

  • 对抽象语义匹配不一定强:当问题需要 fuzzy association、paraphrase-heavy retrieval 或概念相似时,embedding retrieval 仍可能更稳。

  • 主要验证文本检索:论文没有扩展到多模态、动态图更新或复杂结构化数据库执行。

  • Graph backend 没有在 KILT-scale 直接实测:graph-based 成本是基于语料级 LLM graph construction 估算,结论更适合成本边界讨论,不应解读为所有 GraphRAG 在所有规模上都不可行。

  • 缺少官方代码:当前只能根据论文设置复现 LogicalRAG,不方便直接运行作者实现。

  • Query interface routing 尚未解决:论文证明 logical retrieval 可行,但没有系统判断何时该用 logical、dense、graph、symbolic SQL/SPARQL 或 hybrid tool set。

  • 做 graph-interface router:先判断 query 走 logical lexical search、semantic retrieval、symbolic execution、graph traversal 还是 hybrid fallback。

  • 把 LogicalRAG 和 DualGraph - Symbolic Querying and Semantic Retrieval for Semi-Structured QA 对齐:LogicalRAG 是文本倒排上的逻辑控制,DualGraph 是半结构化图上的 symbolic execution;两者可组成从 lexical logic 到 schema logic 的连续谱。

  • 和 QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples 结合:评估 AND / OR / NOT 是否真的保留 intersection、join、comparison、aggregation 等 query operators。

  • 和 DOTRAG - Retrieval-Time Reasoning Along Paths 对照:DOTRAG 把 path 当检索对象,LogicalRAG 把 logical expression 当检索动作;两者都说明 retrieval stage 本身正在承担 reasoning。

  • 做 hallucination-aware fallback:当 logical queries 连续失败时,优先触发拒答、降级到 semantic search,或要求用户补充实体约束。

  • 做成本路由:当 inverted index 已足够时避免 dense embedding / graph construction;只有 query 需要结构路径、时间关系、表格公式绑定或多模态 grounding 时再升级。

关联与拓展

  • 2026-06-09-Paper-Pool:第三批 P0 候选,已从摘要级提升到 PDF级。
  • 2026-06-09-Trend-Report:把 LLM-driven logical retrieval 从摘要信号提升为 PDF级证据。
  • 2026-06-09-Open-Problems OP-11:可扩展 graph interface routing、retrieval-operator routing 和 query execution log schema。
  • GraphRAG研究地图:应归入“语义检索何时不够,什么时候要查询执行”和“什么时候需要图,什么时候扁平检索够用”。
  • GraphRAG研究工作流索引:应进入“查询算子保持与执行式检索”和“是否需要图、需要哪种图接口”。

相关 Paper Cards:

相关理论笔记:

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:Rethinking Agentic RAG: Toward LLM-Driven Logical Retrieval Beyond Embeddings
  • 中文标题:重新思考 Agentic RAG:走向超越嵌入的 LLM 驱动逻辑检索
  • 方法名:LogicalRAG
  • 作者:Yuqi Zeng, Qixiang Deng, Yulei Wan, Ruiquan Jiang, Xiaoqing Zheng, Xuanjing Huang
  • 机构:Fudan University; Shanghai Kingstar Software Technology Co., Ltd.
  • 年份:2026
  • 版本:arXiv v1,2026-05-26
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:论文正文和 arXiv 页面未给出 LogicalRAG 官方代码链接;正文仅引用 OpenSearch 作为检索引擎依赖。
  • 阅读状态:PDF级
  • 所属方向:Agentic RAG、logical retrieval、query execution、graph interface routing、cost-efficient retrieval
  • 优先级:P0

Background

  • 研究问题:Agentic RAG 已经从单次检索变成多轮 plan -> retrieve -> observe -> revise -> answer。当 LLM 能逐步改写检索意图时,系统瓶颈不一定是更复杂的 dense / hybrid / graph backend,而可能是检索接口是否能忠实执行 LLM 给出的结构化意图。
  • 为什么重要:embedding retrieval 擅长语义相似,但对专名、罕见实体、排除条件和精确词组不够可控;GraphRAG 能组织多跳结构,但大规模图构建和维护成本高。本文提出一个反向设计:让 LLM 做“重脑”,把检索后端降为可执行逻辑约束的“精确手”。
  • 对本知识库的意义:这篇论文把 GraphRAG中的图接口选择与任务类型、Query Execution 与 Retrieval 的区别 和 OP-11 进一步推向 agentic 场景:不是所有复杂问答都要先建重图;有些问题更需要一个可控、可修复、低成本的逻辑检索接口。

Gap

  • Agentic Hybrid 的 query repair 不够有效:自然语言 query 小幅改写后,在 embedding / hybrid 空间中仍可能返回高度重叠的候选,导致多轮检索只是反复取相似干扰项。
  • 复杂后端成本高:dense / hybrid 需要 corpus-wide embedding 和向量索引;graph-based retrieval 还需要实体关系抽取、图构建和持续更新。
  • 图接口被过度默认:很多系统把 graph / dense / sparse 都称为 retrieval,没有先判断 query 到底需要语义相似、符号执行、逻辑过滤还是局部图遍历。
  • 缺少 failed search signal:semantic backend 即使找不到目标证据,也会返回相似段落,可能鼓励 LLM 编造;显式逻辑检索失败反而更容易让模型拒答。

Insight

  • 一句话创新点:LogicalRAG 让 LLM 用 Boolean logic、phrase matching、field targeting 和 matching granularity 表达检索意图,再用倒排索引忠实执行候选过滤,用 BM25 只负责候选集内排序。
  • 核心洞察:
    • Agentic RAG 的检索能力来自“能否改变 candidate set”,不只是单轮 top-k relevance。
    • LLM 越强,越能利用高控制度接口,把推理中的缺口转成精确逻辑查询。
    • 对大规模文本语料,倒排索引 + 逻辑约束可能在答案质量上接近 hybrid retrieval,但 construction / serving cost 明显更低。
    • 失败的逻辑查询是有用信号:多轮都无法满足显式约束时,系统更容易判断证据缺失并拒答。

Method

1. Agentic Loop:把检索看作接口控制问题

输入是问题 $q$、语料 $C$、检索接口 $I$ 和 LLM agent $\pi_\theta$。每一轮 agent 观察已有证据和历史动作:

h_t=(q,a_{<t},R_{<t})

其中 $a_{<t}$ 是历史检索动作,$R_{<t}$ 是历史返回结果。agent 选择下一步:

a_t \sim \pi_\theta(\cdot \mid h_t)

$a_t$ 可以是继续检索,也可以是最终回答 / 拒答。本文的核心不是换更复杂的后端,而是改变动作空间:

a_t \in \mathcal{A}_{logic}

让 agent 能显式执行 broaden、narrow、exclude、exact phrase、field targeting 和 one-hop-at-a-time search。

2. LogicalRAG Search Tool:给 LLM 一个可执行逻辑查询接口

Rethinking-Agentic-RAG-logical-search-tool

输入是 LLM 生成的 Lucene-style query-string,例如:

(Manuel AND Díaz AND Rodríguez) AND NOT Juan
title:"Mona Tyndall" birth date

检索接口支持:

  • Boolean logic:AND / OR / NOT / parentheses
  • Phrase matching:"exact phrase"
  • Field targeting:title:...、content:...
  • Term boosting:^N
  • Default operator:OR 或 AND

这使 agent 可以从宽松关键词开始,再根据失败反馈逐步收紧:

Q_1 \rightarrow Q_2 \rightarrow \cdots \rightarrow Q_T

其中每次 $Q_t$ 的修改都应直接改变候选集合,而不是只在 latent semantic space 中产生相近 query embedding。

3. Candidate Filtering:逻辑约束先决定“谁有资格被取回”

倒排索引把语料表示为 term 到 document 的映射:

\mathcal{I}: term \mapsto \{d_i \in C\}

给定逻辑查询 $Q_t$,系统先按词项、短语、字段和布尔表达式求候选集:

D_t = Exec(Q_t,\mathcal{I})

例如:

Exec(A \;AND\; B)=Post(A)\cap Post(B)
Exec(A \;OR\; B)=Post(A)\cup Post(B)
Exec(A \;AND\; NOT\; B)=Post(A)\setminus Post(B)

这里的关键是:逻辑约束控制可检索集合 $D_t$,而不是只改变排序分数。

4. BM25 Ranking:只在满足逻辑约束的候选内排序

候选集确定后,LogicalRAG 用 BM25 对 $D_t$ 内的文档排序:

score(d,Q_t)=\sum_{w\in Q_t} IDF(w)\cdot \frac{tf(w,d)(k_1+1)} {tf(w,d)+k_1(1-b+b\cdot |d|/avgdl)}

输出 top-$k$:

R_t=TopK_{d\in D_t} score(d,Q_t)

因此 LogicalRAG 的职责分离很清楚:

  • logical query 决定 candidate eligibility;
  • BM25 决定 eligible candidates 的相对排序;
  • LLM 根据返回结果决定下一轮 broaden / narrow / exclude / answer / refuse。

5. Query Repair:用低重叠和高恢复率衡量多轮修复能力

Rethinking-Agentic-RAG-fig1-logical-retrieval-motivation

Figure 1 展示典型失败与修复:Agentic Hybrid 多次改写 “Manuel Díaz Rodríguez” 仍返回相似姓名干扰项;LogicalRAG 用 AND NOT Juan 收紧候选集,取回目标实体,再检索 Mona Tyndall 生日并完成比较。

论文用两个轨迹指标衡量 agentic query repair:

Same-intent overlap:对同一检索意图下相邻两次检索结果计算 top-$K$ 重叠:

Overlap(R_t,R_{t+1})=\frac{|R_t^{K}\cap R_{t+1}^{K}|}{K}

然后对同一 intent group 求平均。越低说明改写 query 后真正改变了 evidence set。

Intent recovery:如果某个 intent 的首次检索失败,后续同 intent 检索至少一次成功,则记为 recovered:

Recovery=\frac{\#\{g: first(g)=fail \land \exists t\in g, success(t)\}}{\#\{g: first(g)=fail\}}

Figure 1 右侧显示 LogicalRAG 的 same-intent overlap 更低,intent recovery 更高,说明逻辑查询更适合修复失败检索。

6. Controlled Baseline:只换 retrieval action space

论文把 LogicalRAG 和 Agentic Hybrid 放在同一个轻量 agent loop 中比较:

System = AgentLoop(\pi_\theta, Tool)

两者区别仅在 tool:

Tool_{logical}=Exec(Q_{logic},\mathcal{I}) + BM25
Tool_{hybrid}=RRF(BM25(q),Dense(q))

其中 hybrid 用 BM25 sparse retrieval、dense retrieval 和 reciprocal rank fusion:

RRF(d)=\sum_{r\in \mathcal{R}}\frac{1}{K+r(d)}

这个控制设计很重要:它把收益归因到 action space / interface control,而不是归因到更复杂的 planner、reranker 或 memory compression。

Results

1. Main Results:LogicalRAG 在大规模 KILT 上接近 Agentic Hybrid

Rethinking-Agentic-RAG-table1-main-results

Table 1 比较 Direct Answer、HippoRAG2、MA-RAG、Agentic Hybrid 和 LogicalRAG:

  • Medium-scale:LogicalRAG 在 2WikiMultiHopQA 上略高于 Agentic Hybrid,Judge 为 0.874 vs 0.867;HotpotQA 和 MuSiQue 上 Agentic Hybrid 更强。
  • KILT-scale:LogicalRAG Avg. Judge 为 0.717,Agentic Hybrid 为 0.716,基本持平。
  • Graph-based HippoRAG2 没有在 KILT-scale 上评估,因为语料级图构建成本过高。

解读:如果任务允许 LLM 分多轮表达明确检索意图,轻量逻辑接口可以在开放域大语料上接近 hybrid backend,不一定需要默认上 graph construction 或 dense index。

2. Construction Cost:倒排索引比 hybrid 和 graph backend 低得多

Rethinking-Agentic-RAG-table2-construction-cost

Table 2 显示 KILT-scale offline construction cost:

  • LogicalRAG:只建 inverted index,1.27 h。
  • Agentic Hybrid:inverted index + embedding + FAISS,52.02 h,约 41.0x。
  • Graph-based:估算需要约 37B input tokens + 18B output tokens 做 LLM graph construction,超出预算。

解读:这篇论文对 GraphRAG 的直接提醒是,图构建成本必须被纳入 query-interface routing。不是所有 multi-hop QA 都值得先付语料级图构建成本。

3. Online Efficiency:吞吐更高、延迟更低

Rethinking-Agentic-RAG-table3-online-efficiency

Table 3 显示在线检索效率:

  • Concurrency = 16 时,LogicalRAG QPS 152.5,Hybrid QPS 66.6。
  • LogicalRAG mean latency 74.9 ms,Hybrid 230.5 ms。
  • 这对应约 2.3x throughput 和 3.1x lower mean latency。

注意:这不是因为 LogicalRAG 少检索。论文报告 LogicalRAG 平均 3.77 search turns / question,Agentic Hybrid 为 3.55。收益主要来自每次检索调用更轻。

4. Model Scaling:强 agent 才能充分利用高控制接口

Rethinking-Agentic-RAG-fig2-model-scaling

Figure 2 显示随着 Qwen3.5 模型能力增强,LogicalRAG 与 Agentic Hybrid 的 Judge gap 缩小:

  • 4B:LogicalRAG 低约 0.030。
  • 9B:gap 约 -0.004。
  • 35B-A3B:gap 约 -0.023。
  • Plus:LogicalRAG 略高 +0.001。

解读:逻辑检索不是无条件替代 dense / hybrid retrieval。弱 agent 可能不会写好约束,仍需要 semantic smoothing;强 agent 才能把推理意图稳定转成可执行 query。

5. Answer-Unavailable:逻辑失败信号降低幻觉

Rethinking-Agentic-RAG-table4-answer-unavailable

Table 4 在移除 gold supporting passages 后评估拒答与幻觉:

  • 平均 refusal:Hybrid 0.767,LogicalRAG 0.828。
  • 平均 hallucination:Hybrid 0.128,LogicalRAG 0.083。
  • 2Wiki、HotpotQA、MuSiQue 三个数据集上 LogicalRAG 的 refusal 更高,hallucination 更低。

解读:显式逻辑约束多次失败时,agent 更容易判断“证据缺失”。Hybrid 检索仍可能返回语义相关但不支持答案的段落,反而增加 unsupported answer。

6. Experimental Settings:复现边界

Rethinking-Agentic-RAG-table5-settings

Table 5 的关键设置:

  • Sparse engine:OpenSearch。
  • Indexed fields:title, content。
  • BM25:$k_1=1.2, b=0.75$。
  • Hybrid fusion:RRF, $K=60$。
  • Embedding model:Qwen3-Embedding-0.6B。
  • Max search turns:8。
  • Agent / Judge:Qwen3.5-Plus unless specified。

解读:LogicalRAG 的结论依赖一个可用的倒排检索基础设施和较强 agent。它不是“关键词检索万能”,而是“强 agent + 可控逻辑接口 + 标准倒排索引”的组合。

7. Ablation:逻辑操作符有贡献,prompt 不是唯一来源

Rethinking-Agentic-RAG-table6-ablation

Table 6 做两个轻量消融:

  • No logical ops:禁用 AND / OR / NOT,保留关键词和短语查询。
  • Syntax-only:保留 query grammar,但移除 BM25 解释和策略提示。

平均 Judge:

  • No logical ops:0.712。
  • Syntax-only:0.732。
  • LogicalRAG:0.736。

解读:Boolean operators 有稳定收益;但 syntax-only 接近完整 LogicalRAG,说明主要收益来自可执行语法本身,而不是长 prompt 说明。

Limitations

  • 依赖 LLM 写出正确逻辑查询:如果 agent 识别错实体、约束、别名或关系词,检索质量会下降。
  • 对抽象语义匹配不一定强:当问题需要 fuzzy association、paraphrase-heavy retrieval 或概念相似时,embedding retrieval 仍可能更稳。
  • 主要验证文本检索:论文没有扩展到多模态、动态图更新或复杂结构化数据库执行。
  • Graph backend 没有在 KILT-scale 直接实测:graph-based 成本是基于语料级 LLM graph construction 估算,结论更适合成本边界讨论,不应解读为所有 GraphRAG 在所有规模上都不可行。
  • 缺少官方代码:当前只能根据论文设置复现 LogicalRAG,不方便直接运行作者实现。
  • Query interface routing 尚未解决:论文证明 logical retrieval 可行,但没有系统判断何时该用 logical、dense、graph、symbolic SQL/SPARQL 或 hybrid tool set。

Future Directions

  • 做 graph-interface router:先判断 query 走 logical lexical search、semantic retrieval、symbolic execution、graph traversal 还是 hybrid fallback。
  • 把 LogicalRAG 和 DualGraph - Symbolic Querying and Semantic Retrieval for Semi-Structured QA 对齐:LogicalRAG 是文本倒排上的逻辑控制,DualGraph 是半结构化图上的 symbolic execution;两者可组成从 lexical logic 到 schema logic 的连续谱。
  • 和 QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples 结合:评估 AND / OR / NOT 是否真的保留 intersection、join、comparison、aggregation 等 query operators。
  • 和 DOTRAG - Retrieval-Time Reasoning Along Paths 对照:DOTRAG 把 path 当检索对象,LogicalRAG 把 logical expression 当检索动作;两者都说明 retrieval stage 本身正在承担 reasoning。
  • 做 hallucination-aware fallback:当 logical queries 连续失败时,优先触发拒答、降级到 semantic search,或要求用户补充实体约束。
  • 做成本路由:当 inverted index 已足够时避免 dense embedding / graph construction;只有 query 需要结构路径、时间关系、表格公式绑定或多模态 grounding 时再升级。

与本知识库的连接

  • 2026-06-09-Paper-Pool:第三批 P0 候选,已从摘要级提升到 PDF级。
  • 2026-06-09-Trend-Report:把 LLM-driven logical retrieval 从摘要信号提升为 PDF级证据。
  • 2026-06-09-Open-Problems OP-11:可扩展 graph interface routing、retrieval-operator routing 和 query execution log schema。
  • GraphRAG研究地图:应归入“语义检索何时不够,什么时候要查询执行”和“什么时候需要图,什么时候扁平检索够用”。
  • GraphRAG研究工作流索引:应进入“查询算子保持与执行式检索”和“是否需要图、需要哪种图接口”。

相关 Paper Cards:

相关理论笔记:

一句话定位

Rethinking Agentic RAG / LogicalRAG 证明了一个重要边界:在强 LLM agent 能写出结构化检索意图时,倒排索引上的逻辑查询可以用远低于 dense / graph backend 的成本接近 hybrid RAG,并用显式失败信号降低无证据幻觉。