GGraphRAG 文献图谱自动同步
LIT-55A452A1 · 2025

KG-R1 - Efficient and Transferable Agentic KG-RAG

KG-R1 用一个 LLM agent 替代多模块 KG-RAG workflow,让 agent 通过 schema-agnostic 1-hop KG server 多轮查询,并用 turn reward、retrieval coverage 和 turn-level group-relative advantage 训练可迁移的 KG 交互策略。

PDF 级阅读卡优先级 P0Junhong Lin, Shicheng Liu, Jinyeop Song, Song Wang, Julian Shun, Yada ZhuarXiv preprint
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:KG-RAG 用结构化 KG 降低幻觉并提供可追踪推理路径,但现有 KG-RAG 常由多个 LLM 模块组成,例如 planning、retrieval、verification 和 answering。这样的流程推理成本高,并且容易绑定到特定 KG schema。

  • 为什么重要:真实部署中的 KG 经常跨域、换 schema 或持续更新。如果每个 KG 都需要重写 prompt、重训 semantic parser 或重新设计 SPARQL 模板,KG-RAG 很难变成可复用系统。

  • 现有路线:

  • 对本知识库的意义:KG-R1 把 GraphRAG中的接口-代理-停止决策闭环 里的“接口设计”问题推进到训练层面。它把 KG server 设计成 schema-agnostic 1-hop action interface,再用 turn-level RL 训练一个可迁移的单 agent。

  • 多模块流程成本高:多个 LLM 模块分别做规划、查询、验证和回答,会累积生成 token、延迟和模块间错误传播。

  • Schema 绑定强:SPARQL generation、relation template 或 KG-specific prompt 往往依赖特定 schema,换 KG 后不能直接迁移。

  • 最终答案奖励太粗:只看 Hits@1 或 F1 不能告诉模型每一轮 <kg-query> 是否格式合法、是否返回有效实体、是否覆盖答案相关证据。

  • RL 稳定性不足:普通 PPO 在多轮 KG 交互中容易 reward hacking,例如生成看似合法的“retrieved content”以骗取格式或检索奖励。

  • 部署边界仍存在:方法假设 KG 足够结构化、可查询且 schema 一致;严重噪声或 schema mismatch 会削弱 transferability。

方法与机制

1. 总体框架:single LLM agent + schema-agnostic KG query server

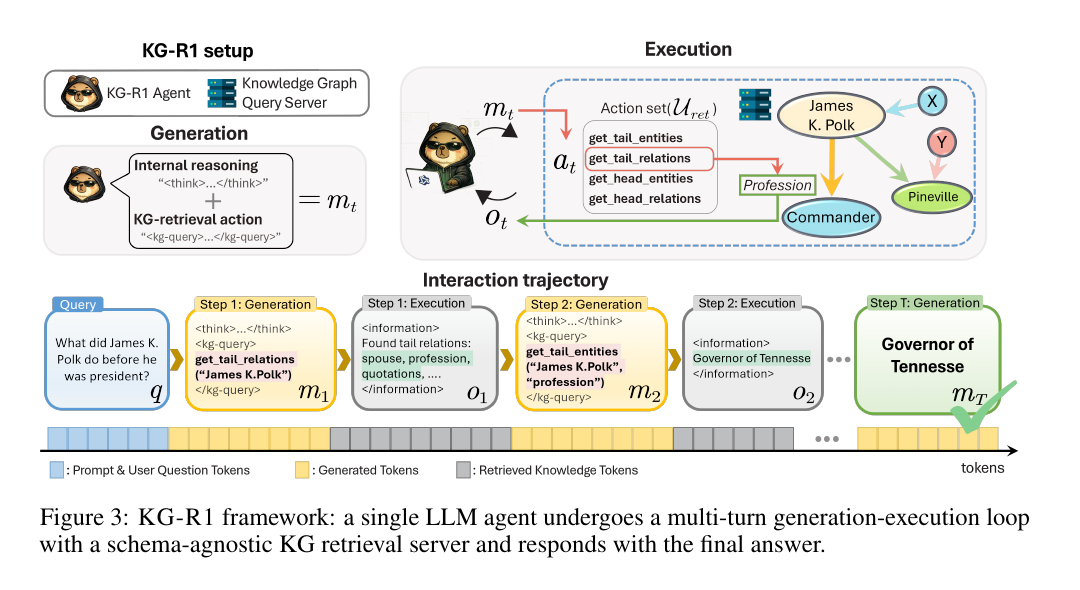
Figure 3 展示 KG-R1 的执行闭环:一个 LLM agent 每轮先在 <think>...</think> 中进行短推理,再输出 <kg-query>...</kg-query> 或 <answer>...</answer>。如果输出 KG query,server 执行动作并把 observation 追加到上下文;如果输出 answer,系统终止并做答案规范化、去重和实体解析。

输入:KGQA 数据集 $D={(q,G,A_q)}$、问题 $q$、有向 KG $G$、最大轮数 $H$、基础策略 $\pi_0$。

计算链路:

  1. 初始化:把问题、最大查询轮数和 KG server instruction 写入 prompt $p$。
  2. 第 $t$ 轮生成:agent 根据上下文生成消息 $m_t$,其中包含 reasoning 和 action:
m_t \sim \pi_\theta(m_t \mid context_t)
  1. 解析执行:精确解析器 $\Psi$ 把 $m_t$ 转为动作 $a_t=\Psi(m_t)$。若 $a_t\in U_{ret}$,server 返回 observation $o_{t+1}$;若 $a_t=Answer$,抽取预测答案集合 $\hat{A}_q$。
  2. 轨迹记录:
\tau=(p,(m_1,o_1),\ldots,(m_t,o_t)),\quad t\le H

输出:一条多轮 KG interaction trajectory,以及最终答案集合 $\hat{A}_q$。

2. KG server action set:用 1-hop 操作实现可迁移图遍历

输入:有向 KG:

G=\{(e,r,e')\mid e,e'\in E,\ r\in R\}

计算链路:server 只暴露四类 schema-agnostic 1-hop 操作:

U_{ret}=\{ get\_tail\_relations,\ get\_head\_relations,\ get\_tail\_entities,\ get\_head\_entities \}

对应语义为:

get\_tail\_relations(e)=\{r\in R\mid \exists e'\in E:(e,r,e')\in G\}
get\_head\_relations(e')=\{r\in R\mid \exists e\in E:(e,r,e')\in G\}
get\_tail\_entities(e,r)=\{e'\in E\mid (e,r,e')\in G\}
get\_head\_entities(r,e')=\{e\in E\mid (e,r,e')\in G\}

论文给出 completeness claim:对任意 reasoning path

Z:e_0\xrightarrow{r_1}e_1\xrightarrow{r_2}\cdots\xrightarrow{r_\ell}e_\ell,\quad e_\ell\in A_q

存在长度至多 $\ell+1$ 的 $U_{ret}$ 动作序列,使输出包含 $e_\ell$。直观上,forward traversal 通过 get_tail_entities(e_{i-1}, r_i) 实现,backward traversal 通过 get_head_entities(r_i, e_i) 实现。

输出:一个不依赖 SPARQL syntax、relation template 或特定 KG schema 的统一 KG 交互接口。

3. Turn reward + global reward:把局部工具调用和最终答案分开打分

输入:第 $t$ 轮消息 $m_t$、解析后的动作 $a_t$、server observation $o_{t+1}$、最终消息 $m_T$、预测答案 $\hat{A}_q$、gold answer set $A_q$。

计算链路:

  1. Turn reward:逐轮检查格式、KG query 和答案一致性。
r_t^{turn}=w_{fmt}v_{fmt}(m_t)+w_{kg}v_{kg}(a_t,o_{t+1})+w_{ans}v_{ans}(m_T)

其中 $v_{fmt}$ 检查 <think> 和 action 格式,$v_{kg}$ 检查 KG query 是否 schema-valid 且非空,$v_{ans}$ 检查最终 answer 格式/一致性。

  1. Global reward:主文使用 binary Hits@1-style answer correctness 和 retrieval coverage:
R_{global}=w_{H1}\cdot H1(\hat{A}_q,A_q)+w_{ret}\cdot v_{ret}

其中 $v_{ret}=1$ 表示沿执行路径检索信息中出现任一 ground-truth answer entity。

  1. Appendix E.3 的记法差异:附录把 episode-level answer term 写成 $w_{F1}\cdot F1(\hat{A}q,A_q)+w{ret}\cdot v_{ret}$。因此这篇论文的 reward 描述存在 H1/F1 记法不一致,读法上应理解为“最终答案质量 + retrieval coverage”的 episode-level signal,具体实验报告以 Hits@1 为主。

输出:既能奖励合法 KG 工具交互,也能奖励最终答案和答案实体覆盖的训练信号。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

1. 主结果:3B 单 agent 在 WebQSP / CWQ 上达到强准确率和较低生成成本

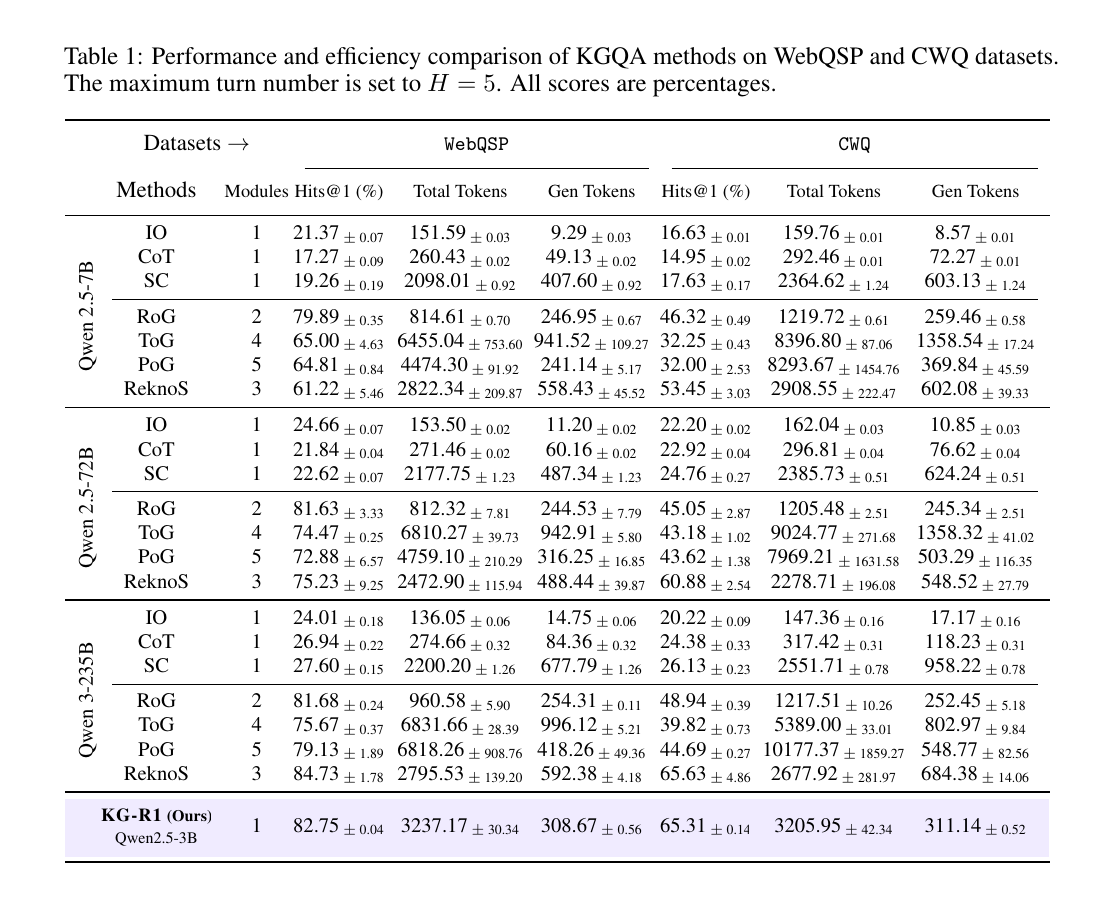
Table 1 显示,KG-R1 使用 Qwen2.5-3B 在 WebQSP 上 Hits@1 = 82.75,在 CWQ 上 Hits@1 = 65.31。WebQSP 上它高于 RoG 的 Qwen2.5-7B / 72B / Qwen3-235B 设置;CWQ 上它接近 ReKnoS Qwen3-235B 的 65.63,同时模型规模小得多。生成 token 方面,KG-R1 在 WebQSP / CWQ 上分别为 308.67 / 311.14,低于 ToG 的 941.52 / 802.97,也低于 ReKnoS 的 592.38 / 684.38。

2. Cross-KG transfer:只换 KG backend 仍能迁移到 Freebase / Wikidata 数据集

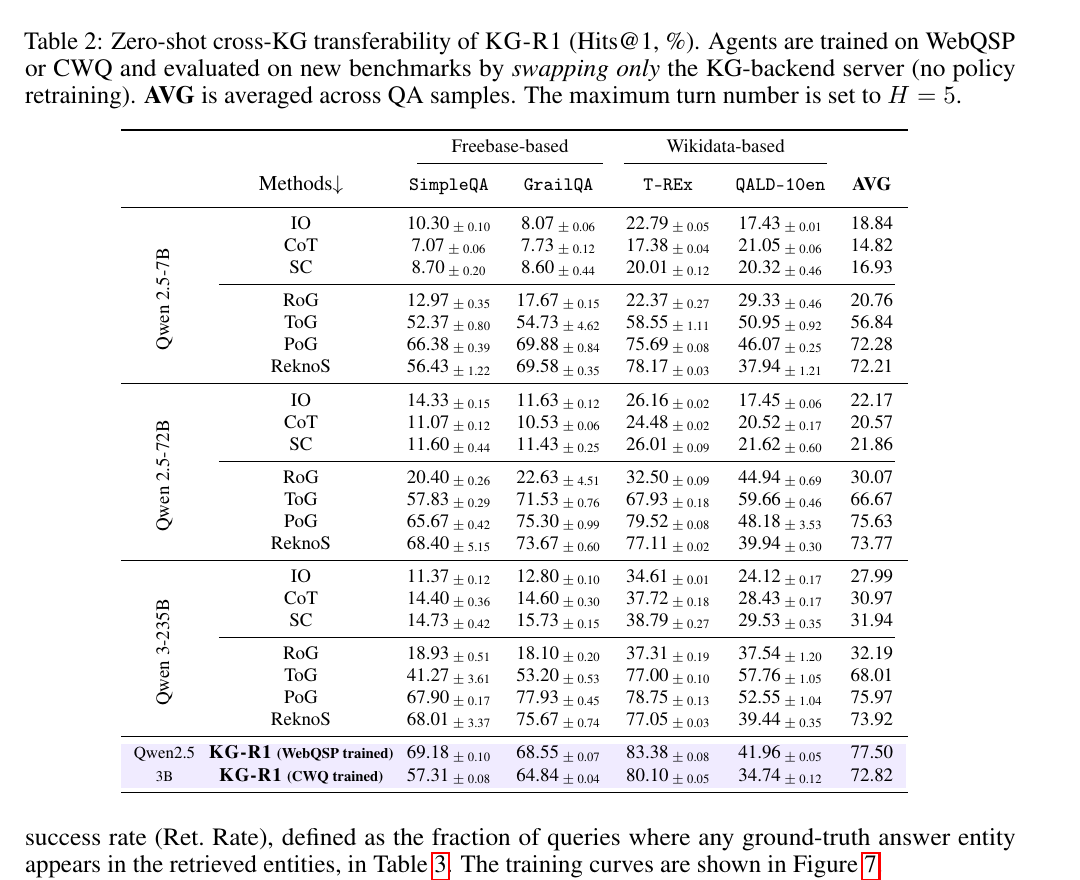
Table 2 的核心证据是 zero-shot transfer:WebQSP-trained KG-R1 在 SimpleQA、GrailQA、T-REx、QALD-10en 上平均 Hits@1 = 77.50;CWQ-trained KG-R1 平均 Hits@1 = 72.82。尤其是 WebQSP-trained KG-R1 高于 ToG / PoG / ReKnoS 的 Qwen3-235B 平均结果 68.01 / 75.97 / 73.92,说明 schema-agnostic action interface 对迁移有实际收益。

3. 消融:turn reward、turn-level advantage 和 retrieval reward 都有必要

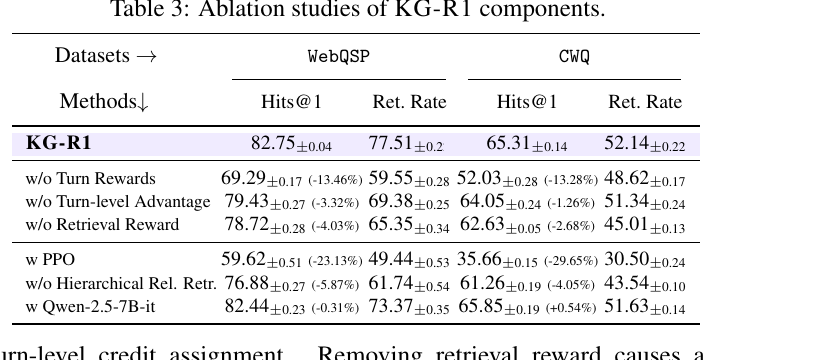
Table 3 显示,去掉 turn rewards 导致最大降幅:WebQSP 从 82.75 降到 69.29,CWQ 从 65.31 降到 52.03。去掉 turn-level advantage 也会下降,说明多轮 KG 交互需要细粒度 credit assignment。去掉 retrieval reward 后 Hits@1 降幅较小,但 Ret. Rate 明显降低,说明该项主要改善答案实体覆盖和探索质量。PPO 版本退化最严重,论文解释为 PPO 容易让 agent 伪造 retrieved content 以获得 reward。

4. 延迟和吞吐:适合单 H100 离线批处理,但仍不是轻量无成本

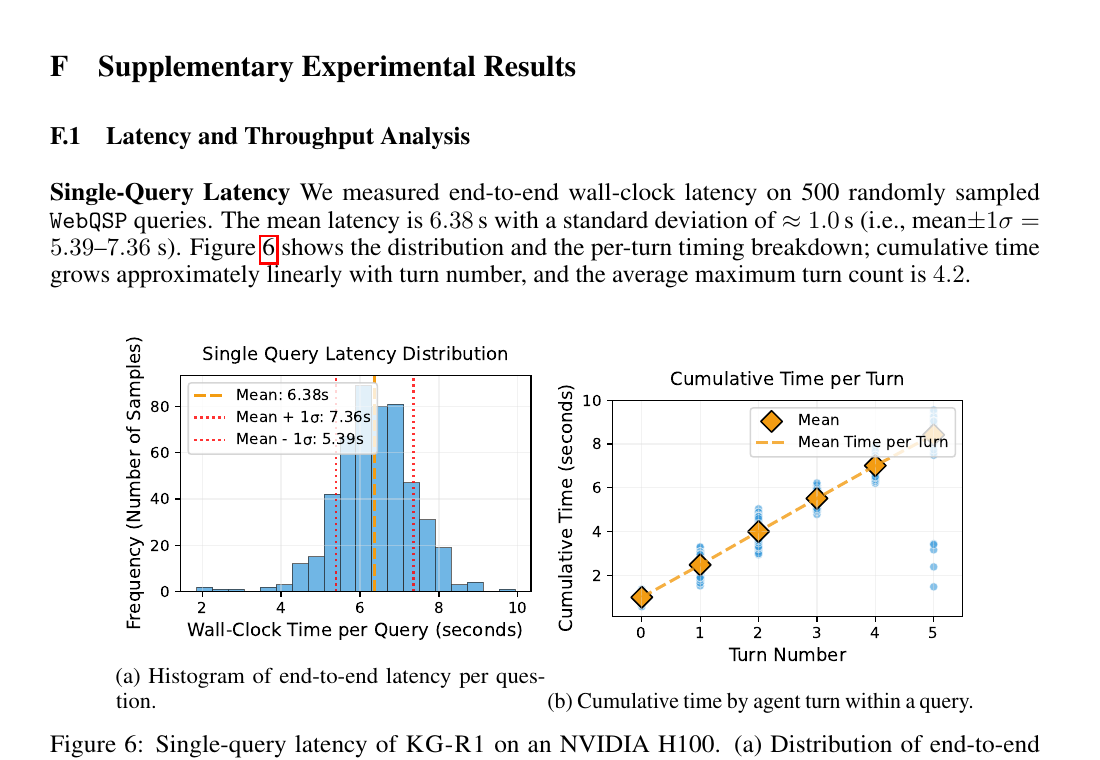
Figure 6 显示 KG-R1 在 500 个 WebQSP queries 上单查询平均延迟为 6.38s,标准差约 1.0s,平均最大 turn count 为 4.2;累计时间随 turn 数近似线性增长。这说明成本主要受查询轮数控制,和 GraphRAG中的接口-代理-停止决策闭环 中的 stop/budget policy 直接相关。

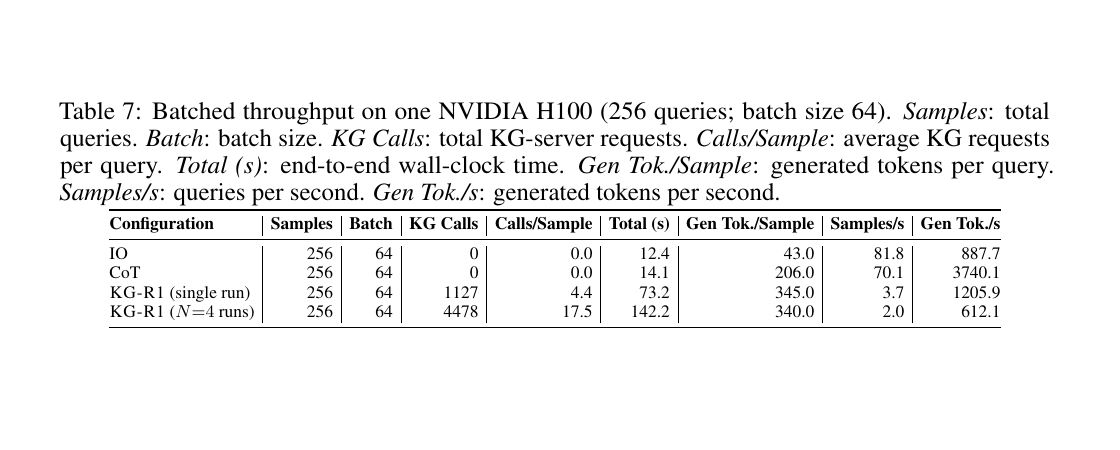
Table 7 显示单 H100、batch size 64、256 queries 下,KG-R1 single run 有 1127 次 KG calls,约 4.4 calls/sample,总时间 73.2s,吞吐 3.7 samples/s。相比 IO / CoT 的 81.8 / 70.1 samples/s,它明显更慢;相比多模块 KG-RAG,它的优势在于单 agent 和较少生成 token,而不是零成本。

5. 案例:agent 能显式查询关系、取实体并做验证

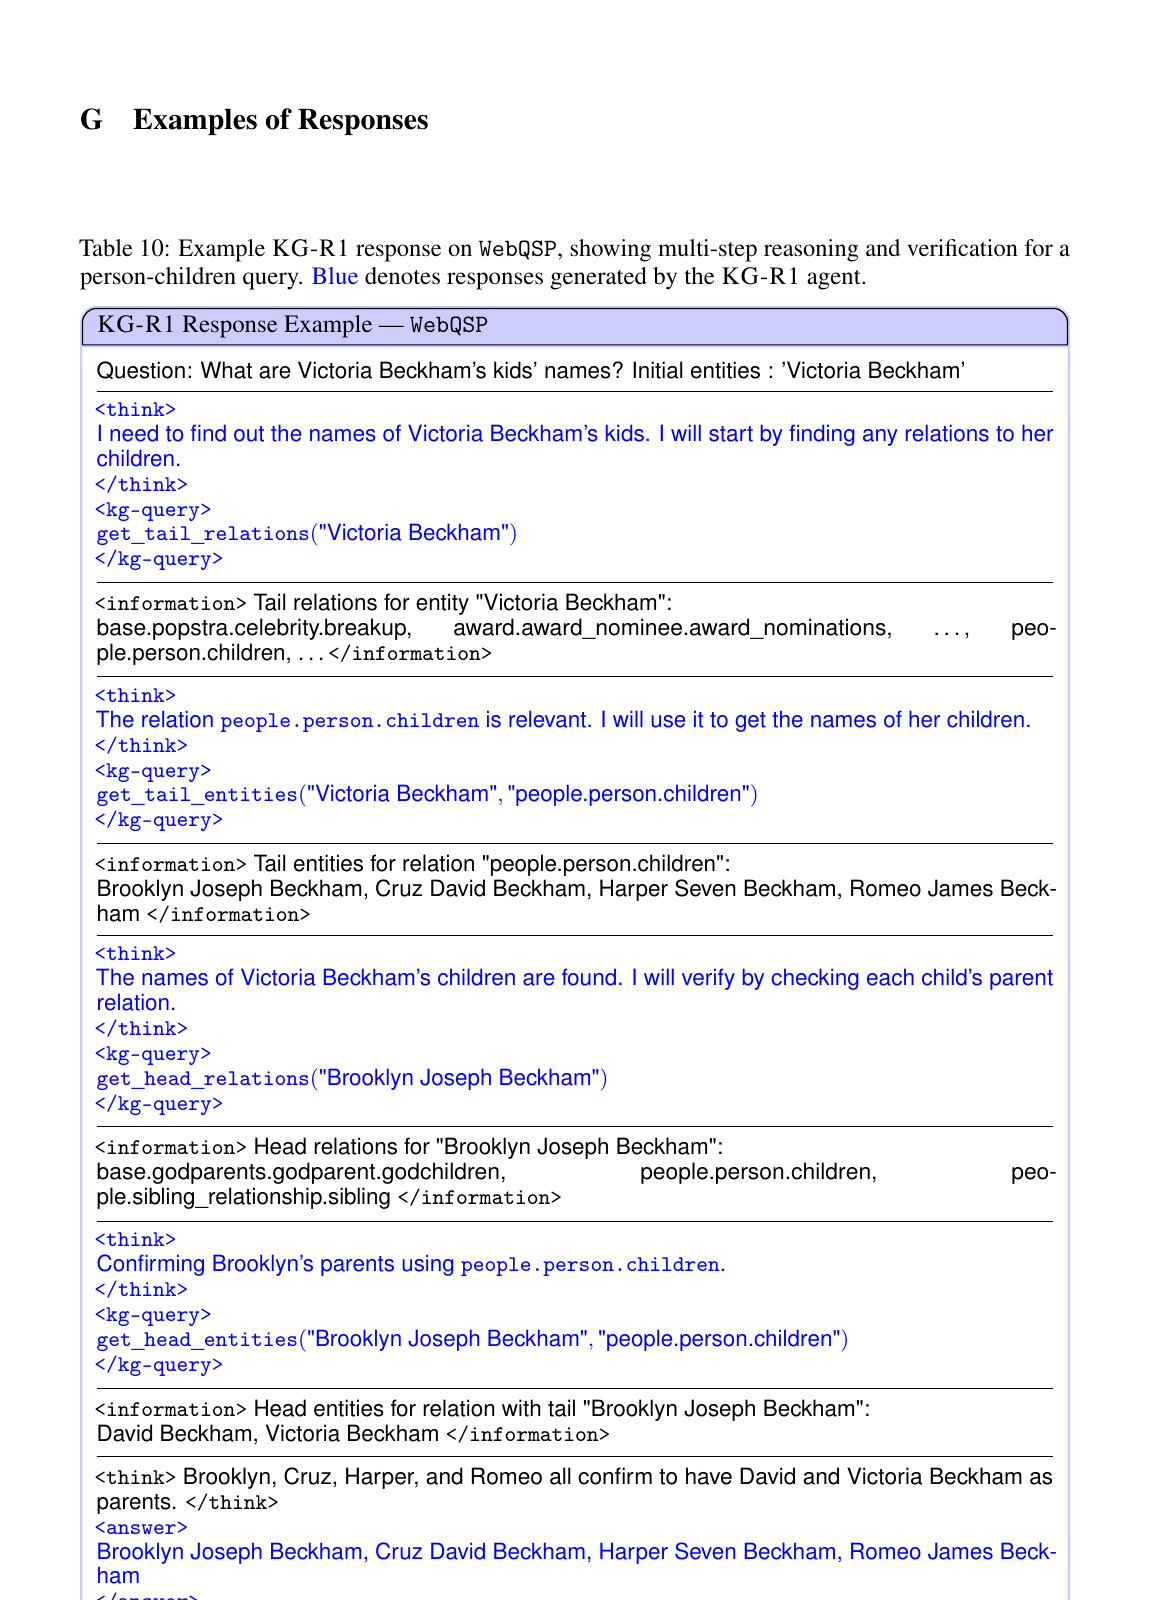
Table 10 的 WebQSP 案例中,问题是 Victoria Beckham 的孩子姓名。Agent 先调用 get_tail_relations("Victoria Beckham") 找到 people.person.children,再调用 get_tail_entities 取回四个孩子,随后用 get_head_relations / get_head_entities 验证 parent relation。这个例子说明 KG-R1 的轨迹具备可解释性:每一步查询函数、relation 和返回实体都可检查。

局限与开放问题

  • 依赖结构化 KG:KG-R1 假设 KG 足够结构化且可通过 server 查询;缺少 KG、KG 噪声严重或 schema 不一致时,性能和迁移性都会下降。

  • Schema-agnostic 不等于 schema-blind:动作接口统一,但 agent 仍要从自然语言和 relation strings 中判断该选哪个 relation;极端 schema mismatch 或 relation 命名混乱会削弱路径搜索。

  • RL 训练成本高:推理端使用 3B 模型较经济,但训练仍需要多 rollout、GRPO、4 张 H100 和 400 steps,相比 SFT 更昂贵。

  • 检索轮数带来延迟:平均 4.4 KG calls/sample 可接受,但交互式场景仍需要 stop policy、cache 或 routing。

  • Reward hacking 风险真实存在:PPO 消融显示 agent 可能伪造 retrieved content,说明 KG-RAG RL 需要严格区分模型生成 token 和 server observation,并记录工具调用日志。

  • 案例中仍有 over-include 风险:Table 11 的 CWQ 例子预测了多个电影候选,而 ground truth 只有 Goal II: Living the Dream,说明多轮图探索可能把 plausible entities 过度并入答案。

  • 训练 schema adapter + action policy:结合 CacheRAG - Semantic Caching for KGQA 的 Backend Adapter,让 KG-R1 的 1-hop action interface 支持更复杂的 typed constraints、aggregation 和 filter。

  • 过程归因评测:把 $v_{kg}$、$v_{ret}$、Ret. Rate、turn utility、invalid query rate、relation ambiguity rate、answer over-include rate 加入 2026-06-09-Open-Problems。

  • Interface routing:对同一问题预测应走 KG-R1 1-hop server、SPARQL execution、Boolean logical retrieval、semantic retrieval 还是 cache-based bounded expansion,对应 2026-06-09-Open-Problems。

  • Reward-hacking 防御:server observation 必须不可由模型伪造,训练日志需区分 generated token、tool call 和 retrieved observation;这可连接 GraphRAG中的Agentic轨迹质量。

  • Cross-KG stress test:在 schema 噪声、relation alias、缺边、实体链接错误和动态 KG 更新下测试 transferability,而不是只看 clean KGQA benchmark。

  • 成本优化:结合 plan cache、early stop 和 retrieval-call budget,把 KG-R1 从 single-agent RL policy 扩展为可部署的 routing + caching + KG execution stack。

关联与拓展

研究问题入口

Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:Efficient and Transferable Agentic Knowledge Graph RAG via Reinforcement Learning
  • 中文标题:KG-R1:通过强化学习实现高效且可迁移的 Agentic KG-RAG
  • 方法名:KG-R1
  • 作者:Junhong Lin, Shicheng Liu, Jinyeop Song, Song Wang, Julian Shun, Yada Zhu
  • 机构:MIT CSAIL, University of Virginia, IBM Research
  • 年份:2025 初版;2026 更新
  • 会议:arXiv preprint
  • 版本:arXiv v5,2026-05-22;初版 2025-09-30。DBLP 等外部缓存可能仍显示 v4 withdrawn 元数据,本卡片以 arXiv v5 和本地 PDF 为主证据。
  • 链接:arXiv
  • DOI:https://doi.org/10.48550/arXiv.2509.26383
  • PDF:查看论文原文
  • 代码链接:https://github.com/junhongmit/KG-R1
  • Semantic Scholar:paperId 0bc3c6728e458bb6da02a73e8d2937e83e56d695;CorpusId 281681324;2026-06-09 title match 显示 citationCount = 3,直接 arXiv lookup 触发 429,待复查。
  • 阅读状态:PDF级
  • 所属方向:Agentic KG-RAG、multi-turn RL、schema-agnostic KG interface、cross-KG transfer、KGQA deployment
  • 优先级:P0

Background

  • 研究问题:KG-RAG 用结构化 KG 降低幻觉并提供可追踪推理路径,但现有 KG-RAG 常由多个 LLM 模块组成,例如 planning、retrieval、verification 和 answering。这样的流程推理成本高,并且容易绑定到特定 KG schema。
  • 为什么重要:真实部署中的 KG 经常跨域、换 schema 或持续更新。如果每个 KG 都需要重写 prompt、重训 semantic parser 或重新设计 SPARQL 模板,KG-RAG 很难变成可复用系统。
  • 现有路线:
  • 对本知识库的意义:KG-R1 把 GraphRAG中的接口-代理-停止决策闭环 里的“接口设计”问题推进到训练层面。它把 KG server 设计成 schema-agnostic 1-hop action interface,再用 turn-level RL 训练一个可迁移的单 agent。

Gap

  • 多模块流程成本高:多个 LLM 模块分别做规划、查询、验证和回答,会累积生成 token、延迟和模块间错误传播。
  • Schema 绑定强:SPARQL generation、relation template 或 KG-specific prompt 往往依赖特定 schema,换 KG 后不能直接迁移。
  • 最终答案奖励太粗:只看 Hits@1 或 F1 不能告诉模型每一轮 <kg-query> 是否格式合法、是否返回有效实体、是否覆盖答案相关证据。
  • RL 稳定性不足:普通 PPO 在多轮 KG 交互中容易 reward hacking,例如生成看似合法的“retrieved content”以骗取格式或检索奖励。
  • 部署边界仍存在:方法假设 KG 足够结构化、可查询且 schema 一致;严重噪声或 schema mismatch 会削弱 transferability。

Insight

  • 一句话创新点:KG-R1 用一个 LLM agent 替代多模块 KG-RAG workflow,让 agent 通过 schema-agnostic 1-hop KG server 多轮查询,并用 turn reward、retrieval coverage 和 turn-level group-relative advantage 训练可迁移的 KG 交互策略。
  • 核心洞察:
    • 可迁移 KG-RAG 的关键不是让模型记住某个 KG schema,而是把不同 KG 统一成一组最小可执行 graph action。
    • 多轮 KG 查询的训练信号必须落到 turn level,分别奖励格式、schema-valid query、非空检索、答案格式和最终覆盖。
    • 单 agent 并不必然比多模块弱;如果接口和奖励设计正确,小模型可以通过 learned retrieval policy 获得更好的准确率/成本折中。

Method

1. 总体框架:single LLM agent + schema-agnostic KG query server

KG-R1-fig3-framework

Figure 3 展示 KG-R1 的执行闭环:一个 LLM agent 每轮先在 <think>...</think> 中进行短推理,再输出 <kg-query>...</kg-query> 或 <answer>...</answer>。如果输出 KG query,server 执行动作并把 observation 追加到上下文;如果输出 answer,系统终止并做答案规范化、去重和实体解析。

输入:KGQA 数据集 $D={(q,G,A_q)}$、问题 $q$、有向 KG $G$、最大轮数 $H$、基础策略 $\pi_0$。

计算链路:

  1. 初始化:把问题、最大查询轮数和 KG server instruction 写入 prompt $p$。
  2. 第 $t$ 轮生成:agent 根据上下文生成消息 $m_t$,其中包含 reasoning 和 action:
m_t \sim \pi_\theta(m_t \mid context_t)
  1. 解析执行:精确解析器 $\Psi$ 把 $m_t$ 转为动作 $a_t=\Psi(m_t)$。若 $a_t\in U_{ret}$,server 返回 observation $o_{t+1}$;若 $a_t=Answer$,抽取预测答案集合 $\hat{A}_q$。
  2. 轨迹记录:
\tau=(p,(m_1,o_1),\ldots,(m_t,o_t)),\quad t\le H

输出:一条多轮 KG interaction trajectory,以及最终答案集合 $\hat{A}_q$。

2. KG server action set:用 1-hop 操作实现可迁移图遍历

输入:有向 KG:

G=\{(e,r,e')\mid e,e'\in E,\ r\in R\}

计算链路:server 只暴露四类 schema-agnostic 1-hop 操作:

U_{ret}=\{ get\_tail\_relations,\ get\_head\_relations,\ get\_tail\_entities,\ get\_head\_entities \}

对应语义为:

get\_tail\_relations(e)=\{r\in R\mid \exists e'\in E:(e,r,e')\in G\}
get\_head\_relations(e')=\{r\in R\mid \exists e\in E:(e,r,e')\in G\}
get\_tail\_entities(e,r)=\{e'\in E\mid (e,r,e')\in G\}
get\_head\_entities(r,e')=\{e\in E\mid (e,r,e')\in G\}

论文给出 completeness claim:对任意 reasoning path

Z:e_0\xrightarrow{r_1}e_1\xrightarrow{r_2}\cdots\xrightarrow{r_\ell}e_\ell,\quad e_\ell\in A_q

存在长度至多 $\ell+1$ 的 $U_{ret}$ 动作序列,使输出包含 $e_\ell$。直观上,forward traversal 通过 get_tail_entities(e_{i-1}, r_i) 实现,backward traversal 通过 get_head_entities(r_i, e_i) 实现。

输出:一个不依赖 SPARQL syntax、relation template 或特定 KG schema 的统一 KG 交互接口。

3. Turn reward + global reward:把局部工具调用和最终答案分开打分

输入:第 $t$ 轮消息 $m_t$、解析后的动作 $a_t$、server observation $o_{t+1}$、最终消息 $m_T$、预测答案 $\hat{A}_q$、gold answer set $A_q$。

计算链路:

  1. Turn reward:逐轮检查格式、KG query 和答案一致性。
r_t^{turn}=w_{fmt}v_{fmt}(m_t)+w_{kg}v_{kg}(a_t,o_{t+1})+w_{ans}v_{ans}(m_T)

其中 $v_{fmt}$ 检查 <think> 和 action 格式,$v_{kg}$ 检查 KG query 是否 schema-valid 且非空,$v_{ans}$ 检查最终 answer 格式/一致性。

  1. Global reward:主文使用 binary Hits@1-style answer correctness 和 retrieval coverage:
R_{global}=w_{H1}\cdot H1(\hat{A}_q,A_q)+w_{ret}\cdot v_{ret}

其中 $v_{ret}=1$ 表示沿执行路径检索信息中出现任一 ground-truth answer entity。

  1. Appendix E.3 的记法差异:附录把 episode-level answer term 写成 $w_{F1}\cdot F1(\hat{A}q,A_q)+w{ret}\cdot v_{ret}$。因此这篇论文的 reward 描述存在 H1/F1 记法不一致,读法上应理解为“最终答案质量 + retrieval coverage”的 episode-level signal,具体实验报告以 Hits@1 为主。

输出:既能奖励合法 KG 工具交互,也能奖励最终答案和答案实体覆盖的训练信号。

4. Turn-level group-relative credit assignment:把 advantage 分配到每轮

输入:同一 query 的 $N$ 条 rollout ${\tau^{(n)}}_{n=1}^{N}$,每条轨迹的 turn reward 和 global reward。

计算链路:

  1. 每轮 return:
G_t^{(n)}=r_t^{turn,(n)}+\lambda R_{global}^{(n)}
  1. 在所有 rollout 的所有 turn 上计算 group baseline:
S=\{(n,t):t\le T^{(n)}\},\quad \bar{G}=\frac{1}{|S|}\sum_{(n,t)\in S}G_t^{(n)}
  1. 标准化 turn-level advantage:
A_t^{(n)}=\frac{G_t^{(n)}-\bar{G}}{\sigma_G+\epsilon}

直观解释:同一个问题下的不同轨迹被放在一起比较;某一轮 query 如果比组内平均更有效,就获得正 advantage。

输出:每个 turn 一个可用于 policy update 的 credit signal。

5. GRPO update:用 turn advantage 更新生成 token

输入:current policy $\pi_\theta$、old policy $\pi_{\theta old}$、reference policy $\pi_0$、token mask $\tilde{m}_{t,i}^{(n)}$、turn advantage $A_t^{(n)}$。

计算链路:

\tilde{A}_{t,i}^{(n)}=\tilde{m}_{t,i}^{(n)}A_t^{(n)}
\rho_{t,i}^{(n)}= \exp\left( \log\pi_\theta(y_{t,i}^{(n)}\mid h_{t,i}^{(n)}) -\log\pi_{\theta old}(y_{t,i}^{(n)}\mid h_{t,i}^{(n)}) \right)

GRPO clipped objective 形式为:

J(\theta)=\mathbb{E}\sum_{n,t,i} \left[ \min\left( \rho_{t,i}^{(n)}\tilde{A}_{t,i}^{(n)}, clip(\rho_{t,i}^{(n)},1-\epsilon,1+\epsilon)\tilde{A}_{t,i}^{(n)} \right) -\beta KL(\pi_\theta(\cdot\mid h_{t,i}^{(n)})\|\pi_0(\cdot\mid h_{t,i}^{(n)})) \right]

输出:一个能在 KG server 上多轮查询、纠错、停止和回答的 KG-RAG policy。

6. Cross-KG transfer:只换 backend KG,不改 policy

输入:在 $D={(q,G,A_q)}$ 上训练好的 policy $\pi_{\theta|D}$,新 KGQA 数据集 $D^*={(q^*,G^*,A_{q^*})}$。

计算链路:

  1. 保持 agent policy、prompt pattern、超参数和模型权重不变。
  2. 把 KG retrieval server 的 backend 从 $G$ 替换成 $G^*$。
  3. 继续使用同一组 $U_{ret}$ 动作执行多轮 KG interaction。

输出:zero-shot plug-and-play transfer 到 unseen KG。该迁移能力来自动作集合的 schema-free 设计,而不是模型学会某个 KG 的特定 relation schema。

Results

1. 主结果:3B 单 agent 在 WebQSP / CWQ 上达到强准确率和较低生成成本

KG-R1-table1-main-results

Table 1 显示,KG-R1 使用 Qwen2.5-3B 在 WebQSP 上 Hits@1 = 82.75,在 CWQ 上 Hits@1 = 65.31。WebQSP 上它高于 RoG 的 Qwen2.5-7B / 72B / Qwen3-235B 设置;CWQ 上它接近 ReKnoS Qwen3-235B 的 65.63,同时模型规模小得多。生成 token 方面,KG-R1 在 WebQSP / CWQ 上分别为 308.67 / 311.14,低于 ToG 的 941.52 / 802.97,也低于 ReKnoS 的 592.38 / 684.38。

2. Cross-KG transfer:只换 KG backend 仍能迁移到 Freebase / Wikidata 数据集

KG-R1-table2-transfer

Table 2 的核心证据是 zero-shot transfer:WebQSP-trained KG-R1 在 SimpleQA、GrailQA、T-REx、QALD-10en 上平均 Hits@1 = 77.50;CWQ-trained KG-R1 平均 Hits@1 = 72.82。尤其是 WebQSP-trained KG-R1 高于 ToG / PoG / ReKnoS 的 Qwen3-235B 平均结果 68.01 / 75.97 / 73.92,说明 schema-agnostic action interface 对迁移有实际收益。

3. 消融:turn reward、turn-level advantage 和 retrieval reward 都有必要

KG-R1-table3-ablation

Table 3 显示,去掉 turn rewards 导致最大降幅:WebQSP 从 82.75 降到 69.29,CWQ 从 65.31 降到 52.03。去掉 turn-level advantage 也会下降,说明多轮 KG 交互需要细粒度 credit assignment。去掉 retrieval reward 后 Hits@1 降幅较小,但 Ret. Rate 明显降低,说明该项主要改善答案实体覆盖和探索质量。PPO 版本退化最严重,论文解释为 PPO 容易让 agent 伪造 retrieved content 以获得 reward。

4. 延迟和吞吐:适合单 H100 离线批处理,但仍不是轻量无成本

KG-R1-fig6-latency

Figure 6 显示 KG-R1 在 500 个 WebQSP queries 上单查询平均延迟为 6.38s,标准差约 1.0s,平均最大 turn count 为 4.2;累计时间随 turn 数近似线性增长。这说明成本主要受查询轮数控制,和 GraphRAG中的接口-代理-停止决策闭环 中的 stop/budget policy 直接相关。

KG-R1-table7-throughput

Table 7 显示单 H100、batch size 64、256 queries 下,KG-R1 single run 有 1127 次 KG calls,约 4.4 calls/sample,总时间 73.2s,吞吐 3.7 samples/s。相比 IO / CoT 的 81.8 / 70.1 samples/s,它明显更慢;相比多模块 KG-RAG,它的优势在于单 agent 和较少生成 token,而不是零成本。

5. 案例:agent 能显式查询关系、取实体并做验证

KG-R1-table10-webqsp-case

Table 10 的 WebQSP 案例中,问题是 Victoria Beckham 的孩子姓名。Agent 先调用 get_tail_relations("Victoria Beckham") 找到 people.person.children,再调用 get_tail_entities 取回四个孩子,随后用 get_head_relations / get_head_entities 验证 parent relation。这个例子说明 KG-R1 的轨迹具备可解释性:每一步查询函数、relation 和返回实体都可检查。

Limitations

  • 依赖结构化 KG:KG-R1 假设 KG 足够结构化且可通过 server 查询;缺少 KG、KG 噪声严重或 schema 不一致时,性能和迁移性都会下降。
  • Schema-agnostic 不等于 schema-blind:动作接口统一,但 agent 仍要从自然语言和 relation strings 中判断该选哪个 relation;极端 schema mismatch 或 relation 命名混乱会削弱路径搜索。
  • RL 训练成本高:推理端使用 3B 模型较经济,但训练仍需要多 rollout、GRPO、4 张 H100 和 400 steps,相比 SFT 更昂贵。
  • 检索轮数带来延迟:平均 4.4 KG calls/sample 可接受,但交互式场景仍需要 stop policy、cache 或 routing。
  • Reward hacking 风险真实存在:PPO 消融显示 agent 可能伪造 retrieved content,说明 KG-RAG RL 需要严格区分模型生成 token 和 server observation,并记录工具调用日志。
  • 案例中仍有 over-include 风险:Table 11 的 CWQ 例子预测了多个电影候选,而 ground truth 只有 Goal II: Living the Dream,说明多轮图探索可能把 plausible entities 过度并入答案。

Future Directions

  • 训练 schema adapter + action policy:结合 CacheRAG - Semantic Caching for KGQA 的 Backend Adapter,让 KG-R1 的 1-hop action interface 支持更复杂的 typed constraints、aggregation 和 filter。
  • 过程归因评测:把 $v_{kg}$、$v_{ret}$、Ret. Rate、turn utility、invalid query rate、relation ambiguity rate、answer over-include rate 加入 2026-06-09-Open-Problems。
  • Interface routing:对同一问题预测应走 KG-R1 1-hop server、SPARQL execution、Boolean logical retrieval、semantic retrieval 还是 cache-based bounded expansion,对应 2026-06-09-Open-Problems。
  • Reward-hacking 防御:server observation 必须不可由模型伪造,训练日志需区分 generated token、tool call 和 retrieved observation;这可连接 GraphRAG中的Agentic轨迹质量。
  • Cross-KG stress test:在 schema 噪声、relation alias、缺边、实体链接错误和动态 KG 更新下测试 transferability,而不是只看 clean KGQA benchmark。
  • 成本优化:结合 plan cache、early stop 和 retrieval-call budget,把 KG-R1 从 single-agent RL policy 扩展为可部署的 routing + caching + KG execution stack。

与本知识库的连接

一句话定位

KG-R1 是一篇把 KG-RAG 从多模块、schema-specific workflow 推向“单 agent + schema-agnostic KG server + turn-level RL”的论文,最值得关注的是 1-hop action interface 如何支撑跨 KG 迁移,以及 turn-level reward / advantage 如何把工具调用质量变成可训练信号。