研究问题与动机
- 研究问题:代码库问答不只需要检索相似代码片段,还需要沿着
controller -> service -> repository、接口实现、继承和依赖注入链路追踪结构关系。 - 为什么重要:代码架构问题经常是多文件、多跳、方向敏感的。向量检索能找词面相似 chunk,但不保证找到上游调用者、接口消费者或继承链上的关键证据。
- 对本知识库的意义:这篇论文把 GraphRAG中的图构建质量、表示保真与下游回答质量 里的抽象问题落到结构化领域:当语料本身有 AST / type system / dependency injection 这类可解析结构时,GraphRAG 不应默认依赖 LLM 抽取 KG。
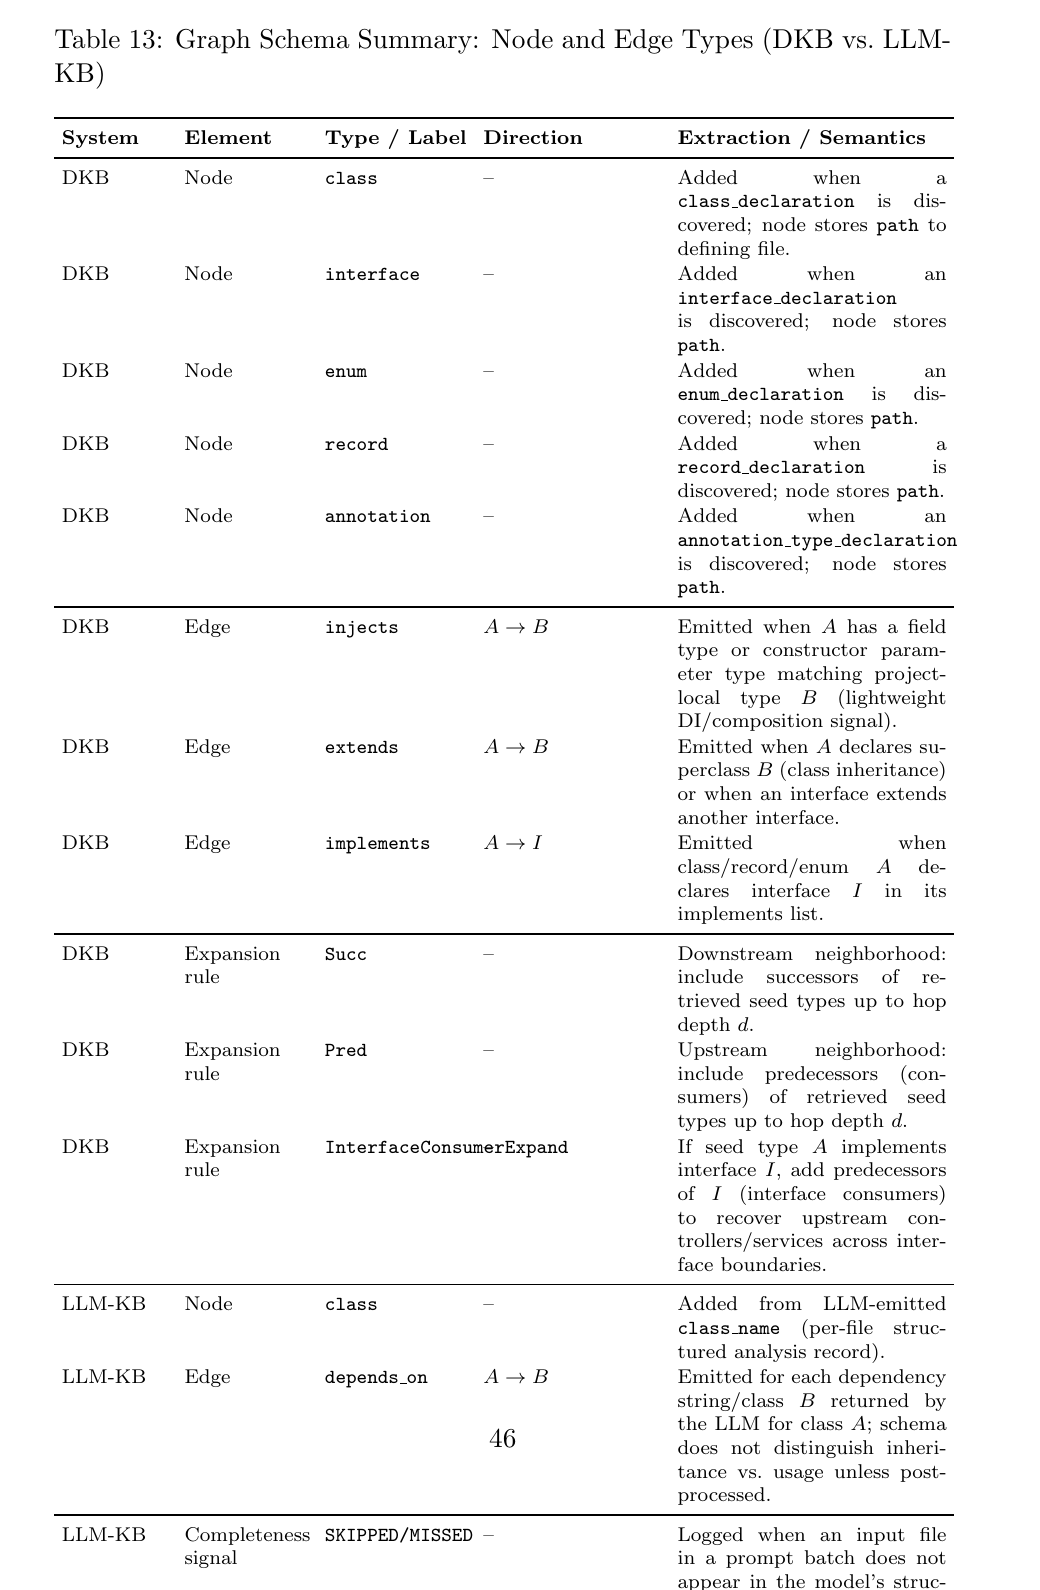
Figure 1 直观展示同一 Java 代码库上的两种 graph artifact:DKB 是 Tree-sitter 解析出的项目内类型图,边是窄而确定的 injects / extends / implements;LLM-KB 是 LLM 输出的 class_name 节点和粗粒度 depends_on 边。它们的边数量不能直接比较,因为 schema 语义不同。
- No-Graph RAG 只做 top-k 向量检索,容易漏掉多跳架构链路和接口边界后的上游消费者。
- LLM-KB 用 LLM 在索引阶段抽取依赖图,能生成高层架构关系,但抽取是 probabilistic、schema-bound 的:文件可能在结构化输出中被跳过。
- LLM-KB 的 skipped / missed file 不只是抽取质量问题,还会让文件无法进入 embedding 和 graph insertion,形成 query-time retrieval blind spot。
- 代码库这类结构化领域已经有 AST、类型声明、继承和依赖注入信号;如果仍只靠 LLM 抽取 KG,会浪费确定性结构。
方法与机制
论文比较三条 pipeline:
- No-Graph Naive RAG:对代码 chunk 做向量检索。
- LLM-KB Graph RAG:索引阶段由 LLM 抽取 dependency graph,查询阶段用图邻域扩展上下文。
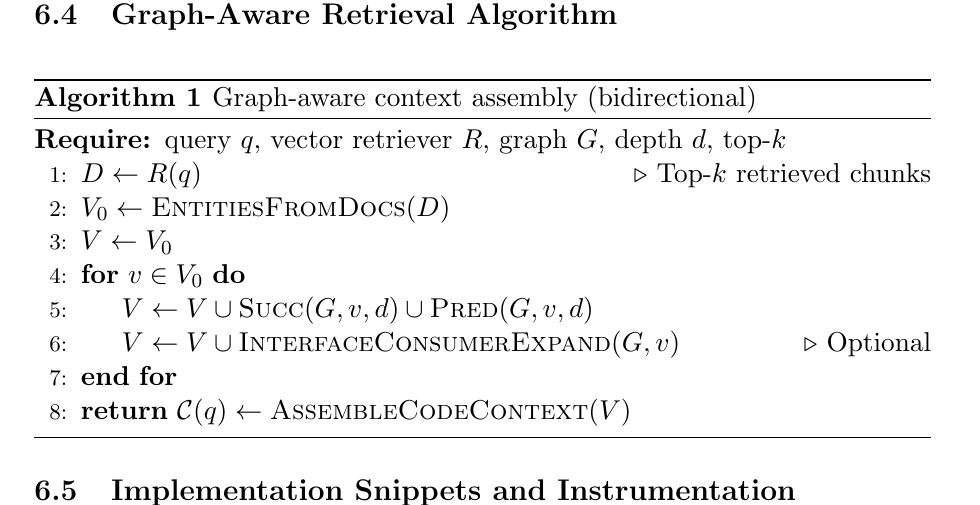
- DKB:用 Tree-sitter 从 Java AST 中确定性构建代码图,查询阶段做双向图遍历和接口消费者扩展。
1. No-Graph:向量检索基线
输入是代码文件。系统将源码按 recursive character splitter 切成 chunk,设置约为 chunk_size=1000、chunk_overlap=100,然后 embedding 到本地向量库。
查询时:
其中 $q$ 是用户问题,$R$ 是向量检索器,$D$ 是 top-k 代码 chunks。输出是 Concat(D) 后交给 LLM 生成答案。它的优点是简单、便宜、延迟低;缺点是没有结构邻域,无法保证多文件证据链完整。
2. LLM-KB:索引阶段让 LLM 抽取依赖图
输入是一批 Java 文件。系统把文件内容拼成 batch prompt,并为了适配上下文窗口截断每个文件内容。LLM 输出结构化 JSON,包括 class entities 和 dependencies。图节点来自 LLM-emitted class names,边是粗粒度 depends_on。
输出是:
- 一个 LLM-generated dependency graph;
- 与这些结构化记录对应的代码 chunks;
- skipped / missed file 日志。
关键风险是:如果输入 batch 中某个文件没有出现在 LLM 的结构化输出里,系统会记录 SKIPPED/MISSED by LLM。该文件随后可能同时缺席 embedding corpus 和 graph corpus,造成后续问题无法检索到它。
3. DKB:Tree-sitter AST 派生确定性图
输入是 Java repository。DKB 用 Tree-sitter 做两遍解析:
- Type discovery:发现项目内
class / interface / enum / record / annotation,建立type -> file映射。 - Edge extraction:从 AST 中抽取字段类型、构造函数参数、继承和实现关系。
输出图 $G=(V,E)$:
- 节点 $V$:项目内 Java 类型。
- 边 $E$:
injects:字段类型或构造函数参数类型指向项目内类型。extends:类或接口声明中的继承关系。implements:类、record、enum 对接口的实现关系。
这一步的价值是把代码结构转成窄 schema 图。它不会覆盖反射、运行时生成代码或复杂动态分派,但在 AST 可见关系上可复现。
4. Graph-aware context assembly:双向邻域和接口消费者扩展
查询阶段先做向量检索,再把命中的文件映射到 seed entities:
随后按深度 $d$ 做图邻域扩展:
其中 $N_d(v)$ 包括 successors 和 predecessors。DKB 额外加入 interface-consumer expansion:如果 seed class 实现了接口 $I$,就把 $I$ 的 predecessors 也加入上下文,以找回依赖接口而不是依赖具体实现的 controller/service。
最终上下文为:
输入是 query、向量命中 chunks 和 AST graph;计算是 seed mapping、双向邻域扩展、接口消费者扩展;输出是包含原始命中代码和结构邻居代码的 prompt context。
证据与结果
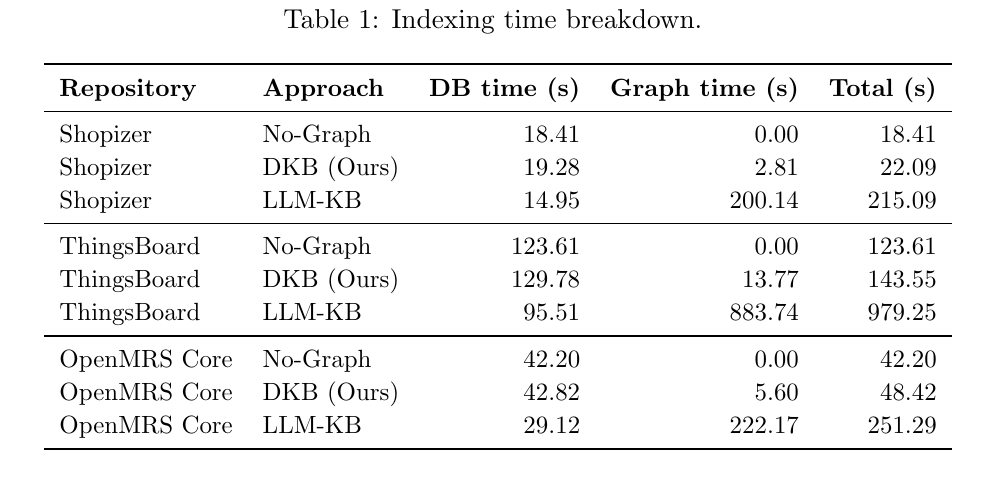
1. Indexing time:DKB 接近 No-Graph,LLM-KB 被图构建时间主导
Table 1 显示三套仓库上的索引耗时:
| Repository | No-Graph total | DKB total | LLM-KB total |
|---|---|---|---|
| Shopizer | 18.41s | 22.09s | 215.09s |
| ThingsBoard | 123.61s | 143.55s | 979.25s |
| OpenMRS Core | 42.20s | 48.42s | 251.29s |
解读:DKB 只多出 AST graph construction,成本增量较小;LLM-KB 的 graph time 在 Shopizer / ThingsBoard / OpenMRS Core 分别为 200.14s / 883.74s / 222.17s,说明 LLM-mediated graph construction 会主导索引成本。
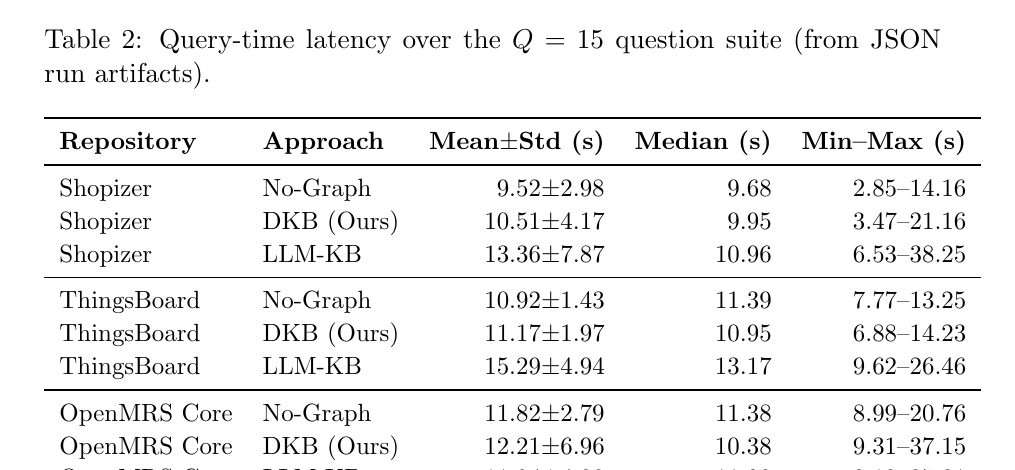
2. Query latency:No-Graph 最轻,DKB 小幅增加,LLM-KB 波动更大
Shopizer 上平均延迟为 No-Graph 9.52s、DKB 10.51s、LLM-KB 13.36s;ThingsBoard 上分别为 10.92s、11.17s、15.29s;OpenMRS Core 上分别为 11.82s、12.21s、11.94s。DKB 不是零成本,但相比 LLM-KB 更接近向量基线。
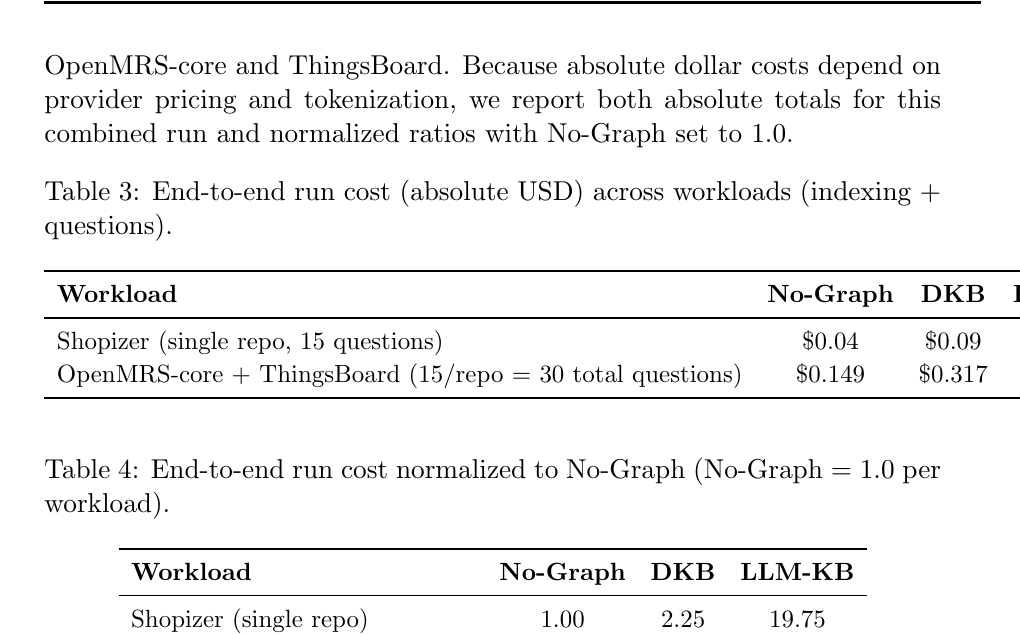
3. End-to-end cost:LLM-KB 随代码库规模快速放大
Shopizer 代表成本:
- No-Graph:$0.04
- DKB:$0.09,约 2.25x
- LLM-KB:$0.79,约 19.75x
OpenMRS Core + ThingsBoard 合并 workload:
- No-Graph:$0.149
- DKB:$0.317,约 2.13x
- LLM-KB:$6.80,约 45.64x
解读:DKB 的成本主要来自更长上下文和图邻域扩展;LLM-KB 的成本主要来自索引阶段调用 LLM 建图。代码库越大,这个差异越明显。
4. Coverage:LLM-KB 的 skipped files 直接变成检索盲点
覆盖率定义:
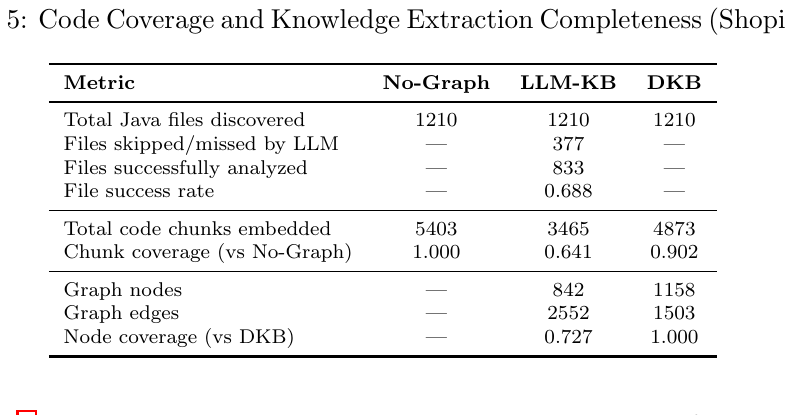
其中 $C_{baseline}$ 是 No-Graph 在所有发现 Java 文件上产生的 chunks,$C_{approach}$ 是某方法实际嵌入的 chunks。
图节点覆盖率定义:
文件成功率定义:
对 LLM-KB:
Shopizer 上,三种方法都发现 1210 个 Java 文件,但 LLM-KB skipped / missed 377 个文件,文件成功率只有 0.688。它嵌入 3465 个 chunks,对 No-Graph 的 chunk coverage 为 0.641;DKB 嵌入 4873 个 chunks,coverage 为 0.902。LLM-KB 生成 842 个 nodes,而 DKB 有 1158 个 nodes,node coverage 为 0.727。
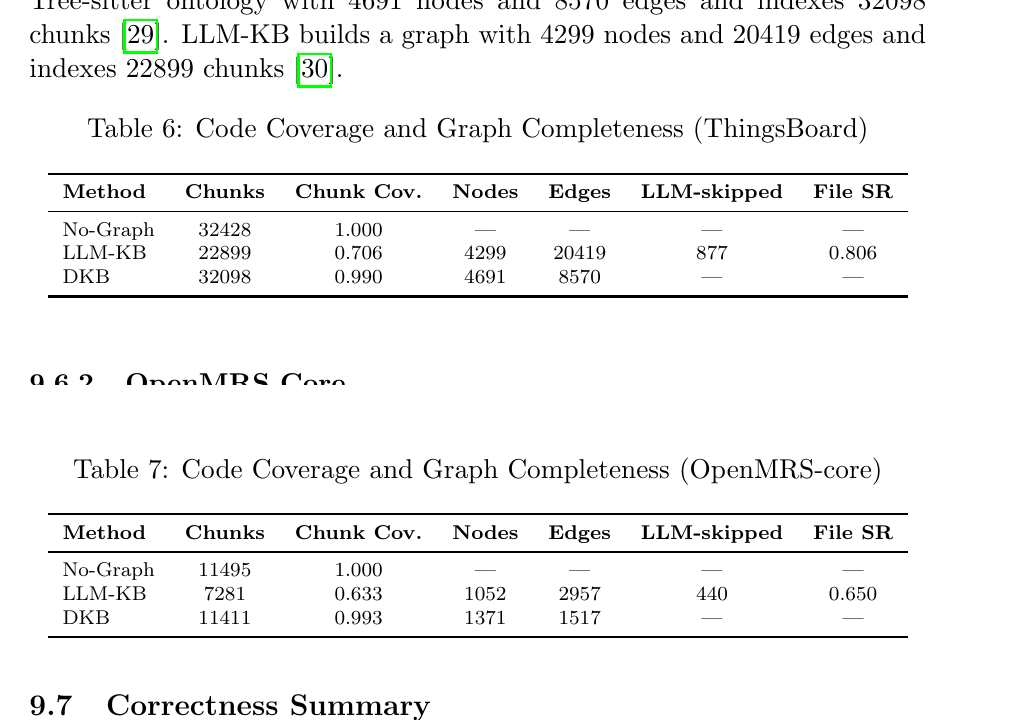
跨仓库模式一致:ThingsBoard 中 LLM-KB chunk coverage 为 0.706,file success rate 为 0.806;OpenMRS Core 中 chunk coverage 为 0.633,file success rate 为 0.650。DKB 在 ThingsBoard / OpenMRS Core 上接近 No-Graph coverage,分别为 0.990 / 0.993。
5. Correctness:DKB 在多跳结构问题上最稳
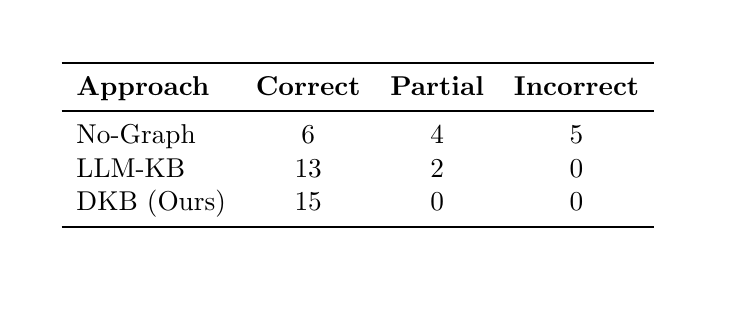
Shopizer 15 个问题上:
- No-Graph:6 correct / 4 partial / 5 incorrect
- LLM-KB:13 correct / 2 partial / 0 incorrect
- DKB:15 correct / 0 partial / 0 incorrect
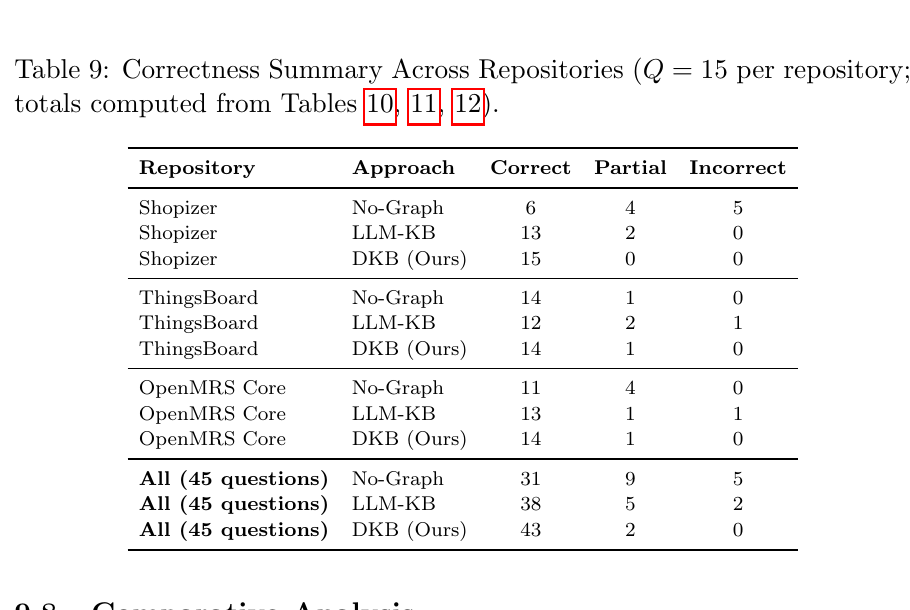
三仓库共 45 个问题:
- No-Graph:31 correct / 9 partial / 5 incorrect
- LLM-KB:38 correct / 5 partial / 2 incorrect
- DKB:43 correct / 2 partial / 0 incorrect
解读:No-Graph 在局部问题上可竞争,但在上游 discovery、接口边界、继承/注入链路上容易漏证据;LLM-KB 有明显提升,但索引覆盖不稳定;DKB 在 correctness-sensitive repository questions 上最可靠。
6. Schema comparison:边数不是结构完整性的充分指标
DKB 的 schema 窄:节点是项目内 Java 类型,边是 injects / extends / implements,扩展操作是 successors、predecessors 和 interface-consumer expansion。LLM-KB 的 schema 粗:节点是 LLM 输出的 class entity,边是 depends_on。因此 LLM-KB 可能边更多,但这不代表结构覆盖更好。
局限与开放问题
-
DKB 只覆盖 AST 可见的结构关系,难以处理 reflection、runtime-generated code、复杂动态 dispatch、框架魔法和运行时配置。
-
实验主要是 Java 代码库;迁移到 Python、JavaScript、C++ 等语言需要新的 parser、type resolver 和依赖规则。
-
DKB 当前 Shopizer chunk coverage 为 0.902,不是因为 AST 解析随机失败,而是因为 embedding corpus 与 graph node discovery 耦合。更稳的实现应先 embed all discovered files,再把 graph edges attach 到可解析类型上。
-
Correct / Partial / Incorrect 是人工判断,未来需要多标注者一致性、结构化引用证据和完整 run artifacts。
-
LLM-KB 的 skipped files 可以通过更小 batch、retry、schema validation 改善,但只要抽取依赖生成式模型,就仍需要显式记录 coverage 和 failure。
-
将 DKB 从 Java 扩展到多语言 deterministic code graph:Tree-sitter 负责 syntax,language server / static analyzer 负责 type resolution 和 cross-file symbol resolution。
-
解耦 embedding corpus 和 graph corpus:所有文件都进入向量索引,AST graph 只作为可用时的结构增强,避免因图节点发现失败而丢代码 chunk。
-
为 LLM-KB 增加 indexing reliability protocol:每个输入文件必须产出
processed / skipped / retry_failed状态,导出 skipped counters、per-file coverage 和 schema validation report。 -
把 deterministic graph 与 LLM semantic graph 合并:AST graph 负责高置信结构边,LLM graph 只补充 AST 不可见的业务语义、配置关系和跨模块概念关系。
-
在代码库 GraphRAG 中引入 stage-aware router:局部问题走 No-Graph,接口/继承/依赖链问题走 DKB,业务概念或跨文档设计问题再触发 LLM-KB 或 agentic search。
关联与拓展
- 相关论文:GraphRAG on Consumer Hardware - Local LLMs for Healthcare EHR Schema Retrieval、CrossAug - Cross-Chunk Graph Augmentation for GraphRAG、MemGraphRAG - Memory-based Multi-Agent GraphRAG
- 图构建质量:GraphRAG中的图构建质量、表示保真与下游回答质量、GraphRAG中的知识图谱噪声传播
- 成本与边界:GraphRAG中的图结构强度、构建成本与收益边界
- 接口选择:GraphRAG中的图接口选择与任务类型、Query Execution 与 Retrieval 的区别
- 工作流入口:2026-06-09-Paper-Pool、2026-06-09-Open-Problems