研究问题与动机
-
研究问题:GraphRAG / Graph-RAG 系统已经能把实体描述、关系描述、community summary 和文本 chunk 放进回答上下文,但多跳问答仍经常失败。关键问题是:失败到底来自检索没召回证据,还是证据已经在上下文中但模型没有正确推理。
-
为什么重要:如果 gold answer 已经在 retrieved context 中,继续只优化 recall、top-k、hop 数或 graph traversal 不一定解决问题。系统需要把失败从
retrieval miss继续拆到reasoning path selection、context compression、operator execution和final answer synthesis。 -
研究对象:论文以 KET-RAG 为主系统。KET-RAG 是 Keyword + Entity + Text 的多组件 Graph-RAG:
- 从所有 chunks 构建 text-keyword bipartite graph,不需要 LLM。
- 用 PageRank 选择核心 chunks,再用 LLM 抽取实体和关系,默认
beta=0.8。 - 同时保留 embedding text retrieval、entity descriptions、relationship descriptions 和 community reports。
- 论文复用 KET-RAG 默认
theta=0.5、lambda=12000,并用预算更低的 embedding / indexing LLM 复现实验覆盖率。
-
Retrieval coverage 不等于 answer correctness:HotpotQA、MuSiQue、2WikiMultiHopQA 中 77%-91% 的问题 gold answer 已经出现在 retrieved context,但 accuracy 仍只有 35%-78%。
-
上下文太大且结构没有被显式利用:KET-RAG 平均返回约 10,000 tokens,包含实体、关系、文本和社区报告。模型需要在大量上下文中自己找多跳链条,容易 needle-in-haystack。
-
普通 CoT 不一定匹配 GraphRAG 上下文:GraphRAG 返回的是 entity-relationship context,但自然语言子问题分解不保证和关系三元组对齐。
-
压缩不是通用剪枝问题:Graph-walk compression 在 KET-RAG 中能利用 PageRank / hop distance 的 relevance gradient,但迁移到 LightRAG 时反而伤害效果,说明压缩方法依赖检索管线结构。
-
现有 GraphRAG 评估常把错误归因停在 retrieval recall,没有单独报告 gold-in-context rate、covered accuracy、reasoning failure share、abstain rate 和 compression loss。
方法与机制
总体框架
论文不重新训练、不重新建索引,而是在 KET-RAG 已返回上下文之后加入三个 inference-time augmentation:
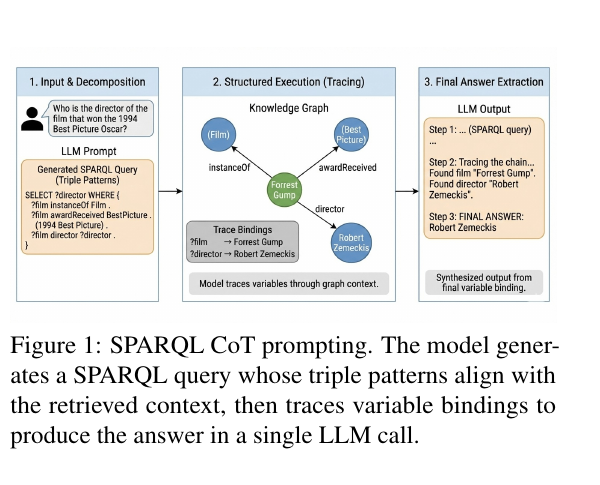
- SPARQL Chain-of-Thought:把问题改写成最多 4 个 triple patterns,再在上下文中追踪变量绑定。
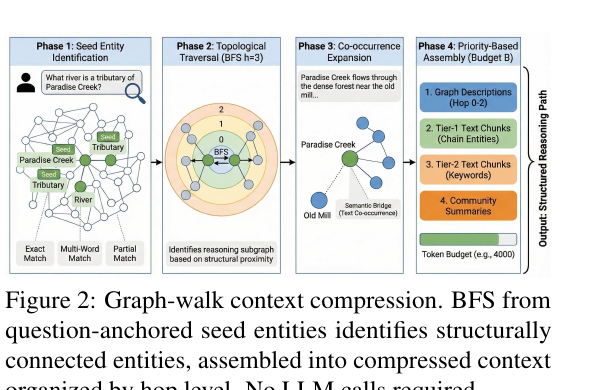
- Graph-walk context compression:用图遍历和文本共现把约 10,000 tokens 压到约 4,000 tokens。
- Question-type routing:先判断问题类型,再选择 SPARQL CoT、generic CoT 或 fallback。
1. SPARQL Chain-of-Thought Prompting
输入:自然语言问题 q,KET-RAG 返回的 entity descriptions、relationship descriptions、community reports 和 text chunks。
计算:模型在一次 LLM 调用中完成三步。
- 写一个简单 SPARQL query:最多 4 个 triple patterns,使用 plain English predicates,不使用 URI、FILTER 或 subquery。
- 沿着 retrieved context 追踪每个变量绑定。
- 输出
FINAL ANSWER: ...;如果上下文没有答案,输出不知道并计为 abstention。
可以把 triple-pattern reasoning 写成:
其中 s_i / o_i 可以是实体或变量,r_i 是自然语言谓词。模型要在 GraphRAG 上下文中寻找每个模式的绑定:
并通过共享变量把多跳链条串起来:
输出:一个与 entity-relationship context 对齐的显式推理 trace,以及最终答案。它的成本主要是多输出约 100-200 tokens,不增加额外检索或多次 LLM 调用。
2. Graph-Walk Context Compression
输入:原始 KET-RAG context、知识图 G=(V,E)、问题 q、token budget B=4000。
计算分四相。
Phase 1:seed entity identification。
从问题中匹配 seed entities:
match(v,q) 包含 exact substring、multi-word matching,以及长度不少于 5 的 significant question word 与实体名部分匹配;stopwords 被排除。
Phase 2:topological traversal。
从 S0 做 BFS,最大深度为 3:
每个实体按到最近 seed 的 hop distance 排序,距离越近优先级越高。
Phase 3:co-occurrence expansion。
如果某个文本 chunk 同时提到 BFS 已到达实体 u 和未到达实体 v,则把 v 加入压缩候选:
这一步补回抽取图里没有直接边、但在文本中共同出现的语义桥。
Phase 4:priority-based assembly。
在预算 B 内按优先级组装上下文:
优先级依次是:
D_graph:按 hop distance 排序的实体和关系描述。D_tier1:提到 BFS-reached entities 的文本 chunks。D_tier2:共享问题关键词但没有 BFS-reached entities 的 chunks。D_community:community reports,最低优先级。
输出:约 4,000 tokens 的结构化压缩上下文,按 hop level 组织,更适合 SPARQL CoT 逐步绑定变量。若没有匹配到 seed entity,则回退到原始未压缩 context。
3. Question-Type Routing
输入:问题 q。
计算:用便宜的 8B 模型做一次最多 5 output tokens 的分类:
决策规则:
bridge:优先使用 SPARQL CoT。comparison/inference:优先使用 generic CoT。- 如果首选方法 abstain,则用另一种方法 retry。
输出:最多 3 次 8B 调用:分类、回答、可选 retry。路由的目标不是提高检索覆盖,而是让不同问题类型使用更合适的推理 scaffold。
4. Error Decomposition
输入:每个样本的 retrieved context、gold answer、模型最终答案。
原始笔记摘录已截断;请打开来源笔记阅读完整内容。
证据与结果
检索覆盖:gold answer 多数已经在上下文中
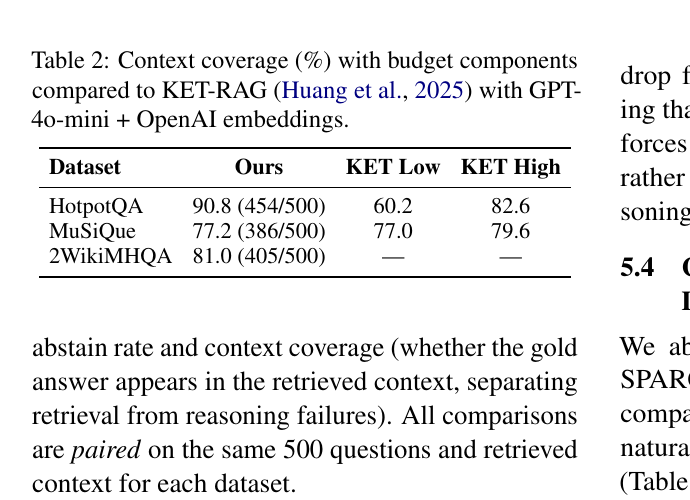
- HotpotQA 覆盖率为 90.8%(454/500),MuSiQue 为 77.2%(386/500),2WikiMHQA 为 81.0%(405/500)。
- 这说明 KET-RAG 的主要问题不再是简单的 answer absent from context,至少在这三个 benchmark 上,大量错误发生在证据已经进入上下文之后。
主结果:SPARQL CoT 与 Graph-walk compression 的组合显著改善小模型
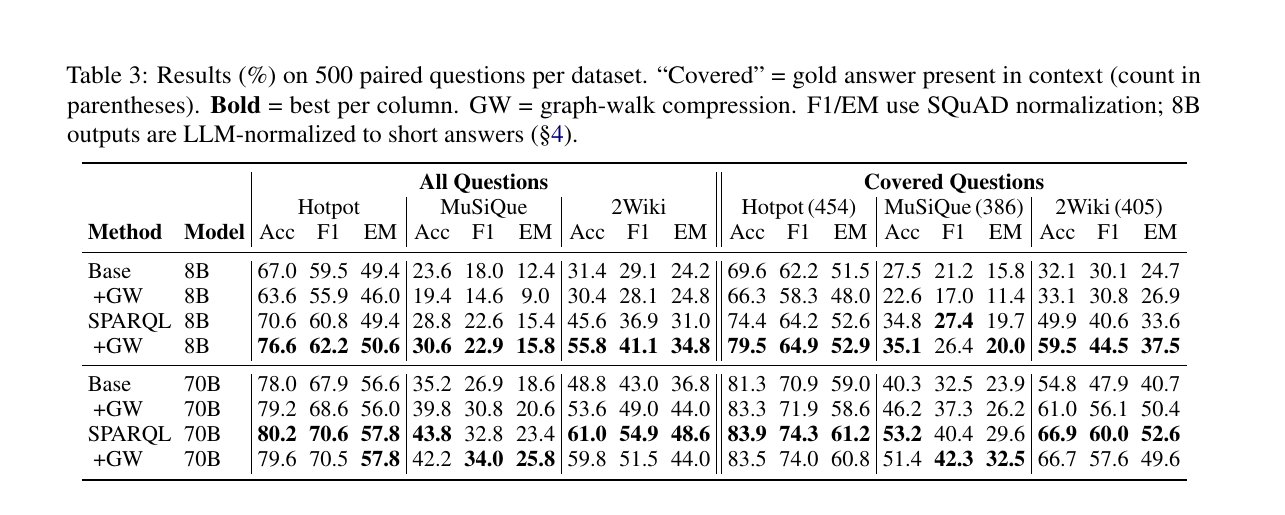
- 8B baseline accuracy:HotpotQA 67.0,MuSiQue 23.6,2WikiMHQA 31.4。
- 8B + SPARQL + GW:HotpotQA 76.6,MuSiQue 30.6,2WikiMHQA 55.8。
- 70B baseline:HotpotQA 78.0,MuSiQue 35.2,2WikiMHQA 48.8。
- 70B + SPARQL:HotpotQA 80.2,MuSiQue 43.8,2WikiMHQA 61.0。
- 关键解读:小模型在压缩 + 结构化提示组合下收益最大;大模型更能直接利用完整上下文和 SPARQL trace。
SPARQL CoT、routing 和 graph-walk compression 的消融
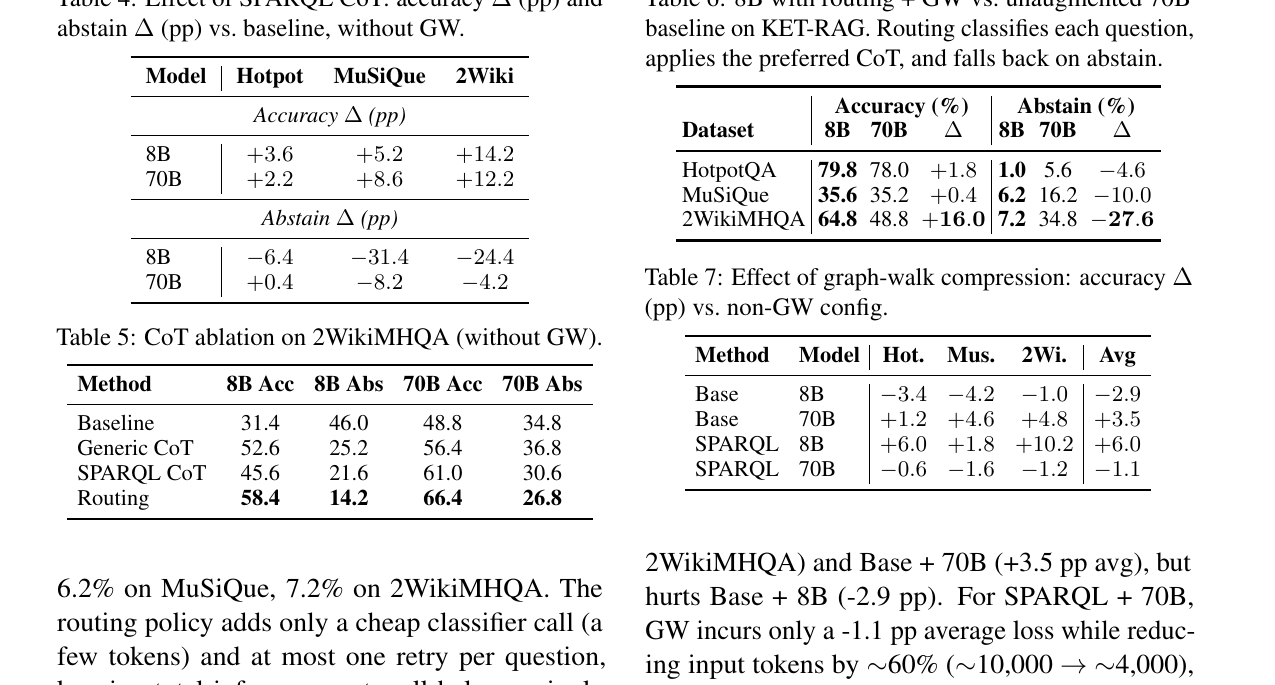
- SPARQL CoT 在不使用 GW 时提升准确率:8B 上 Hotpot +3.6、MuSiQue +5.2、2Wiki +14.2;70B 上 Hotpot +2.2、MuSiQue +8.6、2Wiki +12.2。
- 2WikiMHQA 的 CoT 消融显示,8B 更偏 generic CoT,70B 更偏 SPARQL CoT;因此路由能进一步提高 2Wiki accuracy 到 8B 58.4 / 70B 66.4。
- 8B routing + GW 可以在三个数据集上匹配或超过未增强 70B baseline:HotpotQA 79.8 vs 78.0,MuSiQue 35.6 vs 35.2,2WikiMHQA 64.8 vs 48.8,同时 abstain rate 更低。
- GW 的效果依赖模型和提示:SPARQL+8B 平均 +6.0 pp,但 Base+8B 平均 -2.9 pp,说明压缩后的小模型必须有结构化推理 scaffold 才能正确利用短上下文。
Error decomposition:多数错误是 reasoning failure
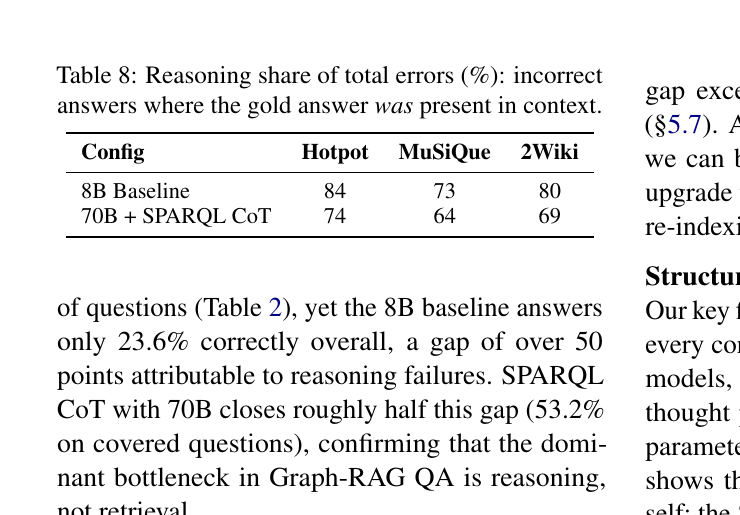
- 8B baseline 中,reasoning failure 占总错误比例:HotpotQA 84%、MuSiQue 73%、2Wiki 80%。
- 即使用 70B + SPARQL CoT,reasoning failure 仍占 HotpotQA 74%、MuSiQue 64%、2Wiki 69%。
- 这张表是本篇最重要的研究信号:GraphRAG 不能只继续报告 recall,必须报告 gold-in-context 后模型是否真的能执行推理。
Question type:SPARQL 和 GW 的收益不是均匀的
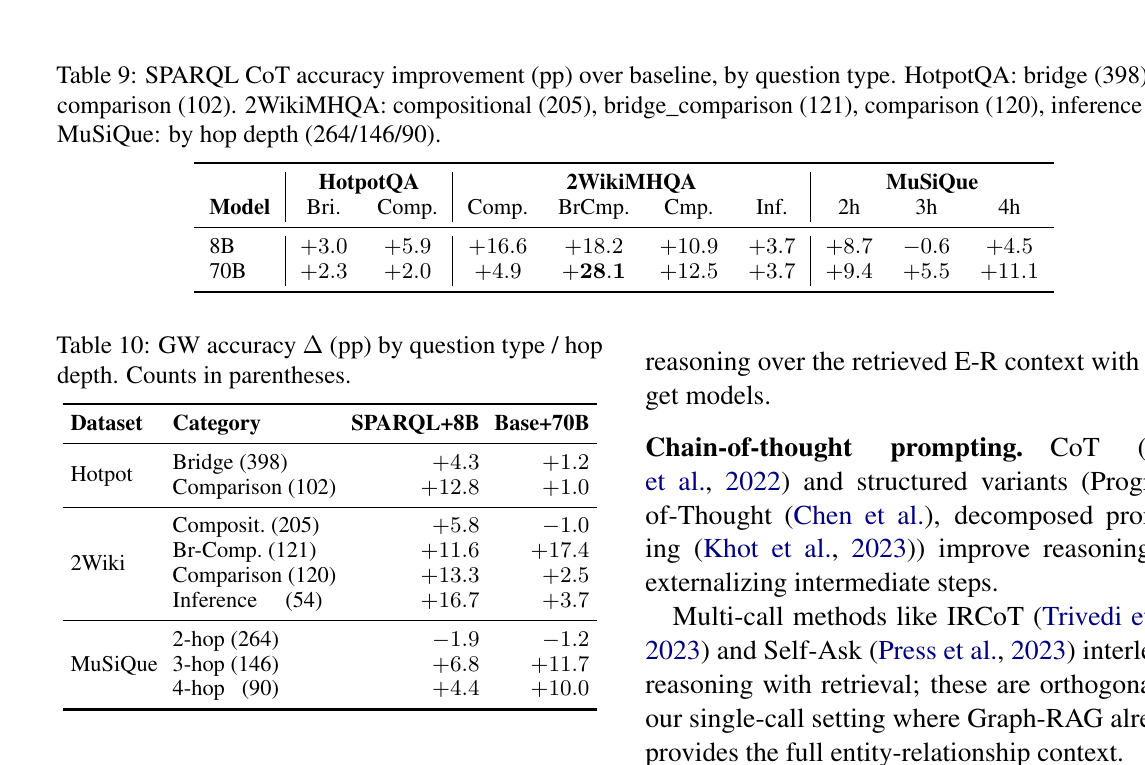
- SPARQL CoT 在链式、多跳、compositional 问题上收益明显:2Wiki bridge-comparison 上 70B +28.1,MuSiQue 4-hop 上 70B +11.1。
- Inference 类问题收益最小,说明 SPARQL triple pattern 更适合显式实体链,而不是所有隐式推理。
- GW 在 SPARQL+8B 下对 Hotpot comparison、2Wiki inference 等类别有较大收益,但在 MuSiQue 2-hop 为负,提示 compression operator 需要按问题类型路由,而不能默认全开。
LightRAG 泛化:SPARQL CoT 可迁移,Graph-walk compression 不一定可迁移
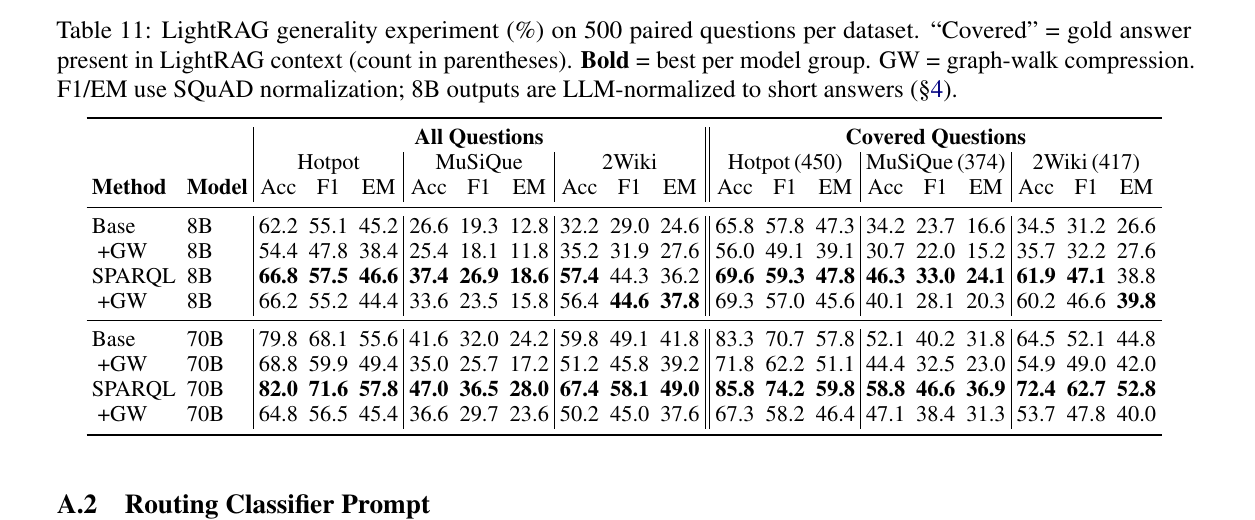
- LightRAG 上 SPARQL CoT 仍稳定提升:HotpotQA +2.2、MuSiQue +5.4、2Wiki +7.6。
- 但 GW 在 LightRAG 上整体伤害效果。论文解释为 LightRAG 缺少 KET-RAG 的 relevance gradient,graph-walk 剪枝会同时删掉相关内容和噪声。
- 这说明 structured prompting 更像系统无关的推理 scaffold,而 graph-based compression 更依赖检索系统如何组织上下文。
局限与开放问题
-
覆盖率用 gold answer substring 是否出现在 context 中衡量,可能高估真正可用的 evidence coverage;有答案字符串不等于完整 support path 已出现。
-
每个数据集只抽样 500 个问题,适合诊断但还不是完整 benchmark 结论。
-
实验依赖 KET-RAG 默认参数和上下文结构,尤其是
theta=0.5、lambda=12000;不同 GraphRAG pipeline 的上下文组织会影响 GW 是否有效。 -
Graph-walk compression 不是系统无关模块:在 LightRAG 上明显退化,说明其前提是检索管线提供可利用的 hop / seed / relevance gradient。
-
论文只做 inference-time augmentation,没有训练模型,也没有学习路由器或压缩器;上限可能受 prompt following 和手工规则限制。
-
SPARQL CoT 适合显式实体链、关系链和 bridge 问题,对隐式 inference、模糊比较、非链式聚合或需要严格 set operation 的问题可能不足。
-
Error decomposition 仍比较粗:
covered but wrong被归为 reasoning failure,但内部还可继续拆成 path selection、operator execution、context ordering、abstention、final synthesis 等错误。 -
作者方向:
- 将 structured prompting、graph-walk compression 和 routing 应用到更多 Graph-RAG 系统。
- 让未来更强模型复用同一个 model-independent graph index。
-
Agent 推断的 Research Opportunities:
- 建立 post-retrieval reasoning diagnostic:固定 retrieved context,只比较 structured prompting、explicit query execution、context compression 和 answer verifier。
- 把 SPARQL-like trace 变成可执行或可验证中间结构,而不是只作为自然语言提示。
- 训练 routing policy,在
SPARQL CoT / generic CoT / no CoT / compression / no compression / retry之间选择。 - 与 GraphRAG-R1 - Process-Constrained Reinforcement Learning for GraphRAG 和 Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning 结合,把 reasoning failure rate、covered accuracy、route choice 和 turn utility 纳入 process reward。
- 建立更细的指标:gold-in-context rate、support-in-context rate、covered accuracy、reasoning failure share、abstain rate、SPARQL trace validity、context compression ratio、compressed-context coverage、route choice、retry rate。
- 与 QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples 结合,把 “gold evidence 已在上下文但 answer model 不会执行 intersection / count / join” 作为统一的后检索执行瓶颈研究。
关联与拓展
- 相关论文:QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples、GraphRAG-R1 - Process-Constrained Reinforcement Learning for GraphRAG、Graph-R1 - Agentic GraphRAG via End-to-end Reinforcement Learning、STAR - Semantic-Tuned and Tail-Adaptive Retriever for GraphRAG、BubbleRAG - Evidence-Driven RAG for Black-Box KGs
- 相关理论:GraphRAG中的Agentic轨迹质量、结构化检索中的Faithfulness与Coverage、Query Execution 与 Retrieval 的区别、GraphRAG中的图接口选择与任务类型
- 可接到的 Open Problems:
- 2026-06-09-Open-Problems OP-17:直接补强 “Reasoning bottleneck after successful graph retrieval”。
- 2026-06-09-Open-Problems OP-11:SPARQL CoT 可以作为 query execution scaffold,但还不是可执行查询。
- 2026-06-09-Open-Problems OP-10:question-type routing、abstain 和 retry 可以进入 traversal / planning attribution。
- 2026-06-09-Open-Problems OP-18:把 gold-in-context、reasoning trace、route choice、citation 和 final answer 连接成 evidence-flow audit。
研究问题入口
Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略