GGraphRAG 文献图谱自动同步
LIT-5A96CB41 · 2025

MMGraphRAG - Interpretable Multimodal Knowledge Graphs

MMGraphRAG 把图片解析成 scene graph,再用 SpecLink 在视觉实体和文本实体之间生成高质量候选对齐,最终构建 node-based MMKG,让检索可以沿跨模态图路径取证据,而不是只用 caption 或 shared embedding。

PDF 级阅读卡优先级 P1Xueyao Wan, Hang Yu发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:传统 GraphRAG 主要围绕文本 entity KG 和 community summary 展开,难以把图片中的对象、局部区域、视觉关系和文本实体放进同一个可遍历图结构。
  • 为什么重要:多模态文档 QA 常依赖图片、表格、版面和文字共同给出答案。若只把图像 caption 成文本,细粒度对象和空间关系会被压扁;若只用 shared embedding,模型能检索相似视觉语义,但很难解释“哪个视觉实体和哪个文本实体被连接”。
  • 现有路线:
    • Image captioning 把视觉内容线性化成一段文本,丢失显式视觉结构。
    • Shared embedding MRAG 把图像和文本投到统一向量空间,容易 semantic flattening,且缺少可解释推理路径。
    • Joint extraction 或约束式对齐依赖任务特定标注和启发式规则,泛化性受限。
  • 对本知识库的意义:MMGraphRAG 补上 M3KG-RAG - Multi-hop Multimodal Knowledge Graph-enhanced RAG 和 SEM-RAG - Structure-Preserving Multimodal Graph Compilation 之间的空白:它不处理 audio-video grounding,也不专注表格公式编译,而是强调 image scene graph 与 text KG 的 cross-modal entity linking。

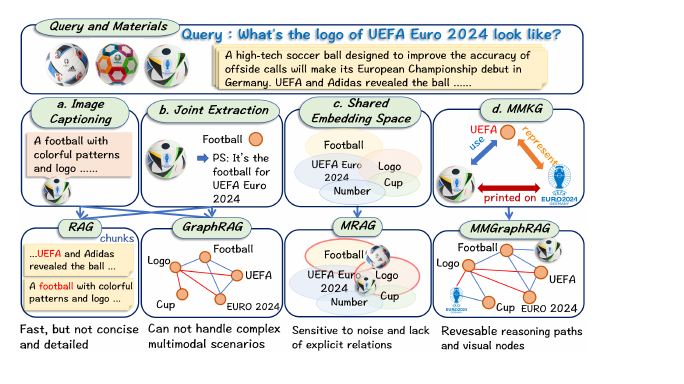
Figure 1 把四种路线放在一起:captioning 快但丢细节,joint extraction 依赖标注,shared embedding 缺显式关系;MMGraphRAG 的关键是把 logo、football 等视觉对象作为图节点,并和文本实体建立可解释边。

  • Text-only GraphRAG 不能把视觉对象作为 first-class graph node,因此无法表达“图片实体 -> 文本实体 -> 文档事实”的跨模态路径。
  • 普通多模态 RAG 依赖 embedding similarity,不能保证实体 presence、视觉关系和文本指代真的对齐。
  • 现有 CMEL benchmark 多偏合成 3D 场景,缺少真实新闻、论文、小说等复杂文档中的细粒度 image-text entity alignment 数据。
  • 图像 caption 会把局部对象、feature block、对象间关系和全局图像语义压成一句话,导致后续 GraphRAG 看不到结构。
  • Unanswerable 问题尤其容易暴露 shared embedding 的噪声:语义相邻但不支持答案的图片证据会诱导模型生成看似合理的错误答案。

方法与机制

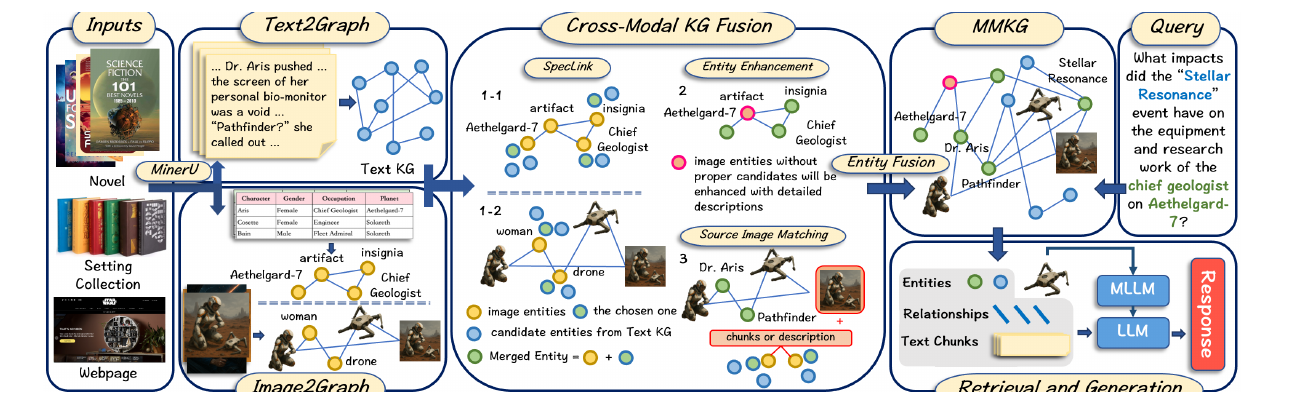
1. 总体框架:从多模态文档到 MMKG 检索

输入:包含文本和图片的文档集合,例如网页、小说、PDF 文档:

D=\{D_i^{text},D_i^{image}\}_{i=1}^{N}

计算链路:

  1. Preprocessing:用 MinerU 等工具解析文档,分离文本 chunk 和图片。
  2. Text2Graph:对文本 chunk 做实体和关系抽取,得到 text KG。
  3. Image2Graph:对图片做分割、描述、实体关系抽取和局部/全局图像节点构建,得到 image KG。
  4. Cross-Modal KG Fusion:用 SpecLink 生成候选跨模态实体对,再由 LLM 做最终 entity alignment;之后增强未对齐视觉实体、对齐全局图像实体、融合表示。
  5. Retrieval and Generation:在统一 MMKG 上检索结构化跨模态上下文;LLM 负责文本逻辑和回答组织,MLLM 负责图像检索结果处理。

输出:可被多轮 query 复用的 multimodal knowledge graph,而不是每个 query 临时构图。

直观解释:MMGraphRAG 把索引阶段做重,把 text KG 和 image KG 提前融合;query-time 主要沿 MMKG 检索跨模态实体、关系和文本 chunk。

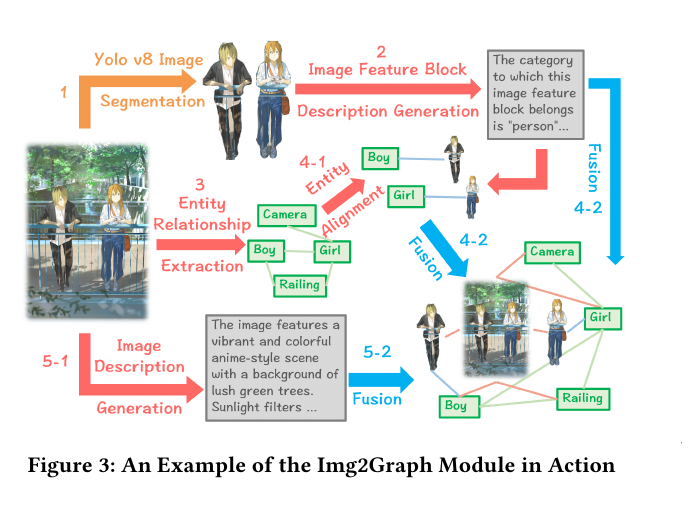
2. Image2Graph:把图片变成图节点和关系

输入:图片 $I_i$。

计算链路:

  1. Semantic segmentation:用 YOLO 把图片切成语义独立的 image feature blocks:
B(I_i)=\{b_1,b_2,\ldots,b_K\}
  1. Feature block description:MLLM 为每个 feature block 生成类别、属性和细粒度描述。
  2. Visual entity and relation extraction:MLLM 从图片中抽取视觉实体和关系:
G_{img}(I_i)=(E_{img}(I_i),R_{img}(I_i))
  1. Feature block alignment:把分割出的局部区域和抽取出的视觉实体对齐,使实体能追溯到图像区域。
  2. Global image entity:构造描述整张图片的全局实体,并和局部实体连接。

输出:带有局部视觉实体、全局图像实体、实体描述和视觉关系的 image-based KG。

直观解释:这一步避免把图片直接压成 caption。图片中的 girl、camera、railing 等都成为节点,holding / appears close 等显式或隐式关系成为边。

3. CMEL + SpecLink:视觉实体和文本实体如何对齐

输入:

  • 图片集合 $I={I_1,I_2,\ldots,I_N}$。
  • 每张图片中的视觉实体:
E(I_i)=\{e_1^{(I_i)},e_2^{(I_i)},\ldots,e_K^{(I_i)}\}
  • 文本 chunk 集合 $T={T_1,T_2,\ldots,T_M}$。
  • 每个文本 chunk 中的文本实体:
E(T_j)=\{e_1^{(T_j)},e_2^{(T_j)},\ldots,e_L^{(T_j)}\}

计算链路:

  1. 候选生成:对每个视觉实体 $e_k^{(I_i)}$,先在上下文相邻文本 chunk 的实体池中生成候选集合:
C(e_k^{(I_i)})\subseteq \bigcup_{\ell=j-1}^{j+1}E(T_\ell)
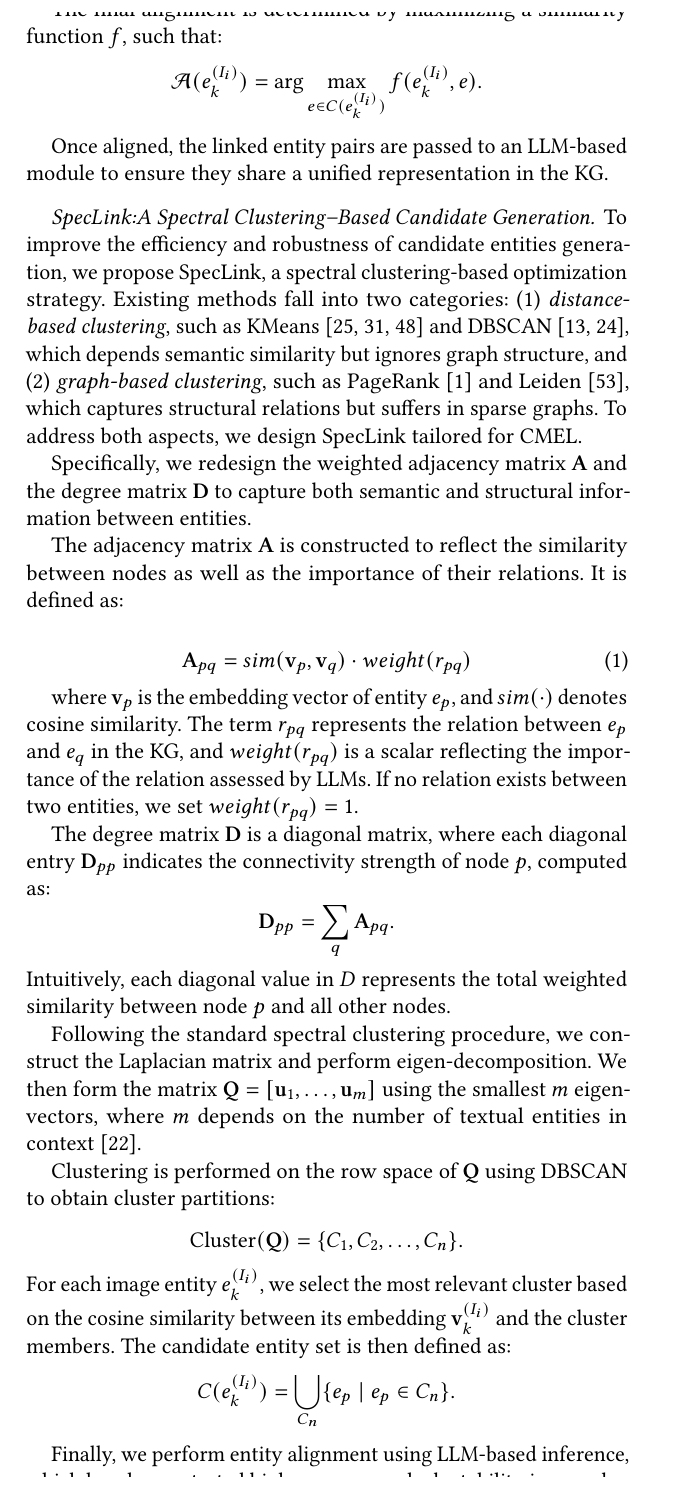
  1. SpecLink 构造带权邻接矩阵,把语义相似度和图关系权重合并:
A_{pq}=sim(v_p,v_q)\cdot weight(r_{pq})

其中 $v_p$ 是实体 $e_p$ 的 embedding,$sim(\cdot)$ 是余弦相似度,$r_{pq}$ 是实体间关系,$weight(r_{pq})$ 是由 LLM 判断的关系重要性;若无关系,则 $weight(r_{pq})=1$。

  1. 计算度矩阵:
D_{pp}=\sum_q A_{pq}
  1. 按 spectral clustering 流程做 Laplacian 分解,取最小 $m$ 个特征向量组成:
Q=[u_1,\ldots,u_m]
  1. 在 $Q$ 的行空间上用 DBSCAN 得到聚类:
Cluster(Q)=\{C_1,C_2,\ldots,C_n\}
  1. 对视觉实体选择最相关 cluster $C_{c^*}$,并把其中实体作为候选:
C(e_k^{(I_i)})=\{e_p\mid e_p\in C_{c^*}\}
  1. 最终对齐由 LLM 在候选集合中选择,形式上是:
A(e_k^{(I_i)})=\arg\max_{e\in C(e_k^{(I_i)})} f(e_k^{(I_i)},e)

输出:视觉实体到文本实体的对齐结果。

直观解释:SpecLink 先用 spectral clustering 缩小候选范围,再让 LLM 做最终判断。这样避免让 LLM 在全量文本实体里盲选,也比纯 embedding similarity 更能利用图结构。

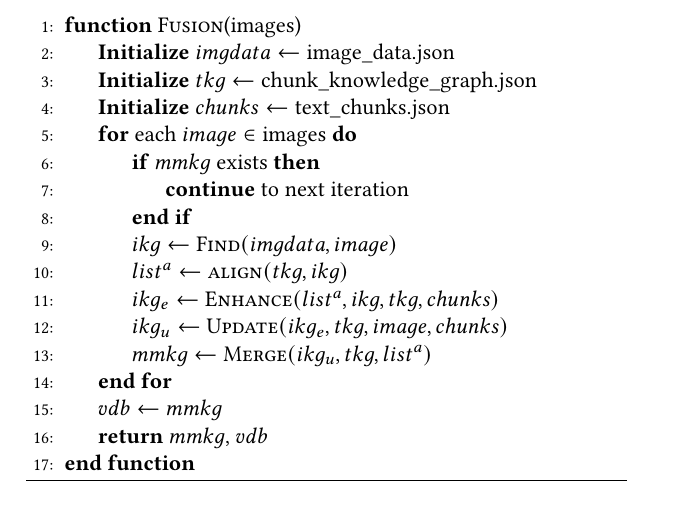
4. Cross-Modal Fusion:从对齐结果到统一 MMKG

输入:

  • imgdata:图片数据和图片解析结果。
  • chunks:文本 chunk。
  • tkg:Text2Graph 生成的 text KG。
  • ikg:Image2Graph 生成的 image KG。

计算链路:

  1. FIND(imgdata, image) 找到当前图片对应的 image KG。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

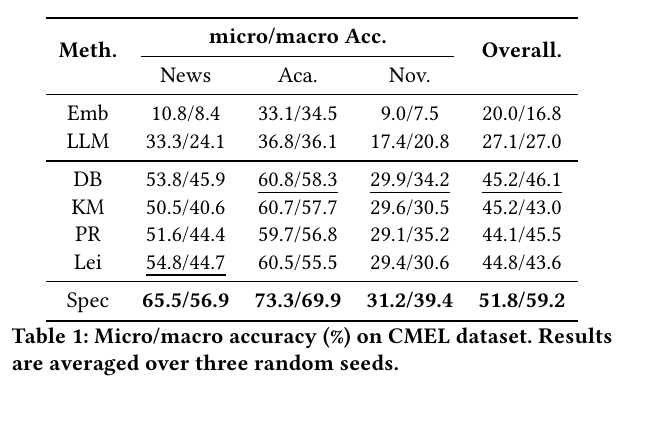
Table 1 使用 micro / macro accuracy。整体结果:

  • Embedding baseline:20.0 / 16.8
  • LLM baseline:27.1 / 27.0
  • DBSCAN:45.2 / 46.1
  • KMeans:45.2 / 43.0
  • PageRank:44.1 / 45.5
  • Leiden:44.8 / 43.6
  • SpecLink:51.8 / 59.2

解读:SpecLink 的优势主要在 macro accuracy,说明它不只是靠实体数量多的文档拉高平均,而是在不同文档/领域上更稳定。论文还报告相对最强 baseline 的提升在 paired bootstrap 下显著,$p<0.01$。

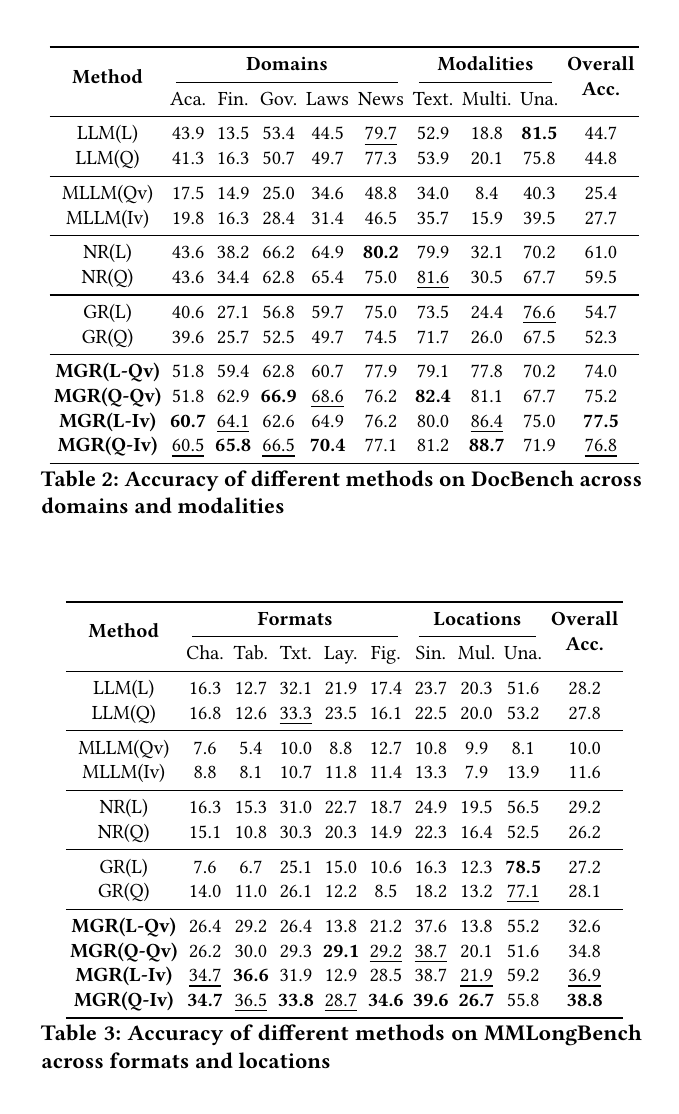
2. DocBench / MMLongBench 主结果支持显式 MMKG

DocBench:

  • NaiveRAG(Q):59.5 overall accuracy。
  • GraphRAG(Q):52.3 overall accuracy。
  • MMGraphRAG(Q-Iv):76.8 overall accuracy。
  • MMGraphRAG(L-Iv):77.5 overall accuracy。
  • 多模态问题上,MMGraphRAG(Q-Iv) 达到 88.7,明显高于 NaiveRAG(Q) 30.5 和 GraphRAG(Q) 26.0。

MMLongBench:

  • NaiveRAG(Q):26.2 overall accuracy。
  • GraphRAG(Q):28.1 overall accuracy。
  • MMGraphRAG(Q-Iv):38.8 overall accuracy。
  • 论文摘要还报告 MMGraphRAG 在 MMLongBench 上达到 34.1 F1。

解读:MMGraphRAG 的收益集中在 multimodal / chart / table / figure / layout 等视觉结构相关问题。纯 MLLM 直接看图并不强,说明“能看图”不等于“能在长文档中把视觉实体和文本证据接起来”。

3. 融合模块和显式 MMKG 都是关键组件

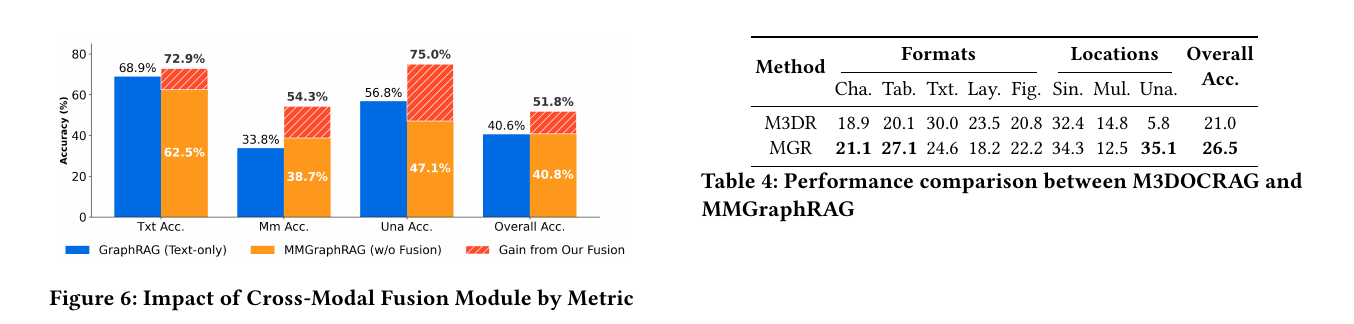
Figure 6 的消融显示:

  • Naive fusion 对 text-only 问题会引入噪声,Txt accuracy 从 full fusion 的 72.9 降到 62.5。
  • Multimodal 问题上,text-only GraphRAG 为 33.8,naive fusion 为 38.7,full MMGraphRAG 为 54.3;完整 cross-modal fusion 相比 naive fusion 带来 +15.6,相比 text-only GraphRAG 带来 +20.5。
  • Unanswerable 问题上,full fusion 达到 75.0,而 naive fusion 为 47.1,说明错误对齐视觉信息会加剧 hallucination。

Table 4 对比 M3DOCRAG:

  • Overall accuracy:M3DR 21.0,MMGraphRAG 26.5。
  • Unanswerable:M3DR 5.8,MMGraphRAG 35.1。
  • Chart / Table:M3DR 18.9 / 20.1,MMGraphRAG 21.1 / 27.1。

解读:显式 MMKG 的关键收益不是所有维度都碾压,而是显著提升 unanswerable 和需要跨模态结构判断的问题。它能让系统更可靠地判断“证据不足”,而不是被 embedding 近邻诱导回答。

4. 评估可靠性补充

  • 论文用 Llama3.1-70B-Instruct 作为自动 judge。
  • 人工一致性抽样显示:DocBench agreement 96.0%,Cohen's $\kappa=0.882$;MMLongBench agreement 94.6%,$\kappa=0.876$。
  • 这说明 judge 在该设置下可用,但仍不能完全替代人工证据核查,尤其是跨模态 grounding 是否真的被图像支持。

局限与开放问题

  • 论文仍是 arXiv 预印本,PDF 模板中保留了占位会议名;正式发表状态需要后续跟踪。

  • 评估主要是 document QA 中的图文场景,不覆盖 M3KG-RAG - Multi-hop Multimodal Knowledge Graph-enhanced RAG 那类 audio / video / audio-video temporal grounding。

  • SpecLink 最终 alignment 仍依赖 LLM 判断;如果视觉实体描述、文本实体抽取或 relation weight 评估出错,错误会进入 MMKG。

  • Image2Graph 依赖 YOLO / MLLM prompt pipeline。论文没有给出完整的索引时间、VRAM、API 调用成本和失败率表。

  • 基线 GraphRAG 为了公平比较移除了 community detection,仅使用 local querying;这不等同于所有 GraphRAG 部署形态。

  • CMEL 数据集虽然公开,但论文中仍提到 anonymized supplementary materials;数据构建依赖半自动流程和人工抽检,长尾视觉实体的标注质量仍需复核。

  • 论文强调 reasoning path,但没有给出足够细的 path-level attribution 指标,例如 retrieved path precision、final-used path、alignment error type。

  • 作者方向:

    • 扩展 CMEL 数据集,覆盖更复杂、更真实的跨模态实体对齐场景。
    • 改进视觉 scene graph 生成和跨模态 entity linking,使 MMKG 更细粒度、更可靠。
    • 继续用显式图结构支持可解释多模态推理。
  • Agent 推断的 Research Opportunities:

    • 建立 MMGraphRAG 日志 schema:记录 visual_entity、feature_block_id、text_entity_candidates、SpecLink_cluster、LLM_alignment_decision、aligned_entity、global_image_entity、retrieved_path、final_used_path。
    • 把 M3KG-RAG - Multi-hop Multimodal Knowledge Graph-enhanced RAG 的 audio / visual grounding、MMGraphRAG 的 image-text CMEL、SEM-RAG - Structure-Preserving Multimodal Graph Compilation 的 table/formula/layout primitives 放进同一个 OP-19 评测框架。
    • 做 graph-interface router:text-only query 走普通 GraphRAG 或 RAG;image-text entity alignment query 走 MMGraphRAG;audio-video grounding query 走 M3KG-RAG 风格;table/formula query 走 SEM-RAG 风格。
    • 增加 alignment-error diagnosis:区分 segmentation miss、visual entity description error、text entity extraction miss、SpecLink candidate miss、LLM final alignment error、global image entity mismatch。
    • 将 unanswerable / insufficient evidence 作为多模态 GraphRAG 的核心指标,而不只看 answer accuracy。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:MMGraphRAG: Bridging Vision and Language with Interpretable Multimodal Knowledge Graphs
  • 中文标题:MMGraphRAG:用可解释多模态知识图谱连接视觉与语言
  • 作者:Xueyao Wan, Hang Yu
  • 机构:Harbin Institute of Technology, Nanyang Technological University
  • 年份:2025
  • 版本:arXiv v2,2026-03-10 更新;初版 2025-07-28
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:https://github.com/wanxueyao/MMGraphRAG ,GitHub API 检查时为 Apache-2.0,90 stars,2026-06-05 更新。
  • Semantic Scholar:paperId db66858be469b8d782283f1e2ba6e6e4b9b565a4,检查时 citationCount 11,influentialCitationCount 1。
  • 阅读状态:PDF级
  • 所属方向:multimodal GraphRAG、node-based MMKG、cross-modal entity linking、scene graph、document QA
  • 优先级:P1

Background

  • 研究问题:传统 GraphRAG 主要围绕文本 entity KG 和 community summary 展开,难以把图片中的对象、局部区域、视觉关系和文本实体放进同一个可遍历图结构。
  • 为什么重要:多模态文档 QA 常依赖图片、表格、版面和文字共同给出答案。若只把图像 caption 成文本,细粒度对象和空间关系会被压扁;若只用 shared embedding,模型能检索相似视觉语义,但很难解释“哪个视觉实体和哪个文本实体被连接”。
  • 现有路线:
    • Image captioning 把视觉内容线性化成一段文本,丢失显式视觉结构。
    • Shared embedding MRAG 把图像和文本投到统一向量空间,容易 semantic flattening,且缺少可解释推理路径。
    • Joint extraction 或约束式对齐依赖任务特定标注和启发式规则,泛化性受限。
  • 对本知识库的意义:MMGraphRAG 补上 M3KG-RAG - Multi-hop Multimodal Knowledge Graph-enhanced RAG 和 SEM-RAG - Structure-Preserving Multimodal Graph Compilation 之间的空白:它不处理 audio-video grounding,也不专注表格公式编译,而是强调 image scene graph 与 text KG 的 cross-modal entity linking。

MMGraphRAG-fig1-fusion-methods

Figure 1 把四种路线放在一起:captioning 快但丢细节,joint extraction 依赖标注,shared embedding 缺显式关系;MMGraphRAG 的关键是把 logo、football 等视觉对象作为图节点,并和文本实体建立可解释边。

Gap

  • Text-only GraphRAG 不能把视觉对象作为 first-class graph node,因此无法表达“图片实体 -> 文本实体 -> 文档事实”的跨模态路径。
  • 普通多模态 RAG 依赖 embedding similarity,不能保证实体 presence、视觉关系和文本指代真的对齐。
  • 现有 CMEL benchmark 多偏合成 3D 场景,缺少真实新闻、论文、小说等复杂文档中的细粒度 image-text entity alignment 数据。
  • 图像 caption 会把局部对象、feature block、对象间关系和全局图像语义压成一句话,导致后续 GraphRAG 看不到结构。
  • Unanswerable 问题尤其容易暴露 shared embedding 的噪声:语义相邻但不支持答案的图片证据会诱导模型生成看似合理的错误答案。

Insight

  • 一句话创新点:MMGraphRAG 把图片解析成 scene graph,再用 SpecLink 在视觉实体和文本实体之间生成高质量候选对齐,最终构建 node-based MMKG,让检索可以沿跨模态图路径取证据,而不是只用 caption 或 shared embedding。
  • 核心洞察:
    • 多模态 GraphRAG 不应把图片当作实体属性,而应采用 node-based MMKG:视觉内容本身成为节点,才能承载关系和推理路径。
    • Cross-modal fusion 的瓶颈不是最终 LLM 推理,而是候选对齐:如果视觉实体和文本实体连接错,后续检索会把噪声当证据。
    • SpecLink 的价值在于同时利用语义相似度和图结构关系,避免纯 KNN/KMeans 只看 embedding 或纯 graph clustering 在稀疏图中失效。
    • MMKG 的收益主要来自可追踪的跨模态连接:系统能说明 visual node 如何连接到 text entity,再如何进入回答上下文。

Method

1. 总体框架:从多模态文档到 MMKG 检索

MMGraphRAG-fig2-framework

输入:包含文本和图片的文档集合,例如网页、小说、PDF 文档:

D=\{D_i^{text},D_i^{image}\}_{i=1}^{N}

计算链路:

  1. Preprocessing:用 MinerU 等工具解析文档,分离文本 chunk 和图片。
  2. Text2Graph:对文本 chunk 做实体和关系抽取,得到 text KG。
  3. Image2Graph:对图片做分割、描述、实体关系抽取和局部/全局图像节点构建,得到 image KG。
  4. Cross-Modal KG Fusion:用 SpecLink 生成候选跨模态实体对,再由 LLM 做最终 entity alignment;之后增强未对齐视觉实体、对齐全局图像实体、融合表示。
  5. Retrieval and Generation:在统一 MMKG 上检索结构化跨模态上下文;LLM 负责文本逻辑和回答组织,MLLM 负责图像检索结果处理。

输出:可被多轮 query 复用的 multimodal knowledge graph,而不是每个 query 临时构图。

直观解释:MMGraphRAG 把索引阶段做重,把 text KG 和 image KG 提前融合;query-time 主要沿 MMKG 检索跨模态实体、关系和文本 chunk。

2. Image2Graph:把图片变成图节点和关系

MMGraphRAG-fig3-img2graph

输入:图片 $I_i$。

计算链路:

  1. Semantic segmentation:用 YOLO 把图片切成语义独立的 image feature blocks:
B(I_i)=\{b_1,b_2,\ldots,b_K\}
  1. Feature block description:MLLM 为每个 feature block 生成类别、属性和细粒度描述。
  2. Visual entity and relation extraction:MLLM 从图片中抽取视觉实体和关系:
G_{img}(I_i)=(E_{img}(I_i),R_{img}(I_i))
  1. Feature block alignment:把分割出的局部区域和抽取出的视觉实体对齐,使实体能追溯到图像区域。
  2. Global image entity:构造描述整张图片的全局实体,并和局部实体连接。

输出:带有局部视觉实体、全局图像实体、实体描述和视觉关系的 image-based KG。

直观解释:这一步避免把图片直接压成 caption。图片中的 girl、camera、railing 等都成为节点,holding / appears close 等显式或隐式关系成为边。

3. CMEL + SpecLink:视觉实体和文本实体如何对齐

MMGraphRAG-speclink-formulas

输入:

  • 图片集合 $I={I_1,I_2,\ldots,I_N}$。
  • 每张图片中的视觉实体:
E(I_i)=\{e_1^{(I_i)},e_2^{(I_i)},\ldots,e_K^{(I_i)}\}
  • 文本 chunk 集合 $T={T_1,T_2,\ldots,T_M}$。
  • 每个文本 chunk 中的文本实体:
E(T_j)=\{e_1^{(T_j)},e_2^{(T_j)},\ldots,e_L^{(T_j)}\}

计算链路:

  1. 候选生成:对每个视觉实体 $e_k^{(I_i)}$,先在上下文相邻文本 chunk 的实体池中生成候选集合:
C(e_k^{(I_i)})\subseteq \bigcup_{\ell=j-1}^{j+1}E(T_\ell)
  1. SpecLink 构造带权邻接矩阵,把语义相似度和图关系权重合并:
A_{pq}=sim(v_p,v_q)\cdot weight(r_{pq})

其中 $v_p$ 是实体 $e_p$ 的 embedding,$sim(\cdot)$ 是余弦相似度,$r_{pq}$ 是实体间关系,$weight(r_{pq})$ 是由 LLM 判断的关系重要性;若无关系,则 $weight(r_{pq})=1$。

  1. 计算度矩阵:
D_{pp}=\sum_q A_{pq}
  1. 按 spectral clustering 流程做 Laplacian 分解,取最小 $m$ 个特征向量组成:
Q=[u_1,\ldots,u_m]
  1. 在 $Q$ 的行空间上用 DBSCAN 得到聚类:
Cluster(Q)=\{C_1,C_2,\ldots,C_n\}
  1. 对视觉实体选择最相关 cluster $C_{c^*}$,并把其中实体作为候选:
C(e_k^{(I_i)})=\{e_p\mid e_p\in C_{c^*}\}
  1. 最终对齐由 LLM 在候选集合中选择,形式上是:
A(e_k^{(I_i)})=\arg\max_{e\in C(e_k^{(I_i)})} f(e_k^{(I_i)},e)

输出:视觉实体到文本实体的对齐结果。

直观解释:SpecLink 先用 spectral clustering 缩小候选范围,再让 LLM 做最终判断。这样避免让 LLM 在全量文本实体里盲选,也比纯 embedding similarity 更能利用图结构。

4. Cross-Modal Fusion:从对齐结果到统一 MMKG

MMGraphRAG-algorithm1-fusion

输入:

  • imgdata:图片数据和图片解析结果。
  • chunks:文本 chunk。
  • tkg:Text2Graph 生成的 text KG。
  • ikg:Image2Graph 生成的 image KG。

计算链路:

  1. FIND(imgdata, image) 找到当前图片对应的 image KG。
  2. ALIGN(tkg, ikg) 用 SpecLink + LLM 得到视觉实体和文本实体对齐列表 $list^a$。
  3. ENHANCE(list^a, ikg, tkg, chunks) 对未对齐视觉实体做语义增强,把原始文本上下文补进视觉实体描述。
  4. UPDATE(ikg_e,tkg,image,chunks) 对齐全局 image entity;若找不到对应文本实体,则从相关文本 chunk 中补建新实体。
  5. MERGE(ikg_u,tkg,list^a) 把增强后的 image KG、updated text KG 和对齐列表合并成最终 MMKG。
  6. 用最终 MMKG 构建 entity vector database,供检索阶段使用。

输出:

MMKG=Merge(G_{text},G_{image},A_{cross})

其中 $A_{cross}$ 是跨模态实体对齐边,包含局部视觉实体对齐、全局图像实体对齐和实体融合后的统一表示。

直观解释:这一步不是简单把 image KG 和 text KG 拼接,而是处理三类关键问题:已对齐实体融合、未对齐视觉实体增强、全局图像语义对齐。

5. Retrieval and Generation:沿跨模态路径生成回答

输入:用户问题 $q$、构建好的 $MMKG$、文本 chunk、图片检索结果。

计算链路:

  1. 在 MMKG 的 entity vector database 中检索相关实体和关系。
  2. 沿跨模态推理路径组织上下文:
C(q)=C_{text}\cup C_{visual}\cup C_{path}

其中 $C_{path}$ 是由 visual node、text entity、relation 和 chunk 组成的结构化路径上下文。

  1. LLM 负责文本逻辑和最终回答结构,MLLM 处理图像检索结果。
  2. 多模态响应合并阶段把 LLM/MLLM 输出合成统一答案。

输出:带有跨模态结构证据支撑的回答。

直观解释:MMGraphRAG 的检索不是“取最相似图片或文本”,而是把图片实体和文本实体之间的对齐边作为可追踪路径,用结构化证据约束生成。

Results

MMGraphRAG-table1-cmel-results

Table 1 使用 micro / macro accuracy。整体结果:

  • Embedding baseline:20.0 / 16.8
  • LLM baseline:27.1 / 27.0
  • DBSCAN:45.2 / 46.1
  • KMeans:45.2 / 43.0
  • PageRank:44.1 / 45.5
  • Leiden:44.8 / 43.6
  • SpecLink:51.8 / 59.2

解读:SpecLink 的优势主要在 macro accuracy,说明它不只是靠实体数量多的文档拉高平均,而是在不同文档/领域上更稳定。论文还报告相对最强 baseline 的提升在 paired bootstrap 下显著,$p<0.01$。

2. DocBench / MMLongBench 主结果支持显式 MMKG

MMGraphRAG-table2-table3-main-results

DocBench:

  • NaiveRAG(Q):59.5 overall accuracy。
  • GraphRAG(Q):52.3 overall accuracy。
  • MMGraphRAG(Q-Iv):76.8 overall accuracy。
  • MMGraphRAG(L-Iv):77.5 overall accuracy。
  • 多模态问题上,MMGraphRAG(Q-Iv) 达到 88.7,明显高于 NaiveRAG(Q) 30.5 和 GraphRAG(Q) 26.0。

MMLongBench:

  • NaiveRAG(Q):26.2 overall accuracy。
  • GraphRAG(Q):28.1 overall accuracy。
  • MMGraphRAG(Q-Iv):38.8 overall accuracy。
  • 论文摘要还报告 MMGraphRAG 在 MMLongBench 上达到 34.1 F1。

解读:MMGraphRAG 的收益集中在 multimodal / chart / table / figure / layout 等视觉结构相关问题。纯 MLLM 直接看图并不强,说明“能看图”不等于“能在长文档中把视觉实体和文本证据接起来”。

3. 融合模块和显式 MMKG 都是关键组件

MMGraphRAG-fig6-table4-ablation-m3docrag

Figure 6 的消融显示:

  • Naive fusion 对 text-only 问题会引入噪声,Txt accuracy 从 full fusion 的 72.9 降到 62.5。
  • Multimodal 问题上,text-only GraphRAG 为 33.8,naive fusion 为 38.7,full MMGraphRAG 为 54.3;完整 cross-modal fusion 相比 naive fusion 带来 +15.6,相比 text-only GraphRAG 带来 +20.5。
  • Unanswerable 问题上,full fusion 达到 75.0,而 naive fusion 为 47.1,说明错误对齐视觉信息会加剧 hallucination。

Table 4 对比 M3DOCRAG:

  • Overall accuracy:M3DR 21.0,MMGraphRAG 26.5。
  • Unanswerable:M3DR 5.8,MMGraphRAG 35.1。
  • Chart / Table:M3DR 18.9 / 20.1,MMGraphRAG 21.1 / 27.1。

解读:显式 MMKG 的关键收益不是所有维度都碾压,而是显著提升 unanswerable 和需要跨模态结构判断的问题。它能让系统更可靠地判断“证据不足”,而不是被 embedding 近邻诱导回答。

4. 评估可靠性补充

  • 论文用 Llama3.1-70B-Instruct 作为自动 judge。
  • 人工一致性抽样显示:DocBench agreement 96.0%,Cohen's $\kappa=0.882$;MMLongBench agreement 94.6%,$\kappa=0.876$。
  • 这说明 judge 在该设置下可用,但仍不能完全替代人工证据核查,尤其是跨模态 grounding 是否真的被图像支持。

Limitations

  • 论文仍是 arXiv 预印本,PDF 模板中保留了占位会议名;正式发表状态需要后续跟踪。
  • 评估主要是 document QA 中的图文场景,不覆盖 M3KG-RAG - Multi-hop Multimodal Knowledge Graph-enhanced RAG 那类 audio / video / audio-video temporal grounding。
  • SpecLink 最终 alignment 仍依赖 LLM 判断;如果视觉实体描述、文本实体抽取或 relation weight 评估出错,错误会进入 MMKG。
  • Image2Graph 依赖 YOLO / MLLM prompt pipeline。论文没有给出完整的索引时间、VRAM、API 调用成本和失败率表。
  • 基线 GraphRAG 为了公平比较移除了 community detection,仅使用 local querying;这不等同于所有 GraphRAG 部署形态。
  • CMEL 数据集虽然公开,但论文中仍提到 anonymized supplementary materials;数据构建依赖半自动流程和人工抽检,长尾视觉实体的标注质量仍需复核。
  • 论文强调 reasoning path,但没有给出足够细的 path-level attribution 指标,例如 retrieved path precision、final-used path、alignment error type。

Future Directions

  • 作者方向:
    • 扩展 CMEL 数据集,覆盖更复杂、更真实的跨模态实体对齐场景。
    • 改进视觉 scene graph 生成和跨模态 entity linking,使 MMKG 更细粒度、更可靠。
    • 继续用显式图结构支持可解释多模态推理。
  • Agent 推断的 Research Opportunities:
    • 建立 MMGraphRAG 日志 schema:记录 visual_entity、feature_block_id、text_entity_candidates、SpecLink_cluster、LLM_alignment_decision、aligned_entity、global_image_entity、retrieved_path、final_used_path。
    • 把 M3KG-RAG - Multi-hop Multimodal Knowledge Graph-enhanced RAG 的 audio / visual grounding、MMGraphRAG 的 image-text CMEL、SEM-RAG - Structure-Preserving Multimodal Graph Compilation 的 table/formula/layout primitives 放进同一个 OP-19 评测框架。
    • 做 graph-interface router:text-only query 走普通 GraphRAG 或 RAG;image-text entity alignment query 走 MMGraphRAG;audio-video grounding query 走 M3KG-RAG 风格;table/formula query 走 SEM-RAG 风格。
    • 增加 alignment-error diagnosis:区分 segmentation miss、visual entity description error、text entity extraction miss、SpecLink candidate miss、LLM final alignment error、global image entity mismatch。
    • 将 unanswerable / insufficient evidence 作为多模态 GraphRAG 的核心指标,而不只看 answer accuracy。

与本知识库的连接

一句话定位

MMGraphRAG 的核心价值是把图片从“caption 或 embedding 属性”提升为 MMKG 中的一等节点:先用 Image2Graph 保留视觉对象和关系,再用 SpecLink 把视觉实体和文本实体对齐,最后沿跨模态图路径检索证据,从而提升多模态文档 QA 的可解释性、unanswerable 判断和结构化推理能力。