GGraphRAG 文献图谱自动同步
LIT-55268E9E · 2026

SEM-RAG - Structure-Preserving Multimodal Graph Compilation

SEM-RAG 把电信标准先编译成可执行图原语,包括层级文本、条件表格子图和公式算子图,再用结构熵最小化构建层级索引,避免递归 LLM 聚类,并通过 JSD 对齐和轻量路由把自然语言问题映射到合适子图。

PDF 级阅读卡优先级 P1Yuzhi Yang, Lina Bariah, Yuhuan Lu, Hang Zou, Mérouane DebbaharXiv 预印本,PDF 未声明正式录用 venue。
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:电信标准文档不是普通文本语料。3GPP / O-RAN 规范中大量知识藏在层级条款、密集表格、条件脚注、公式、单位、release tag 和跨条款引用中。若把它们直接 flatten 成文本 chunk,RAG 会保留词面相似性,但丢掉行列绑定、条件逻辑和公式算子结构。
  • 为什么重要:电信问答中的小错误可能导致错误的 capability 判断、slice 配置或服务故障。此类任务常要求精确读取参数表、公式阈值、协议条件,而不是泛化描述。
  • 现有方法:
    • Naive RAG 成本低,但会把表格和公式压成一维文本。
    • RAPTOR / hierarchical text RAG 能组织长上下文,但 hierarchy 仍建立在文本摘要上。
    • GraphRAG 支持关系检索和多跳遍历,但如果 ingest 阶段已丢失表格/公式结构,后续图遍历无法可靠恢复。
  • 对本知识库的意义:SEM-RAG 是 2026-06-09-Open-Problems OP-19 的直接 PDF 级证据。它补上 M3KG-RAG 之外的另一条多模态 GraphRAG 线索:不是 audio-visual grounding,而是 table / formula / layout / conditional logic 的 structure-preserving graph compilation。

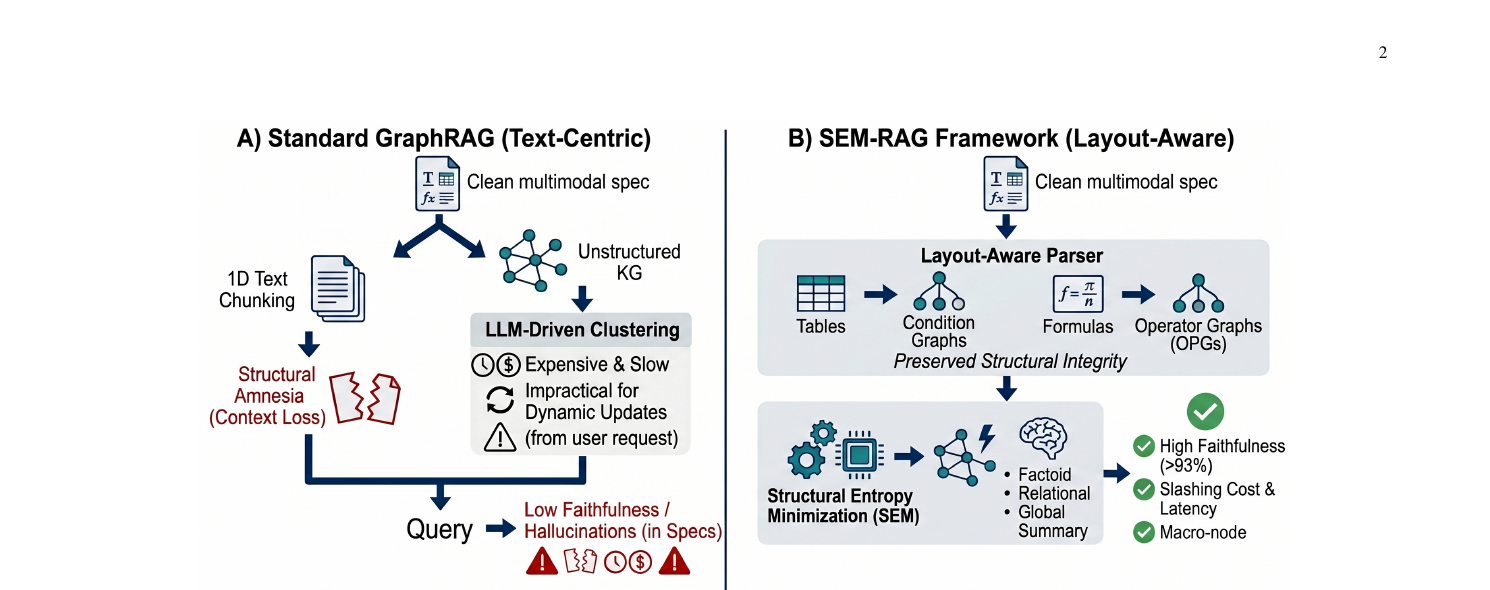
Figure 1 清楚展示了核心差异:标准 GraphRAG 先做 text chunking,再在丢失结构后的文本图上做 LLM-driven clustering;SEM-RAG 先把表格编译成 condition graph、公式编译成 operator graph,再用 Structural Entropy Minimization 构造层级索引。

  • Structural amnesia:文本 chunking 保留 token 顺序,但忽略二维表格邻接、header inheritance、条件脚注和公式 operator precedence。系统“记得词”,但不记得这些词如何绑定成可执行约束。
  • 现有 GraphRAG 的 ingest 仍偏 text-first:图节点和边常来自已经 flatten 的文本,因此即使后续有多跳 traversal,也只能在不完整结构上补救。
  • LLM-driven hierarchy 成本高:标准 GraphRAG 常对每层 community 递归调用 LLM summarization,更新频繁的标准语料会带来高 token 成本和 re-indexing latency。
  • 只靠更强 embedding 或更长上下文不能恢复 row-column binding:检索到正确页面仍可能选错表格单元格、忽略 footnote condition 或误解公式符号。
  • 结构保真与在线成本之间存在张力:若把每个表格单元、公式符号和条件都转成图节点,图会更大,需要一个低成本层级压缩和 query routing 机制。

方法与机制

1. 目标语料表示:文本、表格和公式三类模态

输入:电信标准语料

D=\{D_1,D_2,\ldots,D_N\}

每篇文档包含三类源模态:

D_i=\{X_i^{text},X_i^{tab},X_i^{eq}\}

其中:

  • $X_i^{text}$:层级条款和段落;
  • $X_i^{tab}$:带 row / column span 的关系表格;
  • $X_i^{eq}$:展示公式。

编译器输出:

\Phi(D_i)=\{T_i,C_i,F_i\}

其中 $T_i$ 是 hierarchical paragraph primitives,$C_i$ 是 conditional-logic table subgraphs,$F_i$ 是 formula graph primitives。

最终合并为基础多模态图:

G_0=(V,E,\tau,\rho,\psi)

其中 $\tau$ 记录节点类型,$\rho$ 记录边关系类型,$\psi$ 保存 source coordinates、clause identifiers、units、release tags 等 provenance 属性。

输出:结构信息尚未压缩的 base multimodal graph $G_0$。

2. Structure-Preserving Compiler:把表格和公式转成可执行图原语

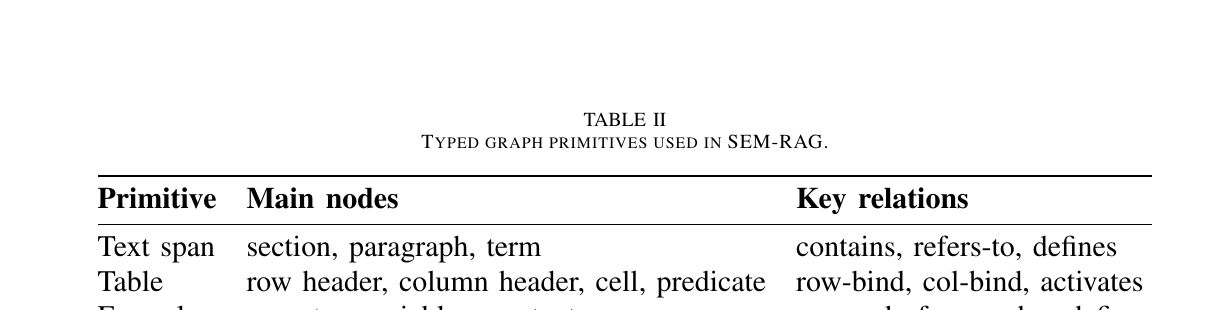
Table II 定义三类 typed graph primitives:

  • Text span:section、paragraph、term,通过 contains、refers-to、defines 连接。
  • Table:row header、column header、cell、predicate,通过 row-bind、col-bind、activates 连接。
  • Formula:operator、variable、constant,通过 operand-of、precedes、defines 连接。

2.1 Table-to-graph conversion

输入:一个表格实例 $b\in X_i^{tab}$,包含 row headers $H^r$、column headers $H^c$、data cells $X$、optional predicates $P$。

计算:构造 conditional-logic table subgraph:

C(b)=(V_b,E_b)

节点集合:

V_b=H^r\cup H^c\cup X\cup P

边集合:

E_b=\{(h_i^r,x_{ij})\}\cup\{(h_j^c,x_{ij})\}\cup\{(p_{ij},x_{ij})\}\cup E_{src}

其中 $E_{src}$ 把 cell 链回 clause / page coordinates。

输出:每个表格单元格都带 row-header path、column-header path、predicate、unit、release tag 和 provenance。表格查询不再是“检索某一行文本”,而是约束式遍历 header / predicate / cell。

2.2 Formula-to-graph mapping

输入:公式实例 $e\in X_i^{eq}$ 及其 abstract syntax tree $A_e$。

计算:构造公式算子图:

F(e)=(U_e\cup K_e\cup O_e,E_e^{op}\cup E_e^{def})

其中 $U_e$ 是变量节点,$K_e$ 是常量节点,$O_e$ 是 operator nodes;$E_e^{op}$ 保留 operand order 和 precedence,$E_e^{def}$ 把符号链接到附近文本定义。

输出:公式不再只是 LaTeX 字符串,而是可检索的 operator graph,可定位子表达式和符号含义。

3. Entropy-Guided Hierarchical Compression:用 SEM 替代递归 LLM 聚类

输入:已编译的基础图 $G_0$。

计算:先定义一维结构熵:

H^1(G)=-\sum_{i=1}^{|V|}\frac{d_i}{V_G}\log_2\frac{d_i}{V_G}

给定 partition tree $P={C_1,C_2,\ldots,C_k}$,二维结构熵为:

H^2(G,P)= \sum_{j=1}^{k}\frac{V_{C_j}}{V_G} \left( -\sum_{v_i\in C_j}\frac{d_i}{V_{C_j}}\log_2\frac{d_i}{V_{C_j}} \right) -\sum_{j=1}^{k}\frac{g_j}{V_G}\log_2\frac{V_{C_j}}{V_G}

其中 $V_{C_j}$ 是 community volume,$g_j$ 是 $C_j$ 到图外的 cut edges 数。

SEM 从 singleton communities 开始,反复合并能最大降低 $H^2$ 的相邻 community。合并过程只用图结构,不调用 LLM。层级固定后,只为少量 top-level communities 生成自然语言 label / summary。

输出:hierarchical encoding tree $P^*$。

直观解释:SEM-RAG 仍保留层级索引,但 hierarchy 来自结构熵压缩,而不是每层社区都让 LLM 写摘要。

4. Retrieval-Space Alignment:把自然语言查询对齐到图原语

输入:

  • 节点 $v$ 的拓扑特征 $z_v$,由轻量 GNN 得到;

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

1. 总体性能:TeleQnA 和 ORAN-Bench-13K 上明显领先

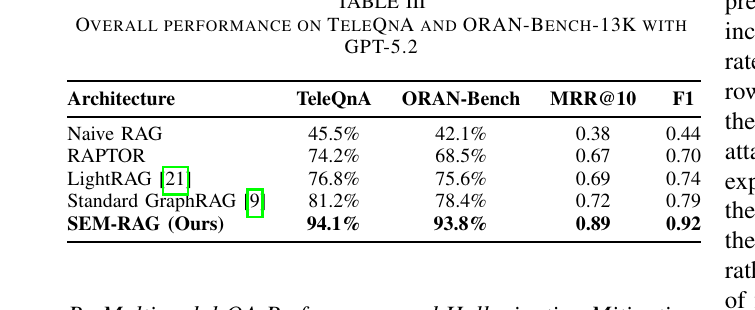
Table III 使用 GPT-5.2 作为主生成模型。SEM-RAG 达到:

  • TeleQnA accuracy:94.1%,高于 Standard GraphRAG 81.2%。
  • ORAN-Bench-13K accuracy:93.8%,高于 Standard GraphRAG 78.4%。
  • MRR@10 / F1:0.89 / 0.92,高于 Standard GraphRAG 0.72 / 0.79。

解读:增益不是只出现在某个结构子集;在混合了 acronym、程序性、表格、公式问题的完整 benchmark 上,结构保真编译仍能提升整体检索质量。

2. 结构敏感子集:表格和公式问题收益最大

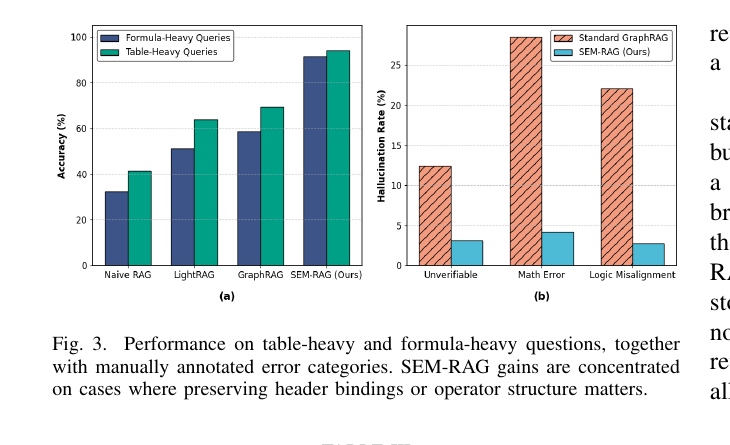
Figure 3 的关键读法:

  • Formula-heavy subset 上,LightRAG 和 Standard GraphRAG 分别约 51.2% / 58.7%,SEM-RAG 达到 91.5%。
  • 错误分析中,Standard GraphRAG 的 mathematical inconsistency 为 28.5%,row/column logic error 为 22.1%;SEM-RAG 将 row/column logic error 降到 2.8%。

解释:这正对应 structural amnesia。普通检索可能找到同一页或相邻段落,但无法稳定绑定 row header、column header、predicate 和 cell value。

3. 多跳深度:压缩后仍保留可遍历结构

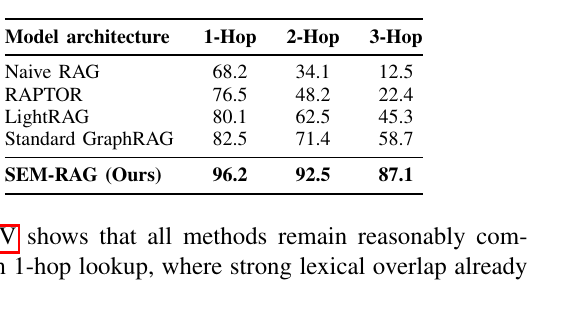
Table IV 按 1-hop / 2-hop / 3-hop 支持路径分层。3-hop 场景下:

  • Naive RAG:12.5%
  • RAPTOR:22.4%
  • LightRAG:45.3%
  • Standard GraphRAG:58.7%
  • SEM-RAG:87.1%

解读:SEM 压缩没有把跨 clause、term、table-cell、symbol-definition 的路径抹掉。它保留了 dense local neighborhoods,使中等深度的 typed traversal 仍可用。

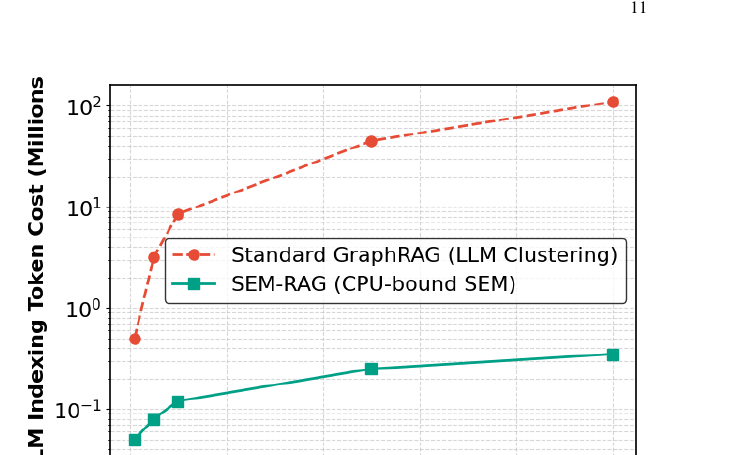
4. 索引成本:LLM token 和时间随规模分叉

Table V / Figure 4 显示,1,000,000 entities 时:

  • Standard GraphRAG:110.0M tokens,78.2 hours。
  • SEM-RAG:0.35M tokens,0.68 hours。

解读:SEM-RAG 不是说图构建免费,而是把 hierarchy construction 从递归 LLM summarization 迁移到图拓扑优化。LLM 只在层级固定后为少量 top-level communities 生成 label / summary。

5. 在线延迟:结构保真不必导致慢检索

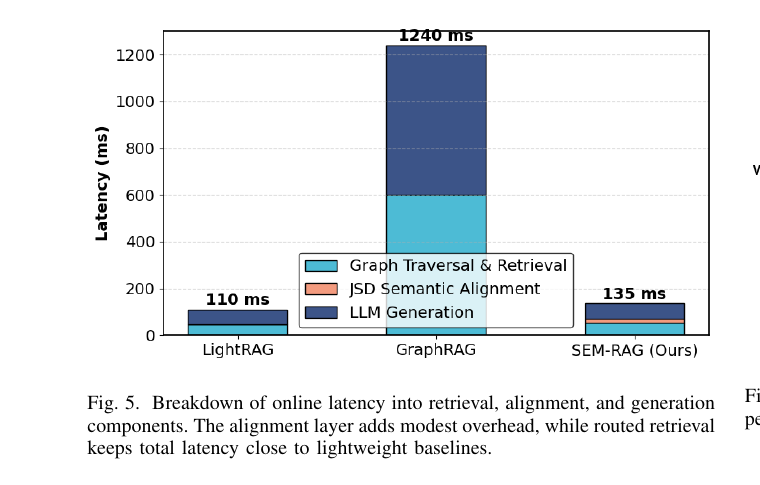
Figure 5 显示 SEM-RAG 总在线延迟约 135ms,接近 LightRAG 的 110ms,明显低于 Standard GraphRAG 的 1240ms。JSD alignment 约 18ms,是可控开销。

解释:router 避免所有问题都走完整图扩展。factoid query 直接 lookup,关系问题才扩 bounded subgraph,高层问题才访问 macro-node。

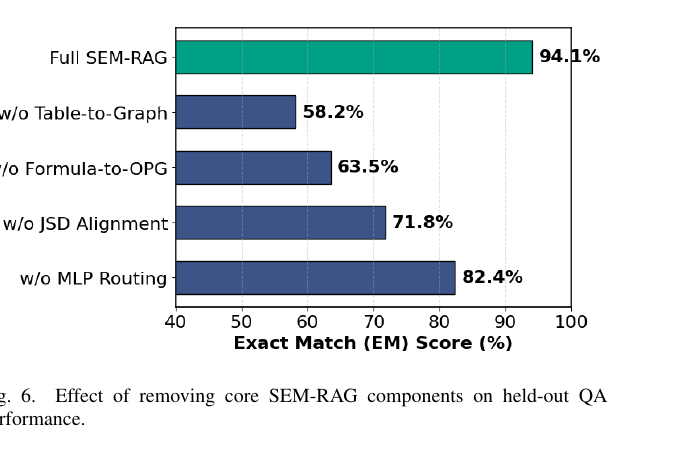
6. 消融:核心收益来自 table / formula compiler

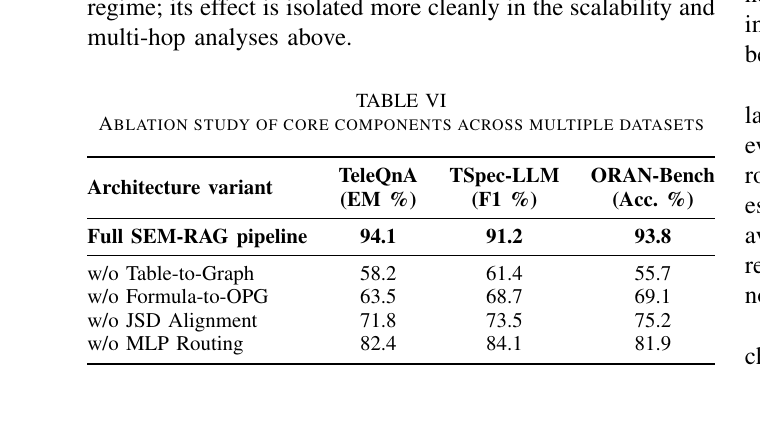
Table VI 显示:

  • Full SEM-RAG:TeleQnA 94.1,TSpec-LLM 91.2,ORAN-Bench 93.8。
  • 去掉 Table-to-Graph:58.2 / 61.4 / 55.7。
  • 去掉 Formula-to-OPG:63.5 / 68.7 / 69.1。
  • 去掉 JSD Alignment:71.8 / 73.5 / 75.2。
  • 去掉 MLP Routing:82.4 / 84.1 / 81.9。

解读:table compiler 和 formula compiler 是硬依赖;alignment 和 routing 也有价值,但不是主收益来源。这支持论文的主张:SEM-RAG 的核心是结构保持编译,而不是 query-time heuristic。

7. 跨模型稳定性:收益不是某个闭源模型的 prompt 偶然性

Table VII 在 TeleQnA 上固定检索管线,只替换生成模型。SEM-RAG 相对 Naive RAG 的绝对增益在四个模型上都接近 50 points:

  • GPT-5.2:+48.6
  • Claude 3.5 Sonnet:+49.6
  • LLaMA-3-70B:+50.8
  • Mistral-Large:+50.1

解读:收益主要来自提供给 generator 的证据结构更好,而不是某个模型对提示词特别敏感。

局限与开放问题

  • 论文不提供 end-to-end answer correctness 的形式化保证;复杂度分析只覆盖 indexing / retrieval budget。

  • 编译图会继承上游 parsing errors,尤其是低质量 PDF、复杂嵌套 annex tables、跨页表格和 OCR 错误。

  • 当前 compiler 主要处理 text、tables、formulas;message sequence charts 和工程图只通过周边文本和 provenance 弱表示。

  • 所有实验都在 telecom standards 上完成,跨领域迁移仍需验证,例如法律条文、医疗指南、金融合规手册或科学论文。

  • SEM-RAG 需要更丰富的 parser 和 typed graph construction,系统工程复杂度高于 text-only RAG。

  • PDF 未给出公开代码仓库,复现实验依赖自行实现 layout-aware parser、公式 AST、SEM merging、JSD alignment 和 router。

  • 论文使用 GPT-5.2 作为主生成模型,并使用 OpenAI text-embedding-3-large;在本地模型或更小 embedding 下的表现需要单独验证。

  • 作者方向:

    • 扩展 compiler 到 message sequence charts 和更丰富的 engineering diagrams。
    • 验证同一设计是否能迁移到其他 standards-heavy technical domains。
  • Agent 推断的 Research Opportunities:

    • 将 SEM-RAG 的 schema-preserving evidence record 固化为 GraphRAG 日志:clause / subject / relation / object / condition / provenance。
    • 在 QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples 的 operator diagnosis 中加入 table row-column binding 和 formula operator preservation。
    • 和 M3KG-RAG - Multi-hop Multimodal Knowledge Graph-enhanced RAG 共同扩展 OP-19:M3KG 关注 audio-visual grounding,SEM-RAG 关注 layout / formula / conditional structure preservation。
    • 将 router 扩展成 graph-interface router:factoid lookup、typed subgraph expansion、symbolic table/formula execution、macro-node summary retrieval 分开评估。
    • 针对低质量 PDF / OCR 场景增加 parser confidence,并把 parser error 传播到 retrieval confidence。
    • 研究“结构熵压缩 vs 语义社区摘要”的混合方案:先用 SEM 保结构,再只对高层 macro-nodes 做少量 LLM semantic labeling。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:SEM-RAG: Structure-Preserving Multimodal Graph Compilation and Entropy-Guided Retrieval for Telecommunication Standards
  • 中文标题:SEM-RAG:面向电信标准的结构保持多模态图编译与熵引导检索
  • 作者:Yuzhi Yang, Lina Bariah, Yuhuan Lu, Hang Zou, Mérouane Debbah
  • 机构:Research Institute for Digital Future, Khalifa University
  • 年份:2026
  • 版本:arXiv v1,2026-05-09
  • 会议 / 期刊:arXiv 预印本,PDF 未声明正式录用 venue。
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:PDF 正文未给出公开代码仓库。
  • 阅读状态:PDF级
  • 所属方向:structure-preserving GraphRAG、telecom standards QA、layout-aware graph compilation、table/formula reasoning、structural entropy indexing
  • 优先级:P1

Background

  • 研究问题:电信标准文档不是普通文本语料。3GPP / O-RAN 规范中大量知识藏在层级条款、密集表格、条件脚注、公式、单位、release tag 和跨条款引用中。若把它们直接 flatten 成文本 chunk,RAG 会保留词面相似性,但丢掉行列绑定、条件逻辑和公式算子结构。
  • 为什么重要:电信问答中的小错误可能导致错误的 capability 判断、slice 配置或服务故障。此类任务常要求精确读取参数表、公式阈值、协议条件,而不是泛化描述。
  • 现有方法:
    • Naive RAG 成本低,但会把表格和公式压成一维文本。
    • RAPTOR / hierarchical text RAG 能组织长上下文,但 hierarchy 仍建立在文本摘要上。
    • GraphRAG 支持关系检索和多跳遍历,但如果 ingest 阶段已丢失表格/公式结构,后续图遍历无法可靠恢复。
  • 对本知识库的意义:SEM-RAG 是 2026-06-09-Open-Problems OP-19 的直接 PDF 级证据。它补上 M3KG-RAG 之外的另一条多模态 GraphRAG 线索:不是 audio-visual grounding,而是 table / formula / layout / conditional logic 的 structure-preserving graph compilation。

SEM-RAG-fig1-conceptual-comparison

Figure 1 清楚展示了核心差异:标准 GraphRAG 先做 text chunking,再在丢失结构后的文本图上做 LLM-driven clustering;SEM-RAG 先把表格编译成 condition graph、公式编译成 operator graph,再用 Structural Entropy Minimization 构造层级索引。

Gap

  • Structural amnesia:文本 chunking 保留 token 顺序,但忽略二维表格邻接、header inheritance、条件脚注和公式 operator precedence。系统“记得词”,但不记得这些词如何绑定成可执行约束。
  • 现有 GraphRAG 的 ingest 仍偏 text-first:图节点和边常来自已经 flatten 的文本,因此即使后续有多跳 traversal,也只能在不完整结构上补救。
  • LLM-driven hierarchy 成本高:标准 GraphRAG 常对每层 community 递归调用 LLM summarization,更新频繁的标准语料会带来高 token 成本和 re-indexing latency。
  • 只靠更强 embedding 或更长上下文不能恢复 row-column binding:检索到正确页面仍可能选错表格单元格、忽略 footnote condition 或误解公式符号。
  • 结构保真与在线成本之间存在张力:若把每个表格单元、公式符号和条件都转成图节点,图会更大,需要一个低成本层级压缩和 query routing 机制。

Insight

  • 一句话创新点:SEM-RAG 把电信标准先编译成可执行图原语,包括层级文本、条件表格子图和公式算子图,再用结构熵最小化构建层级索引,避免递归 LLM 聚类,并通过 JSD 对齐和轻量路由把自然语言问题映射到合适子图。
  • 核心洞察:
    • 表格和公式不能只作为文本片段进入 RAG,而应作为 graph primitives 进入索引。
    • 对电信标准,检索失败常发生在 ingestion 阶段;一旦 row/column/predicate/operator 信息丢失,query-time rerank 很难找回。
    • SEM 的作用不是替代语义理解,而是把已编译的 typed graph 压成可维护层级,让结构保真不被索引成本抵消。
    • Query-time controller 应只决定访问 direct lookup、bounded subgraph 还是 macro-node;核心知识质量来自编译图,而不是在线启发式。

Method

1. 目标语料表示:文本、表格和公式三类模态

输入:电信标准语料

D=\{D_1,D_2,\ldots,D_N\}

每篇文档包含三类源模态:

D_i=\{X_i^{text},X_i^{tab},X_i^{eq}\}

其中:

  • $X_i^{text}$:层级条款和段落;
  • $X_i^{tab}$:带 row / column span 的关系表格;
  • $X_i^{eq}$:展示公式。

编译器输出:

\Phi(D_i)=\{T_i,C_i,F_i\}

其中 $T_i$ 是 hierarchical paragraph primitives,$C_i$ 是 conditional-logic table subgraphs,$F_i$ 是 formula graph primitives。

最终合并为基础多模态图:

G_0=(V,E,\tau,\rho,\psi)

其中 $\tau$ 记录节点类型,$\rho$ 记录边关系类型,$\psi$ 保存 source coordinates、clause identifiers、units、release tags 等 provenance 属性。

输出:结构信息尚未压缩的 base multimodal graph $G_0$。

2. Structure-Preserving Compiler:把表格和公式转成可执行图原语

SEM-RAG-table2-typed-primitives

Table II 定义三类 typed graph primitives:

  • Text span:section、paragraph、term,通过 contains、refers-to、defines 连接。
  • Table:row header、column header、cell、predicate,通过 row-bind、col-bind、activates 连接。
  • Formula:operator、variable、constant,通过 operand-of、precedes、defines 连接。

2.1 Table-to-graph conversion

输入:一个表格实例 $b\in X_i^{tab}$,包含 row headers $H^r$、column headers $H^c$、data cells $X$、optional predicates $P$。

计算:构造 conditional-logic table subgraph:

C(b)=(V_b,E_b)

节点集合:

V_b=H^r\cup H^c\cup X\cup P

边集合:

E_b=\{(h_i^r,x_{ij})\}\cup\{(h_j^c,x_{ij})\}\cup\{(p_{ij},x_{ij})\}\cup E_{src}

其中 $E_{src}$ 把 cell 链回 clause / page coordinates。

输出:每个表格单元格都带 row-header path、column-header path、predicate、unit、release tag 和 provenance。表格查询不再是“检索某一行文本”,而是约束式遍历 header / predicate / cell。

2.2 Formula-to-graph mapping

输入:公式实例 $e\in X_i^{eq}$ 及其 abstract syntax tree $A_e$。

计算:构造公式算子图:

F(e)=(U_e\cup K_e\cup O_e,E_e^{op}\cup E_e^{def})

其中 $U_e$ 是变量节点,$K_e$ 是常量节点,$O_e$ 是 operator nodes;$E_e^{op}$ 保留 operand order 和 precedence,$E_e^{def}$ 把符号链接到附近文本定义。

输出:公式不再只是 LaTeX 字符串,而是可检索的 operator graph,可定位子表达式和符号含义。

3. Entropy-Guided Hierarchical Compression:用 SEM 替代递归 LLM 聚类

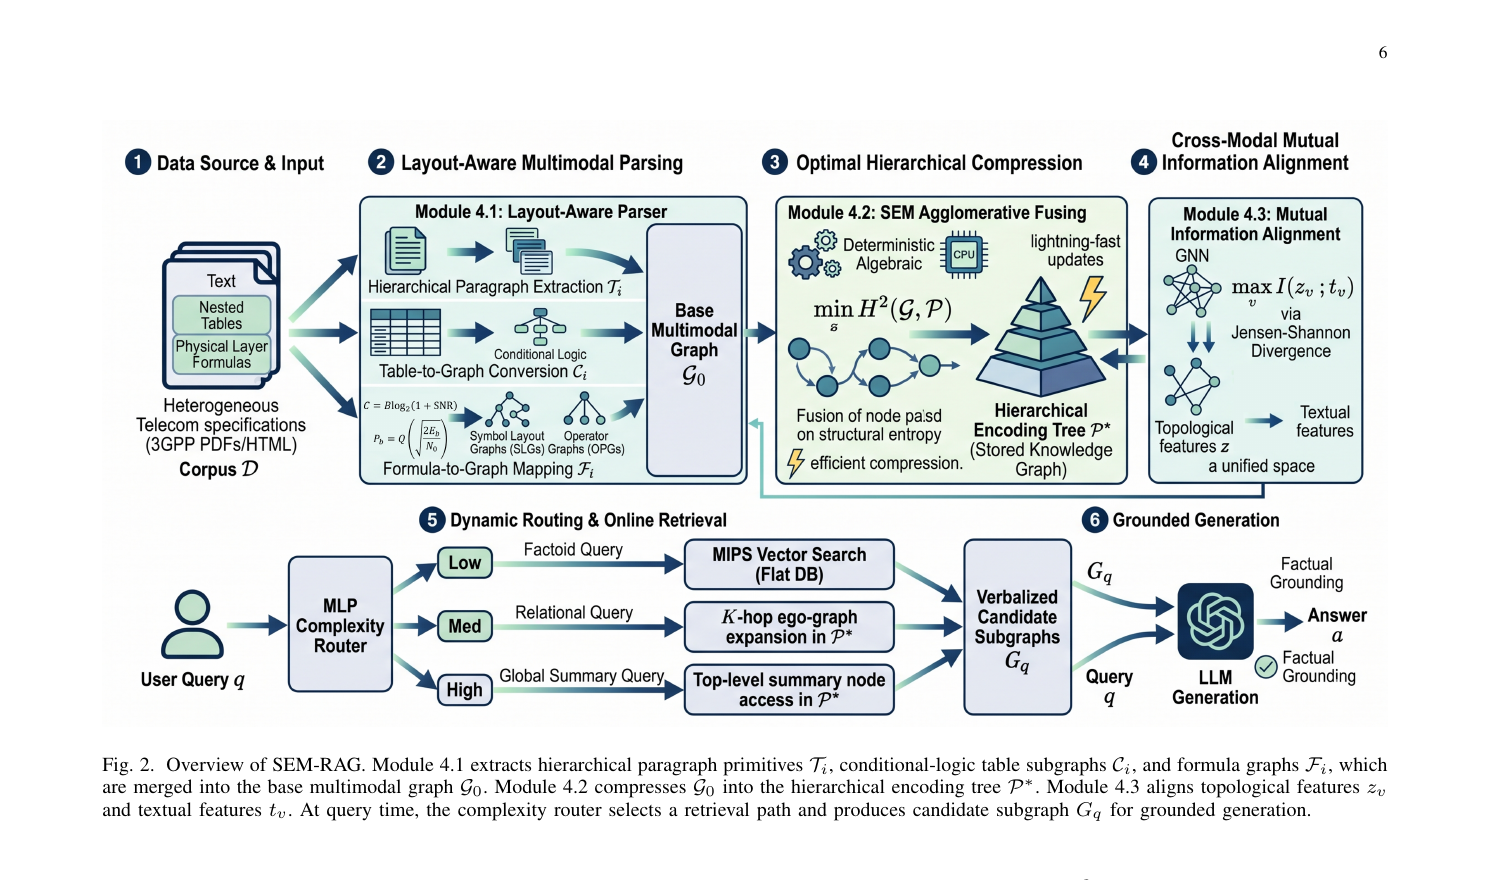
SEM-RAG-fig2-architecture

输入:已编译的基础图 $G_0$。

计算:先定义一维结构熵:

H^1(G)=-\sum_{i=1}^{|V|}\frac{d_i}{V_G}\log_2\frac{d_i}{V_G}

给定 partition tree $P={C_1,C_2,\ldots,C_k}$,二维结构熵为:

H^2(G,P)= \sum_{j=1}^{k}\frac{V_{C_j}}{V_G} \left( -\sum_{v_i\in C_j}\frac{d_i}{V_{C_j}}\log_2\frac{d_i}{V_{C_j}} \right) -\sum_{j=1}^{k}\frac{g_j}{V_G}\log_2\frac{V_{C_j}}{V_G}

其中 $V_{C_j}$ 是 community volume,$g_j$ 是 $C_j$ 到图外的 cut edges 数。

SEM 从 singleton communities 开始,反复合并能最大降低 $H^2$ 的相邻 community。合并过程只用图结构,不调用 LLM。层级固定后,只为少量 top-level communities 生成自然语言 label / summary。

输出:hierarchical encoding tree $P^*$。

直观解释:SEM-RAG 仍保留层级索引,但 hierarchy 来自结构熵压缩,而不是每层社区都让 LLM 写摘要。

4. Retrieval-Space Alignment:把自然语言查询对齐到图原语

输入:

  • 节点 $v$ 的拓扑特征 $z_v$,由轻量 GNN 得到;
  • 节点 $v$ 的文本特征 $t_v$,由 pretrained encoder 得到。

理想目标:最大化同一 primitive 的图视图与文本视图互信息:

\max \sum_{v\in V} I(z_v;t_v)

实际优化使用 JSD surrogate:

L_{align}=JSD(p_g(\cdot\mid v),p_t(\cdot\mid v))

训练时 matched graph/text pairs 拉近,mismatched pairs 通过 negative sampling 推开。

输出:自然语言 query 更容易 anchor 到正确 table / formula / paragraph primitive。

注意:论文明确把 JSD alignment 定位为 retrieval support module,不是核心表示学习贡献。核心仍是 parser-generated compiled graph。

5. Query-Time Controller:按复杂度选择检索路径

输入:用户 query $q$,以及廉价 query features:

  • detected entities 数;
  • symbolic tokens;
  • query length;
  • initial vector hits 的 entropy。

计算:MLP router 输出复杂度标签 $\ell\in{Low,Med,High}$。

三种路径:

  1. Low / Factoid mode:直接从 vector index 检索 paragraph / value nodes。
  2. Med / Relational mode:anchor entities,并扩展 bounded $K$-hop typed subgraph。
  3. High / Global mode:从 $P^*$ 检索少量 macro-nodes 和 summaries。

期望检索成本写作:

E[T_{ret}]= p_{low}O(\log |V|) +p_{med}O(|A_q|d_{eff}^{K_{max}}) +p_{high}O(M)

输出:候选子图 $G_q$。

最后不是把 raw graph dump 塞给 LLM,而是 verbalize 成 schema-preserving evidence records:

(clause,subject,relation,object,condition,provenance)

这些记录再和 query 一起进入生成模型。

6. Algorithm 1:端到端流程

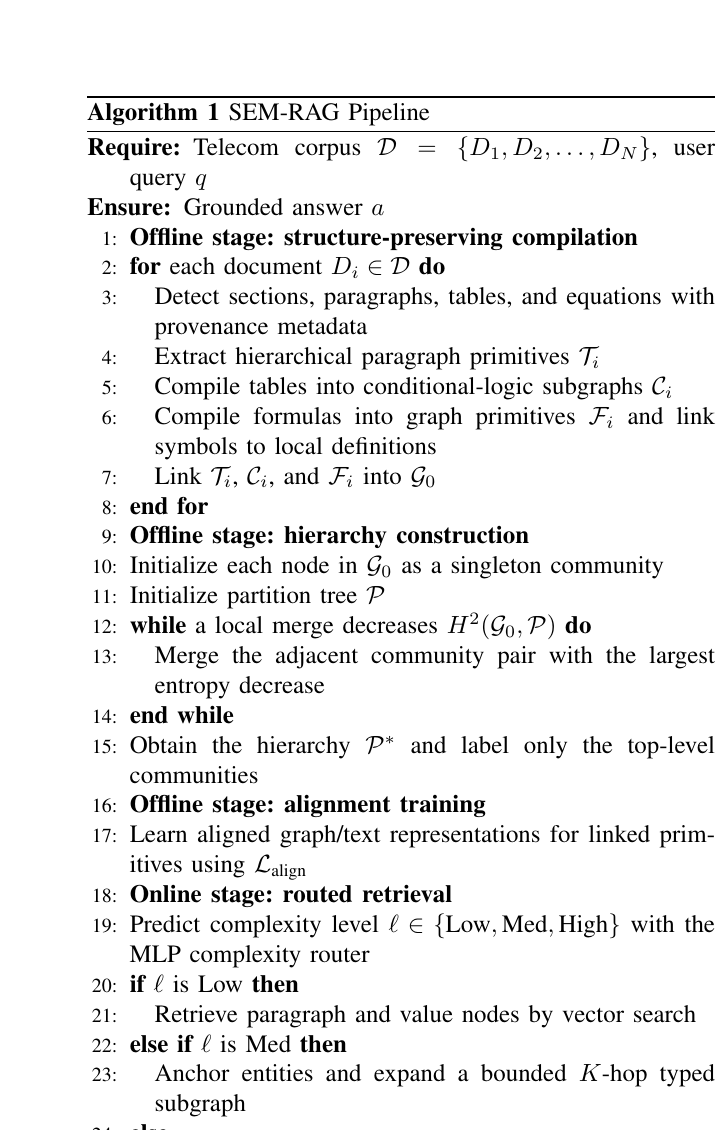
SEM-RAG-algorithm1-pipeline

Algorithm 1 将流程分成离线和在线两段:

  • 离线:解析文档 -> 抽取 $T_i$ / $C_i$ / $F_i$ -> 链成 $G_0$ -> SEM 构建 $P^*$ -> 对齐图/文本表示。
  • 在线:router 选择 Low / Med / High -> 检索 direct nodes、K-hop subgraph 或 macro-nodes -> verbalize $G_q$ -> LLM 生成答案。

Results

1. 总体性能:TeleQnA 和 ORAN-Bench-13K 上明显领先

SEM-RAG-table3-overall-performance

Table III 使用 GPT-5.2 作为主生成模型。SEM-RAG 达到:

  • TeleQnA accuracy:94.1%,高于 Standard GraphRAG 81.2%。
  • ORAN-Bench-13K accuracy:93.8%,高于 Standard GraphRAG 78.4%。
  • MRR@10 / F1:0.89 / 0.92,高于 Standard GraphRAG 0.72 / 0.79。

解读:增益不是只出现在某个结构子集;在混合了 acronym、程序性、表格、公式问题的完整 benchmark 上,结构保真编译仍能提升整体检索质量。

2. 结构敏感子集:表格和公式问题收益最大

SEM-RAG-fig3-structure-sensitive-results

Figure 3 的关键读法:

  • Formula-heavy subset 上,LightRAG 和 Standard GraphRAG 分别约 51.2% / 58.7%,SEM-RAG 达到 91.5%。
  • 错误分析中,Standard GraphRAG 的 mathematical inconsistency 为 28.5%,row/column logic error 为 22.1%;SEM-RAG 将 row/column logic error 降到 2.8%。

解释:这正对应 structural amnesia。普通检索可能找到同一页或相邻段落,但无法稳定绑定 row header、column header、predicate 和 cell value。

3. 多跳深度:压缩后仍保留可遍历结构

SEM-RAG-table4-multihop-depth

Table IV 按 1-hop / 2-hop / 3-hop 支持路径分层。3-hop 场景下:

  • Naive RAG:12.5%
  • RAPTOR:22.4%
  • LightRAG:45.3%
  • Standard GraphRAG:58.7%
  • SEM-RAG:87.1%

解读:SEM 压缩没有把跨 clause、term、table-cell、symbol-definition 的路径抹掉。它保留了 dense local neighborhoods,使中等深度的 typed traversal 仍可用。

4. 索引成本:LLM token 和时间随规模分叉

SEM-RAG-table5-indexing-scalability

SEM-RAG-fig4-indexing-scalability

Table V / Figure 4 显示,1,000,000 entities 时:

  • Standard GraphRAG:110.0M tokens,78.2 hours。
  • SEM-RAG:0.35M tokens,0.68 hours。

解读:SEM-RAG 不是说图构建免费,而是把 hierarchy construction 从递归 LLM summarization 迁移到图拓扑优化。LLM 只在层级固定后为少量 top-level communities 生成 label / summary。

5. 在线延迟:结构保真不必导致慢检索

SEM-RAG-fig5-online-latency

Figure 5 显示 SEM-RAG 总在线延迟约 135ms,接近 LightRAG 的 110ms,明显低于 Standard GraphRAG 的 1240ms。JSD alignment 约 18ms,是可控开销。

解释:router 避免所有问题都走完整图扩展。factoid query 直接 lookup,关系问题才扩 bounded subgraph,高层问题才访问 macro-node。

6. 消融:核心收益来自 table / formula compiler

SEM-RAG-fig6-ablation-chart

SEM-RAG-table6-ablation

Table VI 显示:

  • Full SEM-RAG:TeleQnA 94.1,TSpec-LLM 91.2,ORAN-Bench 93.8。
  • 去掉 Table-to-Graph:58.2 / 61.4 / 55.7。
  • 去掉 Formula-to-OPG:63.5 / 68.7 / 69.1。
  • 去掉 JSD Alignment:71.8 / 73.5 / 75.2。
  • 去掉 MLP Routing:82.4 / 84.1 / 81.9。

解读:table compiler 和 formula compiler 是硬依赖;alignment 和 routing 也有价值,但不是主收益来源。这支持论文的主张:SEM-RAG 的核心是结构保持编译,而不是 query-time heuristic。

7. 跨模型稳定性:收益不是某个闭源模型的 prompt 偶然性

SEM-RAG-table7-cross-llm-stability

Table VII 在 TeleQnA 上固定检索管线,只替换生成模型。SEM-RAG 相对 Naive RAG 的绝对增益在四个模型上都接近 50 points:

  • GPT-5.2:+48.6
  • Claude 3.5 Sonnet:+49.6
  • LLaMA-3-70B:+50.8
  • Mistral-Large:+50.1

解读:收益主要来自提供给 generator 的证据结构更好,而不是某个模型对提示词特别敏感。

Limitations

  • 论文不提供 end-to-end answer correctness 的形式化保证;复杂度分析只覆盖 indexing / retrieval budget。
  • 编译图会继承上游 parsing errors,尤其是低质量 PDF、复杂嵌套 annex tables、跨页表格和 OCR 错误。
  • 当前 compiler 主要处理 text、tables、formulas;message sequence charts 和工程图只通过周边文本和 provenance 弱表示。
  • 所有实验都在 telecom standards 上完成,跨领域迁移仍需验证,例如法律条文、医疗指南、金融合规手册或科学论文。
  • SEM-RAG 需要更丰富的 parser 和 typed graph construction,系统工程复杂度高于 text-only RAG。
  • PDF 未给出公开代码仓库,复现实验依赖自行实现 layout-aware parser、公式 AST、SEM merging、JSD alignment 和 router。
  • 论文使用 GPT-5.2 作为主生成模型,并使用 OpenAI text-embedding-3-large;在本地模型或更小 embedding 下的表现需要单独验证。

Future Directions

  • 作者方向:
    • 扩展 compiler 到 message sequence charts 和更丰富的 engineering diagrams。
    • 验证同一设计是否能迁移到其他 standards-heavy technical domains。
  • Agent 推断的 Research Opportunities:
    • 将 SEM-RAG 的 schema-preserving evidence record 固化为 GraphRAG 日志:clause / subject / relation / object / condition / provenance。
    • 在 QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples 的 operator diagnosis 中加入 table row-column binding 和 formula operator preservation。
    • 和 M3KG-RAG - Multi-hop Multimodal Knowledge Graph-enhanced RAG 共同扩展 OP-19:M3KG 关注 audio-visual grounding,SEM-RAG 关注 layout / formula / conditional structure preservation。
    • 将 router 扩展成 graph-interface router:factoid lookup、typed subgraph expansion、symbolic table/formula execution、macro-node summary retrieval 分开评估。
    • 针对低质量 PDF / OCR 场景增加 parser confidence,并把 parser error 传播到 retrieval confidence。
    • 研究“结构熵压缩 vs 语义社区摘要”的混合方案:先用 SEM 保结构,再只对高层 macro-nodes 做少量 LLM semantic labeling。

与本知识库的连接

一句话定位

SEM-RAG 的核心价值是把 GraphRAG 的关键前移到 ingestion 阶段:先把电信标准中的层级条款、表格条件和公式算子编译成可执行图原语,再用结构熵压缩替代递归 LLM 聚类,使 GraphRAG 同时保留结构、降低索引成本,并在表格/公式密集问答中显著减少 structural amnesia。