研究问题与动机
-
研究问题:GraphRAG 依赖离线索引、实体/关系抽取、社区总结和在线检索生成。这个多阶段流程在云端强模型上可用,但在医疗 EHR schema 这类隐私敏感、资源受限场景中,能否用本地开源 LLM 跑通并稳定回答仍不清楚。
-
为什么重要:医疗 EHR schema 包含大量表、列、外键和 join 条件。查询往往不是普通 fact lookup,而是要理解表之间关系、字段连接和 schema 结构。云 API 会带来成本、延迟和 HIPAA 数据出域问题。
-
对本知识库的意义:这篇论文直接补充 GraphRAG中的图结构强度、构建成本与收益边界 和 GraphRAG中的容量与上下文带宽:GraphRAG 的收益边界不只由算法决定,还由本地模型容量、结构化输出可靠性、硬件带宽和 retrieval mode 决定。
-
现有 GraphRAG 研究多在 general-domain corpus、云端 LLM 或性能指标上做比较,较少考察本地部署的 pipeline-level reliability。
-
本地小模型不只影响最终答案,还影响 GraphRAG 前置阶段:实体抽取、关系抽取、JSON 结构输出、community report generation。
-
医疗/企业 schema 场景对隐私和合规要求更高,不能默认把 schema metadata 发送给云端 LLM。
-
“建出更大的图”不一定代表“问答效果更好”,索引阶段和查询阶段可能需要不同模型能力。
方法与机制
1. 数据集:Epic Clarity EHR schema 子集
语料来自 Epic DocGen 导出的 HTML schema 文件,每个文件描述一个 Clarity 数据库表,包括:
- 表名和描述。
- 列定义:列名、数据类型、约束。
- 外键关系。
- join conditions。
原始完整数据集超过 7,000 个文件。本文使用 10-file curated subset:
ABN_FOLLOW_UP, ABN_MEDICATIONS, ABN_NOTES, ABN_ORDERS, ABN_ORDER_INFO, ACCESSIBLE_SERVICES, ACCOUNT, ACCOUNT_2, ACCOUNT_3, ACCOUNT_CONTACT。
HTML parsing 后得到:
这个规模很小,但保留了 EHR schema 的关键结构特征:表间依赖、外键和关系模式。
2. GraphRAG pipeline
作者使用 Microsoft GraphRAG v2.3.0,采用 6 阶段流程:
- HTML schema files 切分成 chunks。
- LLM 抽取 tables、columns、data types、foreign-key links 等 entities / relationships。
- 用抽取结果构建 knowledge graph。
- 使用 Leiden algorithm 做 community detection。
- LLM 为每层 community 生成 natural-language summaries。
- 使用
nomic-embed-text为 text units 和 entity descriptions 建 embedding index。
Figure 1 展示 offline indexing 与 online querying 的分离:
- Offline:schema files -> chunking -> entity/relation extraction -> KG construction -> community detection -> community summarization -> embedding index。
- Online:query 进入 global search 或 local search,再由 LLM 生成答案。
关键配置:
concurrent_requests=1 是单 GPU 内存约束导致的配置。
3. 本地模型和硬件
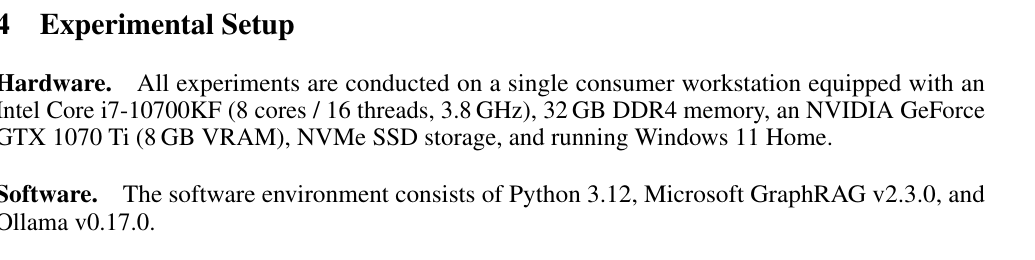
硬件环境:
- Intel Core i7-10700KF,8 cores / 16 threads,3.8 GHz。
- 32 GB DDR4。
- NVIDIA GeForce GTX 1070 Ti,8 GB VRAM。
- NVMe SSD。
- Windows 11 Home。
软件环境:
- Python 3.12。
- Microsoft GraphRAG v2.3.0。
- Ollama v0.17.0。
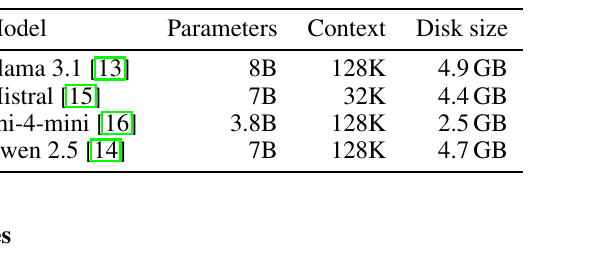
模型均通过 Ollama 部署,并使用 Q4_K_M quantization:
- Llama 3.1:8B,128K context,4.9GB。
- Mistral:7B,32K context,4.4GB。
- Phi-4-mini:3.8B,128K context,2.5GB。
- Qwen 2.5:7B,128K context,4.7GB。
4. 查询与指标
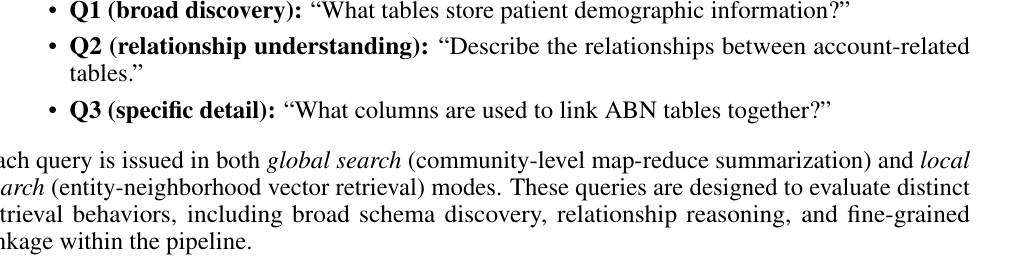
三类查询:
- Q1 broad discovery:What tables store patient demographic information?
- Q2 relationship understanding:Describe the relationships between account-related tables.
- Q3 specific detail:What columns are used to link ABN tables together?
每个查询都跑两种模式:
- Global search:基于 community-level map-reduce summarization。
- Local search:基于 entity-neighborhood vector retrieval。
指标:
- Indexing time。
- Graph statistics:entities、relationships、communities。
- Query latency。
- Manual answer quality:1-5 分,依据 correctness、completeness、relevance。
- Hallucination:是否引用源文件中不存在的 schema entities。
证据与结果
索引性能:Llama 建图最多,Qwen 最快,Phi-4-mini 失败
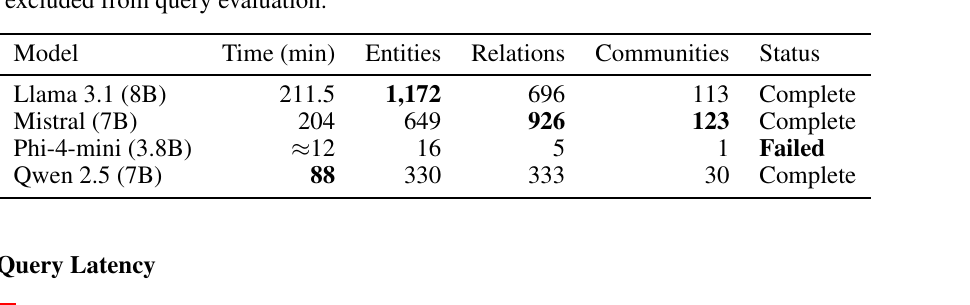
Table 2 的关键数字:
- Llama 3.1:211.5 min,1,172 entities,696 relations,113 communities,complete。
- Mistral:204 min,649 entities,926 relations,123 communities,complete。
- Phi-4-mini:约 12 min,16 entities,5 relations,1 community,failed。
- Qwen 2.5:88 min,330 entities,333 relations,30 communities,complete。
解读:
- Llama 3.1 构建最丰富图,实体数约为 Qwen 2.5 的 3.5 倍。
- Qwen 2.5 索引最快。
- Mistral 关系数最多,可能更偏 relation-focused extraction。
- Phi-4-mini 在 community report generation 阶段因
FailedToGenerateValidJsonError崩溃,说明 GraphRAG 对结构化输出能力有硬门槛。
查询延迟:local search 明显更稳定
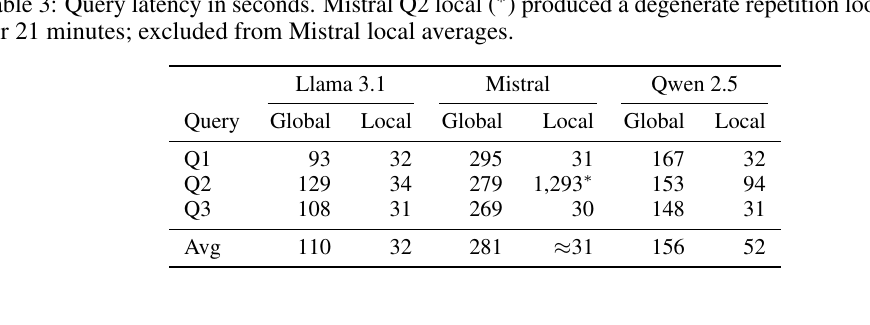
Table 3 显示:
- Llama 3.1:global avg 110s,local avg 32s。
- Mistral:global avg 281s,local avg 约 31s;但 Q2 local 出现 1,293s repetition loop,被排除出 local avg。
- Qwen 2.5:global avg 156s,local avg 52s。
解读:
- Global search 对社区总结数量敏感;Mistral 因处理 123 个 community reports 变慢。
- Local search 在多数正常情况下约 30-52s,更适合交互式本地部署。
- Mistral Q2 的 1,293s 异常说明本地推理配置也会成为稳定性风险。
答案质量:Qwen 2.5 最好,但它不是建图最多的模型
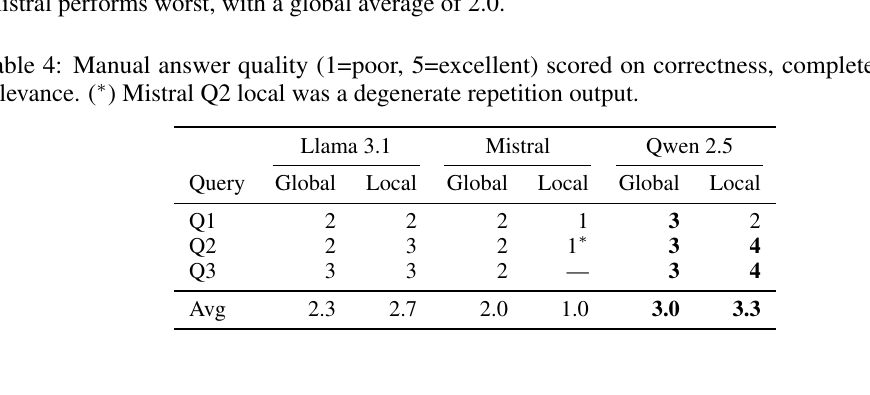
Table 4 的平均分:
- Llama 3.1:global 2.3,local 2.7。
- Mistral:global 2.0,local 1.0。
- Qwen 2.5:global 3.0,local 3.3。
关键结论:
- Qwen 2.5 抽取实体最少,却答案质量最高。
- Llama 3.1 图最大,但 local answer quality 只有 2.7。
- 这说明 GraphRAG 不能只优化 indexing coverage;建图模型和回答模型可能应该分开选择。
一个自然的 hybrid pipeline 是:
即用 Llama 3.1 获取更高覆盖的图,用 Qwen 2.5 做查询回答。
幻觉与失败模式:global search 更容易回到训练先验
作者报告 global search 中三个成功模型都会产生不存在于测试语料的数据库表名:
- Llama 3.1:
PATIENT,PERSON,TRANSACTIONS,BALANCES,CUSTOMERS。 - Mistral:
PATIENT_DEMOGRAPHICS,ADDRESS,INSURANCE,PAYMENT_HISTORY。 - Qwen 2.5:部分 hallucinate
claim_id。
相比之下,local search 的结果保持 grounded,引用实际 schema entities,例如:
ABN_FOLLOW_UPNOTE_CSN_IDPAT_ID
解读:7B 本地模型面对大量 community summaries 时,可能无法忠实综合局部事实,转而生成“典型数据库”先验。Local entity-neighborhood retrieval 更能约束答案。
失败模式:
- Phi-4-mini:无法稳定生成 GraphRAG 所需结构化 JSON,最后 pipeline 崩溃。
- Mistral:Q2 local search 进入 21 分钟重复循环,生成越来越不连贯的列名;作者认为 Ollama 默认配置缺少 repetition penalty 加剧了问题。
成本与合规:本地部署省 API 成本,也避免数据出域
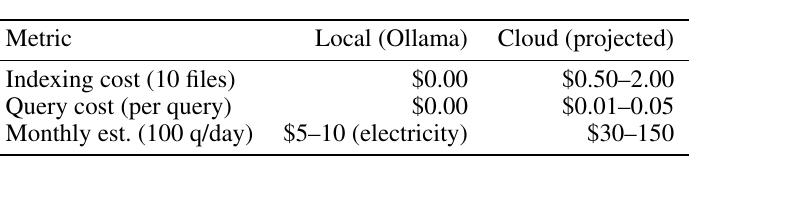
Table 5 的估计:
- 10-file indexing:local $0.00,cloud $0.50-2.00。
- per query:local $0.00,cloud $0.01-0.05。
- 100 queries/day 月成本:local $5-10 electricity,cloud $30-150。
更重要的是合规:
- 本地 pipeline 不需要把 schema metadata 发给外部云服务。
- 对医疗组织,HIPAA 场景下数据不出域可能不是优化项,而是部署前提。
局限与开放问题
-
数据规模小:只用 10-file curated subset,虽然代表 EHR schema 特征,但远小于完整 7,000-file corpus。
-
查询少:只有 3 个 representative queries,每个跑 global/local,不能代表完整任务分布。
-
答案质量是作者人工 1-5 分,缺少临床信息学专家正式评估。
-
只测试单一硬件:GTX 1070 Ti 8GB VRAM、32GB RAM,无法推出所有消费级设备表现。
-
未实现混合模型 pipeline,只在讨论中提出 Llama indexing + Qwen querying 的可能性。
-
云端成本是 projected,不是完整实测 cloud baseline。
-
只使用 Microsoft GraphRAG v2.3.0,不能代表 LightRAG、HippoRAG、LinearRAG 等其他更轻量 GraphRAG。
-
作者方向:
- 扩展到完整 7,000-file schema corpus。
- 研究 hybrid pipeline,把 indexing 和 querying 分配给不同模型。
- 让 clinical informatics professionals 做正式 human evaluation。
- 建立 cloud-based baseline,直接比较质量、延迟和成本。
-
Agent 推断的 Research Opportunities:
- 做 stage-aware model routing:抽取、社区总结、local query、global query 各自选择不同模型。
- 在低算力 GraphRAG 中优先优化 local search,而不是默认依赖 global community summaries。
- 设计 structured-output reliability benchmark,专门评估小模型能否稳定生成 GraphRAG indexing 所需 JSON。
- 把 hallucinated schema entity rate 作为 GraphRAG 医疗/企业部署的硬指标。
- 对比 Microsoft GraphRAG 与 LinearRAG / LightRAG 类轻量方法,在相同 8GB VRAM 预算下测 construction time、query latency、answer quality、hallucination。
关联与拓展
- 原始框架:GraphRAG-Microsoft。
- 接口与任务:GraphRAG中的图接口选择与任务类型、DualGraph - Symbolic Querying and Semantic Retrieval for Semi-Structured QA。
- 路由与模型选择:GraphRAG-Router - Cost-Efficient Routing over GraphRAGs and LLMs。
- 成本与结构强度:GraphRAG中的图结构强度、构建成本与收益边界、GraphRAG中的结构强度与Query-Complexity动态切换。
- 容量与上下文:GraphRAG中的容量与上下文带宽。
- 本地/复杂任务边界:A2RAG - Adaptive Agentic Graph Retrieval、Do We Still Need GraphRAG - Agentic Search Benchmark。
研究问题入口
Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略