研究问题与动机
-
研究问题:个性化 LLM Agent 需要长期、结构化、可更新的外部记忆。单纯 dense retrieval 容易漏掉多跳关系;传统 GraphRAG 若只做静态 node-level retrieval,又难以根据中间发现的信息调整搜索计划。
-
为什么重要:这篇论文把 GraphRAG作为Query-Planning 做成完整工程流程:复杂问题先转成 search plan,再通过实体匹配、clue-query、图遍历和 sufficiency check 逐步收集证据。
-
现有方法:
- PAI-1:已有 memory graph 和 BeamSearch / WaterCircles / A* 等图遍历机制,但主要是一次性检索。
- LightRAG:强调轻量图结构和双层检索。
- RAPTOR:用 tree summary 做层次检索。
- HippoRAG / GraphRAG中的Personalized-PageRank:用图结构和 PPR 组织长期记忆。
-
静态检索无法根据已发现证据动态改写后续搜索步骤。
-
复杂问题常需要先拆成子问题,再从前序答案中生成更具体的后续查询;固定 plan 会在中间实体未知时失败。
-
图遍历如果只从单个实体或单个 query 出发,容易漏掉分散在多个子图中的同一对象信息。
-
个性化记忆图存在实体歧义、重复三元组、时间信息隐式化、图构建成本高等问题。
方法与机制
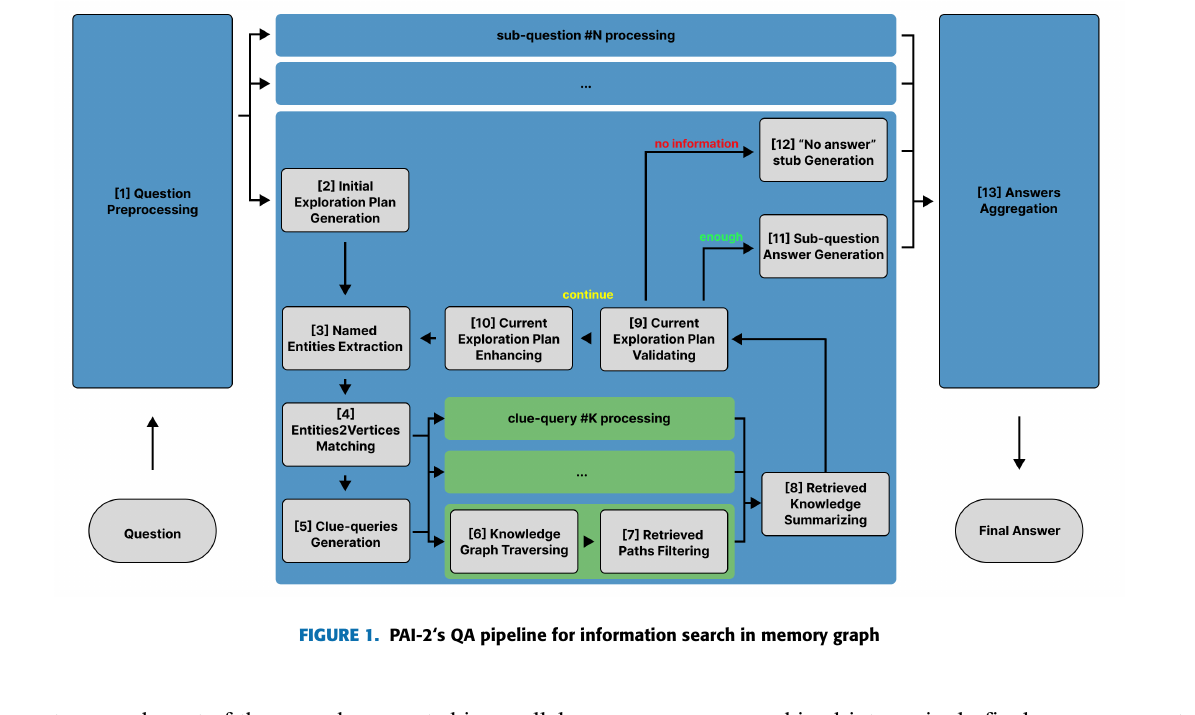
- 整体框架:PAI-2 的 QA pipeline 包含 13 个阶段:问题预处理、子问题并行处理、初始搜索计划、实体抽取、实体到图顶点匹配、clue-query 生成、知识图遍历、路径/三元组过滤、检索知识总结、计划验证、计划增强、子答案生成、答案聚合。
Figure 1 是 PAI-2 的主流程图。最重要的闭环在中间:SearchPlan -> NER -> Entities2Vertices -> ClueQueries -> GraphTraversal -> Filtering -> Summarizing -> PlanValidation -> PlanEnhancing。如果当前证据不足,系统不会直接回答,而是增强未完成 search plan,然后回到实体抽取和图遍历。
1. 问题预处理
给定原始问题 q,PAI-2 先进行去噪、增强和可选分解:
Denoise(q):修语法、去掉噪声词。Enhance(q):改写成更清晰、更适合搜索的表达。Decompose(q):判断是否可拆成多个独立子问题。
论文实验中主实验禁用了 query preprocessing,因为作者认为该阶段对准确率提升不足且 prompt 还需调优。因此这部分更像可选模块,不应把全部收益归因于预处理。
2. 子问题的 memory graph exploration
对每个子问题 q_i,先生成初始搜索计划:
每个 s_j 是一个 natural-language search step。随后对当前 search step 执行:
把实体链接到 memory graph 的 object vertices:
其中 V_m 是每个实体最多匹配的顶点数。然后对匹配顶点做组合,取前 C_m 个候选顶点组:
C_m 同时也是每个 search step 生成 clue-queries 的最大数量。
3. Clue-query 控制图遍历
对每个顶点组,LLM 根据 search step 和 matched vertices 生成更具体的 clue-query:
每个 clue-query 控制一次图遍历:
遍历算法可选 BeamSearch、WaterCircles、NaiveRetriever 以及组合。随后按与 clue-query / search step 的相关性过滤三元组:
4. Clue answer 与 search step answer
对每个 clue-query 的过滤三元组生成局部答案:
再把多个 clue answers 汇总为当前 search step 的新增知识:
所有已完成 search steps 的结果记为:
5. 证据充分性与计划增强
PAI-2 用 LLM 判断当前 SA 是否足以回答子问题:
如果足够,就生成子答案:
如果不足,就判断并增强后续搜索计划:
这个机制是 PAI-2 的核心。它允许系统用前面 search steps 得到的实体或事实,把后续抽象问题改写成更具体的问题。
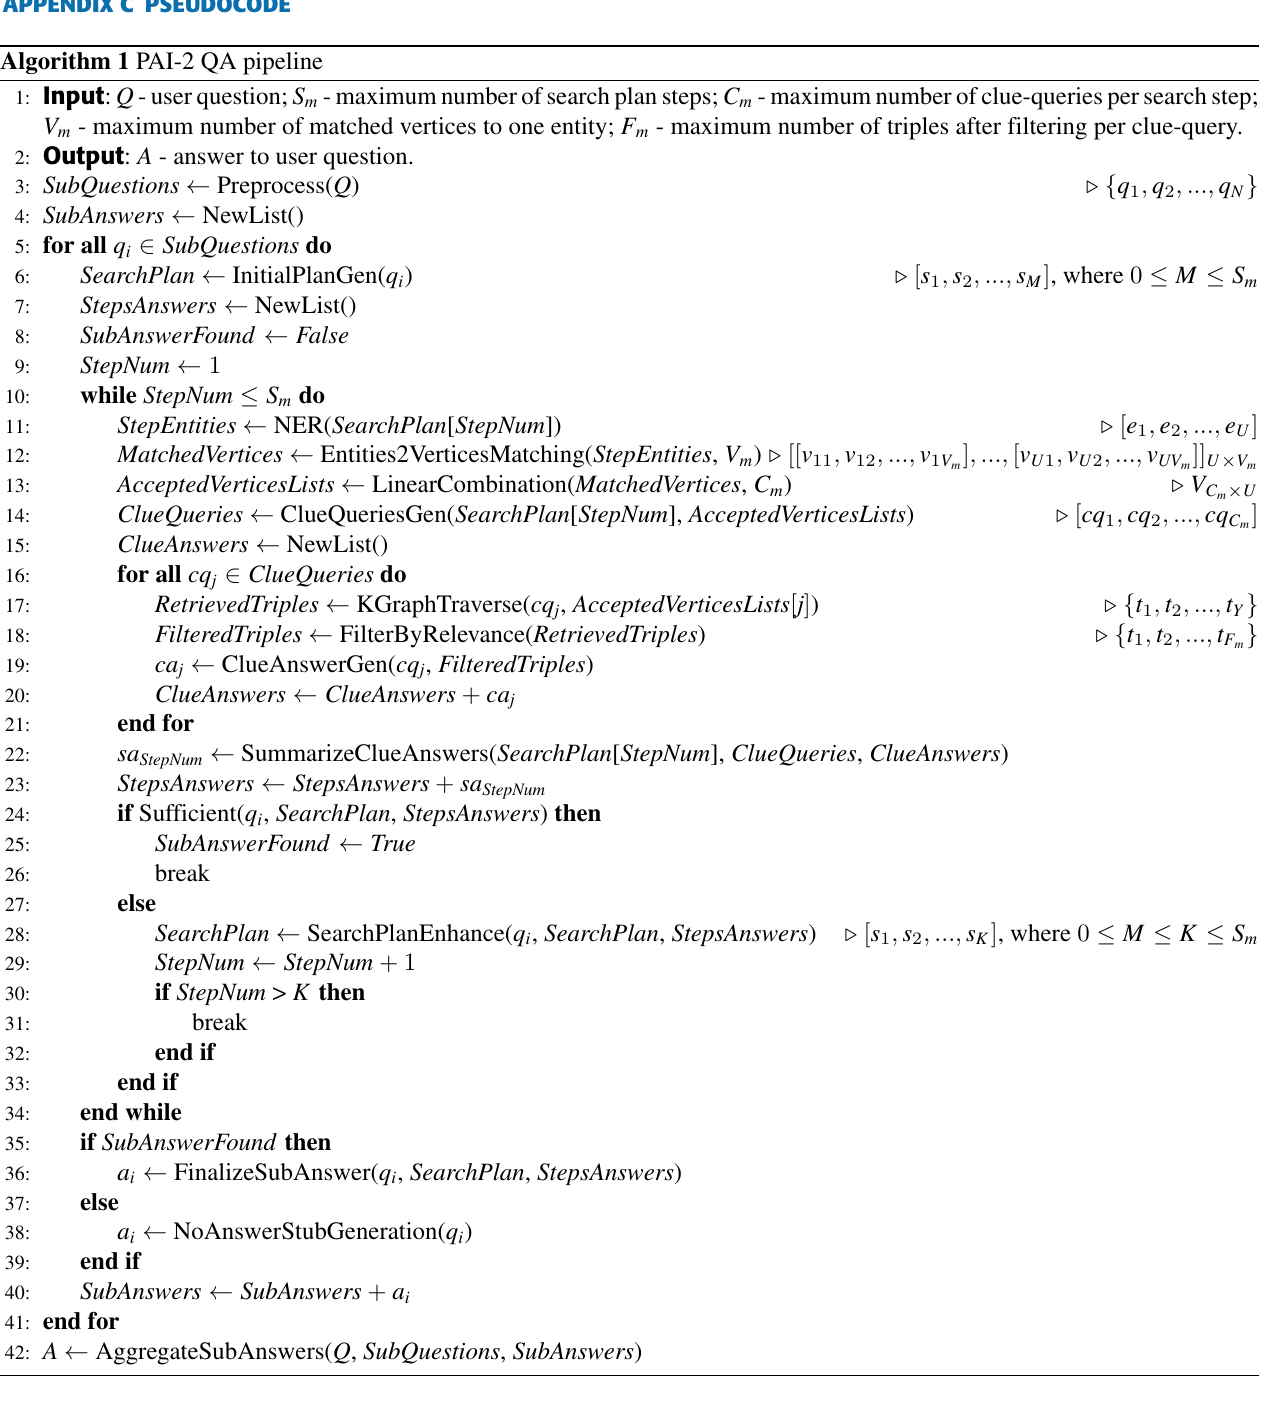
Algorithm 1 把上述流程写成可执行伪代码。关键超参数是:
S_m:最大 search plan steps。C_m:每个 search step 最大 clue-query 数。V_m:每个实体最大匹配顶点数。F_m:每个 clue-query 过滤后保留的最大三元组数。
这四个参数共同决定检索预算、分支宽度和上下文噪声。
证据与结果
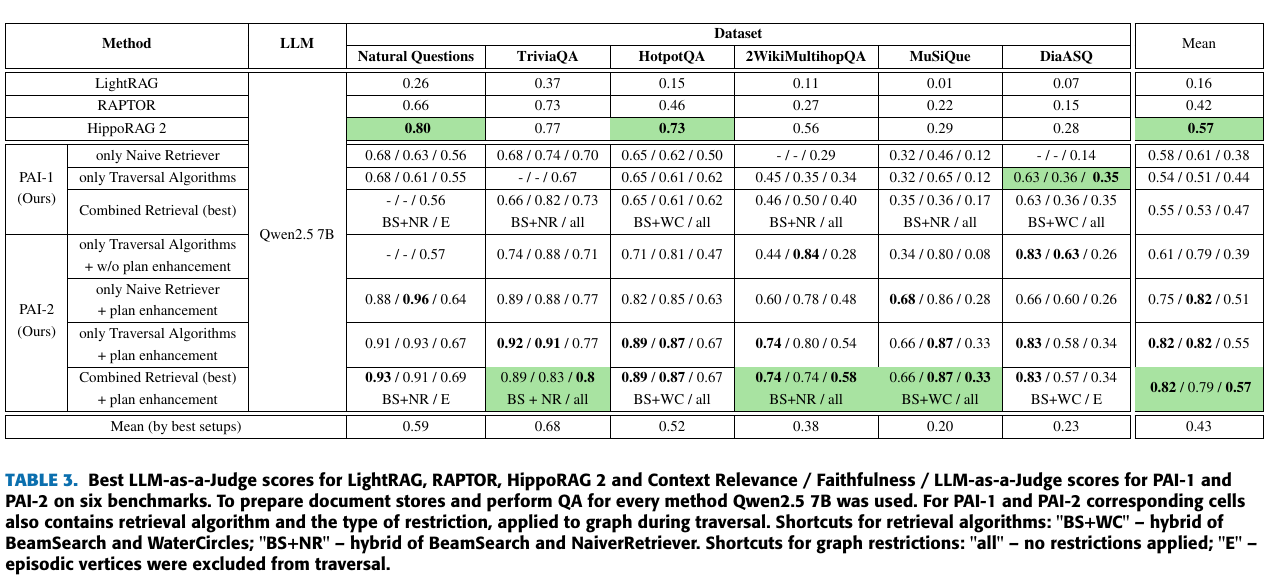
主结果:PAI-2 的计划增强 + 图遍历在多数数据集上有效,但不是无条件压倒 HippoRAG2
- 表中 PAI-1 / PAI-2 的每个单元是
Context Relevance / Faithfulness / LLM-as-a-Judge。 - PAI-2 best combined retrieval + plan enhancement 的 mean 为
0.82 / 0.79 / 0.57。 - HippoRAG2 的 LLM-as-a-Judge mean 也是 0.57,因此平均答案正确率不是压倒式优势。
- 但 PAI-2 在多个数据集上更强:
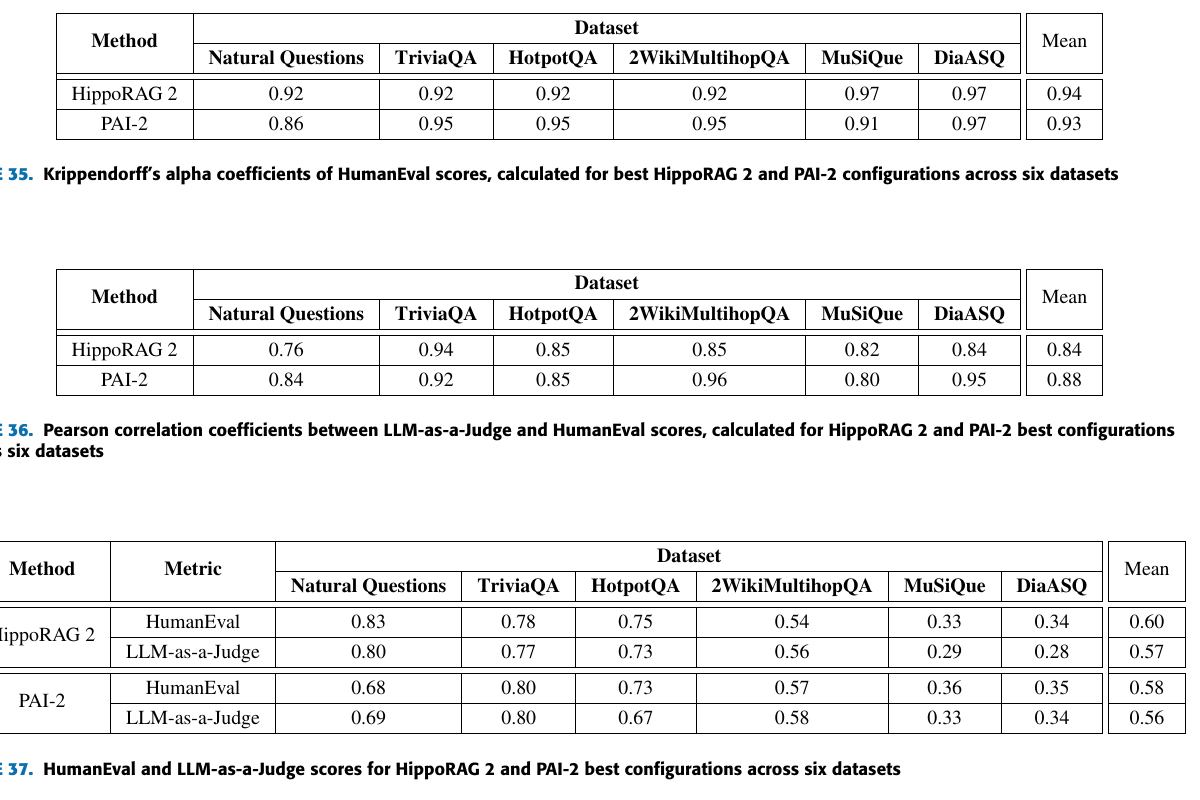
- TriviaQA:PAI-2 best 0.80,高于 HippoRAG2 0.77。
- 2Wiki:PAI-2 best 0.58,高于 HippoRAG2 0.56。
- MuSiQue:PAI-2 best 0.33,高于 HippoRAG2 0.29。
- DiaASQ:PAI-2 traversal 0.34,高于 HippoRAG2 0.28。
- 解读:PAI-2 的价值不应写成“全面 SOTA”,而应写成“计划增强和图遍历在多跳/个性化场景中提高了证据定位能力,但平均 LLM-as-Judge 与 HippoRAG2 接近”。
Plan enhancement 是主要收益来源
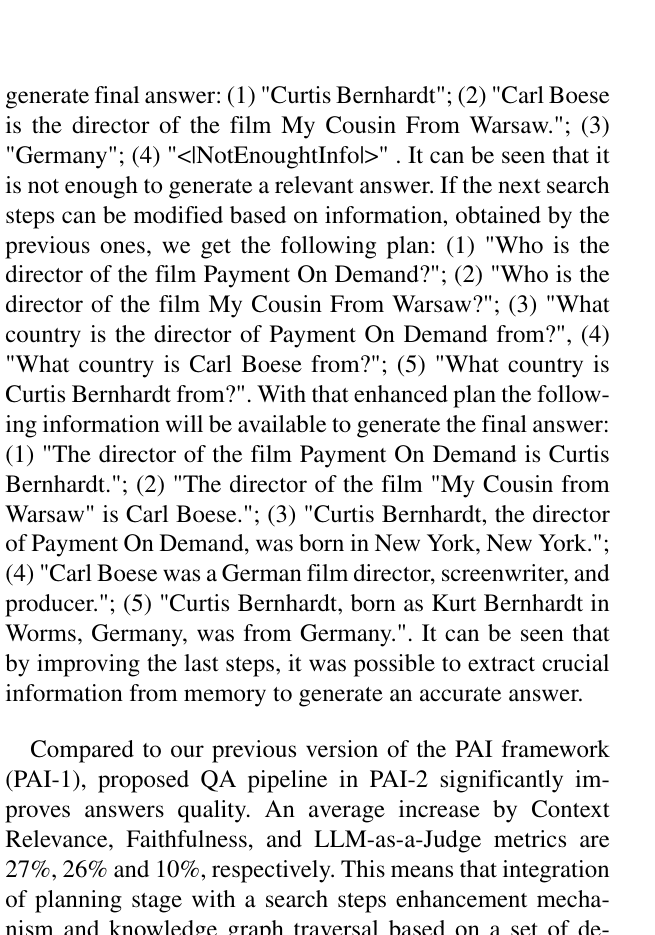
论文用电影导演国籍问题说明 disabled plan enhancement 的失败原因:初始计划第 3/4 步需要先知道导演是谁,否则查询太抽象。启用 plan enhancement 后,系统把后续问题改写为 “What country is Carl Boese from?” 和 “What country is Curtis Bernhardt from?”,从而拿到关键证据。
- 论文报告:启用 search plan enhancement 相比禁用版本,LLM-as-a-Judge 平均提升约 18%。
- 对本知识库的启发:多跳 GraphRAG 的关键往往不是“一次性分解”,而是把前序 retrieval result 写回 plan state,动态改写后续 search steps。
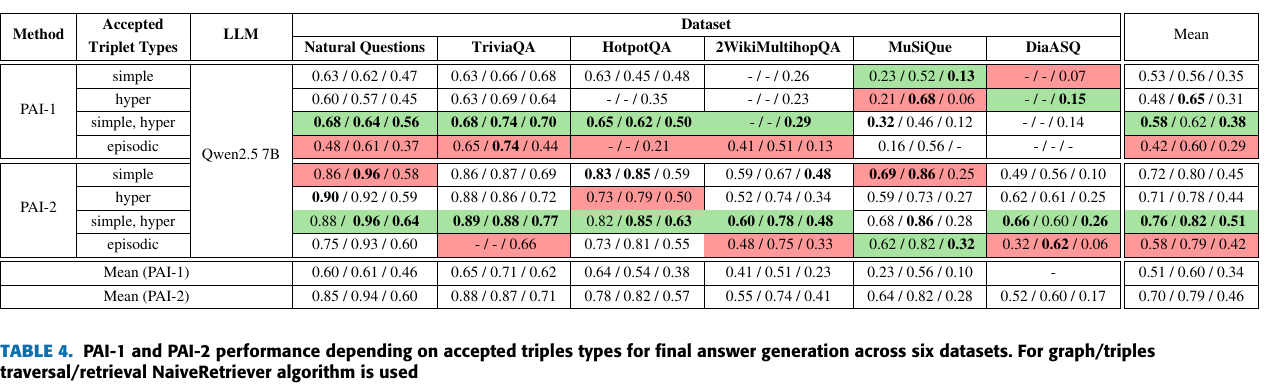
Triplet 类型:simple + hyper 通常比单一类型更稳
- PAI-2 在
simple, hyper组合下 mean 为0.76 / 0.82 / 0.51,高于 simple-only 的0.72 / 0.80 / 0.45和 hyper-only 的0.71 / 0.78 / 0.44。 - episodic triples 在部分数据集有用,但也可能带来噪声;作者指出排除 episodic triples 有时能缓解 Lost in the Middle。
- 解读:memory graph 不能只保留一种结构粒度。simple triples 提供局部事实,hyper triples 提供更丰富关系,episodic 信息提供原始上下文但可能增加噪声。
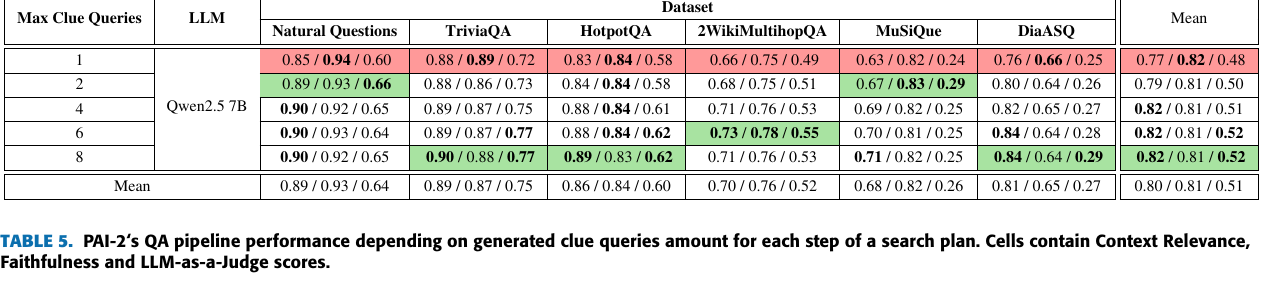
Clue-query 数量:增加分支有收益,但边际收益有限
C_m=1时 mean LLM-as-a-Judge 为 0.48。C_m=2为 0.50,C_m=4为 0.51,C_m=6/8为 0.52。- 解读:多 clue-query 可以覆盖同一实体的多个候选子图,缓解实体重复和子图碎片化;但从 6 到 8 基本不再提升,说明需要停止准则,而不是无限扩展。
LLM backbone 与数据集设置
-
作者在 HotpotQA few-shot 上比较 Qwen2.5 7B、Llama3.1 8B、Granite3.3 8B、Gemma2 9B,选择 Qwen2.5 7B 作为主实验 LLM。
-
PAI-2 在 Qwen2.5 7B 下的 few-shot 指标明显优于 PAI-1,尤其 Faithfulness 和 Groundedness。
-
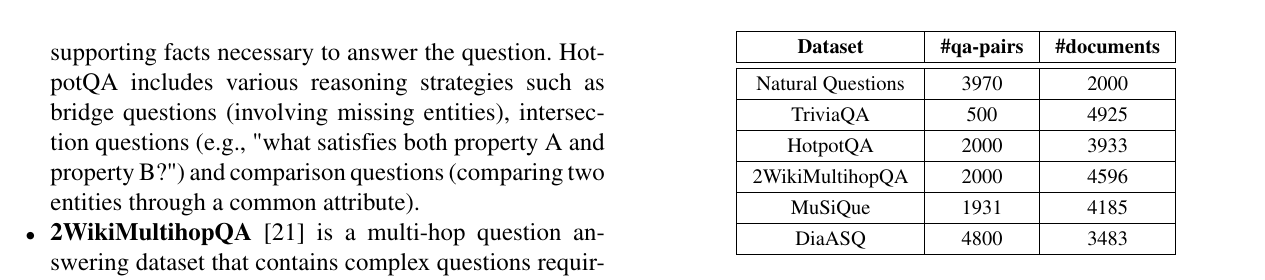
评测覆盖 Natural Questions、TriviaQA、HotpotQA、2WikiMultihopQA、MuSiQue、DiaASQ。
-
每个数据集构建了独立 memory graph;主评测每个 benchmark 使用 100 个 QA pair。
-
解读:数据集多样,但每个 benchmark 的 QA 样本数较小,性能结论要视作初步工程验证。
成本:PAI-2 比 PAI-1 更慢,图构建也很重
-
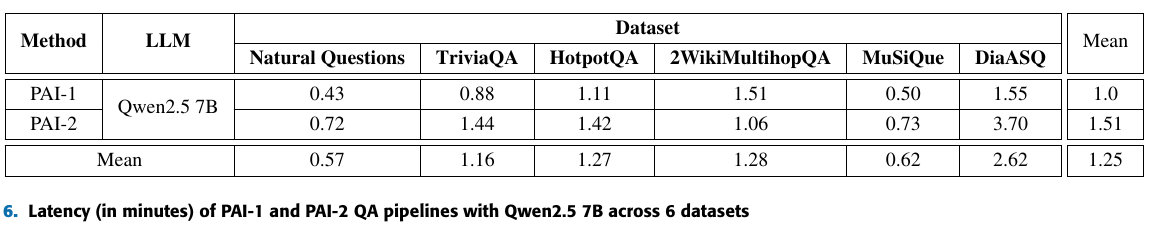
PAI-2 平均单问答延迟为 1.51 分钟,高于 PAI-1 的 1.0 分钟。
-
DiaASQ 上 PAI-2 达 3.70 分钟,说明多轮计划和图遍历在复杂对话/个性化场景中成本较高。
-
作者指出瓶颈主要是 LLM inference、vector search、knowledge graph traversal。
-
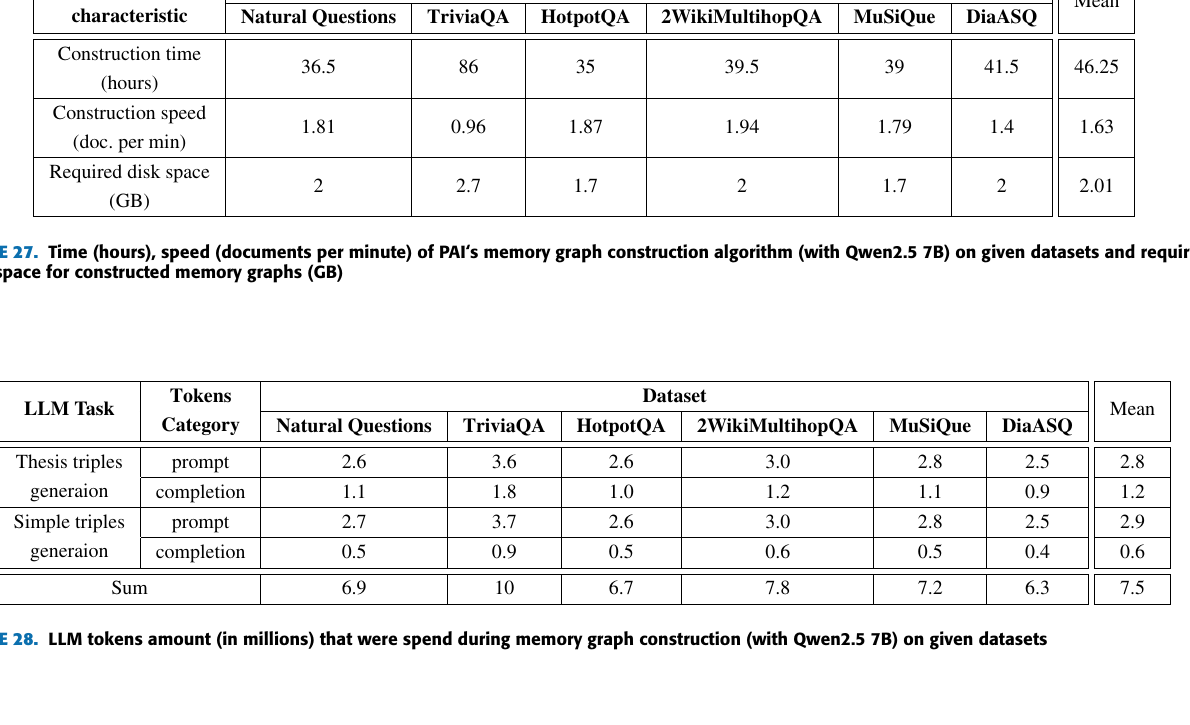
平均图构建时间 46.25 小时,平均构建速度 1.63 docs/min,平均磁盘占用约 2.01GB。
-
平均图构建消耗约 7.5M LLM tokens。
-
解读:PAI-2 更适合长期个性化记忆或高价值知识库,不适合作为一次性、临时性 RAG 的默认方案。
图构建质量:MINE-1 信息保留高,但依赖顶点类型完整性
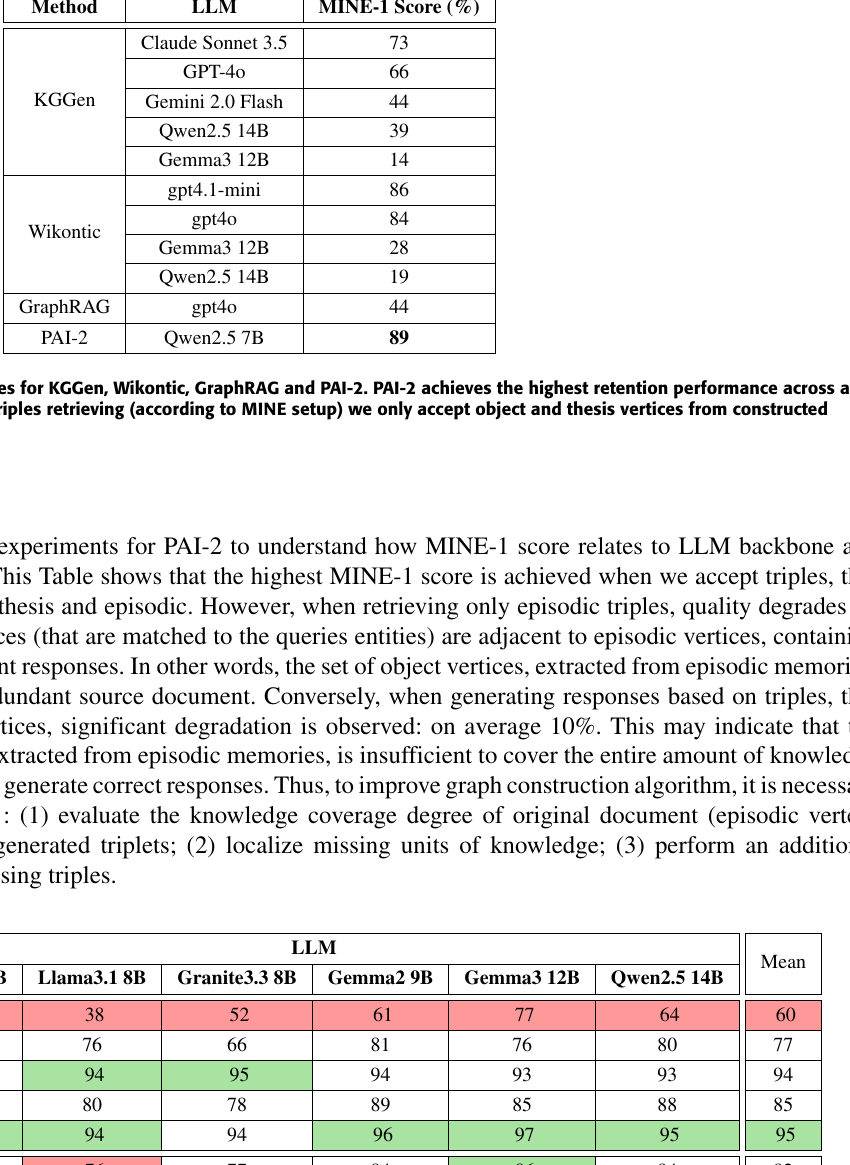
- PAI-2 在 MINE-1 上用 Qwen2.5 7B 达到 89% information-retention score,高于 GraphRAG GPT-4o 的 44% 和 Wikontic GPT-4.1-mini 的 86%。
- Table 34 显示只接受 object vertices 的平均分 60,只接受 thesis 77,只接受 episodic 94;object + thesis + episodic 为 95。
原始笔记摘录已截断;请打开来源笔记阅读完整内容。
局限与开放问题
-
评测样本较小:每个 benchmark 主要评测 100 个 QA pair,且很多配置是工程调参后的 best setup。
-
端到端成本高:PAI-2 单问答平均 1.51 分钟,图构建平均 46.25 小时,约 7.5M tokens。
-
主实验禁用了 query preprocessing,说明完整 pipeline 中部分模块尚未稳定贡献。
-
图构建存在 LLM parsing error;作者报告某些数据集构建时会丢失文档。
-
实体定义不充分:object vertices 缺少 formal entity definitions,导致多义实体需要大量遍历。
-
缺少语义去重:只用 exact string comparison 会产生重复三元组,增加存储、检索和更新成本。
-
时间信息仍较弱:timestamp 作为 plain text 进入 prompt,可能受 Lost in the Middle 影响。
-
HumanEval 平均分略低于 HippoRAG2,说明自动评测和主表指标不能独立支撑“全面领先”结论。
-
作者 Future Work:
- 给 thesis vertex 增加
Episode / Temporal双标签,区分 FACT、OPINION、PREDICTION,以及 STATIC、DYNAMIC、ATEMPORAL。 - 为 thesis vertex 增加显式时间区间:
t_created、t_valid、t_expired、t_invalid、invalidated_by。 - 为 predicate text 引入固定字段和 glossary,提高索引、过滤和更新可靠性。
- 给 thesis vertex 增加
-
Agent 推断的 Research Opportunities:
- 把 PAI-2 的 plan enhancement 变成可学习 policy:何时改写计划、何时继续当前 step、何时停止。
- 将
C_m / V_m / F_m / S_m作为预算控制变量,学习 evidence utility 与 marginal cost 的关系。 - 把 clue-query generation 与 A2RAG - Adaptive Agentic Graph Retrieval 的 Local / Bridge / PPR 升级结合:先 plan,再选择 traversal operator。
- 在本地 GraphRAG 检索实验中记录 plan state:初始 plan、增强后 plan、触发增强原因、每步 support-set coverage。
- 用 MINE-1 或类似信息保留指标评估图构建,不只看最终 QA。
关联与拓展
- 相关论文:A2RAG - Adaptive Agentic Graph Retrieval、GraphRAG-Router - Cost-Efficient Routing over GraphRAGs and LLMs、Do We Still Need GraphRAG - Agentic Search Benchmark、LightRAG、RAPTOR、HippoRAG
- 相关理论:GraphRAG作为Query-Planning、GraphRAG中的接口-代理-停止决策闭环、GraphRAG中的停止准则与预算分配形式化、GraphRAG中的Evidence Utility 而非 Evidence Quantity、GraphRAG中的Bridge Evidence 为什么关键、GraphRAG中的Query-Complexity与结构选择、GraphRAG中的Agentic轨迹质量
- 可接到的当前方法:
- 用 plan enhancement 诊断多跳失败:如果后续查询依赖前序实体,固定 plan 会失败。
- 用 clue-query 分支数作为预算参数,而不是固定 top-k。
- 用 sufficiency 判断决定是否继续图遍历,避免无限扩展。
- 把图构建质量单独评估:document-to-graph 信息保留、parsing error、semantic dedup、temporal validity。
研究问题入口
Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略