GGraphRAG 文献图谱自动同步
LIT-41529CC8 · 2026

BubbleRAG - Evidence-Driven RAG for Black-Box KGs

把 GraphRAG 检索形式化为 Optimal Informative Subgraph Retrieval,并用 semantic anchor grouping、bubble expansion、CEG ranking 和 reasoning-aware expansion 近似求解。

PDF 级阅读卡优先级 P0Duyi Pan, Tianao Lou, Xin Li, Haoze Song, Yiwen Wu, Mengyi Deng, Mingyu Yang, Wei Wang发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:在黑盒知识图谱中,schema、实体类型、关系类型和约束未知,GraphRAG 检索器很难知道 query 概念应该落到哪些节点/边,以及应该沿哪些路径扩展。

  • 为什么重要:多跳 QA 需要同时保证 recall 和 precision。只找相似节点会漏掉关键路径;盲目扩展会带来大量噪声证据。

  • 现有方法:

    • Naive RAG 只检索文本 chunks,难以利用图结构。
    • ToG / RoG 等路径方法依赖起点和 relation plan,容易受 anchor 错误影响。
    • HippoRAG2 / PPR 类方法依赖随机游走或扩散,擅长关联召回但不一定能精确比较候选证据质量。
  • Semantic instantiation uncertainty:一个 query 概念可能对应 KG 中多个异构实体、别名、属性值或隐式关系。

  • Structural path uncertainty:即使找到概念,也不知道哪些路径是回答问题所需的证据链。

  • Evidential comparison uncertainty:找到多个候选子图后,缺少判别机制判断哪个证据子图更完整、更紧凑、更有信息密度。

  • 黑盒 KG 下没有可靠 schema 可用,不能依赖人工写好的 relation template。

方法与机制

  • 形式化:论文定义 OISR(Optimal Informative Subgraph Retrieval)。
    • 输入:KG G=(V,E)、每个节点/边的 query relevance value val(.)、语义锚点组 S={S1,...,Sk}。
    • 约束:输出子图 G' 必须连通,并且每个 anchor set 至少覆盖一个节点或边。
    • 目标:最大化被选节点/边的平均 value,也就是信息密度。
    • 理论性质:OISR 是 Group Steiner Tree 的变体,论文证明其 NP-hard 且 APX-hard,因此需要启发式搜索。
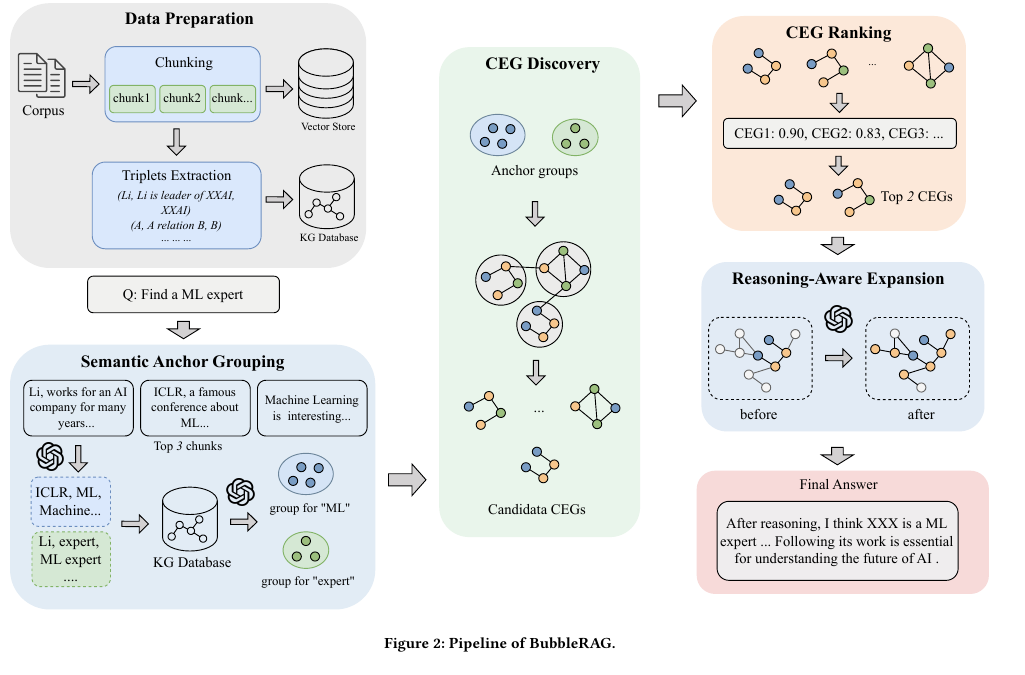
  • 整体框架:
    • Data Preparation:从 corpus chunking,抽取 triples,构建 KG 与 vector store。
    • Semantic Anchor Grouping:LLM 从 query 中抽取显式/隐式关键词,检索候选 nodes/edges,做 anchor specialization、schema relaxation 和 importance weighting。
    • CEG Discovery:用 Bubble Expansion 从 semantic anchor groups 出发构造 candidate evidence graphs。
    • CEG Ranking:按语义贴合度和缺失 anchor penalty 选择高质量 CEG。
    • Reasoning-Aware Expansion:对 top CEG 做 LLM-guided 扩展,补充回答所需邻居。
    • Answer Generation:合并 top CEGs 为 unified evidence graph,再映射回 provenance chunks,输入 LLM 生成答案。
  • Bubble Expansion:
    • 先从 anchor nodes 提取 h-hop localized subgraph,缩小搜索空间。
    • 在局部图中做 multi-source、Dijkstra-like 的 anisotropic expansion。
    • 扩展成本为 cost(v)=1-cos(z_q,z_v),低成本节点更容易被扩展。
    • 当来自不同 anchor group 的扩展前沿相遇时,触发 collision detection,并回溯 predecessor pointers 形成 CEG。
  • CEG Ranking:
    • Semantic dissonance:候选子图中节点与 query 的平均语义成本 Cost_sem(T)。
    • Structural incompleteness:若 CEG 未覆盖某些 anchor group,根据 group importance weight 计算 missing mass,并用 Penalty_miss(T)=exp(alpha * r_miss) 惩罚。
    • 最终分数近似为 Score(T)=1 / (Cost_sem(T) * Penalty_miss(T) + epsilon)。
    • alpha 控制 completeness 严格度:大 alpha 更像 AND 查询,小 alpha 更像 OR 查询。
  • Method Figure 解读:

Figure 2 展示了 BubbleRAG 的完整流程。左侧先把 corpus 切块并抽取 triples,建立 vector store 和 KG database;查询进入后,系统先把 “ML expert” 这类概念映射成多个 semantic anchor groups;中间通过 CEG Discovery 找到连接这些 anchor groups 的候选证据图;右侧用 CEG Ranking 选 top CEGs,再做 reasoning-aware expansion,最后把结构化证据和文本证据一起给 LLM 生成答案。

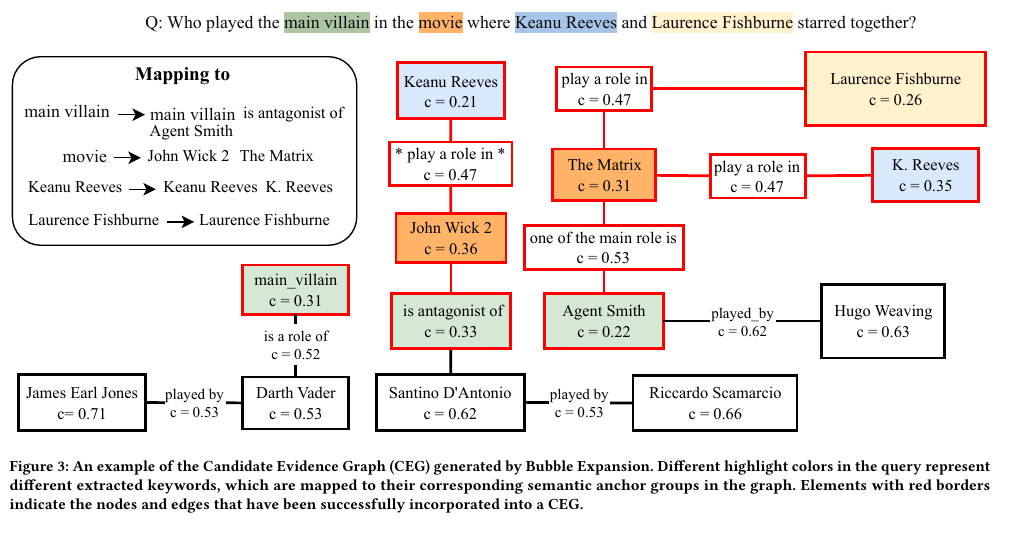
Figure 3 用 “Keanu Reeves / Laurence Fishburne / main villain / movie” 的例子说明 CEG 如何把 query 中不同颜色的关键词映射到不同 anchor groups,并通过图中的路径连接到 Agent Smith 和 Hugo Weaving。红框表示被 Bubble Expansion 成功纳入 CEG 的节点和边。这个图的重点是:CEG 不是任意邻域,而是围绕多个 query anchor 的连通证据骨架。

证据与结果

  • 实验设置:
    • 数据集:HotpotQA、MuSiQue、2WikiMultiHopQA。
    • LLM:Qwen3-30B 和 Qwen3-8B 两种设置。
    • 指标:F1 和 LLM-as-a-Judge Accuracy。
    • Baselines:Vanilla LLM、CoT+LLM、Naive RAG、ToG、RAPTOR、LightRAG local/global/hybrid、HippoRAG2、Clue-RAG。
  • Table 2 主结果:

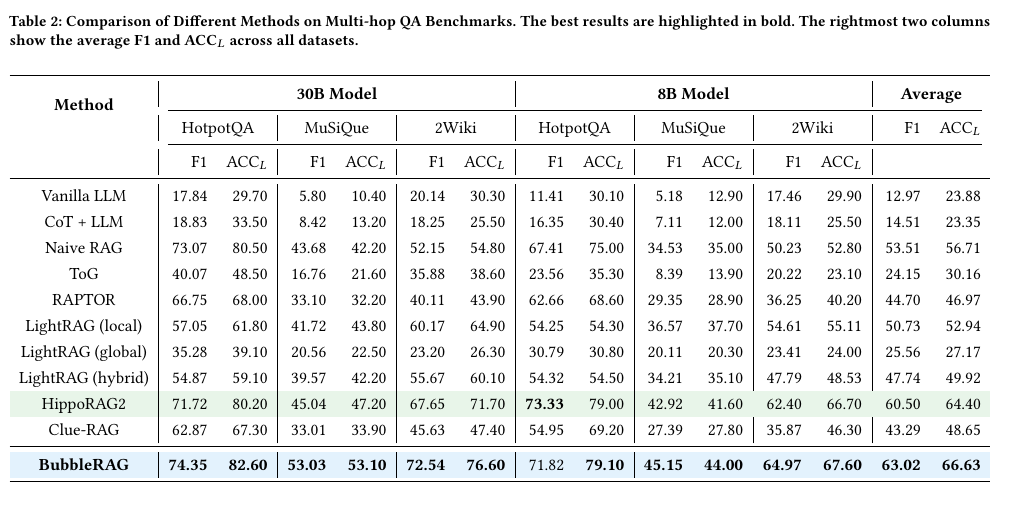
BubbleRAG 在平均 F1 和 ACC 上最高:Average F1=63.02,ACC=66.63。相对最强 baseline HippoRAG2,Average F1 从 60.50 提升到 63.02,ACC 从 64.40 提升到 66.63。最明显提升出现在 MuSiQue,30B 下 F1=53.03,明显高于 HippoRAG2 的 45.04,说明 group-aware evidence graph search 对复杂多跳组合问题更有效。

  • Table 3 消融:

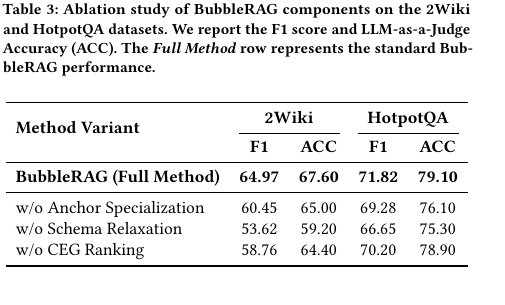
消融在 2Wiki 和 HotpotQA 上验证三个组件。去掉 Schema Relaxation 下降最大:2Wiki F1 从 64.97 降到 53.62,HotpotQA 从 71.82 降到 66.65,说明黑盒 KG 里过于严格的 schema 匹配会严重损害 recall。去掉 Anchor Specialization 会让 query anchor 更泛化,2Wiki F1 降到 60.45。去掉 CEG Ranking 对 2Wiki 影响明显,F1 降到 58.76,说明 ranking 对复杂多跳证据选择尤其重要。

  • Table 4 参数敏感性:

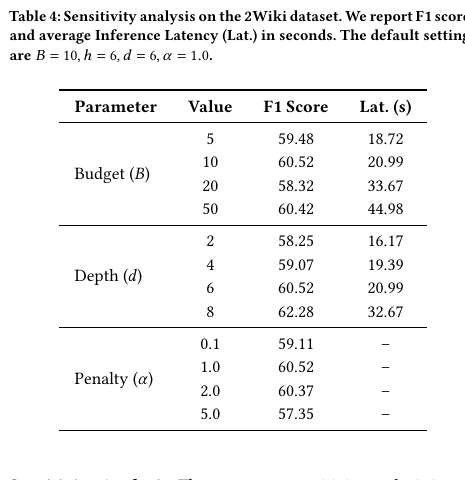
在 2Wiki 100 个样本上,默认 B=10, h=6, d=6, alpha=1.0。预算 B=10 在 F1=60.52、latency=20.99s 之间取得较好平衡;继续增大预算到 20/50 不一定提升 F1,反而显著增加延迟。深度从 2 到 8 提升 F1,但 d=8 延迟升到 32.67s,说明更深推理链有收益但成本明显增加。alpha=1.0 最好,过强惩罚 alpha=5.0 会伤害表现。

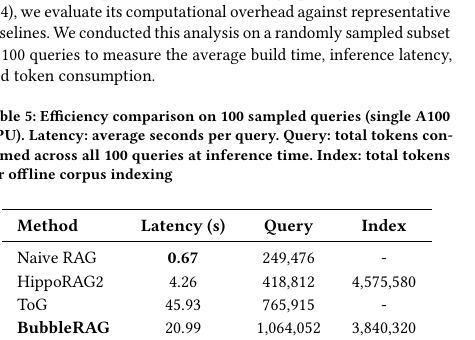
  • Table 5 效率:

BubbleRAG 平均延迟 20.99s,慢于 Naive RAG 的 0.67s 和 HippoRAG2 的 4.26s,但快于 ToG 的 45.93s。Query-time token consumption 为 1,064,052,高于 HippoRAG2 的 418,812;index tokens 为 3,840,320,低于 HippoRAG2 的 4,575,580。结论是 BubbleRAG 用更高 query-time 成本换更强的多跳证据子图质量。

局限与开放问题

  • Query-time 成本明显高于 HippoRAG2 和 Naive RAG,平均延迟约 20.99s。

  • Anchor grouping 和 reasoning-aware expansion 依赖 LLM,可能受 prompt、模型能力和成本影响。

  • 论文的核心优势集中在多跳 QA benchmark,是否适用于开放式科研综述、趋势分析和长文档推理还需要验证。

  • OISR 假设 KG informationally sufficient,即存在可覆盖 anchor groups 的连通子图;如果 KG 本身缺边严重,需要结合 CrossAug / dynamic graph update。

  • LLM-as-a-Judge Accuracy 需要进一步 human evaluation 校验。

  • 作者 Future Work:论文没有单独展开 future work,但结论强调将 retrieval 作为 OISR 形式化问题,并围绕 recall / precision 设计专门模块。

  • Agent 推断的 Research Opportunities:

    • 把 BubbleRAG 的 OISR 目标转成 GraphRAG 证据充分性指标:coverage、information density、semantic dissonance、missing mass。
    • 把 Bubble Expansion 与 CrossAug - Cross-Chunk Graph Augmentation for GraphRAG 结合:离线补桥接边,在线找高密度证据子图。
    • 在 BERDG-RAG / QueryShift 中加入 CEG ranking 诊断,区分“候选子图找不到”和“候选子图排序错”。
    • 将 alpha 用作 query semantics controller:AND / OR / comparison query 使用不同 completeness penalty。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q5 动态状态与学习策略, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:BubbleRAG: Evidence-Driven Retrieval-Augmented Generation for Black-Box Knowledge Graphs
  • 中文标题:面向黑盒知识图谱的证据驱动 RAG
  • 作者:Duyi Pan, Tianao Lou, Xin Li, Haoze Song, Yiwen Wu, Mengyi Deng, Mingyu Yang, Wei Wang
  • 机构:HKUST (GZ) / HKUST
  • 年份:2026
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码链接:待补充
  • 阅读状态:PDF级
  • 所属方向:黑盒 KG 检索、证据子图、多跳 QA、GraphRAG 检索形式化
  • 优先级:P0 精读

Background

  • 研究问题:在黑盒知识图谱中,schema、实体类型、关系类型和约束未知,GraphRAG 检索器很难知道 query 概念应该落到哪些节点/边,以及应该沿哪些路径扩展。
  • 为什么重要:多跳 QA 需要同时保证 recall 和 precision。只找相似节点会漏掉关键路径;盲目扩展会带来大量噪声证据。
  • 现有方法:
    • Naive RAG 只检索文本 chunks,难以利用图结构。
    • ToG / RoG 等路径方法依赖起点和 relation plan,容易受 anchor 错误影响。
    • HippoRAG2 / PPR 类方法依赖随机游走或扩散,擅长关联召回但不一定能精确比较候选证据质量。

Gap

  • Semantic instantiation uncertainty:一个 query 概念可能对应 KG 中多个异构实体、别名、属性值或隐式关系。
  • Structural path uncertainty:即使找到概念,也不知道哪些路径是回答问题所需的证据链。
  • Evidential comparison uncertainty:找到多个候选子图后,缺少判别机制判断哪个证据子图更完整、更紧凑、更有信息密度。
  • 黑盒 KG 下没有可靠 schema 可用,不能依赖人工写好的 relation template。

Insight

  • 一句话创新点:把 GraphRAG 检索形式化为 Optimal Informative Subgraph Retrieval,并用 semantic anchor grouping、bubble expansion、CEG ranking 和 reasoning-aware expansion 近似求解。
  • 核心洞察:GraphRAG 检索的目标不是“找若干相似节点”,而是“找一个覆盖 query 语义锚点、连通、紧凑、信息密度高的证据子图”。

Method

  • 形式化:论文定义 OISR(Optimal Informative Subgraph Retrieval)。
    • 输入:KG G=(V,E)、每个节点/边的 query relevance value val(.)、语义锚点组 S={S1,...,Sk}。
    • 约束:输出子图 G' 必须连通,并且每个 anchor set 至少覆盖一个节点或边。
    • 目标:最大化被选节点/边的平均 value,也就是信息密度。
    • 理论性质:OISR 是 Group Steiner Tree 的变体,论文证明其 NP-hard 且 APX-hard,因此需要启发式搜索。
  • 整体框架:
    • Data Preparation:从 corpus chunking,抽取 triples,构建 KG 与 vector store。
    • Semantic Anchor Grouping:LLM 从 query 中抽取显式/隐式关键词,检索候选 nodes/edges,做 anchor specialization、schema relaxation 和 importance weighting。
    • CEG Discovery:用 Bubble Expansion 从 semantic anchor groups 出发构造 candidate evidence graphs。
    • CEG Ranking:按语义贴合度和缺失 anchor penalty 选择高质量 CEG。
    • Reasoning-Aware Expansion:对 top CEG 做 LLM-guided 扩展,补充回答所需邻居。
    • Answer Generation:合并 top CEGs 为 unified evidence graph,再映射回 provenance chunks,输入 LLM 生成答案。
  • Bubble Expansion:
    • 先从 anchor nodes 提取 h-hop localized subgraph,缩小搜索空间。
    • 在局部图中做 multi-source、Dijkstra-like 的 anisotropic expansion。
    • 扩展成本为 cost(v)=1-cos(z_q,z_v),低成本节点更容易被扩展。
    • 当来自不同 anchor group 的扩展前沿相遇时,触发 collision detection,并回溯 predecessor pointers 形成 CEG。
  • CEG Ranking:
    • Semantic dissonance:候选子图中节点与 query 的平均语义成本 Cost_sem(T)。
    • Structural incompleteness:若 CEG 未覆盖某些 anchor group,根据 group importance weight 计算 missing mass,并用 Penalty_miss(T)=exp(alpha * r_miss) 惩罚。
    • 最终分数近似为 Score(T)=1 / (Cost_sem(T) * Penalty_miss(T) + epsilon)。
    • alpha 控制 completeness 严格度:大 alpha 更像 AND 查询,小 alpha 更像 OR 查询。
  • Method Figure 解读:

BubbleRAG-pipeline-figure

Figure 2 展示了 BubbleRAG 的完整流程。左侧先把 corpus 切块并抽取 triples,建立 vector store 和 KG database;查询进入后,系统先把 “ML expert” 这类概念映射成多个 semantic anchor groups;中间通过 CEG Discovery 找到连接这些 anchor groups 的候选证据图;右侧用 CEG Ranking 选 top CEGs,再做 reasoning-aware expansion,最后把结构化证据和文本证据一起给 LLM 生成答案。

BubbleRAG-ceg-example

Figure 3 用 “Keanu Reeves / Laurence Fishburne / main villain / movie” 的例子说明 CEG 如何把 query 中不同颜色的关键词映射到不同 anchor groups,并通过图中的路径连接到 Agent Smith 和 Hugo Weaving。红框表示被 Bubble Expansion 成功纳入 CEG 的节点和边。这个图的重点是:CEG 不是任意邻域,而是围绕多个 query anchor 的连通证据骨架。

Results

  • 实验设置:
    • 数据集:HotpotQA、MuSiQue、2WikiMultiHopQA。
    • LLM:Qwen3-30B 和 Qwen3-8B 两种设置。
    • 指标:F1 和 LLM-as-a-Judge Accuracy。
    • Baselines:Vanilla LLM、CoT+LLM、Naive RAG、ToG、RAPTOR、LightRAG local/global/hybrid、HippoRAG2、Clue-RAG。
  • Table 2 主结果:

BubbleRAG-table2-main-results

BubbleRAG 在平均 F1 和 ACC 上最高:Average F1=63.02,ACC=66.63。相对最强 baseline HippoRAG2,Average F1 从 60.50 提升到 63.02,ACC 从 64.40 提升到 66.63。最明显提升出现在 MuSiQue,30B 下 F1=53.03,明显高于 HippoRAG2 的 45.04,说明 group-aware evidence graph search 对复杂多跳组合问题更有效。

  • Table 3 消融:

BubbleRAG-table3-ablation

消融在 2Wiki 和 HotpotQA 上验证三个组件。去掉 Schema Relaxation 下降最大:2Wiki F1 从 64.97 降到 53.62,HotpotQA 从 71.82 降到 66.65,说明黑盒 KG 里过于严格的 schema 匹配会严重损害 recall。去掉 Anchor Specialization 会让 query anchor 更泛化,2Wiki F1 降到 60.45。去掉 CEG Ranking 对 2Wiki 影响明显,F1 降到 58.76,说明 ranking 对复杂多跳证据选择尤其重要。

  • Table 4 参数敏感性:

BubbleRAG-table4-sensitivity

在 2Wiki 100 个样本上,默认 B=10, h=6, d=6, alpha=1.0。预算 B=10 在 F1=60.52、latency=20.99s 之间取得较好平衡;继续增大预算到 20/50 不一定提升 F1,反而显著增加延迟。深度从 2 到 8 提升 F1,但 d=8 延迟升到 32.67s,说明更深推理链有收益但成本明显增加。alpha=1.0 最好,过强惩罚 alpha=5.0 会伤害表现。

  • Table 5 效率:

BubbleRAG-table5-efficiency

BubbleRAG 平均延迟 20.99s,慢于 Naive RAG 的 0.67s 和 HippoRAG2 的 4.26s,但快于 ToG 的 45.93s。Query-time token consumption 为 1,064,052,高于 HippoRAG2 的 418,812;index tokens 为 3,840,320,低于 HippoRAG2 的 4,575,580。结论是 BubbleRAG 用更高 query-time 成本换更强的多跳证据子图质量。

Limitations

  • Query-time 成本明显高于 HippoRAG2 和 Naive RAG,平均延迟约 20.99s。
  • Anchor grouping 和 reasoning-aware expansion 依赖 LLM,可能受 prompt、模型能力和成本影响。
  • 论文的核心优势集中在多跳 QA benchmark,是否适用于开放式科研综述、趋势分析和长文档推理还需要验证。
  • OISR 假设 KG informationally sufficient,即存在可覆盖 anchor groups 的连通子图;如果 KG 本身缺边严重,需要结合 CrossAug / dynamic graph update。
  • LLM-as-a-Judge Accuracy 需要进一步 human evaluation 校验。

Future Directions

  • 作者 Future Work:论文没有单独展开 future work,但结论强调将 retrieval 作为 OISR 形式化问题,并围绕 recall / precision 设计专门模块。
  • Agent 推断的 Research Opportunities:
    • 把 BubbleRAG 的 OISR 目标转成 GraphRAG 证据充分性指标:coverage、information density、semantic dissonance、missing mass。
    • 把 Bubble Expansion 与 CrossAug - Cross-Chunk Graph Augmentation for GraphRAG 结合:离线补桥接边,在线找高密度证据子图。
    • 在 BERDG-RAG / QueryShift 中加入 CEG ranking 诊断,区分“候选子图找不到”和“候选子图排序错”。
    • 将 alpha 用作 query semantics controller:AND / OR / comparison query 使用不同 completeness penalty。

与本知识库的连接

本卡片待补

  • 查找 BubbleRAG 是否公开代码或正式会议版本。
  • 将 OISR / CEG Ranking 公式整理成独立理论笔记。
  • 对比 BubbleRAG、SubQRAG、CrossAug 在“证据充分性”上的不同定义。