GGraphRAG 文献图谱自动同步
LIT-19653D47 · 2026

FastInsight - Fast and Insightful Retrieval via Fusion Operators for Graph RAG

FastInsight 把 GraphRAG 检索分解为基础算子和融合算子,用 GRanker 在 reranking 中融合拓扑邻域,用 STeX 在图扩展中融合语义相似度,从而在不依赖多轮 LLM 推理的情况下实现快速 Insightful Retrieval。

PDF 级阅读卡优先级 P1Seonho An, Chaejeong Hyun, Min-Soo Kim论文模板显示 SIGIR'26,但正式录用状态未确认。
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:面向 corpus graph 的 GraphRAG 需要在节点文本和图拓扑之间做多步检索。现有方法要么只做向量相似检索,要么依赖 LLM 多轮 interleaving,效果和延迟之间很难兼得。

  • 为什么重要:论文把这类需求称为 Insightful Retrieval:检索器不仅要看当前节点文本,还要理解中间检索结果,并据此决定下一步扩展方向。这个能力对文献引用图、法规图、科学事实图和文本丰富 KG 都很关键。

  • 现有方法:

    • Vector search 能利用语义,但不看图结构。
    • Graph search 能沿边扩展,但容易只按拓扑走到语义无关节点。
    • Model-based reranking 能精排文本相关性,但对候选节点的邻域上下文 topology-blind。
    • LLM interleaving 能更灵活,但 query latency 高,不适合实时企业检索。
  • 对本知识库的意义:FastInsight 补上 GraphRAG中的图接口选择与任务类型 和 GraphRAG中的Evidence Utility 而非 Evidence Quantity 中“图检索算子库”的缺口。它不像 STAR - Semantic-Tuned and Tail-Adaptive Retriever for GraphRAG 训练 KG reasoning path scorer,而是在 corpus graph 上把检索流程拆成可组合 operator,并提出低延迟 fusion operator。

  • 基础算子存在两个结构性缺陷:

    • Model-based search $O_m$ 只看 query-node 文本匹配,不看候选节点之间的图邻域,存在 topology-blindness。
    • Graph search $O_{gs}$ 只按图连接扩展,不看 query 语义和节点向量,存在 semantics-blindness。
  • 现有 GraphRAG 检索多是顺序组合 $O_{vs}$、$O_{gs}$、$O_m$,没有真正把语义和拓扑融合到同一个 scoring / expansion operator。

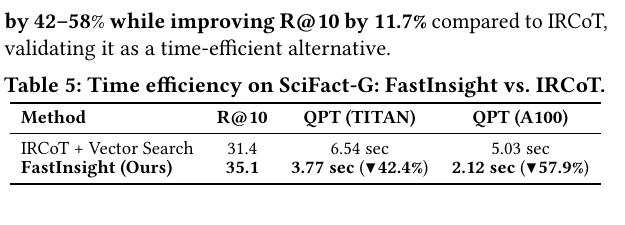
  • LLM-based interleaving retrieval 能模拟“理解 -> 决策”,但需要频繁 LLM 调用。论文报告 IRCoT + Vector Search 在 SciFact-G 上 QPT 为 6.54s / 5.03s,而 FastInsight 为 3.77s / 2.12s。

  • 评估上,普通 Recall 只看是否命中 oracle nodes,不衡量当前检索节点离未命中的 oracle nodes 有多近,因此难以判断图检索是否真的在向正确邻域靠近。

方法与机制

1. Operator Taxonomy:把 GraphRAG 检索拆成基础算子

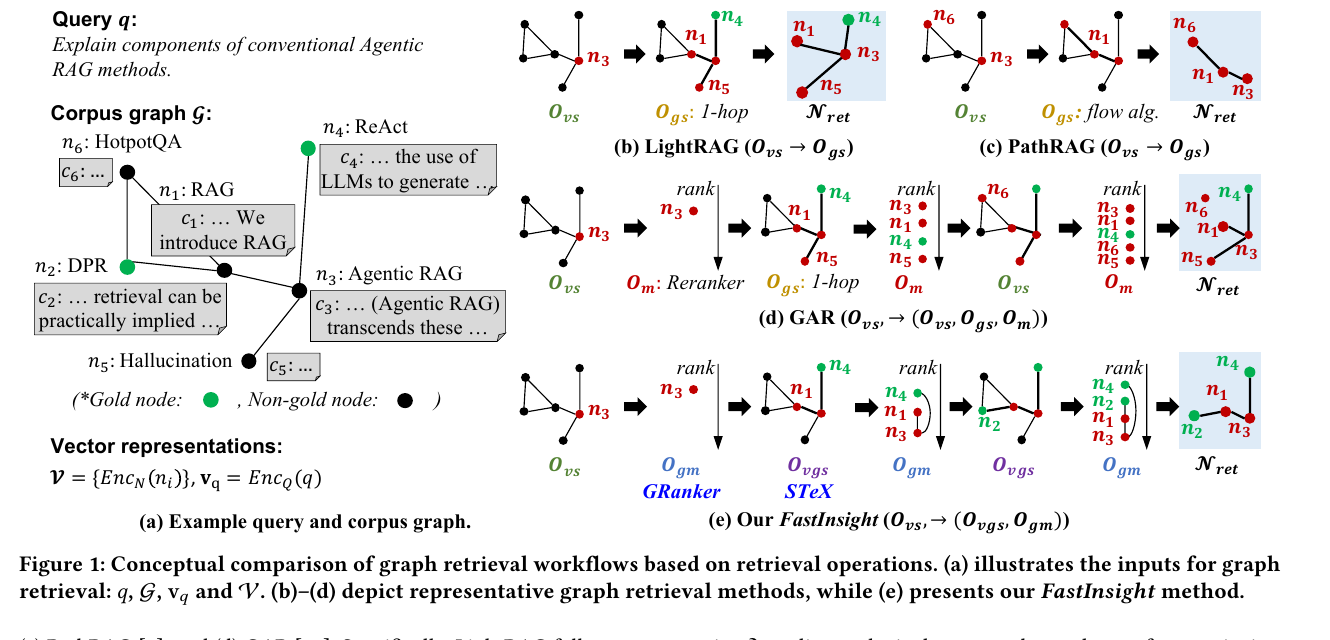
Figure 1 对比了 LightRAG、PathRAG、GAR 和 FastInsight 的检索操作序列。论文把基础检索算子分成三类:

  1. Vector Search $O_{vs}$:根据 query vector 和 node vector 相似度取 top-k。
  2. Graph Search $O_{gs}$:从 seed nodes 沿图拓扑扩展。
  3. Model-based Search $O_m$:用 reranker / cross-encoder / small LM 对候选节点打分。

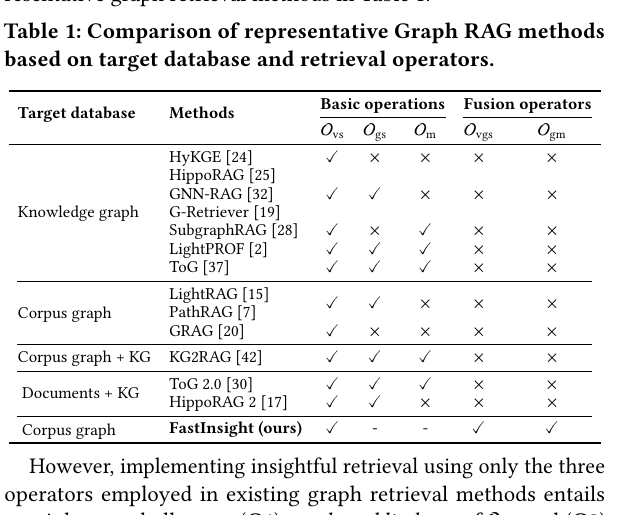
Table 1 的价值在于把 GraphRAG 方法从“系统名称”还原成“算子组合”。FastInsight 的区别是引入两个 fusion operators:$O_{gm}$ 和 $O_{vgs}$,而不是只顺序堆叠基础算子。

输入:

  • query $q$
  • corpus graph $G=(N,E)$
  • node vectors $V={v_n\mid n\in N}$
  • query vector $v_q$

基础 vector search:

N_{VS}=O_{vs}(v_q,N,k)=\arg topk_{n\in N} sim(v_q,v_n)

基础 graph search:

N_{GS}=O_{gs}(N_{seed},H_{seed},E)=P_{GS}(R_{GS}(N_{seed},H_{seed},E))

基础 model-based search:

N_M=O_m(q,N_{seed},k)=\arg topk_{n\in N_{seed}} P_\phi(q,n)

输出:一个可比较、可组合的 GraphRAG retrieval operator taxonomy。

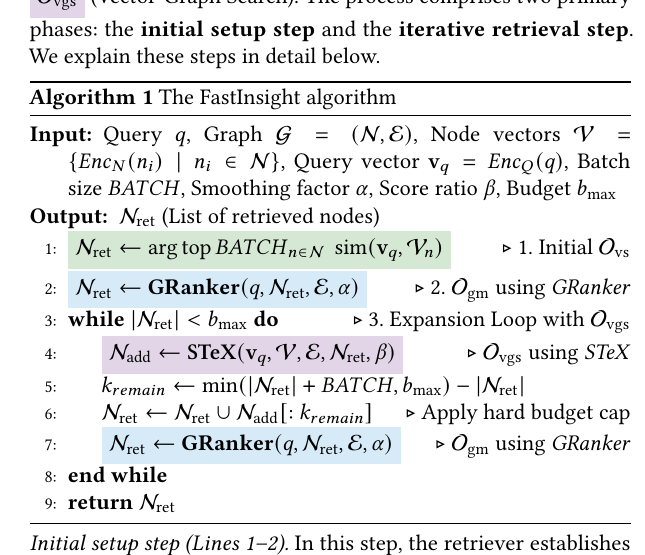
2. FastInsight 主流程:$O_{vs}\rightarrow(O_{gm},O_{vgs})$

输入:query $q$、图 $G=(N,E)$、node vectors $V$、query vector $v_q$、batch size $BATCH$、GRanker 平滑系数 $\alpha$、STeX score ratio $\beta$、最大预算 $b_{max}$。

计算:

  1. Initial Vector Search:
N_{ret}\leftarrow \arg top BATCH_{n\in N} sim(v_q,V_n)
  1. 用 GRanker 对初始节点做 graph-aware reranking:
N_{ret}\leftarrow GRanker(q,N_{ret},E,\alpha)
  1. 当 $|N_{ret}|<b_{max}$ 时循环:
    • 用 STeX 从当前 $N_{ret}$ 邻域中找新增节点 $N_{add}$。
    • 按预算加入最多 $BATCH$ 个节点。
    • 再用 GRanker 更新排序。

输出:满足预算的 retrieved node list $N_{ret}$。

这个流程把 expensive reranker 限制在小批候选上,同时用图扩展不断改善候选池质量。

3. GRanker:Graph Model-based Search $O_{gm}$

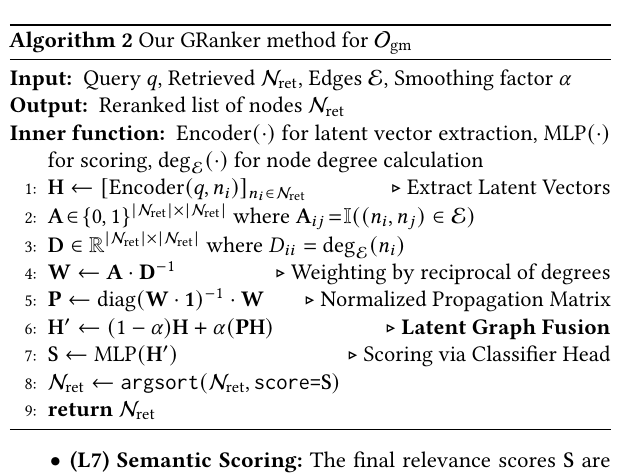
GRanker 解决 $O_m$ 的 topology-blindness:普通 reranker 只看 query-node 文本,忽略候选节点是否处在相互支持的图邻域中。

输入:

  • query $q$
  • 当前候选 $N_{ret}$
  • 边集合 $E$
  • smoothing factor $\alpha$

计算:

先用 cross-encoder 提取候选节点 latent vectors:

H=[Encoder(q,n_i)]_{n_i\in N_{ret}}

在候选子图上构造归一化传播矩阵 $P$,然后做一阶 Laplacian smoothing:

H'=(1-\alpha)H+\alpha(PH)

最后用 MLP 评分并重排:

S=MLP(H')
N_{ret}\leftarrow argsort(N_{ret},score=S)

输出:融合了文本语义和邻域拓扑的 reranked candidates。

直观解释:如果两个节点文本都相关,但其中一个节点被相关邻居支持得更好,GRanker 会把这种结构信号注入 reranker 表示。

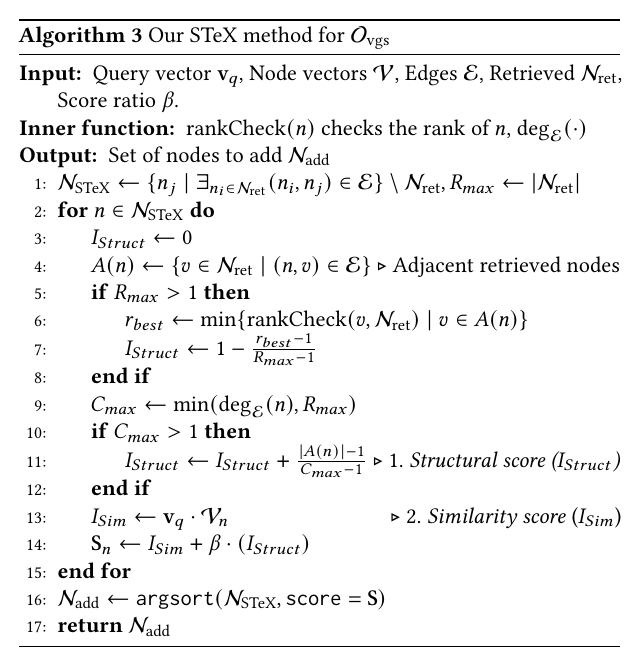
4. STeX:Vector-Graph Search $O_{vgs}$

STeX 解决 $O_{gs}$ 的 semantics-blindness:普通图遍历只看边,可能沿着拓扑连通性走到 query 无关节点。

输入:

  • query vector $v_q$
  • node vectors $V$
  • graph edges $E$
  • 当前已检索节点 $N_{ret}$
  • score ratio $\beta$

计算:

先构造一跳候选:

N_{STeX}=\{n_j\mid \exists n_i\in N_{ret},(n_i,n_j)\in E\}\setminus N_{ret}

对每个候选节点 $n$ 计算 structural score。它由两部分组成:

  • rank proximity:是否连接到当前高排名节点;
  • bridging capability:是否连接多个已检索节点,近似捕捉 structural hole / broker 价值。

再计算语义相似度:

I_{Sim}=v_q\cdot V_n

最终 STeX score:

S_n=I_{Sim}+\beta\cdot I_{Struct}

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

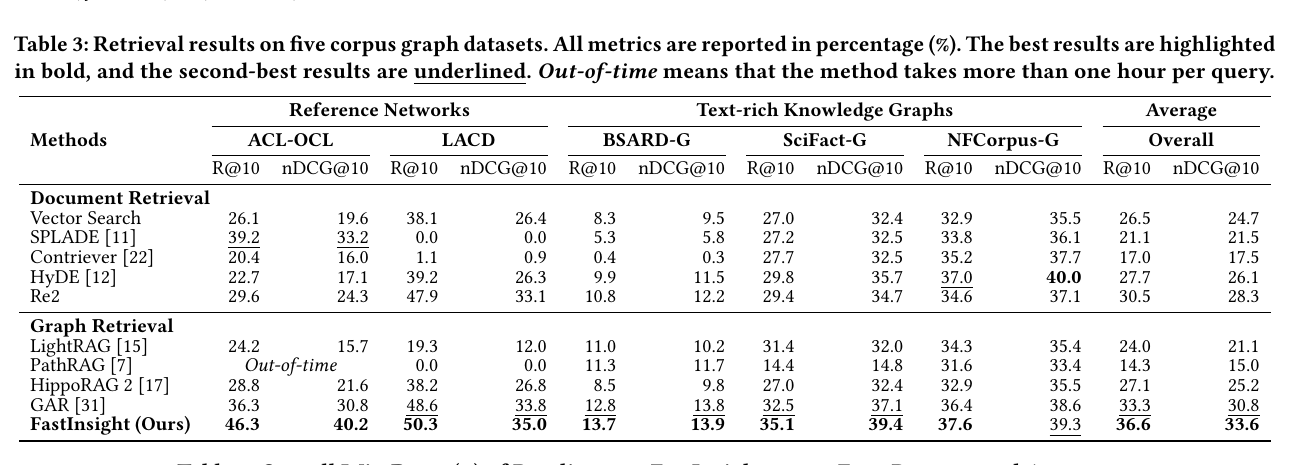
1. 检索主结果:平均 R@10 / nDCG@10 最强

Table 3 在 5 个 corpus graph retrieval datasets 上比较 9 个 baseline。FastInsight 的 Overall R@10 / nDCG@10 为 36.6 / 33.6,高于最强 baseline GAR 的 33.3 / 30.8。论文总结相对最强 baseline 平均提升 9.9% R@10、9.1% nDCG@10。

关键读法:

  • 在 ACL-OCL 引用网络上,FastInsight R@10 为 46.3,GAR 为 36.3,Re2 为 29.6。
  • 在 LACD 法律引用网络上,FastInsight R@10 为 50.3,略高于 GAR 48.6。
  • 在 text-rich KG 上增益较小但稳定,说明方法在强文本相似 baseline 已经较强时仍能补充拓扑信号。

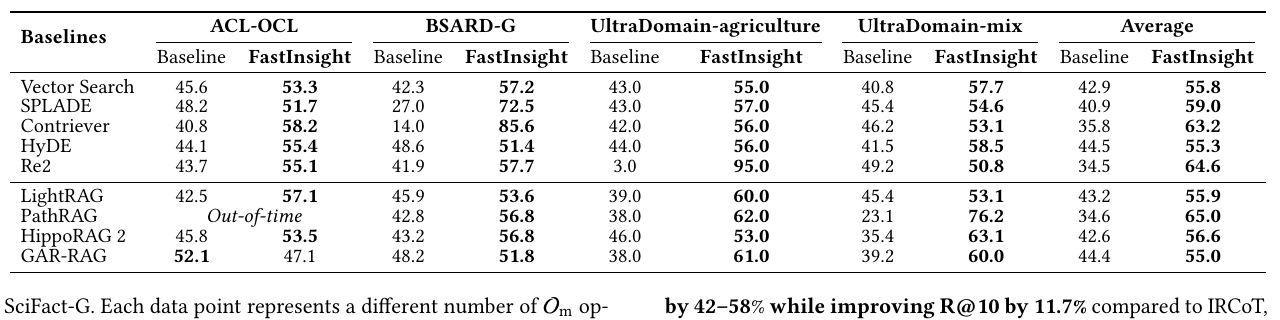
2. RAG 结果:检索增益能转化为生成胜率

Table 4 用 GPT-5-nano 基于检索节点生成答案,再用 pairwise LLM-as-a-Judge 评估。FastInsight 对所有 baseline 的平均 win rate 都超过 55%。其中对 Re2 的平均胜率为 64.6%,对 PathRAG 为 65.0%,对 GAR-RAG 为 55.0%。

解读:FastInsight 不是只提高离线检索指标,它返回的节点也能改善最终生成质量。不过这里依赖 LLM-as-a-Judge,结论应看作生成质量趋势,而不是确定性事实匹配。

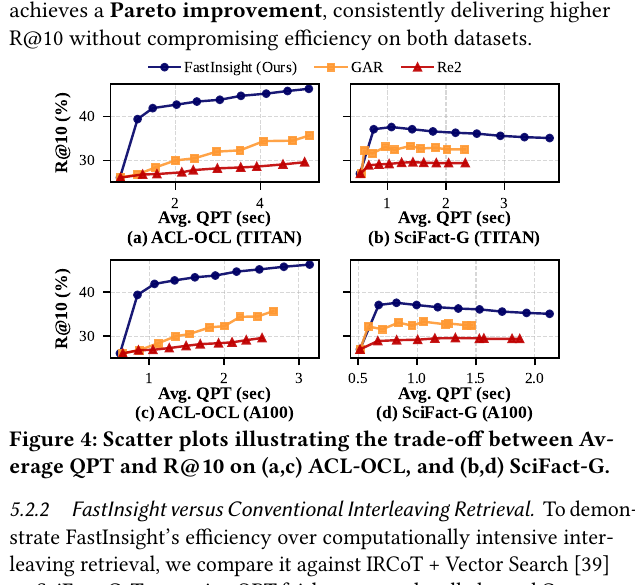
3. 效率结果:比 LLM interleaving 更快

Figure 4 显示 FastInsight 在 ACL-OCL 和 SciFact-G 上形成 Pareto improvement:同等或更低平均 QPT 下,R@10 高于 GAR 和 Re2。

Table 5 比较 FastInsight 和 IRCoT + Vector Search。SciFact-G 上:

  • IRCoT + Vector Search:R@10 31.4,TITAN 6.54s,A100 5.03s。
  • FastInsight:R@10 35.1,TITAN 3.77s,A100 2.12s。

论文总结 FastInsight 在提升 R@10 11.7% 的同时,QPT 降低 42.4%-57.9%。

4. Insightful Retrieval 诊断:TR / MissTR 解释图检索收益

Figure 5 显示 TR quartile 越高,R@10 越高;FastInsight 和 GAR 在高 TR 区间比 Re2 提升更明显。这支持一个判断:图检索的收益来自“当前节点已靠近 oracle-rich neighborhood”,不是随机扩展。

Table 6 显示 MissTR 与后续 marginal recall gain $\Delta R$ 的相关性通常高于普通 Recall。例如 BSARD-G 上 GAR 的 Recall / MissTR 相关系数为 0.46 / 0.79,FastInsight 为 0.32 / 0.57。这说明 MissTR 比初始命中率更能预测后续图扩展是否有潜力。

Figure 6 显示随着 retrieval budget $b_{max}$ 增大,FastInsight 的 TR 初期上升更快,说明 STeX 更早把搜索推向 oracle-rich neighborhood,GRanker 再把候选按拓扑上下文重排。

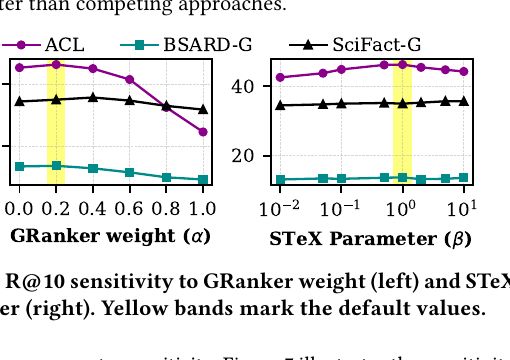
5. 超参数敏感性:$\alpha=0.2,\beta=1$ 是平衡点

Figure 7 显示 GRanker weight $\alpha$ 太接近 0 时退化为只依赖 $O_m$,STeX 参数 $\beta$ 过小或过大时分别偏向只用向量或只用图拓扑,性能都会下降。默认 $\alpha=0.2,\beta=1$ 代表语义和拓扑的平衡。

局限与开放问题

  • 任务范围限定在 corpus graphs,即每个节点有 rich textual content;不覆盖普通社交图、纯结构图或边文本极其重要的 KG setting。

  • 论文明确没有重点利用 edge-level textual information,这对 DualGraph - Symbolic Querying and Semantic Retrieval for Semi-Structured QA、QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples 这类 typed relation / operator setting 是限制。

  • ACL-OCL 的 query 是 synthetic query-gold node pairs,适合测试 insightful retrieval,但需要注意合成问题和真实用户问题之间的分布差异。

  • RAG 评估使用 pairwise LLM-as-a-Judge,生成胜率不是完全确定性的 gold answer accuracy。

  • 论文使用 OpenAI embedding、GPT-5-mini / GPT-5-nano 和 bge-reranker-v2-m3;不同模型、不同 reranker 的成本和性能可能变化。

  • 代码只给匿名链接描述,当前无法复现仓库实现细节。

  • 作者方向:

    • 将方法扩展到 corpus graph 之外的图类型。
    • 更充分利用 edge-level textual information。
  • Agent 推断的 Research Opportunities:

关联与拓展

研究问题入口

Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略, Q8 效率与部署

展开原始论文笔记全文

基本信息

  • 英文标题:FastInsight: Fast and Insightful Retrieval via Fusion Operators for Graph RAG
  • 中文标题:FastInsight:通过融合算子实现快速且有洞察力的 Graph RAG 检索
  • 作者:Seonho An, Chaejeong Hyun, Min-Soo Kim
  • 机构:KAIST
  • 年份:2026
  • 版本:arXiv v1,2026-01-26;arXiv comment 为 under review
  • 会议 / 期刊:论文模板显示 SIGIR'26,但正式录用状态未确认。
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:正文只写 Anonymous GitHub Link,PDF 中未给出可访问公开仓库。
  • 阅读状态:PDF级
  • 所属方向:GraphRAG retrieval operators、corpus graph retrieval、fast insightful retrieval、reranking、topological retrieval
  • 优先级:P1

Background

  • 研究问题:面向 corpus graph 的 GraphRAG 需要在节点文本和图拓扑之间做多步检索。现有方法要么只做向量相似检索,要么依赖 LLM 多轮 interleaving,效果和延迟之间很难兼得。
  • 为什么重要:论文把这类需求称为 Insightful Retrieval:检索器不仅要看当前节点文本,还要理解中间检索结果,并据此决定下一步扩展方向。这个能力对文献引用图、法规图、科学事实图和文本丰富 KG 都很关键。
  • 现有方法:
    • Vector search 能利用语义,但不看图结构。
    • Graph search 能沿边扩展,但容易只按拓扑走到语义无关节点。
    • Model-based reranking 能精排文本相关性,但对候选节点的邻域上下文 topology-blind。
    • LLM interleaving 能更灵活,但 query latency 高,不适合实时企业检索。
  • 对本知识库的意义:FastInsight 补上 GraphRAG中的图接口选择与任务类型 和 GraphRAG中的Evidence Utility 而非 Evidence Quantity 中“图检索算子库”的缺口。它不像 STAR - Semantic-Tuned and Tail-Adaptive Retriever for GraphRAG 训练 KG reasoning path scorer,而是在 corpus graph 上把检索流程拆成可组合 operator,并提出低延迟 fusion operator。

Gap

  • 基础算子存在两个结构性缺陷:
    • Model-based search $O_m$ 只看 query-node 文本匹配,不看候选节点之间的图邻域,存在 topology-blindness。
    • Graph search $O_{gs}$ 只按图连接扩展,不看 query 语义和节点向量,存在 semantics-blindness。
  • 现有 GraphRAG 检索多是顺序组合 $O_{vs}$、$O_{gs}$、$O_m$,没有真正把语义和拓扑融合到同一个 scoring / expansion operator。
  • LLM-based interleaving retrieval 能模拟“理解 -> 决策”,但需要频繁 LLM 调用。论文报告 IRCoT + Vector Search 在 SciFact-G 上 QPT 为 6.54s / 5.03s,而 FastInsight 为 3.77s / 2.12s。
  • 评估上,普通 Recall 只看是否命中 oracle nodes,不衡量当前检索节点离未命中的 oracle nodes 有多近,因此难以判断图检索是否真的在向正确邻域靠近。

Insight

  • 一句话创新点:FastInsight 把 GraphRAG 检索分解为基础算子和融合算子,用 GRanker 在 reranking 中融合拓扑邻域,用 STeX 在图扩展中融合语义相似度,从而在不依赖多轮 LLM 推理的情况下实现快速 Insightful Retrieval。
  • 核心洞察:
    • GraphRAG 检索不应只问“向量、图遍历、reranker 哪个更好”,而应问“这些算子如何组合,以及缺失了哪种输入信号”。
    • reranker 的 cross-encoder 表示可以看作 noisy semantic signal,再通过 graph Laplacian smoothing 引入邻域结构。
    • 图扩展不应只看边,也应在扩展候选中加入 query-vector similarity,避免沿拓扑走向语义无关节点。
    • Topological Recall 能度量 retrieved nodes 到 missing oracle nodes 的图距离,适合作为 GraphRAG 检索“靠近正确证据”的诊断指标。

Method

1. Operator Taxonomy:把 GraphRAG 检索拆成基础算子

FastInsight-fig1-workflow-comparison

Figure 1 对比了 LightRAG、PathRAG、GAR 和 FastInsight 的检索操作序列。论文把基础检索算子分成三类:

  1. Vector Search $O_{vs}$:根据 query vector 和 node vector 相似度取 top-k。
  2. Graph Search $O_{gs}$:从 seed nodes 沿图拓扑扩展。
  3. Model-based Search $O_m$:用 reranker / cross-encoder / small LM 对候选节点打分。

FastInsight-table1-operator-taxonomy

Table 1 的价值在于把 GraphRAG 方法从“系统名称”还原成“算子组合”。FastInsight 的区别是引入两个 fusion operators:$O_{gm}$ 和 $O_{vgs}$,而不是只顺序堆叠基础算子。

输入:

  • query $q$
  • corpus graph $G=(N,E)$
  • node vectors $V={v_n\mid n\in N}$
  • query vector $v_q$

基础 vector search:

N_{VS}=O_{vs}(v_q,N,k)=\arg topk_{n\in N} sim(v_q,v_n)

基础 graph search:

N_{GS}=O_{gs}(N_{seed},H_{seed},E)=P_{GS}(R_{GS}(N_{seed},H_{seed},E))

基础 model-based search:

N_M=O_m(q,N_{seed},k)=\arg topk_{n\in N_{seed}} P_\phi(q,n)

输出:一个可比较、可组合的 GraphRAG retrieval operator taxonomy。

2. FastInsight 主流程:$O_{vs}\rightarrow(O_{gm},O_{vgs})$

FastInsight-algorithm1-overall-flow

输入:query $q$、图 $G=(N,E)$、node vectors $V$、query vector $v_q$、batch size $BATCH$、GRanker 平滑系数 $\alpha$、STeX score ratio $\beta$、最大预算 $b_{max}$。

计算:

  1. Initial Vector Search:
N_{ret}\leftarrow \arg top BATCH_{n\in N} sim(v_q,V_n)
  1. 用 GRanker 对初始节点做 graph-aware reranking:
N_{ret}\leftarrow GRanker(q,N_{ret},E,\alpha)
  1. 当 $|N_{ret}|<b_{max}$ 时循环:
    • 用 STeX 从当前 $N_{ret}$ 邻域中找新增节点 $N_{add}$。
    • 按预算加入最多 $BATCH$ 个节点。
    • 再用 GRanker 更新排序。

输出:满足预算的 retrieved node list $N_{ret}$。

这个流程把 expensive reranker 限制在小批候选上,同时用图扩展不断改善候选池质量。

3. GRanker:Graph Model-based Search $O_{gm}$

FastInsight-algorithm2-granker

GRanker 解决 $O_m$ 的 topology-blindness:普通 reranker 只看 query-node 文本,忽略候选节点是否处在相互支持的图邻域中。

输入:

  • query $q$
  • 当前候选 $N_{ret}$
  • 边集合 $E$
  • smoothing factor $\alpha$

计算:

先用 cross-encoder 提取候选节点 latent vectors:

H=[Encoder(q,n_i)]_{n_i\in N_{ret}}

在候选子图上构造归一化传播矩阵 $P$,然后做一阶 Laplacian smoothing:

H'=(1-\alpha)H+\alpha(PH)

最后用 MLP 评分并重排:

S=MLP(H')
N_{ret}\leftarrow argsort(N_{ret},score=S)

输出:融合了文本语义和邻域拓扑的 reranked candidates。

直观解释:如果两个节点文本都相关,但其中一个节点被相关邻居支持得更好,GRanker 会把这种结构信号注入 reranker 表示。

4. STeX:Vector-Graph Search $O_{vgs}$

FastInsight-algorithm3-stex

STeX 解决 $O_{gs}$ 的 semantics-blindness:普通图遍历只看边,可能沿着拓扑连通性走到 query 无关节点。

输入:

  • query vector $v_q$
  • node vectors $V$
  • graph edges $E$
  • 当前已检索节点 $N_{ret}$
  • score ratio $\beta$

计算:

先构造一跳候选:

N_{STeX}=\{n_j\mid \exists n_i\in N_{ret},(n_i,n_j)\in E\}\setminus N_{ret}

对每个候选节点 $n$ 计算 structural score。它由两部分组成:

  • rank proximity:是否连接到当前高排名节点;
  • bridging capability:是否连接多个已检索节点,近似捕捉 structural hole / broker 价值。

再计算语义相似度:

I_{Sim}=v_q\cdot V_n

最终 STeX score:

S_n=I_{Sim}+\beta\cdot I_{Struct}

输出:按 $S_n$ 排序的新增节点 $N_{add}$。

直观解释:STeX 不是“看到边就扩展”,而是在当前图邻域里优先选择既结构上靠近已检索证据、又语义上接近 query 的节点。

5. Topological Recall:衡量“离未命中 oracle 有多近”

普通 Recall 只看 oracle node 是否直接进入 $N_{ret}$。FastInsight 额外提出 Topological Recall:

TR(E,N_{ret},N_{oracle})= avg_{n_i\in N_{oracle}} \left( \frac{1}{1+u(E,N_{ret},n_i)} \right)

其中 uncertainty function $u$ 是从当前 retrieved node 到 oracle node 的最短路径上的 log-degree 累积:

u(E,N_{ret},n_i)= \min_{n_j\in N_{ret}} \sum_{n_k\in SP(E,n_j,n_i),n_k\ne n_i} \ln(1+deg_E(n_k))

TR 与 Recall 的关系:

TR=Recall+\frac{|N_{oracle}\setminus N_{ret}|}{|N_{oracle}|}\cdot TR(E,N_{ret},N_{oracle}\setminus N_{ret})

输出:即使 oracle 没被直接命中,也能衡量当前检索是否已经靠近正确邻域。论文把第二项称为 MissTR,用来分析 missing oracle nodes 的可达性。

Results

1. 检索主结果:平均 R@10 / nDCG@10 最强

FastInsight-table3-retrieval-results

Table 3 在 5 个 corpus graph retrieval datasets 上比较 9 个 baseline。FastInsight 的 Overall R@10 / nDCG@10 为 36.6 / 33.6,高于最强 baseline GAR 的 33.3 / 30.8。论文总结相对最强 baseline 平均提升 9.9% R@10、9.1% nDCG@10。

关键读法:

  • 在 ACL-OCL 引用网络上,FastInsight R@10 为 46.3,GAR 为 36.3,Re2 为 29.6。
  • 在 LACD 法律引用网络上,FastInsight R@10 为 50.3,略高于 GAR 48.6。
  • 在 text-rich KG 上增益较小但稳定,说明方法在强文本相似 baseline 已经较强时仍能补充拓扑信号。

2. RAG 结果:检索增益能转化为生成胜率

FastInsight-table4-rag-win-rates

Table 4 用 GPT-5-nano 基于检索节点生成答案,再用 pairwise LLM-as-a-Judge 评估。FastInsight 对所有 baseline 的平均 win rate 都超过 55%。其中对 Re2 的平均胜率为 64.6%,对 PathRAG 为 65.0%,对 GAR-RAG 为 55.0%。

解读:FastInsight 不是只提高离线检索指标,它返回的节点也能改善最终生成质量。不过这里依赖 LLM-as-a-Judge,结论应看作生成质量趋势,而不是确定性事实匹配。

3. 效率结果:比 LLM interleaving 更快

FastInsight-fig4-qpt-r10-pareto

Figure 4 显示 FastInsight 在 ACL-OCL 和 SciFact-G 上形成 Pareto improvement:同等或更低平均 QPT 下,R@10 高于 GAR 和 Re2。

FastInsight-table5-ircor-time-efficiency

Table 5 比较 FastInsight 和 IRCoT + Vector Search。SciFact-G 上:

  • IRCoT + Vector Search:R@10 31.4,TITAN 6.54s,A100 5.03s。
  • FastInsight:R@10 35.1,TITAN 3.77s,A100 2.12s。

论文总结 FastInsight 在提升 R@10 11.7% 的同时,QPT 降低 42.4%-57.9%。

4. Insightful Retrieval 诊断:TR / MissTR 解释图检索收益

FastInsight-fig5-topological-recall-impact

Figure 5 显示 TR quartile 越高,R@10 越高;FastInsight 和 GAR 在高 TR 区间比 Re2 提升更明显。这支持一个判断:图检索的收益来自“当前节点已靠近 oracle-rich neighborhood”,不是随机扩展。

FastInsight-table6-misstr-correlation

Table 6 显示 MissTR 与后续 marginal recall gain $\Delta R$ 的相关性通常高于普通 Recall。例如 BSARD-G 上 GAR 的 Recall / MissTR 相关系数为 0.46 / 0.79,FastInsight 为 0.32 / 0.57。这说明 MissTR 比初始命中率更能预测后续图扩展是否有潜力。

FastInsight-fig6-tr-evolution

Figure 6 显示随着 retrieval budget $b_{max}$ 增大,FastInsight 的 TR 初期上升更快,说明 STeX 更早把搜索推向 oracle-rich neighborhood,GRanker 再把候选按拓扑上下文重排。

5. 超参数敏感性:$\alpha=0.2,\beta=1$ 是平衡点

FastInsight-fig7-hyperparameter-sensitivity

Figure 7 显示 GRanker weight $\alpha$ 太接近 0 时退化为只依赖 $O_m$,STeX 参数 $\beta$ 过小或过大时分别偏向只用向量或只用图拓扑,性能都会下降。默认 $\alpha=0.2,\beta=1$ 代表语义和拓扑的平衡。

Limitations

  • 任务范围限定在 corpus graphs,即每个节点有 rich textual content;不覆盖普通社交图、纯结构图或边文本极其重要的 KG setting。
  • 论文明确没有重点利用 edge-level textual information,这对 DualGraph - Symbolic Querying and Semantic Retrieval for Semi-Structured QA、QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples 这类 typed relation / operator setting 是限制。
  • ACL-OCL 的 query 是 synthetic query-gold node pairs,适合测试 insightful retrieval,但需要注意合成问题和真实用户问题之间的分布差异。
  • RAG 评估使用 pairwise LLM-as-a-Judge,生成胜率不是完全确定性的 gold answer accuracy。
  • 论文使用 OpenAI embedding、GPT-5-mini / GPT-5-nano 和 bge-reranker-v2-m3;不同模型、不同 reranker 的成本和性能可能变化。
  • 代码只给匿名链接描述,当前无法复现仓库实现细节。

Future Directions

  • 作者方向:
    • 将方法扩展到 corpus graph 之外的图类型。
    • 更充分利用 edge-level textual information。
  • Agent 推断的 Research Opportunities:

与本知识库的连接

一句话定位

FastInsight 的核心价值是把 corpus-graph GraphRAG 检索从“向量检索 + 图遍历 + reranker 的经验组合”推进到“可命名、可诊断、可融合的 retrieval operator pipeline”:GRanker 补 topology-blind reranking,STeX 补 semantics-blind graph expansion,TR / MissTR 则提供了衡量检索是否靠近正确证据邻域的新指标。