研究问题与动机
-
研究问题:Agentic search 通过多轮检索、推理、query rewrite 和 policy learning,可以在 dense RAG 上形成“隐式结构”。这引出一个核心问题:如果 online interaction 已经能组织证据,是否还值得付出 offline graph construction 成本?
-
为什么重要:这是 GraphRAG中的何时图优于扁平检索 和 GraphRAG中的Query-Complexity与结构选择 的直接实证版本。它不是再问“哪种 GraphRAG 更强”,而是问“在哪些任务上图结构仍有边际收益”。
-
现有方法:
- Dense RAG:低构建成本、适合一般 QA,但缺少显式关系结构。
- GraphRAG:通过 tree、entity graph、hypergraph、tri-graph 等结构提供 explicit inductive bias,但有离线构建和维护成本。
- Agentic search:Search-o1、GraphSearch、Search-R1、Graph-R1 等方法让模型在推理中多轮检索,形成 online implicit structure。
-
过往比较常把 RAG、GraphRAG 和 agentic 方法作为端到端系统比较,难以分离“检索后端”与“agent 控制逻辑”的贡献。
-
很多实验没有统一 LLM backbone、retrieval budget、推理协议和 test set,导致“图是否必要”的结论不稳定。
-
GraphRAG 的成本不仅是在线检索,还包括 entity extraction、summarization、graph construction、index maintenance;如果不报告成本,容易高估图结构的实际价值。
-
Agentic search 对 dense RAG 的提升是否足以替代显式图结构,缺少统一 benchmark。
方法与机制
- 整体框架:RAGSearch benchmark。它把检索后端和 agent 控制逻辑解耦:
- Retrieval backend:Dense RAG、GraphRAG、RAPTOR、HippoRAG2、HyperGraphRAG、LinearRAG。
- Agentic inference:training-free Search-o1 / GraphSearch,RL-based Search-R1 / Graph-R1。
- 统一设置:相同 LLM backbone、retrieval budget、interaction protocol、full test set。
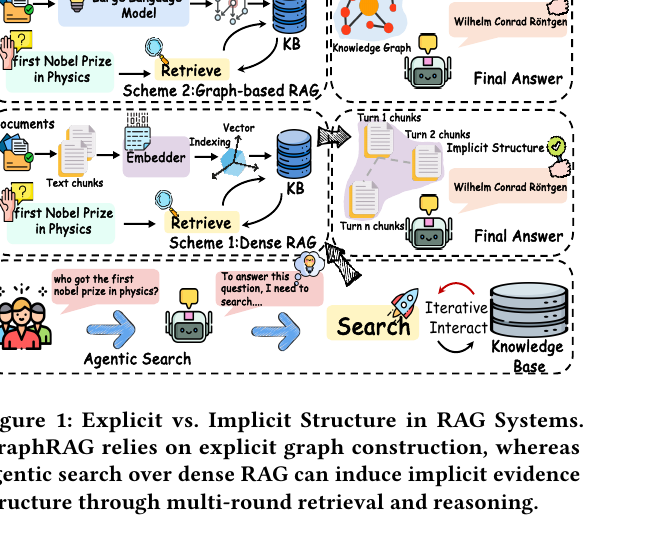
Figure 1 给出论文的核心问题。GraphRAG 用 offline graph construction 产生 explicit structure;dense RAG + agentic search 则通过多轮检索和推理在 online interaction 中形成 implicit structure。这张图对应本知识库的元问题:结构到底应该提前建在索引里,还是在推理时动态形成?
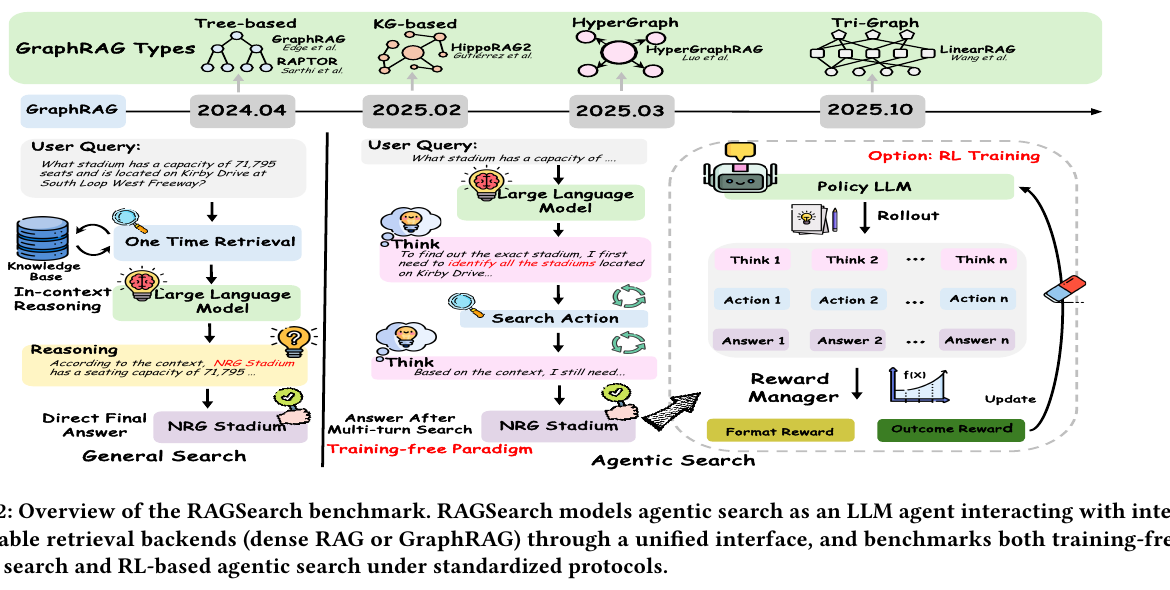
Figure 2 是 RAGSearch 框架。左侧是 one-time retrieval 的 general search;中间是 training-free agentic search,LLM 在 think / search / think 循环中不断改写查询;右侧是 RL training,让 policy LLM 通过 reward manager 更新检索与回答策略。上方把 GraphRAG 后端分成 tree-based、KG-based、hypergraph、tri-graph 四类。
- General agentic search formulation:
其中 B 可以是 dense RAG,也可以是 GraphRAG 后端。agent 在每一步生成 reasoning、search query、retrieved information,直到输出 final answer。
- 训练范式:
- Training-free:Search-o1 代表 reasoning-driven on-demand search;GraphSearch 代表 decomposition / search / verification / answer 的多模块工作流。
- RL-based:Search-R1 / Graph-R1 将 agentic search 建模为策略学习问题,用 GRPO 训练 policy。
- 数据集:
- General QA:Natural Questions、PopQA、TriviaQA。
- Multi-hop QA:HotpotQA、MuSiQue、2WikiMultiHopQA。
- 指标:
- Contain Exact Match。
- F1。
- 离线构建成本、在线 retrieval time、context length。
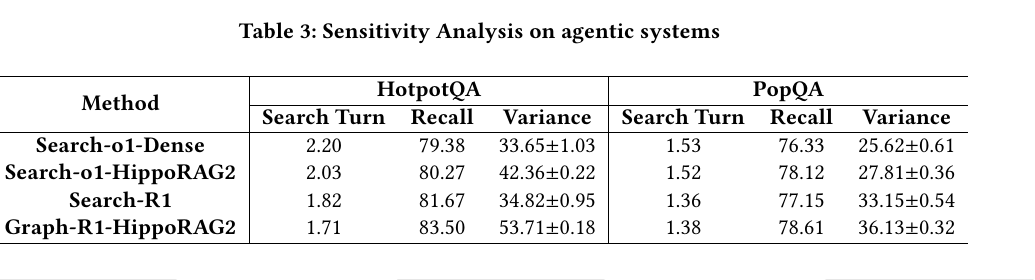
- 稳定性:search turn、recall、Contain-EM variance。
证据与结果
主结果:Agentic search 缩小差距,但 GraphRAG 在多跳上仍强
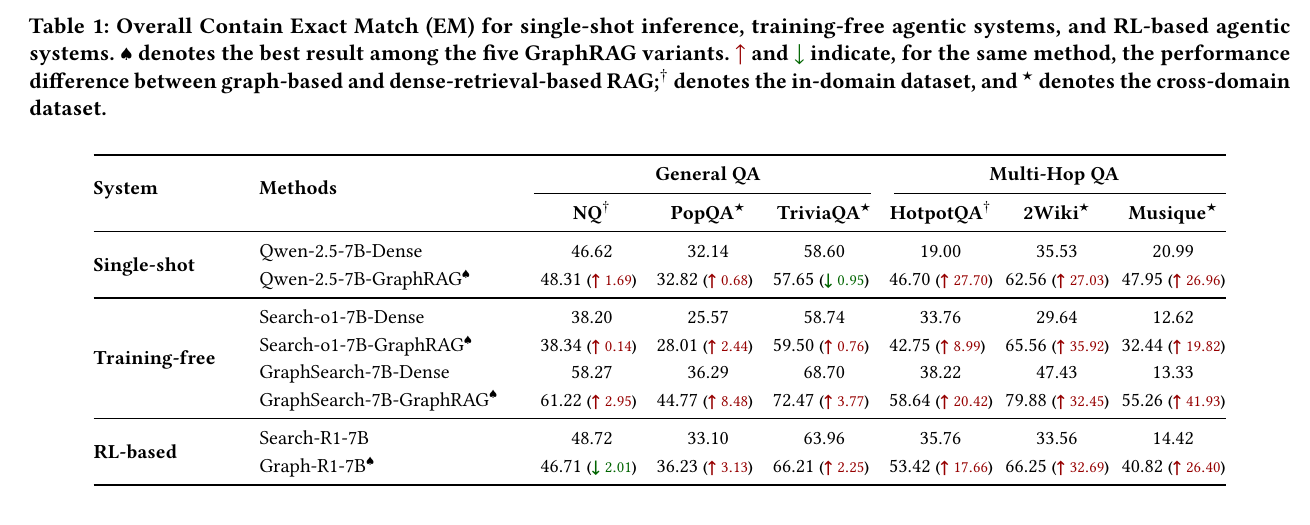
- Single-shot:GraphRAG 对 general QA 只带来小增益,平均约 +0.47;但在 HotpotQA / 2Wiki / MuSiQue 上平均提升约 +27.23。
- Training-free:Search-o1 / GraphSearch 能让 dense RAG 变强,说明 online interaction 确实能补一部分结构;但 GraphRAG 在 multi-hop QA 上仍显著领先。
- RL-based:Search-R1 到 Graph-R1 后,multi-hop QA 仍有明显图结构收益。HotpotQA 从 35.76 到 53.42,2Wiki 从 33.56 到 66.25,MuSiQue 从 14.42 到 40.82。
- 解读:agentic search 不是“替代图”,而是把一部分结构从 offline graph construction 转移到 online interaction;复杂多跳任务仍需要显式结构支撑。
Training-free 后端比较:HippoRAG2 最稳定
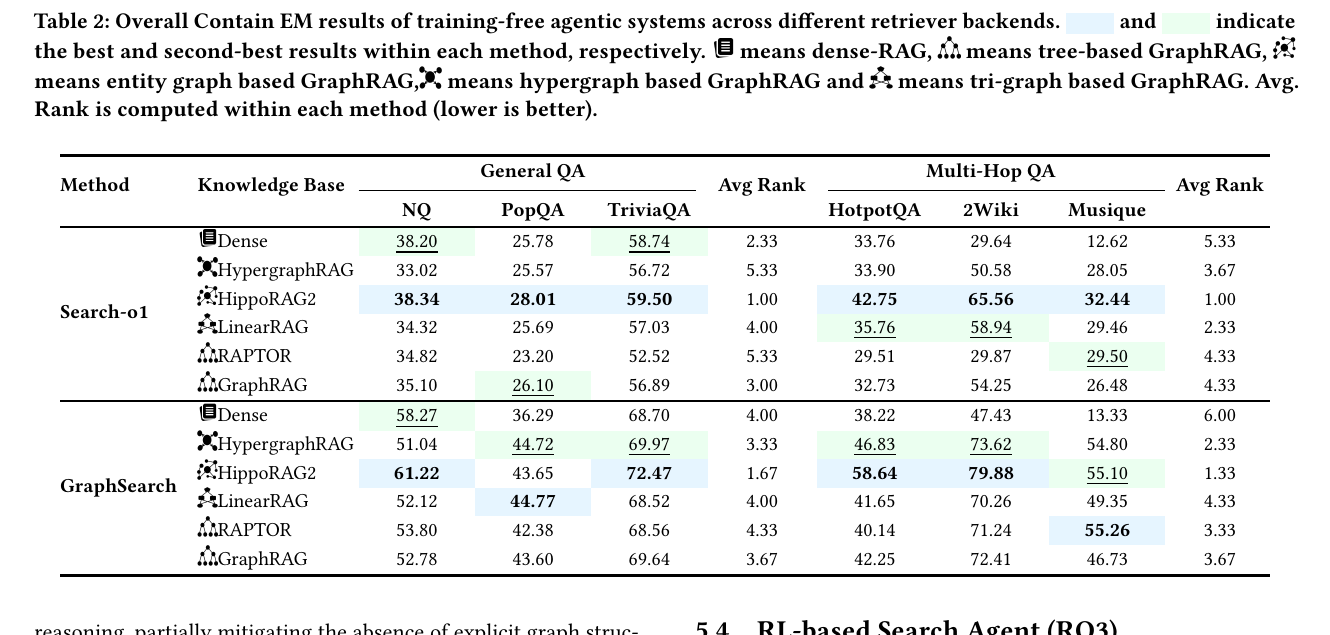
- Search-o1 下,HippoRAG2 在 general QA 和 multi-hop QA 的 Avg Rank 都是 1.00。
- GraphSearch 下,HippoRAG2 在 multi-hop QA 的 Avg Rank 为 1.33,HypergraphRAG 为 2.33,dense RAG 为 6.00。
- Dense RAG 在 general QA 中仍有竞争力,但在 multi-hop QA 中明显弱于多个 GraphRAG 后端。
- 解读:GraphRAG 不是一个单一选择。实体图、hypergraph、tree、tri-graph 的收益不同;在这篇实验里,entity-centric HippoRAG2 最适合 agentic search 利用。
稳定性:GraphRAG 降低 agentic search 方差
- HotpotQA:Search-o1-Dense 的 Contain-EM variance 为 33.65±1.03;Search-o1-HippoRAG2 为 42.36±0.22。
- HotpotQA:Search-R1 为 34.82±0.95;Graph-R1-HippoRAG2 为 53.71±0.18。
- Search turn 差异不大,但 GraphRAG recall 更高、variance 更低。
- 解读:显式结构不只是提高平均分,也让多轮 agentic search 更稳定。这一点对科研知识库很关键,因为我们需要可审计、可复现的 evidence trajectory,而不只是偶然答对。
RL 算法和模型规模
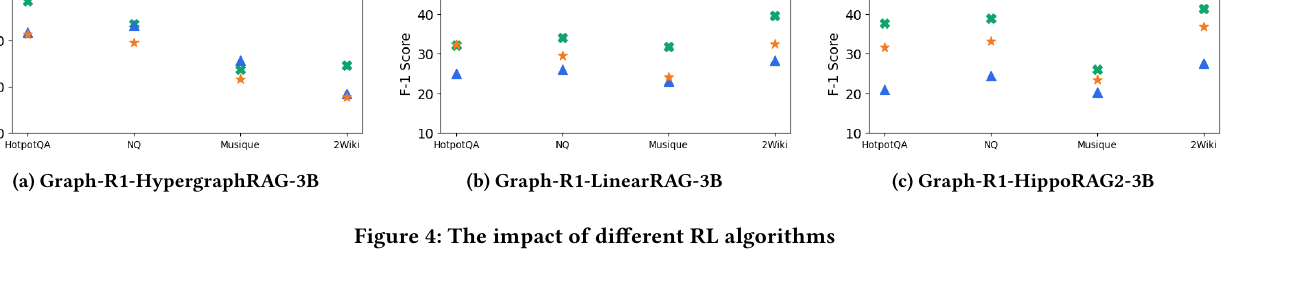
- GRPO 在多个 Graph-R1 后端上优于 PPO / RPP,说明 agentic GraphRAG 的 policy learning 选择会影响最终效果。
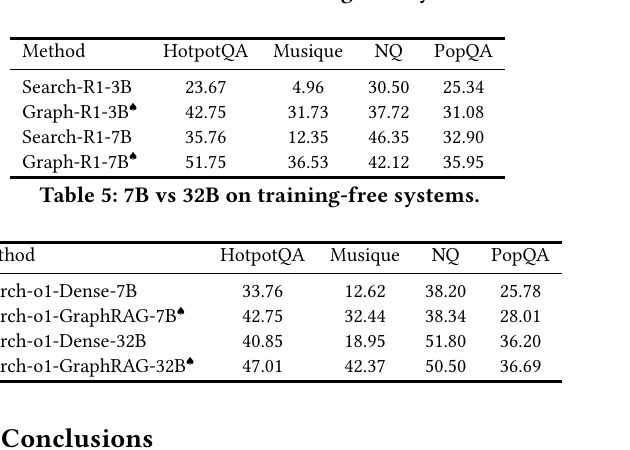
- 7B 相比 3B 提升明显;32B training-free 相比 7B 也缩小 dense / graph 的差距。
- 解读:大模型更能通过推理形成 implicit structure,因此 GraphRAG 的边际收益会随 backbone 能力变化。这支持 GraphRAG中的结构强度与Query-Complexity动态切换 的判断:结构需求不是固定的,会受模型能力和预算影响。
成本:GraphRAG 的收益必须和离线构建成本一起看
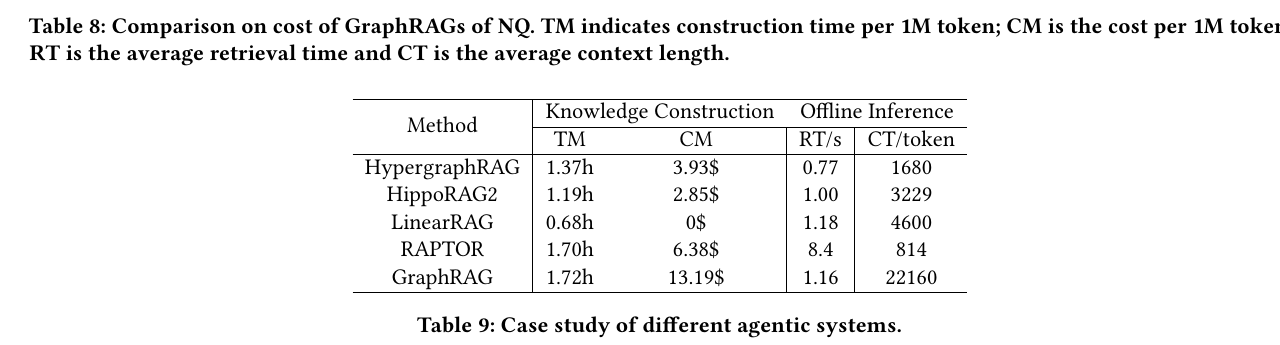
- NQ 上各 GraphRAG 的 construction time per 1M token:
- LinearRAG:0.68h,$0。
- HippoRAG2:1.19h,$2.85。
- HypergraphRAG:1.37h,$3.93。
- RAPTOR:1.70h,$6.38。
- GraphRAG:1.72h,$13.19。
- GraphRAG 的 average context length 很高,达到 22160 tokens;RAPTOR retrieval time 为 8.4s。
- 解读:GraphRAG 在复杂多跳上有价值,但对 general QA 未必划算。只有当离线构建成本能被大量复杂查询 amortize,或系统强需求稳定 multi-hop evidence 时,显式图结构才更值得。
局限与开放问题
-
论文 PDF 仍保留 ACM 模板占位信息,说明稿件元数据未完全清理。
-
GraphRAG 后端实现依赖各开源版本和作者重实现,具体细节可能影响公平性。
-
使用 Contain EM 和 F1,仍主要是答案级指标;对 trajectory faithfulness、citation grounding、support-set completeness 的评估不足。
-
成本表只覆盖 NQ 的 GraphRAG cost,不能直接推广到所有语料规模和领域。
-
GraphSearch 的 F1 表中表现异常低,但 EM 表很高,说明不同指标和输出格式可能存在不一致,需要后续复核。
-
对“图是否必要”的回答仍依赖任务分布:general QA、multi-hop QA、科研文献问答、企业知识库问答可能边界不同。
-
作者 Future Work:论文主要在 conclusion 中指出,需要继续研究 explicit structure 与 online interaction 的平衡,而不是把 agentic search 视为 GraphRAG 的替代。
-
Agent 推断的 Research Opportunities:
- 构建 query-complexity router:先判断当前 query 是 general QA、multi-hop、global summarization 还是 constrained execution,再决定 dense / graph / agentic graph。
- 把 offline graph construction cost 和 online search cost 统一到总预算模型中,形成 cost-amortized GraphRAG selection。
- 给 agentic search 增加 trajectory-level evidence evaluation:不仅看 EM/F1,还看 support-set recall、citation grounding、search turns、variance。
- 在本地 GraphRAG 方法中复刻“same agent, different backend”的比较,避免把 agent prompt 效果误归因给图结构。
- 比较 A2RAG 的 stage-wise controller 和 RAGSearch 的 backend-level comparison:一个回答“何时升级图检索”,一个回答“何时需要图后端”。
关联与拓展
- 相关论文:A2RAG - Adaptive Agentic Graph Retrieval、Graph-R1、HippoRAG、LinearRAG、GraphRAG-Microsoft、RAPTOR
- 相关理论:GraphRAG中的何时图优于扁平检索、GraphRAG中的Query-Complexity与结构选择、GraphRAG中的结构强度与Query-Complexity动态切换、GraphRAG中的停止准则与预算分配形式化、GraphRAG中的Agentic轨迹质量
- 可接到的当前方法:
- 作为 GraphRAG router 的实证依据:simple query 走 dense RAG,multi-hop / bridge-heavy query 走 GraphRAG。
- 作为实验协议参考:固定 agent 控制逻辑,只替换 retrieval backend。
- 作为成本报告模板:同时记录 construction time、construction cost、retrieval time、context length、answer metrics。
研究问题入口
Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略