GGraphRAG 文献图谱自动同步
LIT-F75B9483 · 2026

LiteSemRAG - Lightweight LLM-Free Semantic-Aware Graph Retrieval

LiteSemRAG 用 token-level contextual embeddings 构建 document / chunk / semantic / token 四层异构语义图,并通过 co-occurrence graph semantic retrieval + isolated semantic recovery 实现完全无 LLM 的语义感知图检索。

PDF 级阅读卡优先级 P0Xiao Yue, Guangzhi Qu, Lige Gan未标注正式会议或期刊
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:GraphRAG 通过图结构支持多层次推理和结构化证据聚合,但主流 GraphRAG / LightRAG 类系统在 indexing 和 querying 阶段经常调用 LLM 做实体抽取、摘要、图遍历或查询理解。

  • 为什么重要:LLM-heavy GraphRAG 的离线 token 消耗、查询延迟、模型依赖和上下文长度问题,会限制大规模语料、频繁更新知识库、本地部署和低成本场景。

  • 现有路线:

    • GraphRAG / LightRAG:用 LLM 构建或查询图结构,效果强但有 token 和延迟成本。
    • NoLLMRAG:尝试去掉 LLM,但主要依赖 surface-level lexical / static statistical structures,缺少显式上下文语义建模。
    • ContextRAG - Extraction-Free Hierarchical Graph Construction:不依赖 LLM 抽取实体关系,但仍在 query-time 使用 LLM rewrite / rerank / answer generation。
  • 对本知识库的意义:LiteSemRAG 把“低成本图检索”推进到更极端的 regime:索引和查询检索本身都不调用 LLM,只用 token-level contextual embeddings 构建语义图。

  • LLM 依赖成本高:GraphRAG / LightRAG 在 indexing 和 querying 中调用 LLM,会引入 token cost、latency variability 和模型敏感性。

  • 低成本路线语义不足:NoLLMRAG 虽然去掉 LLM,但缺少 contextual semantic modeling,只靠表层词和统计结构,难处理多义词和复杂多跳检索。

  • flat chunk retrieval 不够:普通 dense / sparse chunk retrieval 不显式表达 document structure、semantic variation 和 multi-hop evidence dependency。

  • 图结构和语义覆盖难兼顾:只看 co-occurrence graph 会漏掉结构上孤立但语义相关的证据;只做 broad semantic search 又会引入大量噪声和 reranking 成本。

方法与机制

1. 输入:文档集合 -> chunks -> token-level contextual embeddings

输入是文档集合。LiteSemRAG 先把每篇文档切成 chunks,再用 NLP tools 抽取重要 textual elements,包括 entities、phrases 和 tokens。每个元素用 token-level text encoder 编码为 contextual semantic embedding。

论文实验中:

  • GraphRAG / LightRAG 使用 text-embedding-3-small 作为 sentence-level embedding encoder。
  • LiteSemRAG 使用 deberta-v3-large,因为它需要 token-level contextual embeddings。

输出:每个 token occurrence 的上下文向量,后续用于构建 semantic nodes。

2. 构建四层异构语义图

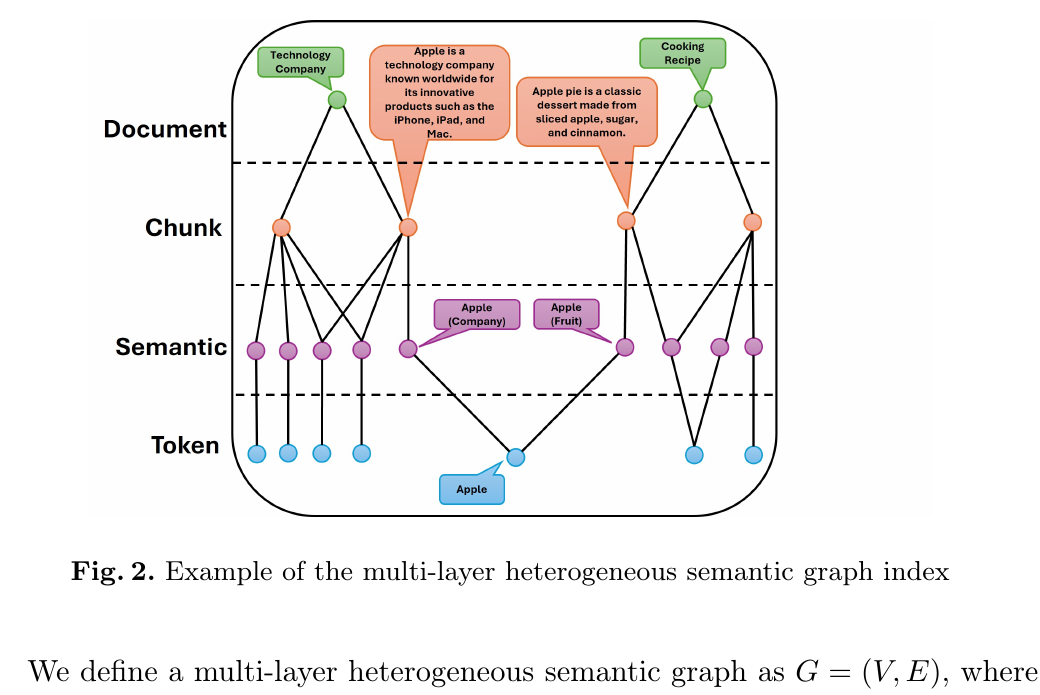
LiteSemRAG 定义多层异构语义图:

G=(V,E)

节点集合:

V=D\cup C\cup S\cup T
  • $D$:document nodes。
  • $C$:chunk nodes。
  • $S$:semantic nodes,每个节点表示某个 token 的一个上下文语义。
  • $T$:token nodes,每个节点表示 surface textual element。

边集合包含三类双向边:

  • Document-Chunk:chunk 属于哪个 document。
  • Chunk-Semantic:某个 semantic meaning 出现在 chunk 中。
  • Semantic-Token:semantic node 连接回 surface token。

输出:一个把表层词形和上下文语义分离的 graph index。

3. 动态语义节点构建:用分布离散度判断是否拆分多义 token

对每个 token $t$,收集其所有 normalized contextual semantic embeddings:

E_t=\{e_1,e_2,\ldots,e_n\}

先计算平均方向:

\bar{e}_t=\frac{1}{n}\sum_{i=1}^{n}e_i

再计算 embedding concentration / dispersion score:

S\text{-}mean(t)=\frac{1}{n}\sum_{i=1}^{n}cos(e_i,\bar{e}_t)

计算含义:

  • $S\text{-}mean$ 高:token 的上下文语义集中,倾向单义。
  • $S\text{-}mean$ 低:embedding 分布可能有多个 clusters,倾向多义。

LiteSemRAG 只在以下条件满足时对 token 做 clustering-based semantic induction:

IDF(t)>\tau_{idf}\quad \text{and}\quad S\text{-}mean(t)<\tau_{disp}

这样避免把高频、低信息量 token 过度切分。

4. Clustering-based semantic induction:为不同上下文语义创建 semantic nodes

若 token 被判定可能多义,LiteSemRAG 对 $E_t$ 做 density-based clustering,例如 HDBSCAN。每个 cluster $C_k\subset E_t$ 对应一个 semantic node,其 anchor embedding 为:

e_{s_k}=\frac{1}{|C_k|}\sum_{e_i\in C_k}e_i

若 token 被判定为单义,或者 clustering 没有产生多个稳定 cluster,则只创建一个 semantic node,其 anchor embedding 是该 token 所有 contextual embeddings 的平均。

输出:

  • chunk nodes 从原本的 token occurrence 重新连接到对应 semantic nodes。
  • token node 保持为 lexical anchor,连接该 token 的所有 semantic nodes。
  • raw occurrence embeddings 可丢弃,只保留 semantic anchor embeddings 以节省内存。

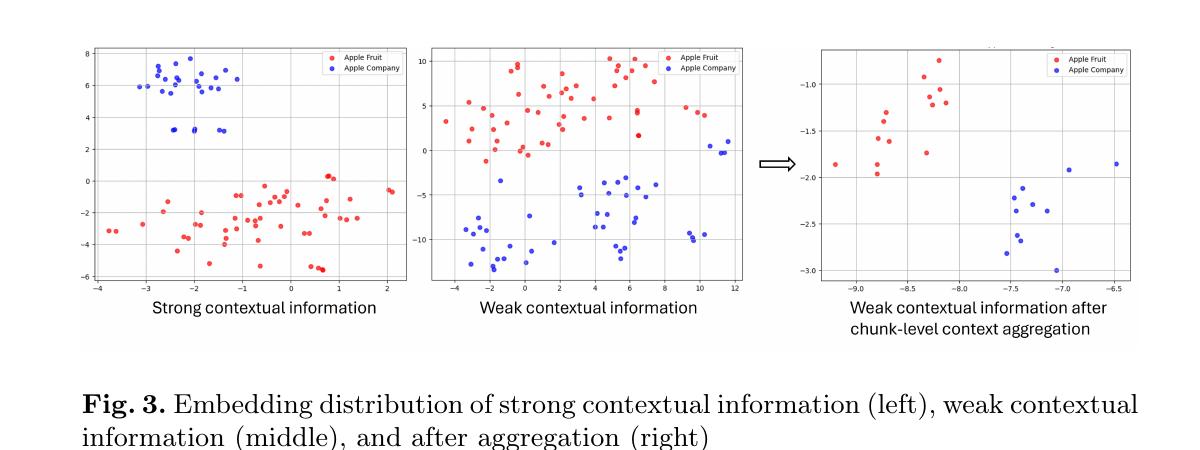
5. Chunk-level context aggregation:弱上下文时增强 cluster separability

当单个 token occurrence 的上下文信息太弱时,polysemous token 的 embedding cluster 可能分不开。LiteSemRAG 在初始 clustering 不稳定时按 chunk 聚合。

设 $C_t$ 是包含 token $t$ 的 chunk 集合。对每个 chunk $c\in C_t$,计算 chunk-level embedding:

\tilde{e}_c=\frac{1}{|E_{t,c}|}\sum_{e_i\in E_{t,c}}e_i

其中 $E_{t,c}$ 是 token $t$ 在 chunk $c$ 中的 embeddings。

计算作用:

  • 降低同一 chunk 内 token occurrence 的噪声。
  • 放大 chunk 间语义差异。
  • 让 apple(company) / apple(fruit) 这类弱上下文场景更容易形成可分 clusters。

6. Adaptive anomaly handling:增量索引时处理新语义漂移

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

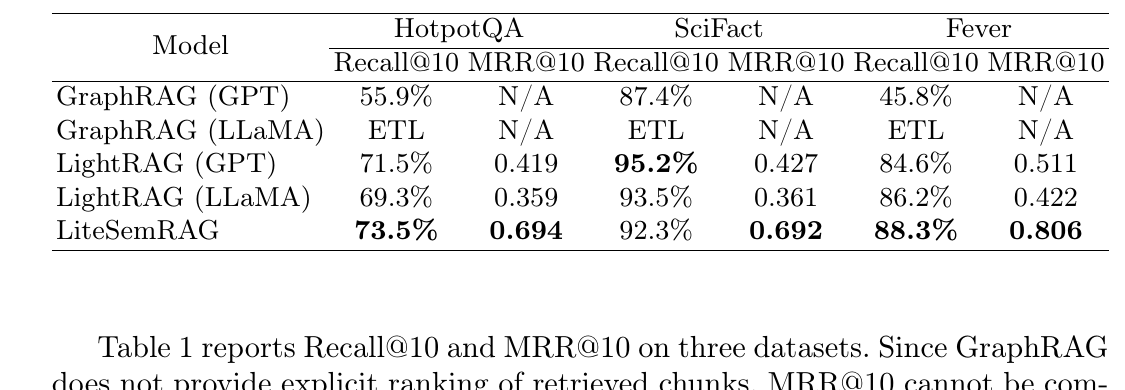
1. Retrieval quality:MRR@10 三个数据集第一,Recall@10 两个数据集第一

Table 1 比较 HotpotQA、SciFact、FEVER 上的 Recall@10 / MRR@10:

  • HotpotQA:LiteSemRAG Recall@10 73.5%、MRR@10 0.694,高于 LightRAG (GPT) 的 71.5% / 0.419。
  • SciFact:LiteSemRAG Recall@10 92.3%,低于 LightRAG (GPT) 的 95.2%,但 MRR@10 0.692 高于 LightRAG (GPT) 的 0.427。
  • FEVER:LiteSemRAG Recall@10 88.3%、MRR@10 0.806,均为最高。
  • GraphRAG 不提供显式 chunk ranking,因此论文不报告 GraphRAG 的 MRR@10。
  • GraphRAG (LLaMA) 在三个数据集上出现 ETL,即 Exceed maximum Token Limitation,无法完成比较。

解读:LiteSemRAG 的强项不是“召回所有证据一定最高”,而是“相关证据更早出现”。这对后续生成模型的上下文预算更有价值。

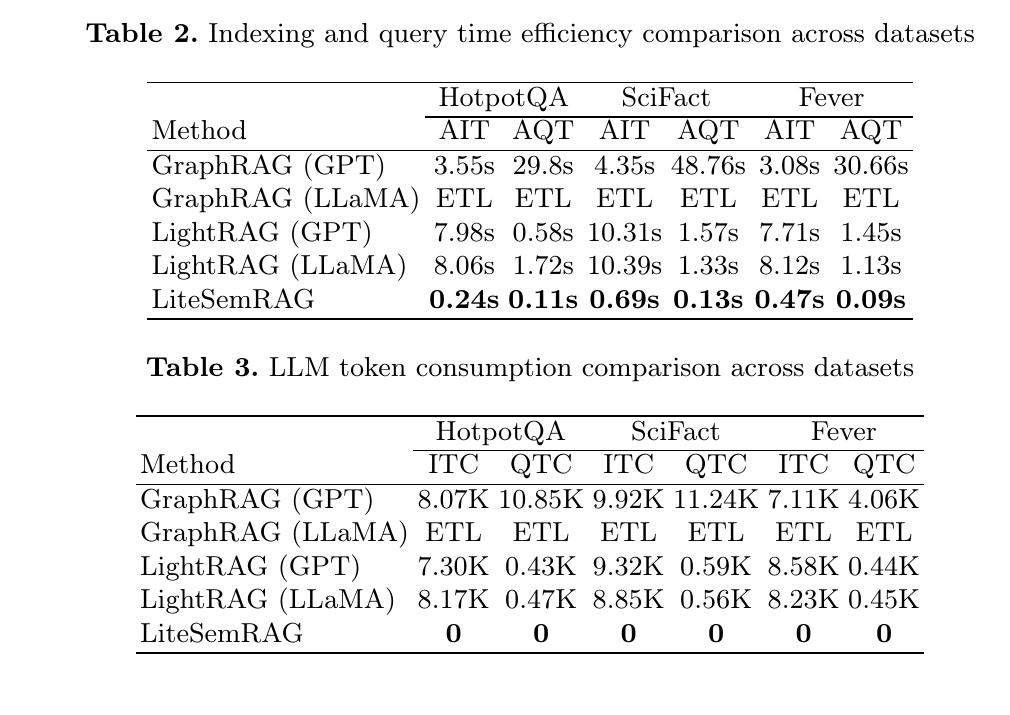
2. Efficiency / Tokens:索引、查询都零 LLM token

Table 2 和 Table 3 显示:

  • HotpotQA:LiteSemRAG AIT / AQT 为 0.24s / 0.11s;LightRAG (GPT) 为 7.98s / 0.58s;GraphRAG (GPT) 为 3.55s / 29.8s。
  • SciFact:LiteSemRAG AIT / AQT 为 0.69s / 0.13s;LightRAG (GPT) 为 10.31s / 1.57s;GraphRAG (GPT) 为 4.35s / 48.76s。
  • FEVER:LiteSemRAG AIT / AQT 为 0.47s / 0.09s;LightRAG (GPT) 为 7.71s / 1.45s;GraphRAG (GPT) 为 3.08s / 30.66s。
  • LLM token consumption:LiteSemRAG 的 ITC / QTC 在三个数据集上全为 0 / 0。

论文总结 LiteSemRAG 相比 LightRAG 约 20x 更快 indexing、10x 更快 querying;相比 GraphRAG 约 10x 更快 indexing、100x 更快 querying。这个结论来自该论文实验设置,应注意硬件和实现差异。

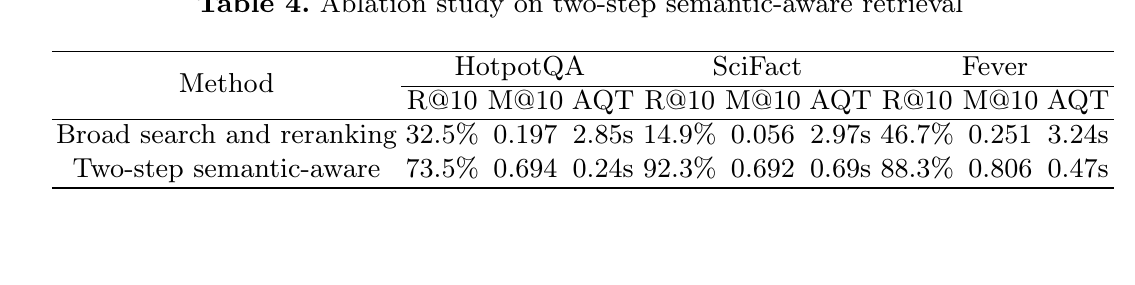
3. Ablation:两步 semantic-aware retrieval 是主要收益来源

Table 4 把标准 LiteSemRAG 与 “broad search + jina-reranker-v3 reranking” 对比,两者使用同一个 semantic index graph 和同一个 token-level encoder,只改变 query-time retrieval strategy。

  • HotpotQA:broad search 32.5% / 0.197 / 2.85s,two-step 73.5% / 0.694 / 0.24s。
  • SciFact:broad search 14.9% / 0.056 / 2.97s,two-step 92.3% / 0.692 / 0.69s。
  • FEVER:broad search 46.7% / 0.251 / 3.24s,two-step 88.3% / 0.806 / 0.47s。

解读:性能不是单纯来自 DeBERTa token-level encoder;co-occurrence graph weighting + isolated semantic recovery 的检索策略本身贡献很大。

局限与开放问题

  • 只评估 retrieval,不评估最终 answer quality:论文明确把 LiteSemRAG 作为 retrieval framework,未比较把 retrieved chunks 输入 LLM 后的 EM/F1/Faithfulness。

  • Baseline 范围有限:主要对比 GraphRAG 和 LightRAG,没有覆盖 HippoRAG2、FastInsight、ContextRAG、NoLLMRAG 的完整统一实验。

  • 图推理能力仍较浅:当前只做 co-occurrence-aware ranking 和 isolated recovery,虽然图结构支持 multi-hop semantic expansion / constrained subgraph extraction / path-based scoring,但论文没有实现或评估这些扩展。

  • 依赖 token-level encoder 和 NLP preprocessing:完全无 LLM 不等于完全无模型,实际质量会受 token extraction、DeBERTa encoder、clustering threshold 和 HDBSCAN 稳定性影响。

  • 多义语义节点的可解释性有限:semantic nodes 来自 embedding clusters,不像 LLM-extracted relation / entity label 那样天然有人类可读标签。

  • 代码可复现状态需谨慎:正文未声明官方代码;同名 GitHub 仓库无 README,当前只能作为潜在线索。

  • 作者明确提到的扩展:

    • 在异构图上加入 deeper graph traversal strategies。
    • 支持 multi-hop semantic expansion。
    • 支持 constrained subgraph extraction。
    • 支持 path-based relevance scoring。
    • 在不使用 LLM graph construction 的前提下继续扩展 graph reasoning operations。
  • Agent 推断的研究机会:

关联与拓展

研究问题入口

Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:LiteSemRAG: Lightweight LLM-Free Semantic-Aware Graph Retrieval for Robust RAG
  • 中文标题:LiteSemRAG:面向鲁棒 RAG 的轻量级无 LLM 语义感知图检索
  • 方法名:LiteSemRAG
  • 作者:Xiao Yue, Guangzhi Qu, Lige Gan
  • 机构:Oakland University
  • 年份:2026
  • 版本:arXiv v1,2026-03-16
  • 会议 / 期刊:未标注正式会议或期刊
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:论文正文未给出官方代码链接;GitHub 可查到同名公开仓库 YxRicardo/LiteSemRAG,但仓库无 README,本文只记录为“同名公开仓库”,不等同于论文正式声明。
  • Semantic Scholar:标题匹配 paperId 9bca964b10d05d5f69a7f359524fe50b0081c5cf,CorpusId 287618272,citationCount 0;直接 arXiv ID 查询本轮遇到 429。
  • 阅读状态:PDF级
  • 所属方向:LLM-free GraphRAG、semantic graph retrieval、low-cost retrieval、polysemy-aware indexing
  • 优先级:P0

Background

  • 研究问题:GraphRAG 通过图结构支持多层次推理和结构化证据聚合,但主流 GraphRAG / LightRAG 类系统在 indexing 和 querying 阶段经常调用 LLM 做实体抽取、摘要、图遍历或查询理解。
  • 为什么重要:LLM-heavy GraphRAG 的离线 token 消耗、查询延迟、模型依赖和上下文长度问题,会限制大规模语料、频繁更新知识库、本地部署和低成本场景。
  • 现有路线:
    • GraphRAG / LightRAG:用 LLM 构建或查询图结构,效果强但有 token 和延迟成本。
    • NoLLMRAG:尝试去掉 LLM,但主要依赖 surface-level lexical / static statistical structures,缺少显式上下文语义建模。
    • ContextRAG - Extraction-Free Hierarchical Graph Construction:不依赖 LLM 抽取实体关系,但仍在 query-time 使用 LLM rewrite / rerank / answer generation。
  • 对本知识库的意义:LiteSemRAG 把“低成本图检索”推进到更极端的 regime:索引和查询检索本身都不调用 LLM,只用 token-level contextual embeddings 构建语义图。

Gap

  • LLM 依赖成本高:GraphRAG / LightRAG 在 indexing 和 querying 中调用 LLM,会引入 token cost、latency variability 和模型敏感性。
  • 低成本路线语义不足:NoLLMRAG 虽然去掉 LLM,但缺少 contextual semantic modeling,只靠表层词和统计结构,难处理多义词和复杂多跳检索。
  • flat chunk retrieval 不够:普通 dense / sparse chunk retrieval 不显式表达 document structure、semantic variation 和 multi-hop evidence dependency。
  • 图结构和语义覆盖难兼顾:只看 co-occurrence graph 会漏掉结构上孤立但语义相关的证据;只做 broad semantic search 又会引入大量噪声和 reranking 成本。

Insight

  • 一句话创新点:LiteSemRAG 用 token-level contextual embeddings 构建 document / chunk / semantic / token 四层异构语义图,并通过 co-occurrence graph semantic retrieval + isolated semantic recovery 实现完全无 LLM 的语义感知图检索。
  • 核心洞察:
    • 表层 token 和上下文语义应该分开建模:同一个 token 可以连接多个 semantic nodes,分别表示不同语义。
    • 多义词不一定要靠 LLM disambiguation;可以用 contextual embeddings 的分布、chunk-level aggregation 和 density clustering 诱导语义节点。
    • 检索时先用共现结构找到结构上互相支持的 semantic nodes,再用 token-family propagation 追回孤立语义节点,能同时保留 structural reasoning 和 semantic coverage。
    • 它不是 end-to-end RAG,而是 retrieval framework;论文只评估 retrieved chunks 的 Recall@10 / MRR@10,不比较最终答案质量。

Method

1. 输入:文档集合 -> chunks -> token-level contextual embeddings

输入是文档集合。LiteSemRAG 先把每篇文档切成 chunks,再用 NLP tools 抽取重要 textual elements,包括 entities、phrases 和 tokens。每个元素用 token-level text encoder 编码为 contextual semantic embedding。

论文实验中:

  • GraphRAG / LightRAG 使用 text-embedding-3-small 作为 sentence-level embedding encoder。
  • LiteSemRAG 使用 deberta-v3-large,因为它需要 token-level contextual embeddings。

输出:每个 token occurrence 的上下文向量,后续用于构建 semantic nodes。

2. 构建四层异构语义图

LiteSemRAG-fig2-heterogeneous-graph

LiteSemRAG 定义多层异构语义图:

G=(V,E)

节点集合:

V=D\cup C\cup S\cup T
  • $D$:document nodes。
  • $C$:chunk nodes。
  • $S$:semantic nodes,每个节点表示某个 token 的一个上下文语义。
  • $T$:token nodes,每个节点表示 surface textual element。

边集合包含三类双向边:

  • Document-Chunk:chunk 属于哪个 document。
  • Chunk-Semantic:某个 semantic meaning 出现在 chunk 中。
  • Semantic-Token:semantic node 连接回 surface token。

输出:一个把表层词形和上下文语义分离的 graph index。

3. 动态语义节点构建:用分布离散度判断是否拆分多义 token

对每个 token $t$,收集其所有 normalized contextual semantic embeddings:

E_t=\{e_1,e_2,\ldots,e_n\}

先计算平均方向:

\bar{e}_t=\frac{1}{n}\sum_{i=1}^{n}e_i

再计算 embedding concentration / dispersion score:

S\text{-}mean(t)=\frac{1}{n}\sum_{i=1}^{n}cos(e_i,\bar{e}_t)

计算含义:

  • $S\text{-}mean$ 高:token 的上下文语义集中,倾向单义。
  • $S\text{-}mean$ 低:embedding 分布可能有多个 clusters,倾向多义。

LiteSemRAG 只在以下条件满足时对 token 做 clustering-based semantic induction:

IDF(t)>\tau_{idf}\quad \text{and}\quad S\text{-}mean(t)<\tau_{disp}

这样避免把高频、低信息量 token 过度切分。

4. Clustering-based semantic induction:为不同上下文语义创建 semantic nodes

若 token 被判定可能多义,LiteSemRAG 对 $E_t$ 做 density-based clustering,例如 HDBSCAN。每个 cluster $C_k\subset E_t$ 对应一个 semantic node,其 anchor embedding 为:

e_{s_k}=\frac{1}{|C_k|}\sum_{e_i\in C_k}e_i

若 token 被判定为单义,或者 clustering 没有产生多个稳定 cluster,则只创建一个 semantic node,其 anchor embedding 是该 token 所有 contextual embeddings 的平均。

输出:

  • chunk nodes 从原本的 token occurrence 重新连接到对应 semantic nodes。
  • token node 保持为 lexical anchor,连接该 token 的所有 semantic nodes。
  • raw occurrence embeddings 可丢弃,只保留 semantic anchor embeddings 以节省内存。

5. Chunk-level context aggregation:弱上下文时增强 cluster separability

LiteSemRAG-fig3-context-aggregation

当单个 token occurrence 的上下文信息太弱时,polysemous token 的 embedding cluster 可能分不开。LiteSemRAG 在初始 clustering 不稳定时按 chunk 聚合。

设 $C_t$ 是包含 token $t$ 的 chunk 集合。对每个 chunk $c\in C_t$,计算 chunk-level embedding:

\tilde{e}_c=\frac{1}{|E_{t,c}|}\sum_{e_i\in E_{t,c}}e_i

其中 $E_{t,c}$ 是 token $t$ 在 chunk $c$ 中的 embeddings。

计算作用:

  • 降低同一 chunk 内 token occurrence 的噪声。
  • 放大 chunk 间语义差异。
  • 让 apple(company) / apple(fruit) 这类弱上下文场景更容易形成可分 clusters。

6. Adaptive anomaly handling:增量索引时处理新语义漂移

当新 embedding $e_{new}$ 到来,而 token $t$ 已有 semantic nodes $S(t)$ 时,先计算它和已有 semantic anchors 的最大相似度:

\max_{s\in S(t)} cos(e_{new},e_s)

若该值小于自适应阈值,则暂存进 anomaly set:

\max_{s\in S(t)} cos(e_{new},e_s)<\tau_{anomaly}

阈值不是全局固定,而是 token-specific percentile:

\tau_{anomaly}=\text{n-th percentile}(S_t)

当 anomaly set 超过预设大小后重新聚类:

  • 若出现新 cluster,则创建新的 semantic node。
  • 若没有新 cluster,则把 anomaly embeddings 分配到最近 semantic node。

输出:支持 incremental indexing 时的 semantic drift,不需要每次重建整个语义图。

7. Query-time multi-level semantic matching

查询阶段先对 query 做同样的 token extraction 和 token-level encoding。对每个 query token $t_q$ 和 embedding $e_q$,从 semantic nodes 中做三层匹配:

  1. Exact match:token node 与 $t_q$ 完全相同。
  2. Partial match:token node 包含 $t_q$ 子串。
  3. Similarity match:semantic node embedding 与 $e_q$ 余弦相似。

三层匹配有不同权重:

\alpha_{exact}>\alpha_{partial}>\alpha_{similarity}

对 exact / partial 匹配到的 token node $t$,只保留与 query token 最接近的 semantic node:

s^*(t)=\arg\max_{s\in S(t)}cos(e_q,e_s)

输出:query-specific candidate semantic nodes,兼顾 lexical precision 和 semantic recall。

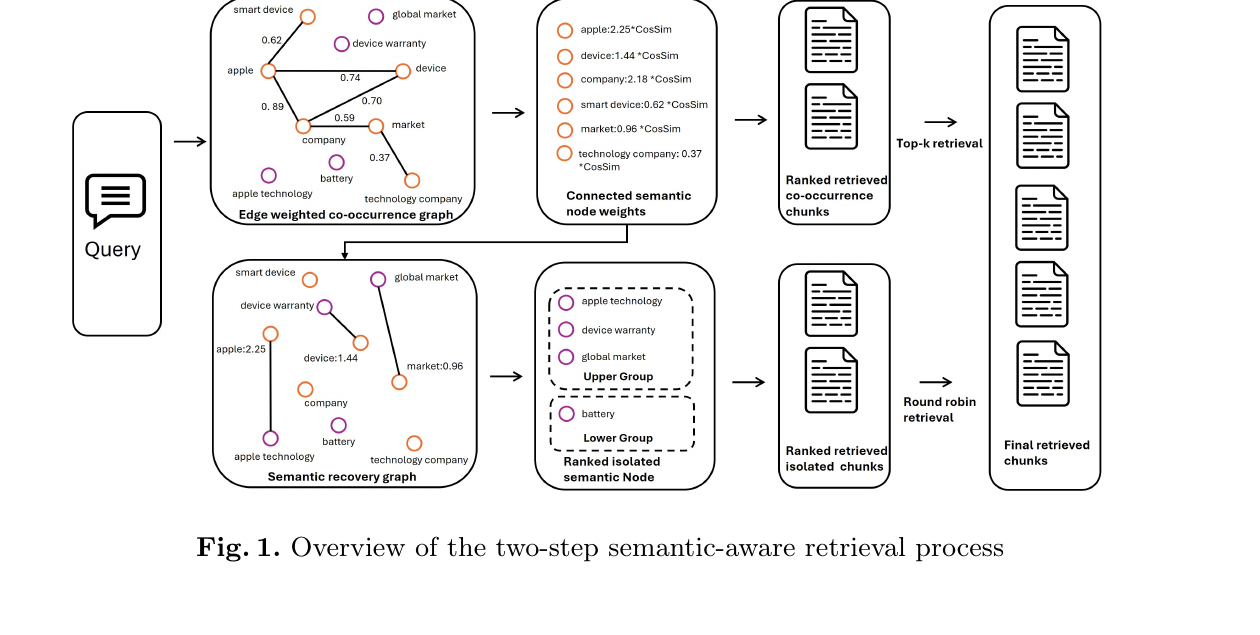
8. Co-occurrence graph semantic retrieval:结构支持的语义节点优先

LiteSemRAG-fig1-two-step-retrieval

对 query 匹配到的 semantic nodes,LiteSemRAG 构建 query-specific semantic co-occurrence graph。对 semantic nodes $i,j$,边权为:

w_{ij}=\frac{|C(i)\cap C(j)|}{\sqrt{|C(i)|\cdot |C(j)|}}

其中 $C(i)$ 是包含 semantic node $i$ 的 chunk 集合。这个 normalized co-occurrence 会压制全局高频语义,突出有意义的局部关联。

每个 semantic node $s$ 的权重:

W(s)=\left(\sum_{j\in N(s)}w_{sj}\right)\cdot \alpha_{level(s)}\cdot cos(e_q,e_s)

它同时融合三类信号:

  • co-occurrence graph structure;
  • lexical matching level;
  • query-semantic similarity。

9. Chunk scoring:BM25-style semantic-level ranking

对连接到 selected semantic nodes 的 chunks,使用 semantic-level BM25-style score:

Score(c)=\sum_{s\in S(c)}W(s)\cdot G(s)\cdot \frac{f(s,c)(k_1+1)} {f(s,c)+k_1\left(1-b+b\frac{|c|}{avgcl}\right)}

其中:

  • $S(c)$:chunk $c$ 中出现的 semantic nodes。
  • $W(s)$:semantic node 的 query-specific 权重。
  • $G(s)$:semantic node 的 chunk-level discriminative weight,类似 IDF。
  • $f(s,c)$:semantic node $s$ 在 chunk $c$ 中的频次。
  • $|c|$ 与 $avgcl$:chunk 长度与平均 chunk 长度。
  • $k_1,b$:BM25 term-frequency saturation 和 length normalization 超参数。

输出:co-occurrence graph semantic retrieval 的 ranked chunks。

10. Isolated semantic recovery:追回结构上孤立但语义相关的证据

co-occurrence graph 会偏向结构上互相支持的 semantic nodes,但有些 query-matched semantic nodes 可能没有显著共现边。LiteSemRAG 把这类节点作为 isolated semantic nodes。

如果 isolated semantic node $s$ 和 co-occurrence graph 中的若干 semantic nodes 共享同一 token family,则把这些节点的权重传播给它:

W_{prop}(s)=\sum_{s'_i\in M(s)}W(s'_i)

其中 $M(s)$ 是 co-occurrence graph 中与 $s$ 共享原始 token 的 semantic nodes。

再分两组排序:

  • Upper Group:收到 propagated co-occurrence weight,排序分数为
Score(s)=W_{prop}(s)\cdot cos(e_q,e_s)
  • Lower Group:没有收到传播权重,只按语义相似度
Score(s)=cos(e_q,e_s)

Upper Group 排在 Lower Group 前面。对每个 isolated semantic node,独立收集关联 chunks,并用同一个 BM25-style score 排序。最终用 round-robin 在 semantic nodes 之间选择 chunks,以提高语义多样性。

输出:作为 fallback 的 isolated recovery chunks。

11. Final retrieval:两阶段结果按比例合并

最终结果由两部分组成:

  • Co-occurrence Graph Semantic Retrieval:结构支持更强,优先级更高。
  • Isolated Semantic Recovery:补充结构稀疏或缺失时的语义覆盖。

论文说明用户定义的超参数控制两阶段结果比例;最终 ranking 中 co-occurrence graph retrieval 的 chunks 优先于 isolated recovery 的 chunks。

Results

1. Retrieval quality:MRR@10 三个数据集第一,Recall@10 两个数据集第一

LiteSemRAG-table1-retrieval-results

Table 1 比较 HotpotQA、SciFact、FEVER 上的 Recall@10 / MRR@10:

  • HotpotQA:LiteSemRAG Recall@10 73.5%、MRR@10 0.694,高于 LightRAG (GPT) 的 71.5% / 0.419。
  • SciFact:LiteSemRAG Recall@10 92.3%,低于 LightRAG (GPT) 的 95.2%,但 MRR@10 0.692 高于 LightRAG (GPT) 的 0.427。
  • FEVER:LiteSemRAG Recall@10 88.3%、MRR@10 0.806,均为最高。
  • GraphRAG 不提供显式 chunk ranking,因此论文不报告 GraphRAG 的 MRR@10。
  • GraphRAG (LLaMA) 在三个数据集上出现 ETL,即 Exceed maximum Token Limitation,无法完成比较。

解读:LiteSemRAG 的强项不是“召回所有证据一定最高”,而是“相关证据更早出现”。这对后续生成模型的上下文预算更有价值。

2. Efficiency / Tokens:索引、查询都零 LLM token

LiteSemRAG-table2-table3-efficiency-tokens

Table 2 和 Table 3 显示:

  • HotpotQA:LiteSemRAG AIT / AQT 为 0.24s / 0.11s;LightRAG (GPT) 为 7.98s / 0.58s;GraphRAG (GPT) 为 3.55s / 29.8s。
  • SciFact:LiteSemRAG AIT / AQT 为 0.69s / 0.13s;LightRAG (GPT) 为 10.31s / 1.57s;GraphRAG (GPT) 为 4.35s / 48.76s。
  • FEVER:LiteSemRAG AIT / AQT 为 0.47s / 0.09s;LightRAG (GPT) 为 7.71s / 1.45s;GraphRAG (GPT) 为 3.08s / 30.66s。
  • LLM token consumption:LiteSemRAG 的 ITC / QTC 在三个数据集上全为 0 / 0。

论文总结 LiteSemRAG 相比 LightRAG 约 20x 更快 indexing、10x 更快 querying;相比 GraphRAG 约 10x 更快 indexing、100x 更快 querying。这个结论来自该论文实验设置,应注意硬件和实现差异。

3. Ablation:两步 semantic-aware retrieval 是主要收益来源

LiteSemRAG-table4-ablation

Table 4 把标准 LiteSemRAG 与 “broad search + jina-reranker-v3 reranking” 对比,两者使用同一个 semantic index graph 和同一个 token-level encoder,只改变 query-time retrieval strategy。

  • HotpotQA:broad search 32.5% / 0.197 / 2.85s,two-step 73.5% / 0.694 / 0.24s。
  • SciFact:broad search 14.9% / 0.056 / 2.97s,two-step 92.3% / 0.692 / 0.69s。
  • FEVER:broad search 46.7% / 0.251 / 3.24s,two-step 88.3% / 0.806 / 0.47s。

解读:性能不是单纯来自 DeBERTa token-level encoder;co-occurrence graph weighting + isolated semantic recovery 的检索策略本身贡献很大。

Limitations

  • 只评估 retrieval,不评估最终 answer quality:论文明确把 LiteSemRAG 作为 retrieval framework,未比较把 retrieved chunks 输入 LLM 后的 EM/F1/Faithfulness。
  • Baseline 范围有限:主要对比 GraphRAG 和 LightRAG,没有覆盖 HippoRAG2、FastInsight、ContextRAG、NoLLMRAG 的完整统一实验。
  • 图推理能力仍较浅:当前只做 co-occurrence-aware ranking 和 isolated recovery,虽然图结构支持 multi-hop semantic expansion / constrained subgraph extraction / path-based scoring,但论文没有实现或评估这些扩展。
  • 依赖 token-level encoder 和 NLP preprocessing:完全无 LLM 不等于完全无模型,实际质量会受 token extraction、DeBERTa encoder、clustering threshold 和 HDBSCAN 稳定性影响。
  • 多义语义节点的可解释性有限:semantic nodes 来自 embedding clusters,不像 LLM-extracted relation / entity label 那样天然有人类可读标签。
  • 代码可复现状态需谨慎:正文未声明官方代码;同名 GitHub 仓库无 README,当前只能作为潜在线索。

Future Directions

  • 作者明确提到的扩展:
    • 在异构图上加入 deeper graph traversal strategies。
    • 支持 multi-hop semantic expansion。
    • 支持 constrained subgraph extraction。
    • 支持 path-based relevance scoring。
    • 在不使用 LLM graph construction 的前提下继续扩展 graph reasoning operations。
  • Agent 推断的研究机会:

与本知识库的连接

一句话定位

LiteSemRAG 的核心价值是证明 GraphRAG 检索不必总依赖 LLM:用 token-level contextual embeddings 诱导多义 semantic nodes,再用共现结构和孤立语义恢复做两步检索,可以在零 LLM token 的条件下取得强 MRR 和显著延迟优势。