研究问题与动机
-
研究问题:GraphRAG 通过图结构支持多层次推理和结构化证据聚合,但主流 GraphRAG / LightRAG 类系统在 indexing 和 querying 阶段经常调用 LLM 做实体抽取、摘要、图遍历或查询理解。
-
为什么重要:LLM-heavy GraphRAG 的离线 token 消耗、查询延迟、模型依赖和上下文长度问题,会限制大规模语料、频繁更新知识库、本地部署和低成本场景。
-
现有路线:
- GraphRAG / LightRAG:用 LLM 构建或查询图结构,效果强但有 token 和延迟成本。
- NoLLMRAG:尝试去掉 LLM,但主要依赖 surface-level lexical / static statistical structures,缺少显式上下文语义建模。
- ContextRAG - Extraction-Free Hierarchical Graph Construction:不依赖 LLM 抽取实体关系,但仍在 query-time 使用 LLM rewrite / rerank / answer generation。
-
对本知识库的意义:LiteSemRAG 把“低成本图检索”推进到更极端的 regime:索引和查询检索本身都不调用 LLM,只用 token-level contextual embeddings 构建语义图。
-
LLM 依赖成本高:GraphRAG / LightRAG 在 indexing 和 querying 中调用 LLM,会引入 token cost、latency variability 和模型敏感性。
-
低成本路线语义不足:NoLLMRAG 虽然去掉 LLM,但缺少 contextual semantic modeling,只靠表层词和统计结构,难处理多义词和复杂多跳检索。
-
flat chunk retrieval 不够:普通 dense / sparse chunk retrieval 不显式表达 document structure、semantic variation 和 multi-hop evidence dependency。
-
图结构和语义覆盖难兼顾:只看 co-occurrence graph 会漏掉结构上孤立但语义相关的证据;只做 broad semantic search 又会引入大量噪声和 reranking 成本。
方法与机制
1. 输入:文档集合 -> chunks -> token-level contextual embeddings
输入是文档集合。LiteSemRAG 先把每篇文档切成 chunks,再用 NLP tools 抽取重要 textual elements,包括 entities、phrases 和 tokens。每个元素用 token-level text encoder 编码为 contextual semantic embedding。
论文实验中:
- GraphRAG / LightRAG 使用
text-embedding-3-small作为 sentence-level embedding encoder。 - LiteSemRAG 使用
deberta-v3-large,因为它需要 token-level contextual embeddings。
输出:每个 token occurrence 的上下文向量,后续用于构建 semantic nodes。
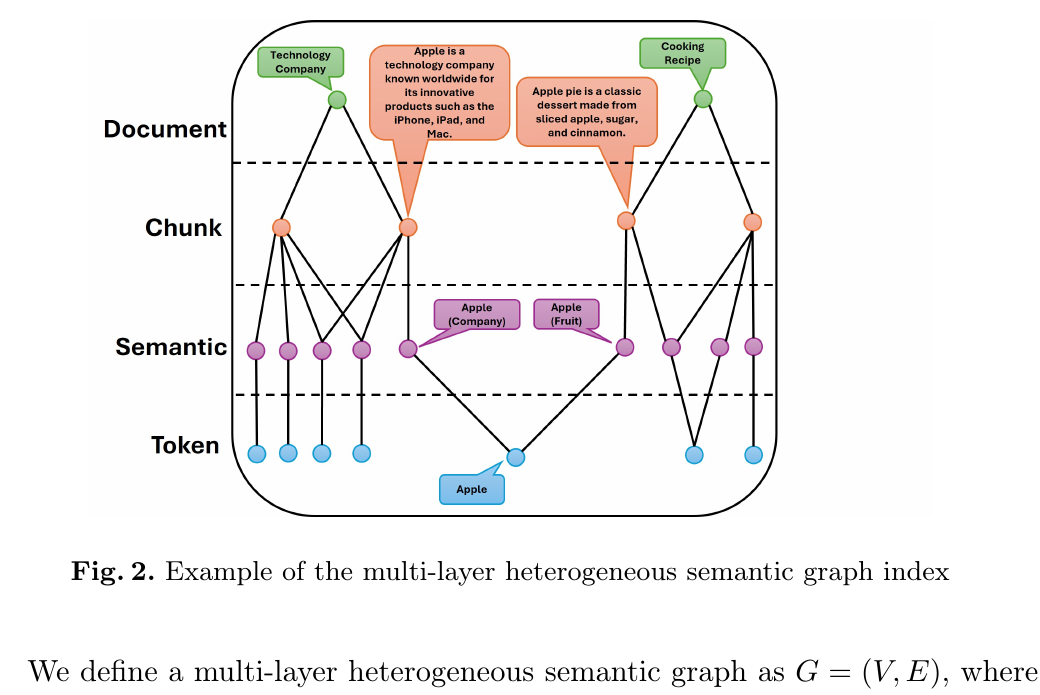
2. 构建四层异构语义图
LiteSemRAG 定义多层异构语义图:
节点集合:
- $D$:document nodes。
- $C$:chunk nodes。
- $S$:semantic nodes,每个节点表示某个 token 的一个上下文语义。
- $T$:token nodes,每个节点表示 surface textual element。
边集合包含三类双向边:
- Document-Chunk:chunk 属于哪个 document。
- Chunk-Semantic:某个 semantic meaning 出现在 chunk 中。
- Semantic-Token:semantic node 连接回 surface token。
输出:一个把表层词形和上下文语义分离的 graph index。
3. 动态语义节点构建:用分布离散度判断是否拆分多义 token
对每个 token $t$,收集其所有 normalized contextual semantic embeddings:
先计算平均方向:
再计算 embedding concentration / dispersion score:
计算含义:
- $S\text{-}mean$ 高:token 的上下文语义集中,倾向单义。
- $S\text{-}mean$ 低:embedding 分布可能有多个 clusters,倾向多义。
LiteSemRAG 只在以下条件满足时对 token 做 clustering-based semantic induction:
这样避免把高频、低信息量 token 过度切分。
4. Clustering-based semantic induction:为不同上下文语义创建 semantic nodes
若 token 被判定可能多义,LiteSemRAG 对 $E_t$ 做 density-based clustering,例如 HDBSCAN。每个 cluster $C_k\subset E_t$ 对应一个 semantic node,其 anchor embedding 为:
若 token 被判定为单义,或者 clustering 没有产生多个稳定 cluster,则只创建一个 semantic node,其 anchor embedding 是该 token 所有 contextual embeddings 的平均。
输出:
- chunk nodes 从原本的 token occurrence 重新连接到对应 semantic nodes。
- token node 保持为 lexical anchor,连接该 token 的所有 semantic nodes。
- raw occurrence embeddings 可丢弃,只保留 semantic anchor embeddings 以节省内存。
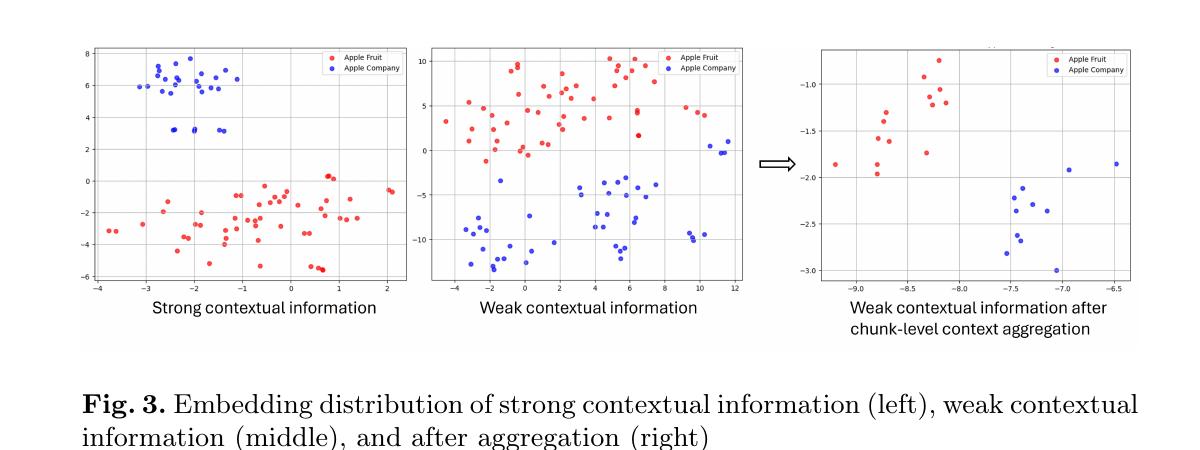
5. Chunk-level context aggregation:弱上下文时增强 cluster separability
当单个 token occurrence 的上下文信息太弱时,polysemous token 的 embedding cluster 可能分不开。LiteSemRAG 在初始 clustering 不稳定时按 chunk 聚合。
设 $C_t$ 是包含 token $t$ 的 chunk 集合。对每个 chunk $c\in C_t$,计算 chunk-level embedding:
其中 $E_{t,c}$ 是 token $t$ 在 chunk $c$ 中的 embeddings。
计算作用:
- 降低同一 chunk 内 token occurrence 的噪声。
- 放大 chunk 间语义差异。
- 让 apple(company) / apple(fruit) 这类弱上下文场景更容易形成可分 clusters。
6. Adaptive anomaly handling:增量索引时处理新语义漂移
原始笔记摘录已截断;请打开来源笔记阅读完整内容。
证据与结果
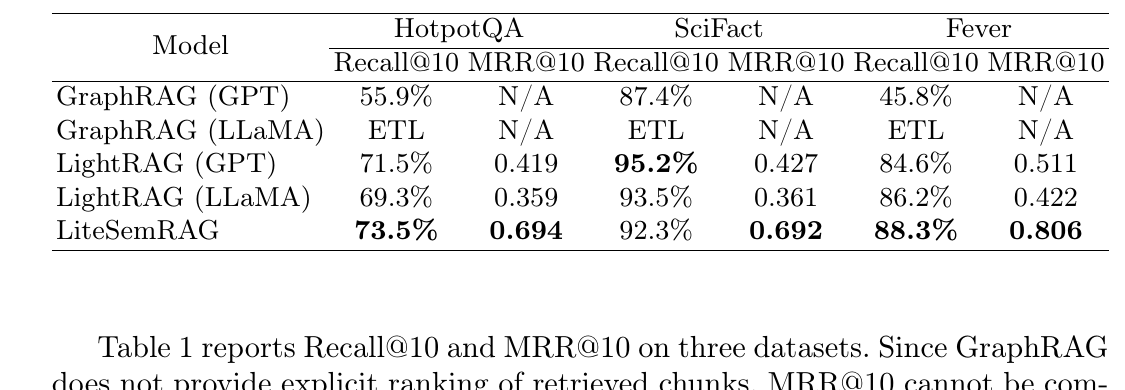
1. Retrieval quality:MRR@10 三个数据集第一,Recall@10 两个数据集第一
Table 1 比较 HotpotQA、SciFact、FEVER 上的 Recall@10 / MRR@10:
- HotpotQA:LiteSemRAG Recall@10
73.5%、MRR@100.694,高于 LightRAG (GPT) 的71.5% / 0.419。 - SciFact:LiteSemRAG Recall@10
92.3%,低于 LightRAG (GPT) 的95.2%,但 MRR@100.692高于 LightRAG (GPT) 的0.427。 - FEVER:LiteSemRAG Recall@10
88.3%、MRR@100.806,均为最高。 - GraphRAG 不提供显式 chunk ranking,因此论文不报告 GraphRAG 的 MRR@10。
- GraphRAG (LLaMA) 在三个数据集上出现 ETL,即 Exceed maximum Token Limitation,无法完成比较。
解读:LiteSemRAG 的强项不是“召回所有证据一定最高”,而是“相关证据更早出现”。这对后续生成模型的上下文预算更有价值。
2. Efficiency / Tokens:索引、查询都零 LLM token
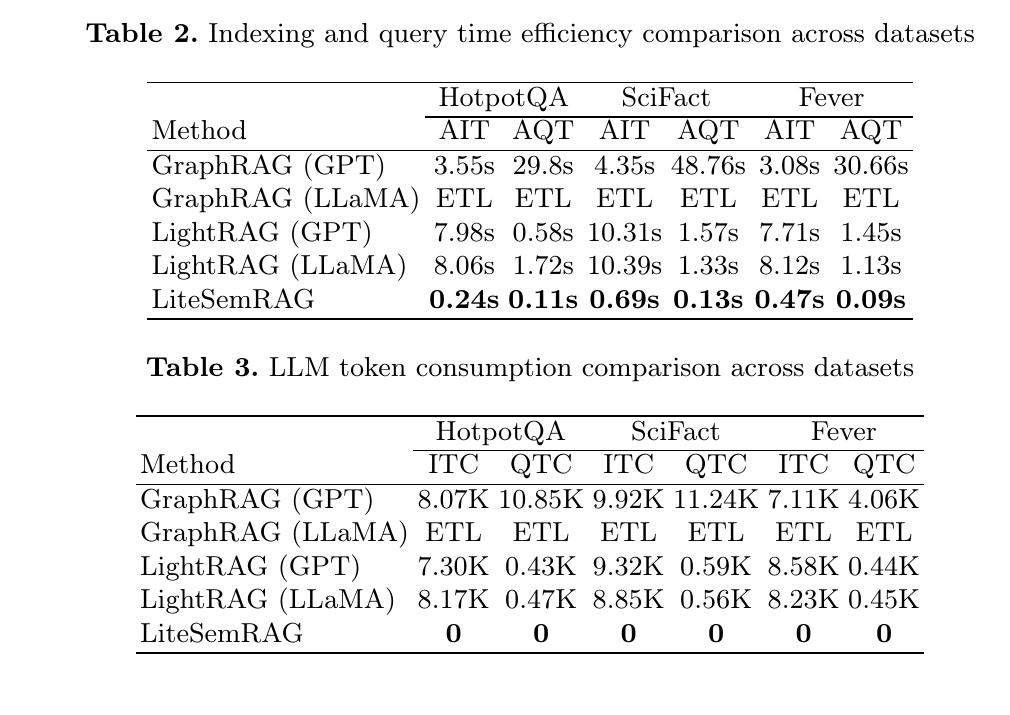
Table 2 和 Table 3 显示:
- HotpotQA:LiteSemRAG AIT / AQT 为
0.24s / 0.11s;LightRAG (GPT) 为7.98s / 0.58s;GraphRAG (GPT) 为3.55s / 29.8s。 - SciFact:LiteSemRAG AIT / AQT 为
0.69s / 0.13s;LightRAG (GPT) 为10.31s / 1.57s;GraphRAG (GPT) 为4.35s / 48.76s。 - FEVER:LiteSemRAG AIT / AQT 为
0.47s / 0.09s;LightRAG (GPT) 为7.71s / 1.45s;GraphRAG (GPT) 为3.08s / 30.66s。 - LLM token consumption:LiteSemRAG 的 ITC / QTC 在三个数据集上全为
0 / 0。
论文总结 LiteSemRAG 相比 LightRAG 约 20x 更快 indexing、10x 更快 querying;相比 GraphRAG 约 10x 更快 indexing、100x 更快 querying。这个结论来自该论文实验设置,应注意硬件和实现差异。
3. Ablation:两步 semantic-aware retrieval 是主要收益来源
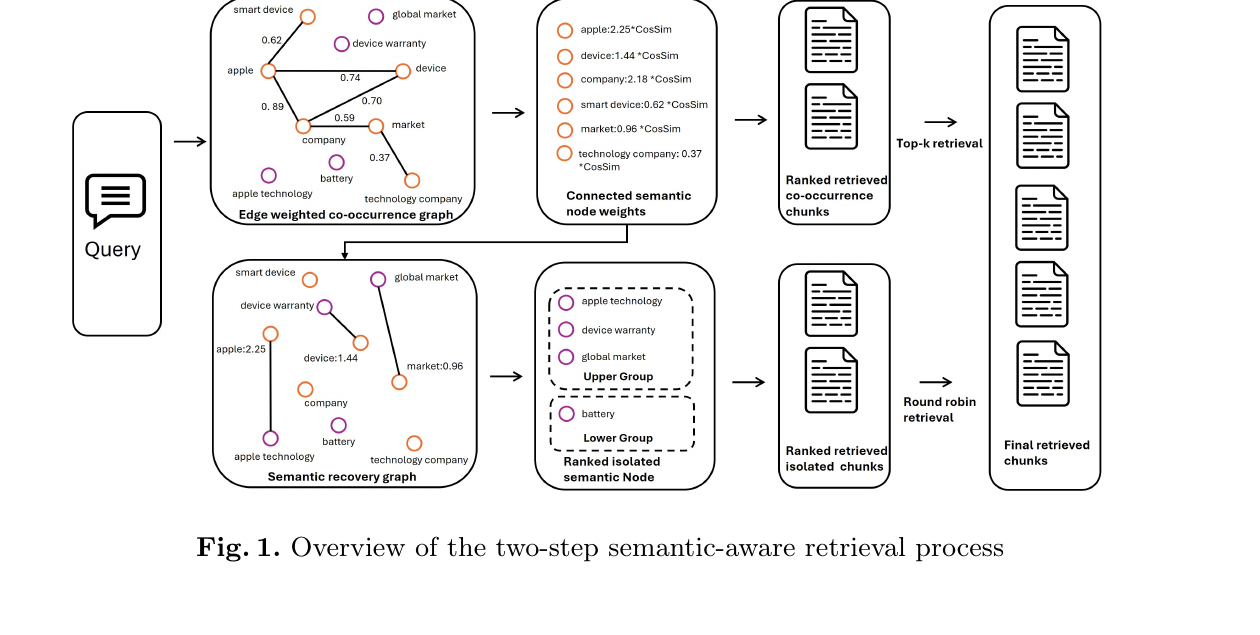
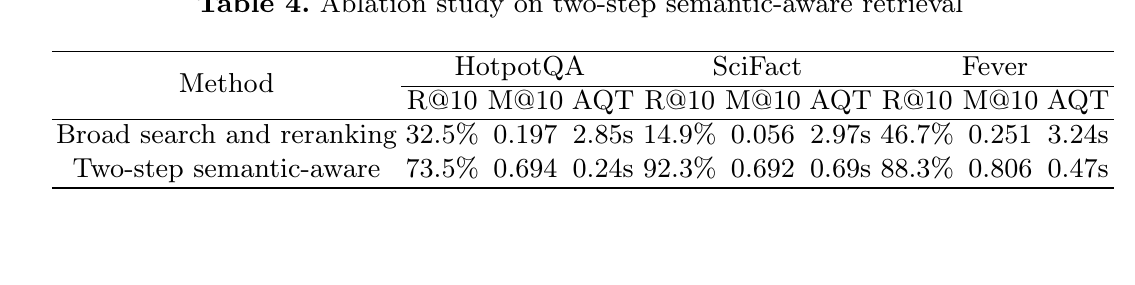
Table 4 把标准 LiteSemRAG 与 “broad search + jina-reranker-v3 reranking” 对比,两者使用同一个 semantic index graph 和同一个 token-level encoder,只改变 query-time retrieval strategy。
- HotpotQA:broad search
32.5% / 0.197 / 2.85s,two-step73.5% / 0.694 / 0.24s。 - SciFact:broad search
14.9% / 0.056 / 2.97s,two-step92.3% / 0.692 / 0.69s。 - FEVER:broad search
46.7% / 0.251 / 3.24s,two-step88.3% / 0.806 / 0.47s。
解读:性能不是单纯来自 DeBERTa token-level encoder;co-occurrence graph weighting + isolated semantic recovery 的检索策略本身贡献很大。
局限与开放问题
-
只评估 retrieval,不评估最终 answer quality:论文明确把 LiteSemRAG 作为 retrieval framework,未比较把 retrieved chunks 输入 LLM 后的 EM/F1/Faithfulness。
-
Baseline 范围有限:主要对比 GraphRAG 和 LightRAG,没有覆盖 HippoRAG2、FastInsight、ContextRAG、NoLLMRAG 的完整统一实验。
-
图推理能力仍较浅:当前只做 co-occurrence-aware ranking 和 isolated recovery,虽然图结构支持 multi-hop semantic expansion / constrained subgraph extraction / path-based scoring,但论文没有实现或评估这些扩展。
-
依赖 token-level encoder 和 NLP preprocessing:完全无 LLM 不等于完全无模型,实际质量会受 token extraction、DeBERTa encoder、clustering threshold 和 HDBSCAN 稳定性影响。
-
多义语义节点的可解释性有限:semantic nodes 来自 embedding clusters,不像 LLM-extracted relation / entity label 那样天然有人类可读标签。
-
代码可复现状态需谨慎:正文未声明官方代码;同名 GitHub 仓库无 README,当前只能作为潜在线索。
-
作者明确提到的扩展:
- 在异构图上加入 deeper graph traversal strategies。
- 支持 multi-hop semantic expansion。
- 支持 constrained subgraph extraction。
- 支持 path-based relevance scoring。
- 在不使用 LLM graph construction 的前提下继续扩展 graph reasoning operations。
-
Agent 推断的研究机会:
- 与 FastInsight - Fast and Insightful Retrieval via Fusion Operators for Graph RAG 结合:把 LiteSemRAG 的 semantic graph 作为 corpus graph,再用 GRanker / STeX 做低延迟 operator fusion。
- 与 ContextRAG - Extraction-Free Hierarchical Graph Construction 对照:比较 embedding-cluster fuzzy graph 与 token-level semantic graph 在低成本 regime 下的图结构强度。
- 与 QO-Bench - Query-Operator-Preserving Retrieval over Typed Event Tuples 对齐:检验无 LLM semantic graph 是否能保留 join / intersection / aggregation 这类 query operators。
- 加入 answer-stage evaluation:在 HotpotQA / FEVER / SciFact 上固定 generator,比较 retrieved chunks 是否真正提升 final answer faithfulness。
- 做 semantic-node interpretability:为 embedding-induced semantic nodes 生成轻量标签或 exemplar chunks,降低不可解释风险。
- 研究 incremental indexing drift:系统记录 anomaly set、new semantic node creation、cluster split / merge 对 retrieval quality 的影响。
关联与拓展
- ContextRAG - Extraction-Free Hierarchical Graph Construction:两者都挑战 LLM extraction-heavy GraphRAG;ContextRAG 低索引成本但 query-time 仍用 LLM,LiteSemRAG 检索阶段完全无 LLM。
- FastInsight - Fast and Insightful Retrieval via Fusion Operators for Graph RAG:FastInsight 是 graph retrieval operator fusion;LiteSemRAG 是 LLM-free semantic graph index + two-step retrieval,二者可组合成低延迟图检索 pipeline。
- GraphRAG on Consumer Hardware - Local LLMs for Healthcare EHR Schema Retrieval:LiteSemRAG 可作为本地部署 / 低算力 GraphRAG 的候选 retriever,但需要补最终答案和领域 schema 评测。
- Rethinking Agentic RAG - LLM-Driven Logical Retrieval Beyond Embeddings:Rethinking Agentic RAG 用低成本 lexical logical retrieval 替代 embedding-heavy / graph-heavy 路线;LiteSemRAG 则保留 embedding semantic graph,但去掉 LLM。
- GraphRAG中的图结构强度、构建成本与收益边界:LiteSemRAG 是“低构建成本 + 中等结构强度”的新证据。
- GraphRAG中的Query-Complexity与结构选择:可加入
needs_llm_free_semantic_graph/needs_low_latency_semantic_recovery作为 query routing 标签。
研究问题入口
Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略, Q6 证据来源与可解释性