GGraphRAG 文献图谱自动同步
LIT-76FFA0A8 · 2026

A2RAG - Adaptive Agentic Graph Retrieval

A2RAG 把 GraphRAG 检索改造成“先轻量、再桥接、最后全局扩散”的渐进式 agent,并用 answer-level Triple-Check 决定是否重写和重试。

PDF 级阅读卡优先级 P1Jiate Liu, Zebin Chen, Shaobo Qiao, Mingchen Ju, Danting Zhang, Bocheng Han, Shuyue Yu, Xin Shu, Jinglin Wu, Dong Wen, Xin Cao, Guanfeng Liu, Zhengyi Yang发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:GraphRAG 在多跳问答中能利用图结构组织证据,但真实 workload 通常混合了 easy query 和 hard multi-hop query。所有问题都走复杂图检索会浪费 token 和 latency;所有问题都走轻量检索又会漏掉 hard-tail 证据链。

  • 为什么重要:这直接对应 GraphRAG中的停止准则与预算分配形式化:系统需要判断“当前证据是否足够、是否值得继续扩展、是否应升级检索策略”。

  • 现有方法:

    • TextRAG / iterative retrieval 通过多轮文本检索补多跳证据,但容易重复调用 LLM、上下文膨胀、成本升高。
    • LightRAG 这类 local graph retrieval 成本低,但在需要非局部桥接节点时可能召回不足。
    • 全局 GraphRAG 覆盖更强,但构建和刷新成本高,不适合所有 query。
  • One-size-fits-all retrieval:固定检索策略无法适配 query 难度差异,导致 easy query 过度检索、hard query 检索不足。

  • Extraction loss:KG 抽取常保留 coarse relation,却丢掉数值、时间、条件、例外等细粒度 qualifier。图结构看似连通,但答案需要的精确信息仍在原文 provenance text 中。

  • 现有 adaptive retrieval 多偏 text-centric,缺少 graph-native escalation operator,例如 local neighborhood、bridge discovery、PPR fallback 之间的渐进式切换。

  • 缺少把 answer-level verification 和 retrieval-level escalation 分开的清晰架构。

方法与机制

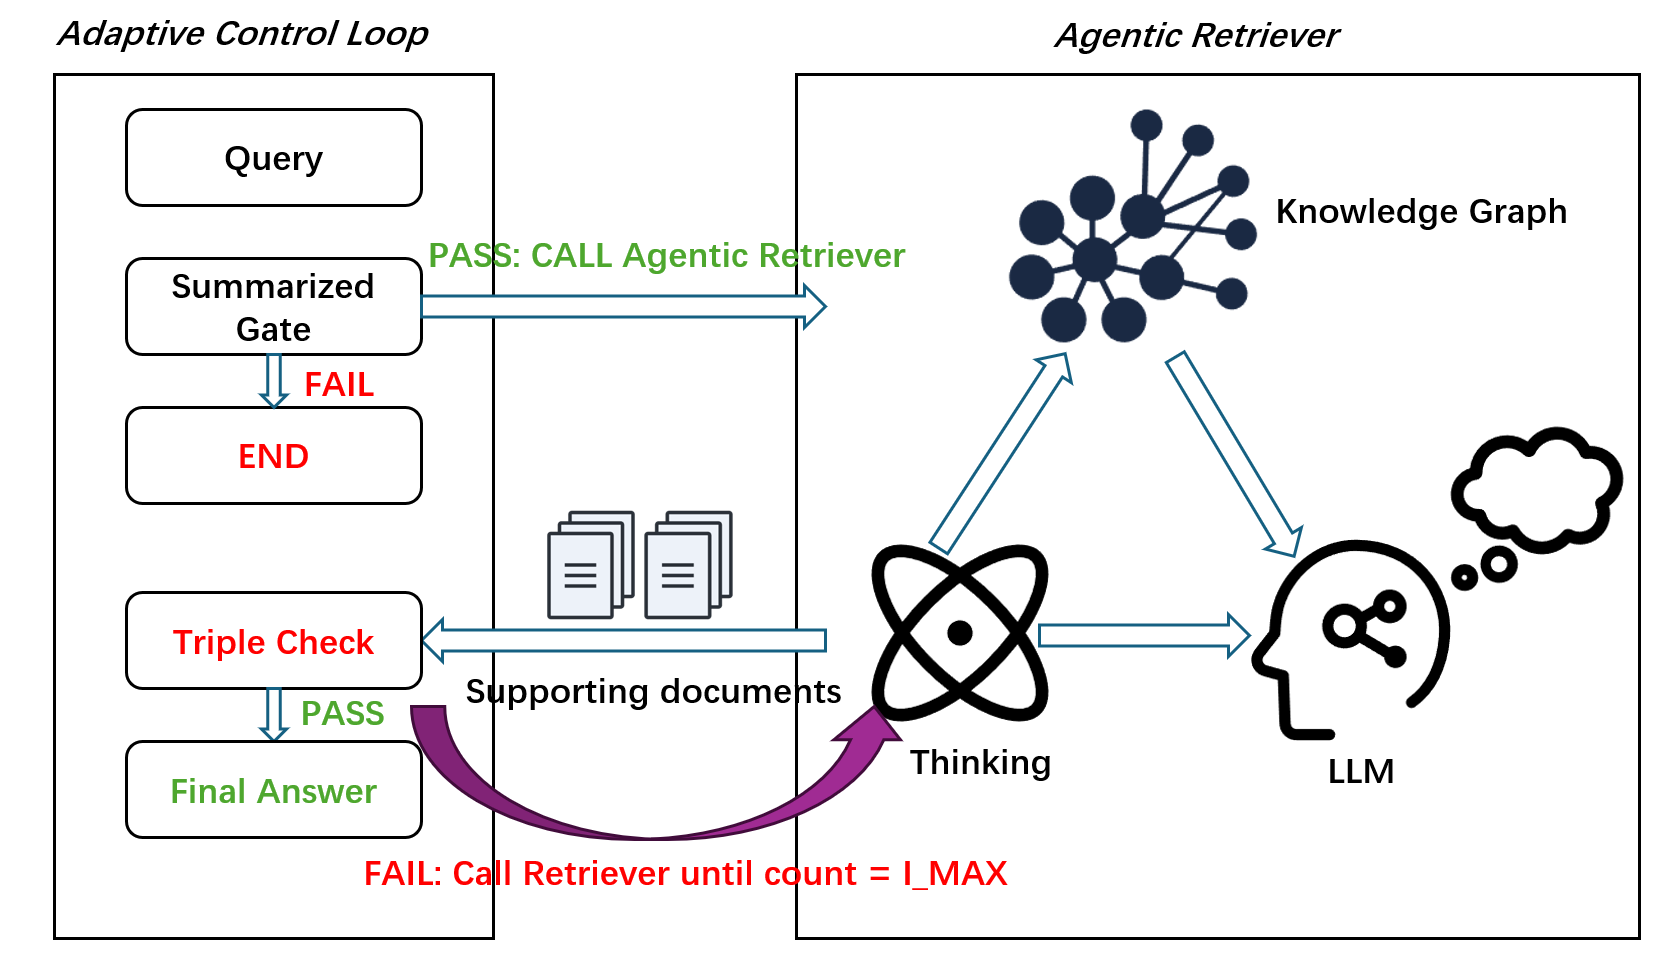
  • 整体框架:Two-layer architecture。
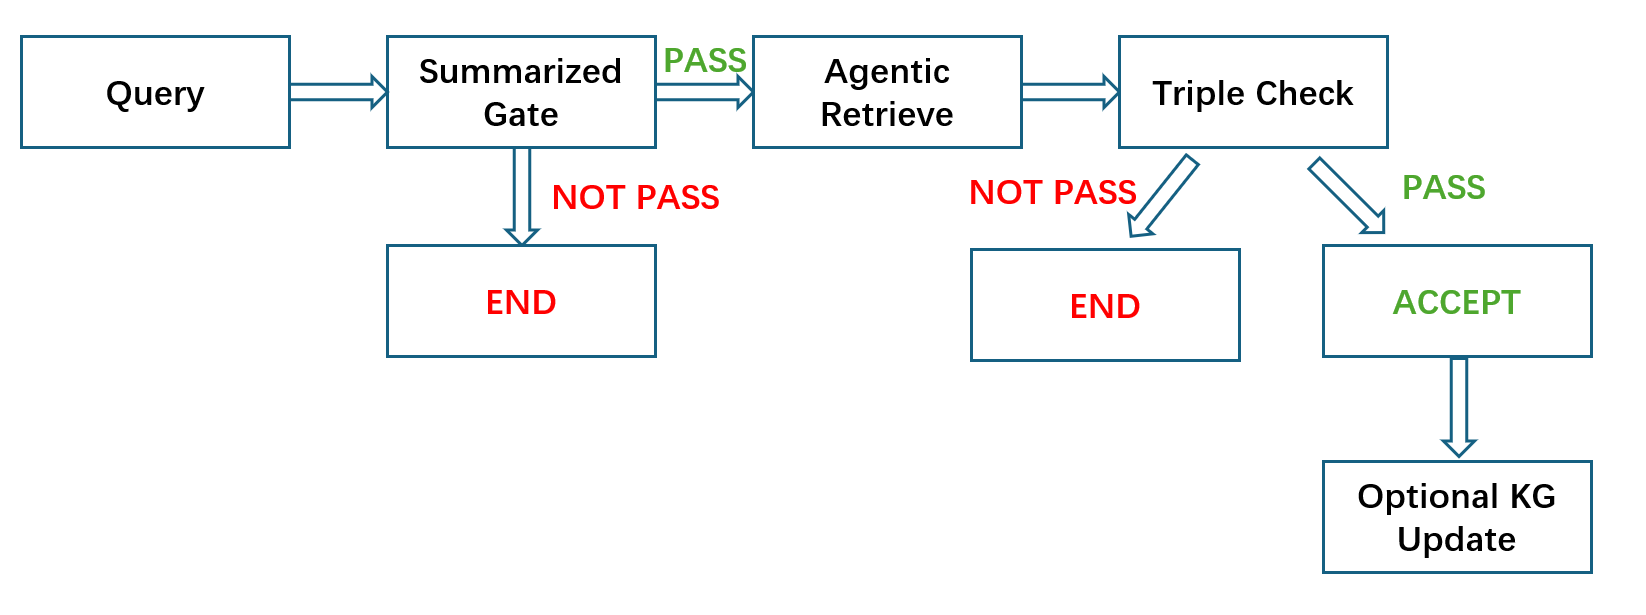
    • Adaptive Control Loop:负责入库 gate、生成候选答案、Triple-Check 验证、failure-aware rewrite、bounded retry。
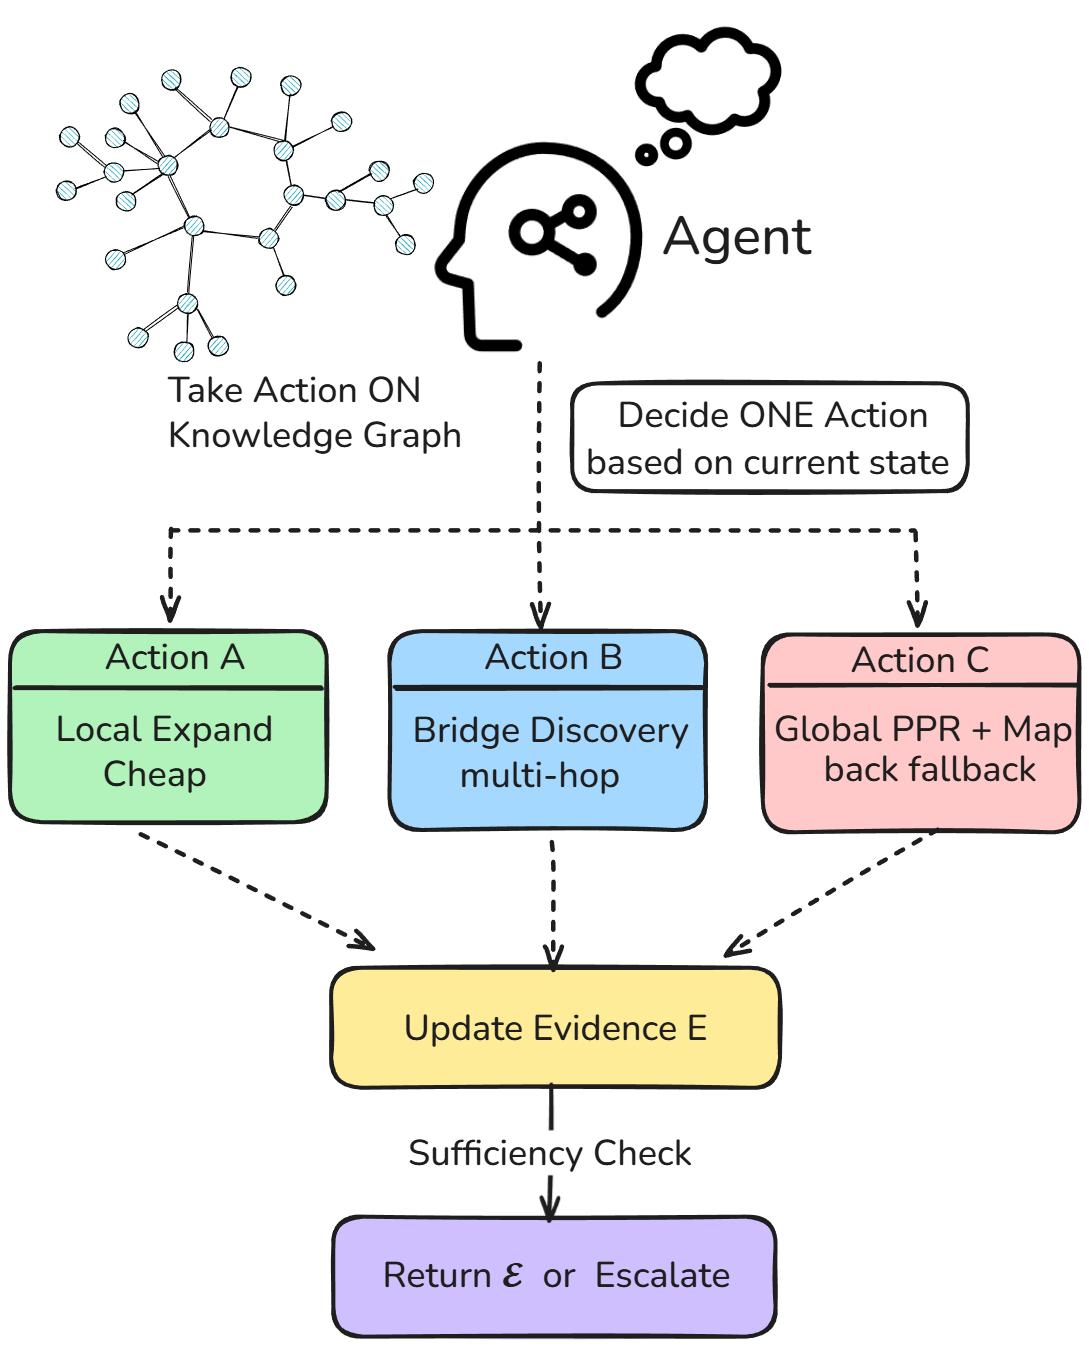
    • Agentic Retriever:负责图检索执行,按 Local -> Bridge -> Global PPR 的顺序逐级升级,并把图节点回映射到原文 chunks。

Figure 1 展示整体架构:controller 不直接指定每一步图操作,而是把 query state 交给 retriever;retriever 返回 evidence 后,controller 再生成答案并验证。如果验证失败,controller 根据失败类型重写 query,在预算内重新调用 retriever。这种分工把“答案是否可靠”和“检索如何升级”分开。

  • Adaptive Control Loop:
    • Entry gate:先用 corpus summary 和 query 做相似度门控。
\mathrm{Gate}(q)=\mathbb{1}\left\{\max_{1\le j\le N}\gamma_j(q)\ge \tau_g\right\}
  • Triple-Check:候选答案必须同时满足 evidence relevance、answer grounding、query resolution。
\mathrm{TripleCheck}(q,a,E)=V_{rel}(q,E)\wedge V_{grd}(a,E)\wedge V_{ans}(q,a)
  • Failure-aware rewrite:若 relevance、grounding 或 adequacy 任一失败,就按失败类型重写 query。
q^{(i+1)}=\mathrm{Rewrite}(q^{(i)},a^{(i)},E^{(i)},type^{(i)})
  • Bounded retry:最多重试 Imax 次,超过预算返回 FAIL / ABSTAIN。

  • Agentic Retriever:

    • State:<q, S_V, S_R, E>,其中 S_V 是 entity seeds,S_R 是 relation seeds,E 是累计证据。
    • Stage 1 Local Evidence Collection:从 query entities 对齐到 KG 节点,取 1-hop neighborhood;如果 relation seeds 可用,只保留与关系意图一致的边。
N_1(v)=\{u\in V\mid (v,r,u)\in E_G\ \mathrm{or}\ (u,r,v)\in E_G,\exists r\in R\}
  • Stage 2 Bridge Discovery:当局部邻域不能连接多个 query seeds 时,找能同时连接多个 seeds 的 compact bridge nodes。
B_K=\{u\in V\mid |\{v\in S_V:u\in N_K(v)\}|\ge 2\}
  • Stage 3 Global Fallback:若 local / bridge 都不足,做 degree-normalized Personalized PageRank,再用 π: V -> 2^D 把 top nodes 映射回 provenance text chunks。
r=\alpha p_0+(1-\alpha)P^\top r
E=\bigcup_{u\in V_{top-L}}\pi(u)\subseteq D
  • 推理流程:
    1. Query 先通过 summarized-KB gating 判断是否属于当前 corpus。
    2. 若需要检索,进入 agentic retriever。
    3. Retriever 先尝试 local 1-hop,再尝试 K-hop bridge,最后才用 PPR fallback。
    4. PPR 阶段不直接把图三元组作为最终答案依据,而是把高分节点回映射到原文 chunks。
    5. Controller 用 evidence 生成答案,并用 Triple-Check 验证。
    6. 若失败,按失败类型重写 query,并在 bounded retry 内重新检索。

证据与结果

主结果

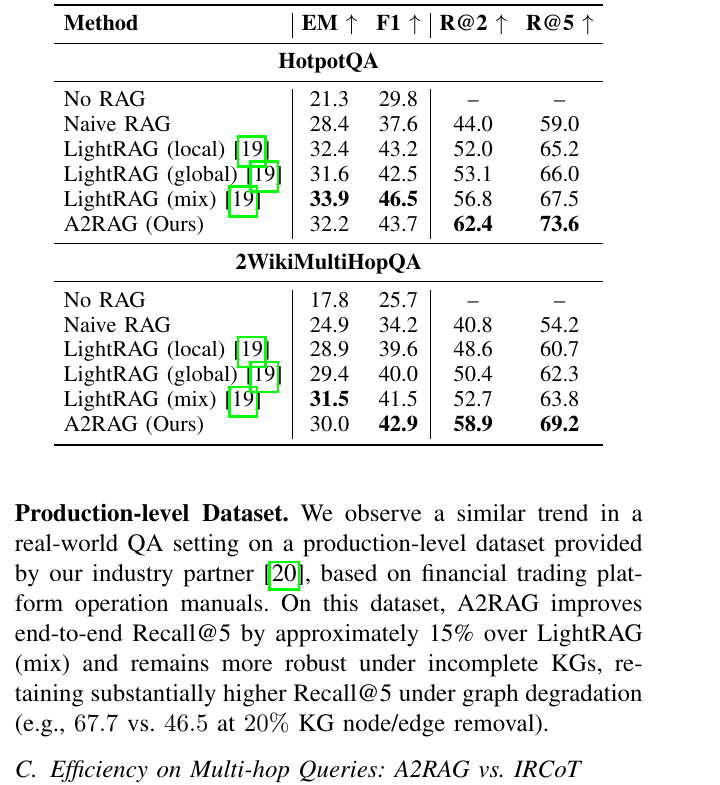
  • HotpotQA:A2RAG 的 R@2 / R@5 为 62.4 / 73.6,高于 LightRAG mix 的 56.8 / 67.5;但 EM / F1 为 32.2 / 43.7,低于 LightRAG mix 的 33.9 / 46.5。
  • 2WikiMultiHopQA:A2RAG 的 R@2 / R@5 为 58.9 / 69.2,高于 LightRAG mix 的 52.7 / 63.8;F1 为 42.9,高于 LightRAG mix 的 41.5,但 EM 低于 LightRAG mix。
  • 生产级数据:论文报告在金融交易平台操作手册 QA 上,A2RAG 相对 LightRAG mix 的 end-to-end Recall@5 约提升 15%;在 20% KG node / edge removal 下保持 67.7 vs 46.5 的 Recall@5。
  • 解读:A2RAG 的优势更明确体现在 evidence recall,答案 EM/F1 并非全面领先。这说明它更像“高召回、低成本、强 provenance 控制”的检索控制器,而不是单纯追求最终答案分数的生成增强方法。

成本与延迟

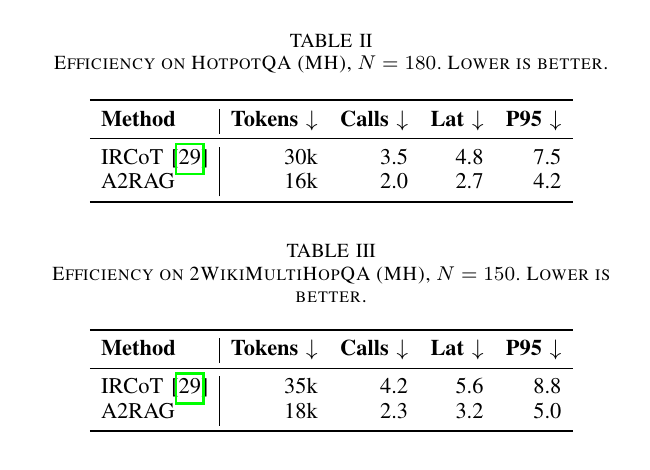
  • HotpotQA multi-hop subset:相对 IRCoT,tokens 从 30k 降到 16k,LLM calls 从 3.5 降到 2.0,平均 latency 从 4.8s 降到 2.7s。
  • 2WikiMultiHopQA multi-hop subset:tokens 从 35k 降到 18k,LLM calls 从 4.2 降到 2.3,平均 latency 从 5.6s 降到 3.2s。
  • 解读:成本下降来自“多数 query 不触发全局 fallback”,而不是模型更小或证据预算不公平。

阶段分布

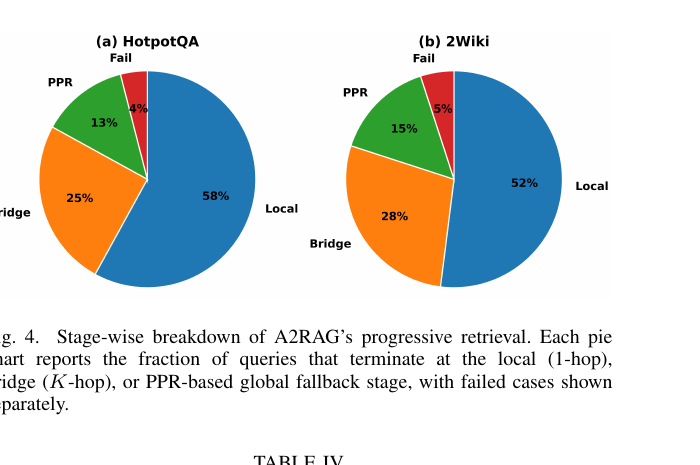
  • HotpotQA:58% query 在 local 1-hop 结束,25% 到 bridge stage,13% 触发 PPR,4% fail。
  • 2WikiMultiHopQA:52% query 在 local 1-hop 结束,28% 到 bridge stage,15% 触发 PPR,5% fail。
  • 解读:这张图是 A2RAG 最重要的机制证据。它把 GraphRAG中的停止准则与预算分配形式化 里的“边际收益低于成本就停止”落成了可观测行为:只有少数 hard cases 消耗 PPR / retry 预算。

Relation seed ablation

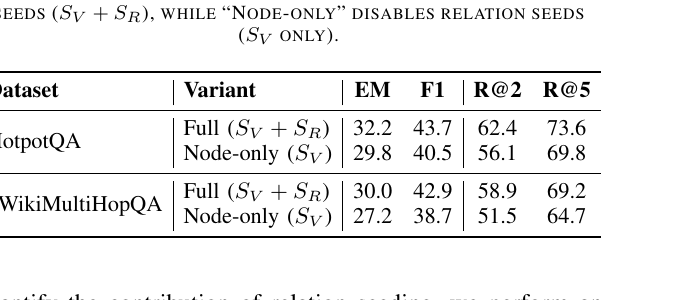
  • 去掉 relation seeds 后,HotpotQA R@2 从 62.4 降到 56.1,2Wiki R@2 从 58.9 降到 51.5。
  • 小 K 下下降更明显,说明 relation intent 能让 local retrieval 和 bridge discovery 更早聚焦到正确关系,而不是扩大上下文碰运气。
  • 这与 GraphRAG中的Bridge Evidence 为什么关键 一致:多跳检索的瓶颈经常不是局部事实没有命中,而是桥接关系方向不对。

Extraction loss robustness

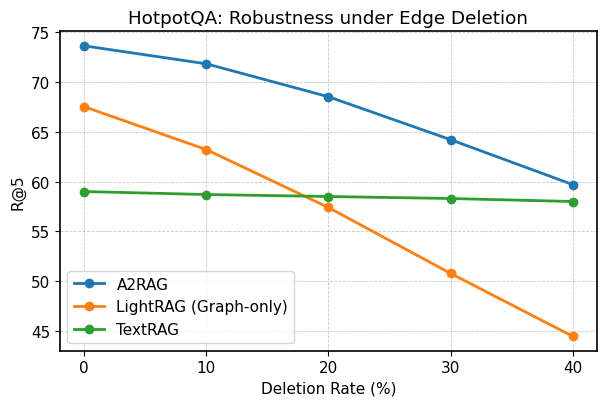
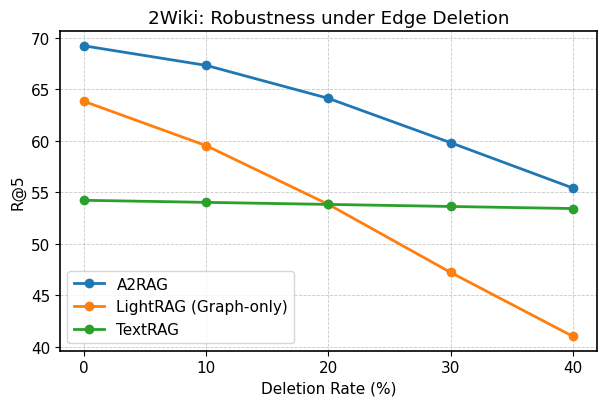
  • 在随机删除 KG node / edge 的 stress test 下,A2RAG 比 graph-only LightRAG 退化更慢。
  • HotpotQA:LightRAG R@5 从 67.5 降到 44.5,A2RAG 从 73.6 降到 59.7。
  • 2WikiMultiHopQA:LightRAG R@5 从 63.8 降到 41.0,A2RAG 从 69.2 降到 55.4。
  • 解读:PPR map-back 的价值不是“图一定完整”,而是图即便不完整,仍可作为结构导航信号定位高价值原文区域。这一点可连接 GraphRAG中的Personalized-PageRank 和 GraphRAG的鲁棒性框架。

局限与开放问题

  • 实验规模有限:HotpotQA 和 2WikiMultiHopQA 都是抽样子集,不是 full benchmark。

  • 最终 EM/F1 不总是最优:A2RAG 的强项是 small-K evidence recall 和成本效率,不能简单写成全面 SOTA。

  • 依赖 seed quality:entity seeds 和 relation seeds 抽错,会导致 local expansion 和 bridge discovery 方向偏移。

  • 仍需要最低限度的 graph backbone:如果图极度稀疏或严重碎片化,A2RAG 会逐渐退化到接近 text-only retrieval。

  • 生产级金融数据不是公开 benchmark,难以独立复核。

  • Triple-Check validator 可以用 NLI 或 LLM binary classifier 实现,但论文没有充分展开校准、judge 偏差和 false accept / false reject 的影响。

  • 未见公开代码,复现成本较高。

  • 作者 Future Work:

    • 在更大规模、更丰富语料上验证泛化性。
    • 提升 robust and domain-adaptive seed extraction。
    • 研究持续更新知识库下的 graph maintenance、drift 和 partial degradation。
  • Agent 推断的 Research Opportunities:

    • 把 A2RAG 的 Local -> Bridge -> PPR escalation 改成可学习 policy,学习何时升级、何时停止。
    • 将 Triple-Check 拆成可标注的训练信号:evidence relevance、answer grounding、answer adequacy。
    • 在当前 GraphRAG 检索实验中记录 stage termination:local hit、bridge hit、PPR fallback、failure,做失败归因。
    • 把 relation seed ablation 转成诊断指标:如果 relation seed 缺失导致 R@2 明显下降,说明 query 的关系意图没有被检索器捕捉。
    • 对比 A2RAG 和 BubbleRAG:前者强调渐进式检索升级,后者强调证据子图目标优化;二者可以统一到“有限预算下的 evidence utility 最大化”。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略
展开原始论文笔记全文

基本信息

  • 英文标题:A2RAG: Adaptive Agentic Graph Retrieval for Cost-Aware and Reliable Reasoning
  • 中文标题:面向成本感知与可靠推理的自适应 Agentic 图检索
  • 作者:Jiate Liu, Zebin Chen, Shaobo Qiao, Mingchen Ju, Danting Zhang, Bocheng Han, Shuyue Yu, Xin Shu, Jinglin Wu, Dong Wen, Xin Cao, Guanfeng Liu, Zhengyi Yang
  • 机构:University of New South Wales, Euler AI, Sigma Trading Management, Eigenflow AI, Macquarie University
  • 年份:2026
  • 版本:arXiv v2,2026-06-04
  • 会议 / 备注:KDExLLM @ ICDE 2026 Workshop oral;RAIDS Lab 页面标注 Best Paper Award
  • 链接:arXiv;RAIDS Lab
  • PDF:查看论文原文
  • 代码链接:未见公开代码入口
  • 阅读状态:PDF级
  • 所属方向:成本感知 GraphRAG、Agentic retrieval、evidence sufficiency、provenance recovery
  • 优先级:P1 候选

Background

  • 研究问题:GraphRAG 在多跳问答中能利用图结构组织证据,但真实 workload 通常混合了 easy query 和 hard multi-hop query。所有问题都走复杂图检索会浪费 token 和 latency;所有问题都走轻量检索又会漏掉 hard-tail 证据链。
  • 为什么重要:这直接对应 GraphRAG中的停止准则与预算分配形式化:系统需要判断“当前证据是否足够、是否值得继续扩展、是否应升级检索策略”。
  • 现有方法:
    • TextRAG / iterative retrieval 通过多轮文本检索补多跳证据,但容易重复调用 LLM、上下文膨胀、成本升高。
    • LightRAG 这类 local graph retrieval 成本低,但在需要非局部桥接节点时可能召回不足。
    • 全局 GraphRAG 覆盖更强,但构建和刷新成本高,不适合所有 query。

Gap

  • One-size-fits-all retrieval:固定检索策略无法适配 query 难度差异,导致 easy query 过度检索、hard query 检索不足。
  • Extraction loss:KG 抽取常保留 coarse relation,却丢掉数值、时间、条件、例外等细粒度 qualifier。图结构看似连通,但答案需要的精确信息仍在原文 provenance text 中。
  • 现有 adaptive retrieval 多偏 text-centric,缺少 graph-native escalation operator,例如 local neighborhood、bridge discovery、PPR fallback 之间的渐进式切换。
  • 缺少把 answer-level verification 和 retrieval-level escalation 分开的清晰架构。

Insight

  • 一句话创新点:A2RAG 把 GraphRAG 检索改造成“先轻量、再桥接、最后全局扩散”的渐进式 agent,并用 answer-level Triple-Check 决定是否重写和重试。
  • 核心洞察:
    • 图不必被当作完整语义库,而应被当作导航地图;最终答案仍应回到 provenance text。
    • sufficiency check 有两层含义:retriever 内部判断是否升级检索;controller 端判断答案是否 relevance、grounded、adequate。
    • 成本控制不是简单减少 top-k,而是把 expensive operation 留给少数 hard cases。

Method

  • 整体框架:Two-layer architecture。
    • Adaptive Control Loop:负责入库 gate、生成候选答案、Triple-Check 验证、failure-aware rewrite、bounded retry。
    • Agentic Retriever:负责图检索执行,按 Local -> Bridge -> Global PPR 的顺序逐级升级,并把图节点回映射到原文 chunks。

A2RAG-framework-overview

Figure 1 展示整体架构:controller 不直接指定每一步图操作,而是把 query state 交给 retriever;retriever 返回 evidence 后,controller 再生成答案并验证。如果验证失败,controller 根据失败类型重写 query,在预算内重新调用 retriever。这种分工把“答案是否可靠”和“检索如何升级”分开。

A2RAG-adaptive-control-loop

  • Adaptive Control Loop:
    • Entry gate:先用 corpus summary 和 query 做相似度门控。
\mathrm{Gate}(q)=\mathbb{1}\left\{\max_{1\le j\le N}\gamma_j(q)\ge \tau_g\right\}
  • Triple-Check:候选答案必须同时满足 evidence relevance、answer grounding、query resolution。
\mathrm{TripleCheck}(q,a,E)=V_{rel}(q,E)\wedge V_{grd}(a,E)\wedge V_{ans}(q,a)
  • Failure-aware rewrite:若 relevance、grounding 或 adequacy 任一失败,就按失败类型重写 query。
q^{(i+1)}=\mathrm{Rewrite}(q^{(i)},a^{(i)},E^{(i)},type^{(i)})
  • Bounded retry:最多重试 Imax 次,超过预算返回 FAIL / ABSTAIN。

A2RAG-agentic-retriever

  • Agentic Retriever:
    • State:<q, S_V, S_R, E>,其中 S_V 是 entity seeds,S_R 是 relation seeds,E 是累计证据。
    • Stage 1 Local Evidence Collection:从 query entities 对齐到 KG 节点,取 1-hop neighborhood;如果 relation seeds 可用,只保留与关系意图一致的边。
N_1(v)=\{u\in V\mid (v,r,u)\in E_G\ \mathrm{or}\ (u,r,v)\in E_G,\exists r\in R\}
  • Stage 2 Bridge Discovery:当局部邻域不能连接多个 query seeds 时,找能同时连接多个 seeds 的 compact bridge nodes。
B_K=\{u\in V\mid |\{v\in S_V:u\in N_K(v)\}|\ge 2\}
  • Stage 3 Global Fallback:若 local / bridge 都不足,做 degree-normalized Personalized PageRank,再用 π: V -> 2^D 把 top nodes 映射回 provenance text chunks。
r=\alpha p_0+(1-\alpha)P^\top r
E=\bigcup_{u\in V_{top-L}}\pi(u)\subseteq D
  • 推理流程:
    1. Query 先通过 summarized-KB gating 判断是否属于当前 corpus。
    2. 若需要检索,进入 agentic retriever。
    3. Retriever 先尝试 local 1-hop,再尝试 K-hop bridge,最后才用 PPR fallback。
    4. PPR 阶段不直接把图三元组作为最终答案依据,而是把高分节点回映射到原文 chunks。
    5. Controller 用 evidence 生成答案,并用 Triple-Check 验证。
    6. 若失败,按失败类型重写 query,并在 bounded retry 内重新检索。

Results

主结果

A2RAG-table1-main-results

  • HotpotQA:A2RAG 的 R@2 / R@5 为 62.4 / 73.6,高于 LightRAG mix 的 56.8 / 67.5;但 EM / F1 为 32.2 / 43.7,低于 LightRAG mix 的 33.9 / 46.5。
  • 2WikiMultiHopQA:A2RAG 的 R@2 / R@5 为 58.9 / 69.2,高于 LightRAG mix 的 52.7 / 63.8;F1 为 42.9,高于 LightRAG mix 的 41.5,但 EM 低于 LightRAG mix。
  • 生产级数据:论文报告在金融交易平台操作手册 QA 上,A2RAG 相对 LightRAG mix 的 end-to-end Recall@5 约提升 15%;在 20% KG node / edge removal 下保持 67.7 vs 46.5 的 Recall@5。
  • 解读:A2RAG 的优势更明确体现在 evidence recall,答案 EM/F1 并非全面领先。这说明它更像“高召回、低成本、强 provenance 控制”的检索控制器,而不是单纯追求最终答案分数的生成增强方法。

成本与延迟

A2RAG-table2-table3-efficiency

  • HotpotQA multi-hop subset:相对 IRCoT,tokens 从 30k 降到 16k,LLM calls 从 3.5 降到 2.0,平均 latency 从 4.8s 降到 2.7s。
  • 2WikiMultiHopQA multi-hop subset:tokens 从 35k 降到 18k,LLM calls 从 4.2 降到 2.3,平均 latency 从 5.6s 降到 3.2s。
  • 解读:成本下降来自“多数 query 不触发全局 fallback”,而不是模型更小或证据预算不公平。

阶段分布

A2RAG-stage-breakdown-context

  • HotpotQA:58% query 在 local 1-hop 结束,25% 到 bridge stage,13% 触发 PPR,4% fail。
  • 2WikiMultiHopQA:52% query 在 local 1-hop 结束,28% 到 bridge stage,15% 触发 PPR,5% fail。
  • 解读:这张图是 A2RAG 最重要的机制证据。它把 GraphRAG中的停止准则与预算分配形式化 里的“边际收益低于成本就停止”落成了可观测行为:只有少数 hard cases 消耗 PPR / retry 预算。

Relation seed ablation

A2RAG-table4-relation-seeding-ablation

  • 去掉 relation seeds 后,HotpotQA R@2 从 62.4 降到 56.1,2Wiki R@2 从 58.9 降到 51.5。
  • 小 K 下下降更明显,说明 relation intent 能让 local retrieval 和 bridge discovery 更早聚焦到正确关系,而不是扩大上下文碰运气。
  • 这与 GraphRAG中的Bridge Evidence 为什么关键 一致:多跳检索的瓶颈经常不是局部事实没有命中,而是桥接关系方向不对。

Extraction loss robustness

A2RAG-robustness-hotpotqa

A2RAG-robustness-2wiki

  • 在随机删除 KG node / edge 的 stress test 下,A2RAG 比 graph-only LightRAG 退化更慢。
  • HotpotQA:LightRAG R@5 从 67.5 降到 44.5,A2RAG 从 73.6 降到 59.7。
  • 2WikiMultiHopQA:LightRAG R@5 从 63.8 降到 41.0,A2RAG 从 69.2 降到 55.4。
  • 解读:PPR map-back 的价值不是“图一定完整”,而是图即便不完整,仍可作为结构导航信号定位高价值原文区域。这一点可连接 GraphRAG中的Personalized-PageRank 和 GraphRAG的鲁棒性框架。

Limitations

  • 实验规模有限:HotpotQA 和 2WikiMultiHopQA 都是抽样子集,不是 full benchmark。
  • 最终 EM/F1 不总是最优:A2RAG 的强项是 small-K evidence recall 和成本效率,不能简单写成全面 SOTA。
  • 依赖 seed quality:entity seeds 和 relation seeds 抽错,会导致 local expansion 和 bridge discovery 方向偏移。
  • 仍需要最低限度的 graph backbone:如果图极度稀疏或严重碎片化,A2RAG 会逐渐退化到接近 text-only retrieval。
  • 生产级金融数据不是公开 benchmark,难以独立复核。
  • Triple-Check validator 可以用 NLI 或 LLM binary classifier 实现,但论文没有充分展开校准、judge 偏差和 false accept / false reject 的影响。
  • 未见公开代码,复现成本较高。

Future Directions

  • 作者 Future Work:
    • 在更大规模、更丰富语料上验证泛化性。
    • 提升 robust and domain-adaptive seed extraction。
    • 研究持续更新知识库下的 graph maintenance、drift 和 partial degradation。
  • Agent 推断的 Research Opportunities:
    • 把 A2RAG 的 Local -> Bridge -> PPR escalation 改成可学习 policy,学习何时升级、何时停止。
    • 将 Triple-Check 拆成可标注的训练信号:evidence relevance、answer grounding、answer adequacy。
    • 在当前 GraphRAG 检索实验中记录 stage termination:local hit、bridge hit、PPR fallback、failure,做失败归因。
    • 把 relation seed ablation 转成诊断指标:如果 relation seed 缺失导致 R@2 明显下降,说明 query 的关系意图没有被检索器捕捉。
    • 对比 A2RAG 和 BubbleRAG:前者强调渐进式检索升级,后者强调证据子图目标优化;二者可以统一到“有限预算下的 evidence utility 最大化”。

与本知识库的连接

本卡片待补

  • 查找是否发布代码或正式 workshop proceedings 页面。
  • 把 Triple-Check 做成可复用模板,和 Evidence Sufficiency Rubric Template 对齐。
  • 在本地 GraphRAG 检索实验中复刻 stage-wise termination 统计:Local / Bridge / PPR / Fail。