GGraphRAG 文献图谱自动同步
LIT-4ACB946B · 2026

TCAR-Gen - Temporal Graph Retrieval with Evidence Fusion

TCAR-Gen 用 query-conditioned context graph 缩小搜索空间,再用 temporal GNN attention、semantic-graph-time hybrid retrieval 和 Chain-of-Trees path fusion,让检索、推理和时间一致性约束共享同一张证据图。

PDF 级阅读卡优先级 P1Sidra Nasir, Muhammad Noman Zahid, Rizwan Ahmed Khan发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:复杂历史案件叙事问答中,答案往往依赖多个证据片段、实体关系和事件顺序。普通 RAG 只按文本相似度检索 chunk,容易漏掉跨文档、多跳、时间顺序相关的证据。
  • 为什么重要:时间推理不只是检索到“相关事件”,还要保证事件先后、证据时间窗、因果顺序和跨案件关系都一致。生成器如果最后才处理时间冲突,往往已经被错误证据污染。
  • 对本知识库的意义:TCAR-Gen 补上了时间 GraphRAG 方向的一条新线:不是只在 retrieval 后做 temporal rerank,也不是只把时间戳写进 community summary,而是在 query-conditioned context graph、GNN attention、hybrid retrieval 和 path fusion 中都加入时间约束。它连接 STAR-RAG、StreamingRAG、GraphRAG中的Personalized-PageRank 和 GraphRAG中的查询语义、逻辑约束与数据库视角。

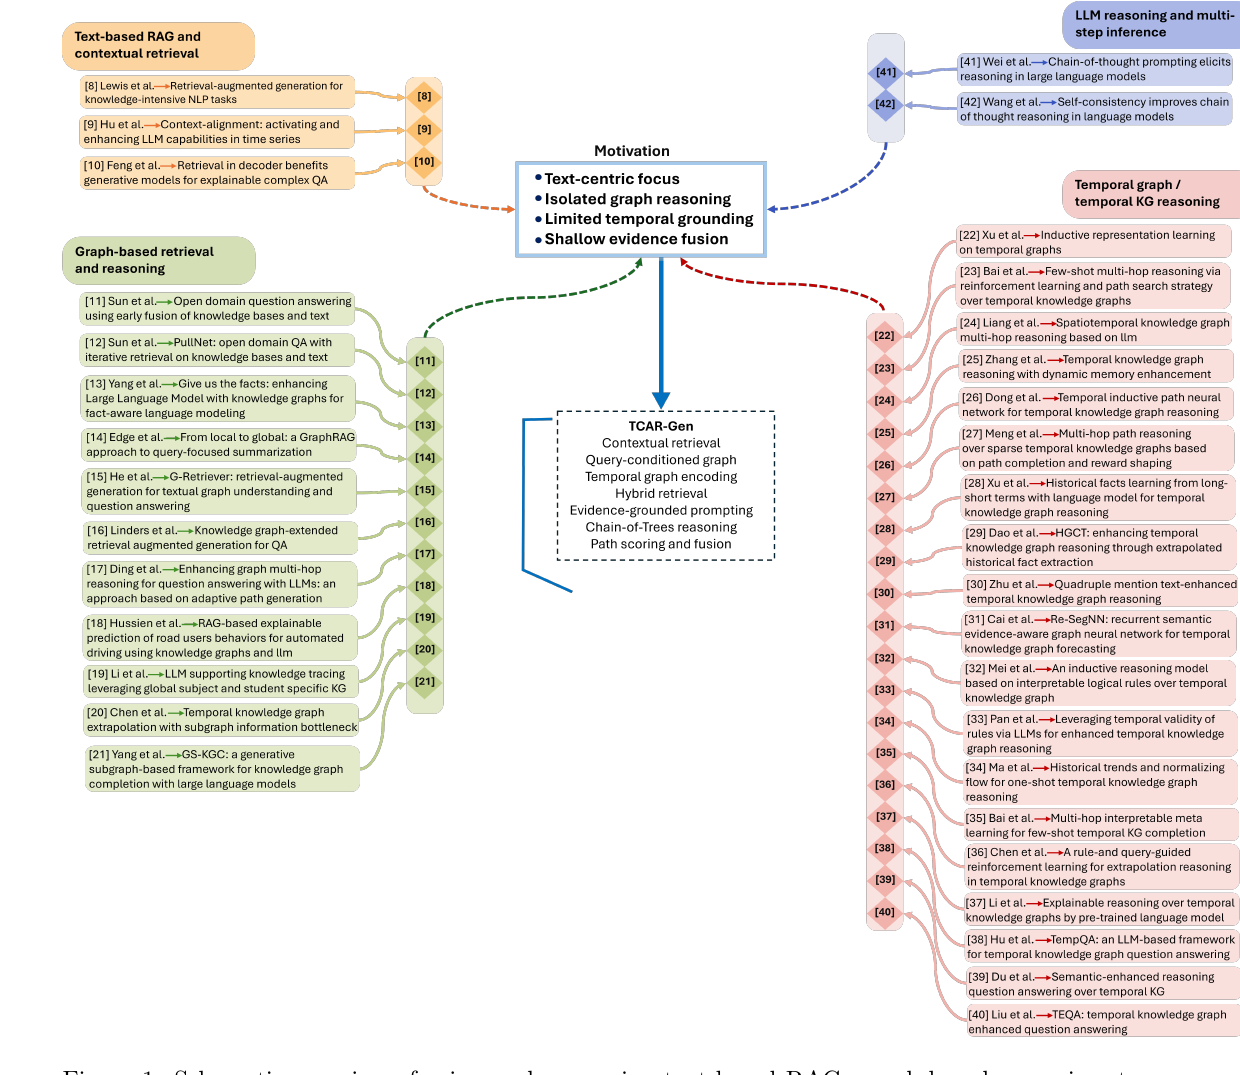
Figure 1 把 TCAR-Gen 放在四条线的交汇处:text-based RAG、graph-based retrieval、temporal KG reasoning 和 LLM multi-step inference。论文认为现有方向各自推进,但缺少一个把 document context、query-conditioned graph、temporal modelling 和 evidence-grounded multi-branch reasoning 统一起来的 pipeline。

  • Text-only RAG 关注 query-chunk 相似度,无法显式表示实体、事件、地点、证据之间的关系。
  • Temporal RAG 如果只做检索后重排,只能利用表层时间窗口,不能处理多跳事件链和跨文档时间依赖。
  • Community-style GraphRAG 可以组织结构,但 community summary 太粗,难以区分具体 evidence chunks。
  • 现有 Chain-of-Thought / self-consistency 主要在生成阶段多想几条路径,不保证每条中间推理都被外部结构证据支撑。
  • 时间 KG 模型常专注图推理或补全,较少和 LLM 的证据检索、prompt construction、answer fusion 打通。

方法与机制

1. Query-specific context graph:先把大图压成查询相关子图

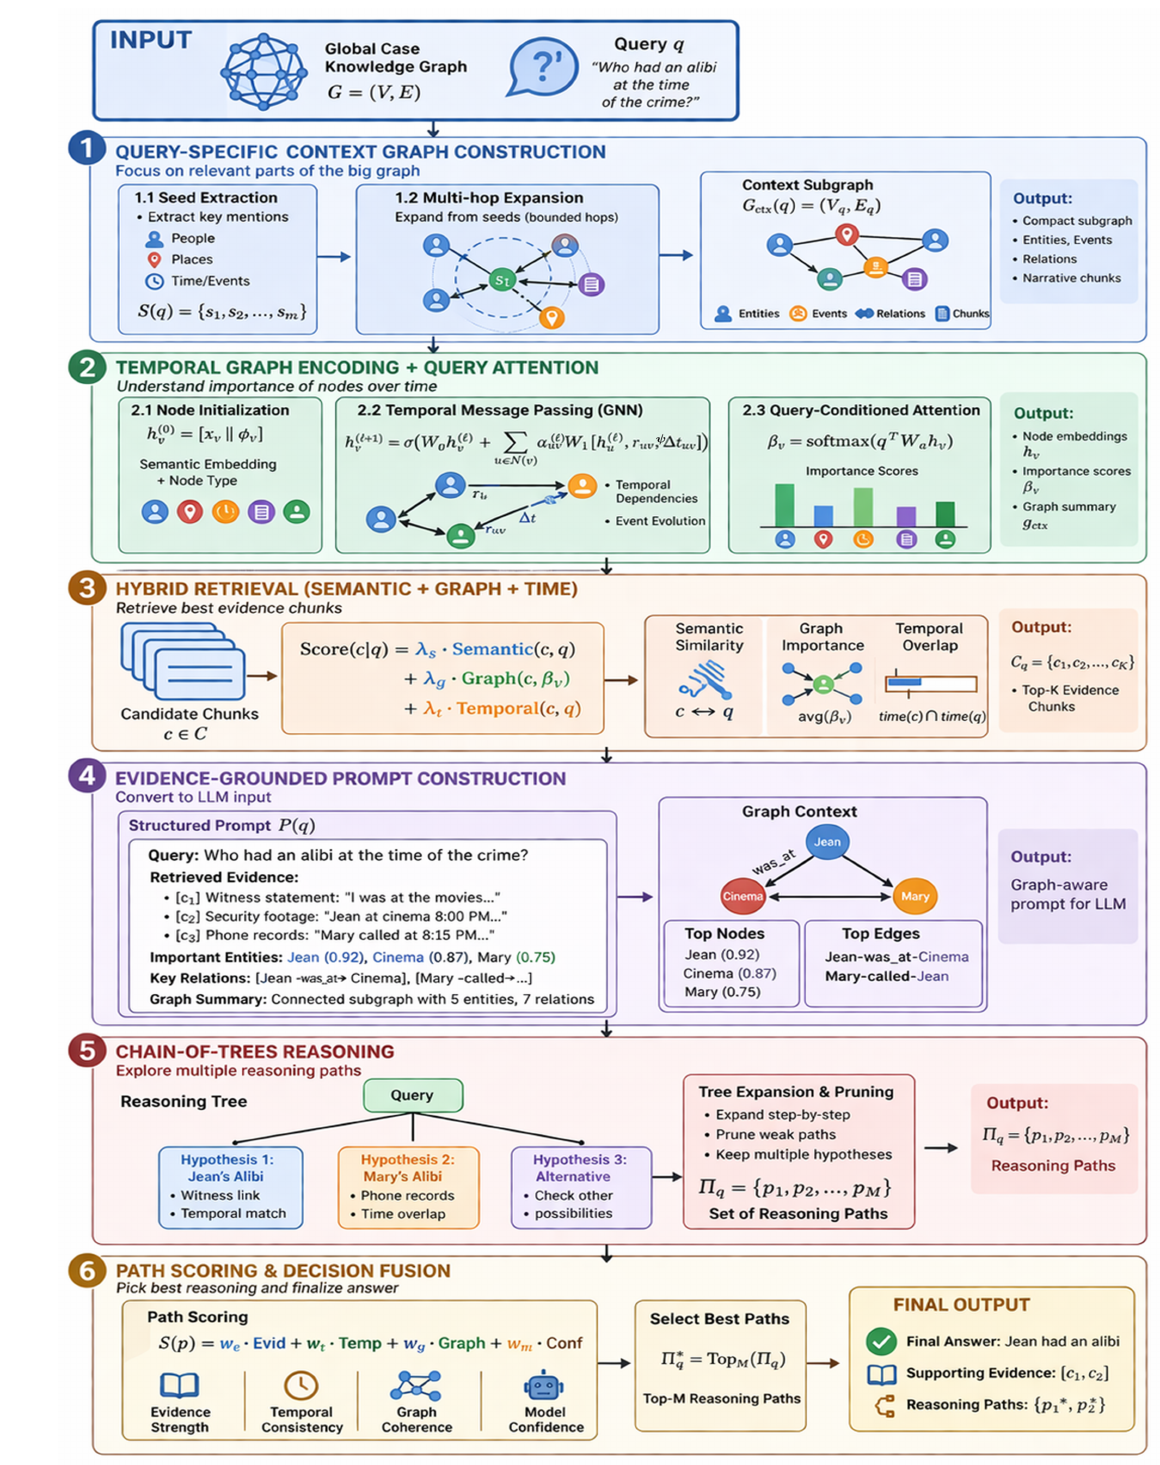
TCAR-Gen 的输入是全局案件知识图谱 $G=(V,E)$ 和自然语言 query $q$。每条边带 relation type,部分边带 temporal marker。目标是生成答案 $y$,同时返回 evidence set $C_q$ 和 reasoning trace $P_q$。

第一步从 query 中抽取 seed mentions:case title、suspect name、victim、location、time expression、crime descriptor,并映射到图节点:

S(q)=\{s_1,s_2,\ldots,s_m\}

然后从 seed 出发做 bounded multi-hop expansion,得到查询相关上下文图:

G_{ctx}(q)=(V_q,E_q)

输入是 query 和全局图;计算是 entity grounding + 有 hop / node budget 的邻域扩展;输出是只包含相关 entity、event、relation、narrative chunk 的 compact subgraph。

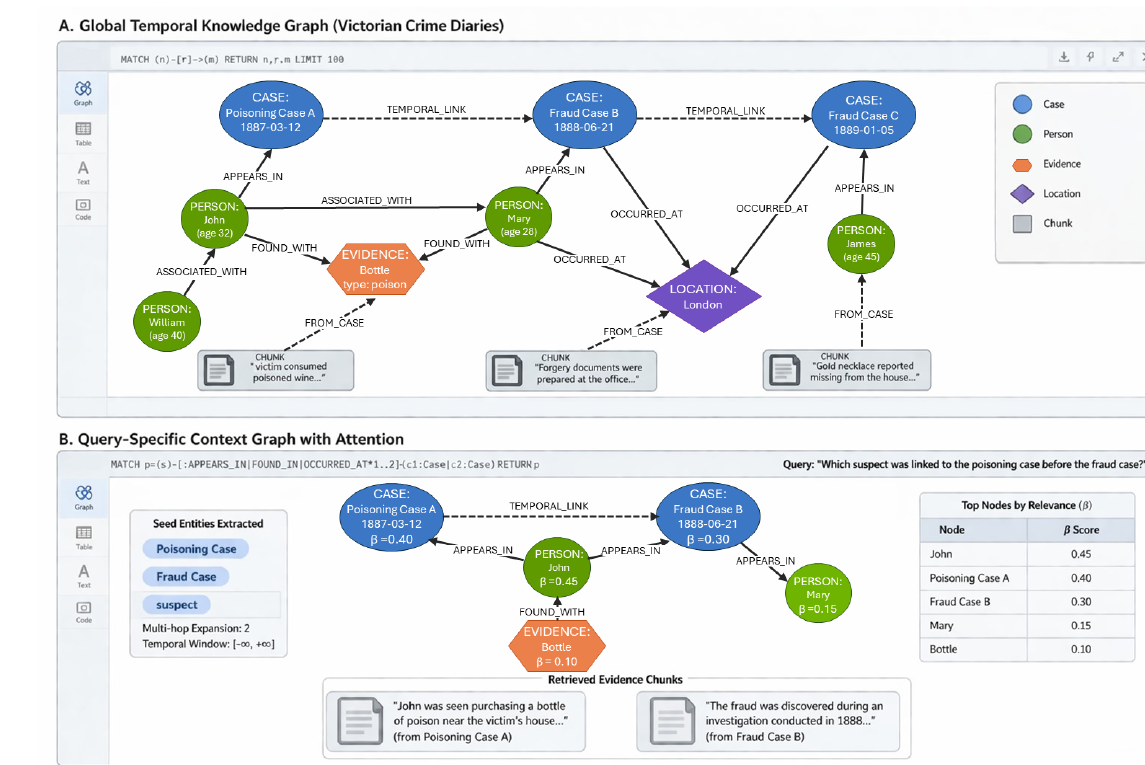
Figure 3 展示了从全局 Victorian Crime Diaries 图到 query-specific subgraph 的缩小过程。对于 poisoning-fraud comparison query,系统保留 poisoning case、fraud case、John、Mary、bottle 等节点,并给节点分配 query-conditioned relevance score $\beta$。

2. Temporal GNN + Query-conditioned attention:给节点和边打查询相关分

节点初始化由语义向量和类型特征拼接:

h_v^{(0)}=[x_v\parallel \phi_v]

其中 $x_v$ 是 node text / metadata embedding,$\phi_v$ 是 type-specific feature。边上 relation type 映射为 $r_{uv}$,时间间隔编码为 $\psi(\Delta t_{uv})$。

每层 temporal message passing:

h_v^{(\ell+1)}=\sigma\left(W_0h_v^{(\ell)}+\sum_{u\in N(v)}\alpha_{uv}W_1[h_u^{(\ell)}\parallel \psi(\Delta t_{uv})\parallel r_{uv}]\right)

输入是 context graph;计算是把 neighbor representation、time gap、relation embedding 一起聚合;输出是带时间邻域信息的 node representation。

然后用 query embedding $q$ 对节点做 attention:

\beta_v=\frac{\exp(q^TW_ah_v^{(L)})}{\sum_{u\in V_q}\exp(q^TW_ah_u^{(L)})}

并得到 graph summary:

g_{ctx}=\sum_{v\in V_q}\beta_vh_v^{(L)}

这里的 $\beta_v$ 后续会被复用为 graph relevance signal,进入 chunk retrieval 和 path scoring。

3. Hybrid retrieval:semantic + graph + temporal 三路打分

候选 evidence chunk $c$ 的最终检索分数是:

Score(c\mid q)=\lambda_sSim(q,e_c)+\lambda_gGraphRel(c\mid G_{ctx},\beta)+\lambda_tTimeAlign(c\mid q)

其中:

Sim(q,e_c)=\frac{q^Te_c}{\|q\|\|e_c\|}
GraphRel(c\mid G_{ctx},\beta)=\max_{v\in Nodes(c)}\beta_v
TimeAlign(c\mid q)=\frac{|I_q\cap I_c|}{|I_q\cup I_c|}

输入是 candidate chunks、query、context graph 和时间窗口;计算是语义相似度、节点相关性、时间窗口重叠的加权和;输出是 top-K evidence chunks:

C_q=\{c_1,c_2,\ldots,c_K\}

论文实现中权重为:

\lambda_s=0.5,\quad \lambda_g=0.3,\quad \lambda_t=0.2

4. Evidence-grounded prompt:把文本证据和图摘要一起给 LLM

检索后的 prompt 包括 query、retrieved chunks、context graph rendering、top nodes 和 top edges:

P(q)=T(q,C_q,Render(G_{ctx}),TopNodes(\beta),TopEdges(\alpha))

输入是检索证据和图 salience;计算是把 top nodes / top edges 线性化成 compact typed triples;输出是 graph-aware prompt。这个步骤的目的不是塞更多文本,而是把 LLM 的回答空间约束在“可被证据 chunk 和图边支持”的局部上下文内。

5. Chain-of-Trees:保留多条证据路径再融合

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

1. 数据集:Victorian Crime Diaries,160 个分层 query

论文在 Victorian Crime Diaries (VCD) corpus 上评估。语料是 Victorian-era criminal case narratives,构造成 Neo4j 异构图:

  • 节点:Case、Person、Evidence、Location、Chunk。
  • 边:APPEARS_IN、FOUND_IN、OCCURRED_AT、FROM_CASE 等。
  • 案件类型:poisoning、murder、theft、conspiracy、blackmail、forgery、kidnapping、fraud。
  • 每个 Case 有 date attribute,可做 temporal ordering 和 cross-case comparison。

benchmark 有 160 个 query:

  • train 20:训练 GNN evidence labels。
  • dev 20:调 retrieval weights 和 path scoring weights。
  • test 120:最终评估。

七类 query:Narrative、Entity Lookup、Cross-Case、Evidence、Temporal、Multi-Hop、Counterfactual。

2. 主结果:TCAR-Gen 在 retrieval 和 temporal consistency 上拉开差距

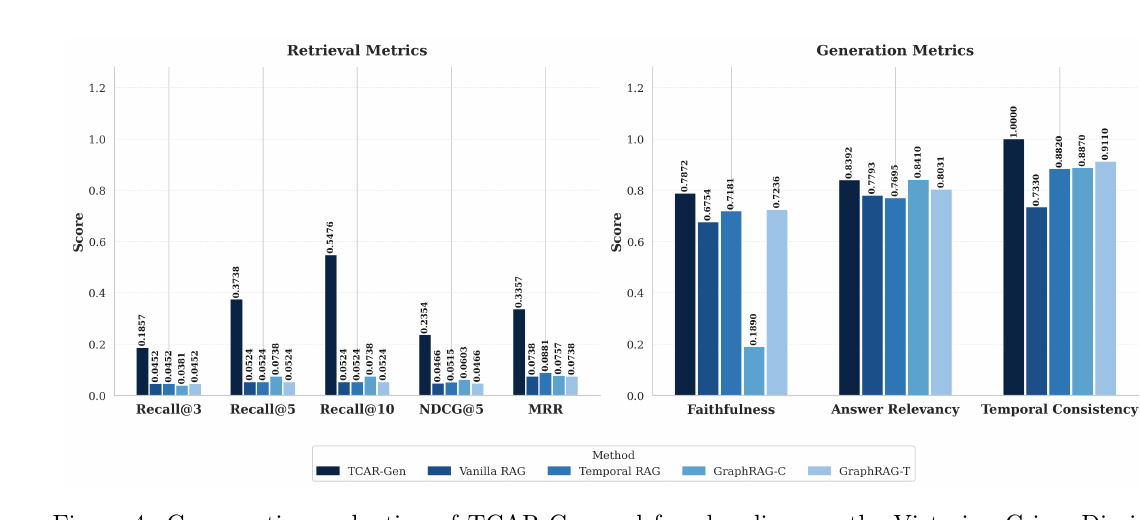
Figure 4 比较 TCAR-Gen、Vanilla RAG、Temporal RAG、GraphRAG-C、GraphRAG-T。关键数字:

  • Recall@5:TCAR-Gen 0.3738,最强 baseline GraphRAG-C 0.0738。
  • Recall@10:TCAR-Gen 0.5476,GraphRAG-C 0.0738。
  • NDCG@5:TCAR-Gen 0.2354,GraphRAG-C 0.0603。
  • MRR:TCAR-Gen 0.3357,Temporal RAG 0.0881。
  • Faithfulness:TCAR-Gen 0.7872,GraphRAG-T 0.7236。
  • Temporal Consistency:TCAR-Gen 1.0000,GraphRAG-T 0.9110,Vanilla RAG 0.7330。

解读:GraphRAG-T 虽然有时间 edge attributes,但只在 community summary 级别加入时间信息,无法细粒度区分 evidence chunks。TCAR-Gen 把时间约束下沉到 evidence-level scoring 和 path fusion,所以 temporal consistency 分离最明显。

3. 分类型结果:Multi-Hop 和 Entity Lookup 收益最大

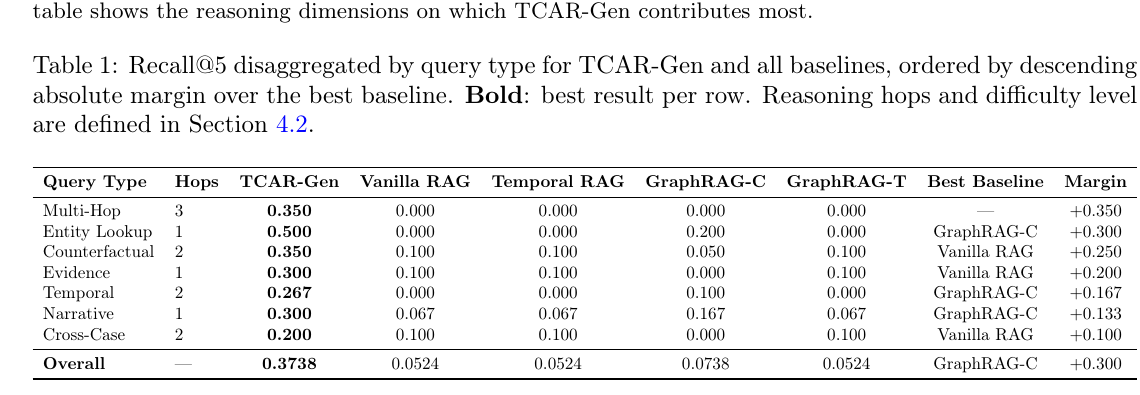
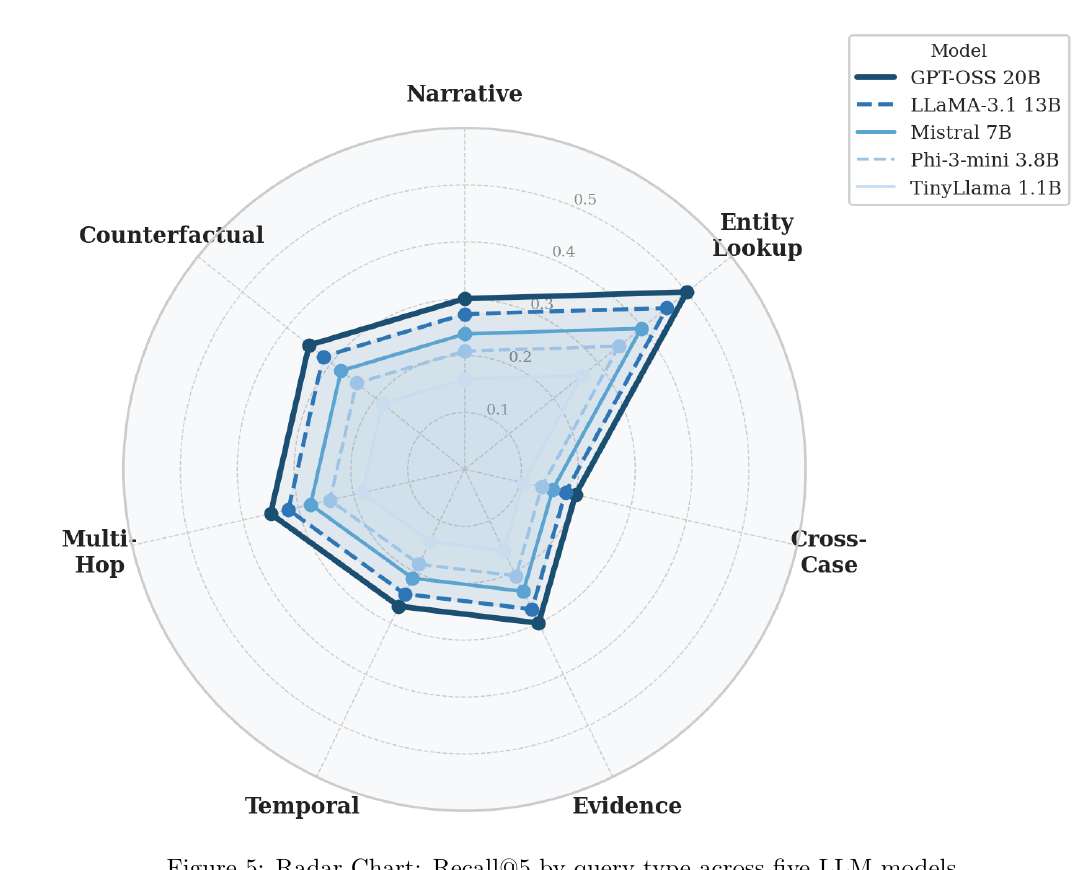
Table 1 显示 TCAR-Gen 在 7 类 query 上 Recall@5 都最高:

  • Multi-Hop:0.350,所有 baseline 都是 0.000,margin +0.350。
  • Entity Lookup:0.500,GraphRAG-C 0.200,margin +0.300。
  • Counterfactual:0.350,Vanilla / Temporal RAG 0.100,margin +0.250。
  • Temporal:0.267,GraphRAG-C 0.100,margin +0.167。
  • Cross-Case:0.200,margin 只有 +0.100,是最弱类型。

Cross-Case 较弱的原因很有价值:query 跨两个 case document 时,seed entities 可能只激活其中一个子图,另一个 case 的连接证据落在 bounded two-hop expansion 之外。这直接指向 cross-case entity resolution / alias normalization 的改进空间。

4. 消融:context graph、QCAP-GNN、temporal penalty 都是硬组件

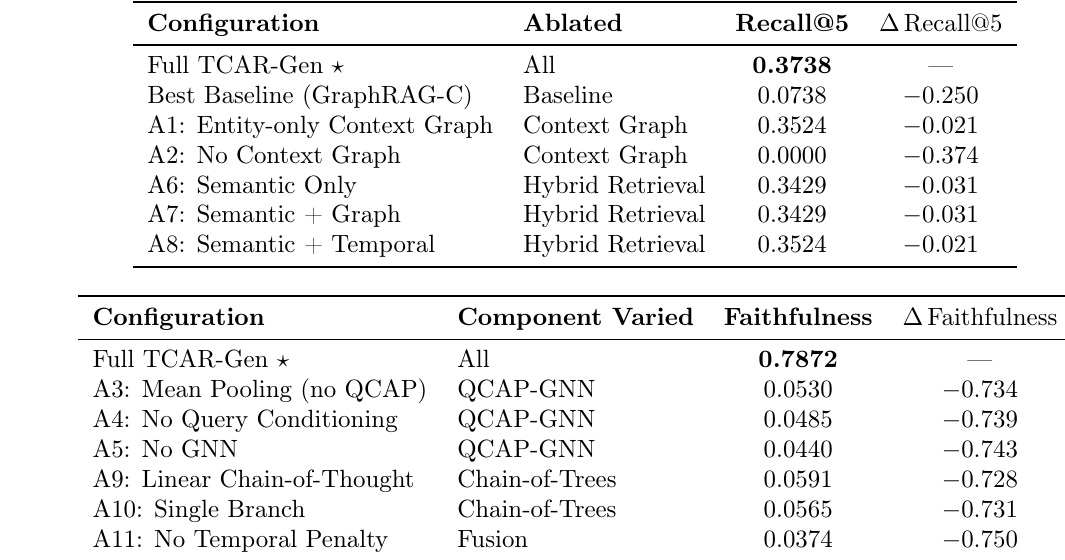
Table 2 的关键信号:

  • No Context Graph:Recall@5 从 0.3738 掉到 0.0000。
  • Semantic Only:Recall@5 0.3429,说明语义仍有基础作用,但不足以达到完整系统。
  • Semantic + Temporal:Recall@5 0.3524,优于 Semantic + Graph 的 0.3429,说明单独看时 temporal alignment 更有区分力。
  • No GNN:Faithfulness 从 0.7872 掉到 0.0440。
  • Linear Chain-of-Thought:Faithfulness 0.0591。
  • No Temporal Penalty:Faithfulness 0.0374,是最大退化。

解读:TCAR-Gen 的收益不是单个“加时间”模块带来的,而是 context graph 控制检索空间、GNN 产生可靠节点权重、Chain-of-Trees 比较证据路径、temporal penalty 过滤违背时间顺序的路径共同作用。

5. 跨模型缩放:retrieval 比 generation 更抗小模型退化

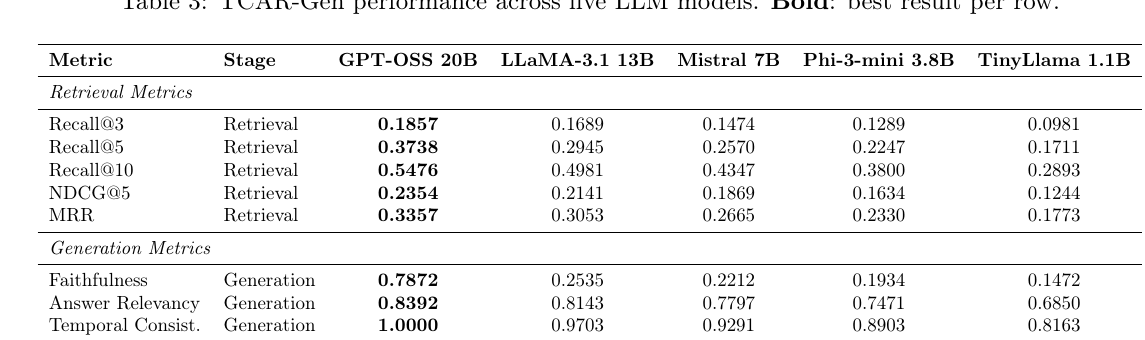
Table 3 比较 GPT-OSS 20B、LLaMA-3.1 13B、Mistral 7B、Phi-3-mini 3.8B、TinyLlama 1.1B:

  • Recall@5:0.3738 -> 0.2945 -> 0.2570 -> 0.2247 -> 0.1711。
  • Recall@10:0.5476 -> 0.4981 -> 0.4347 -> 0.3800 -> 0.2893。

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

局限与开放问题

  • 只评估 Victorian Crime Diaries 一个语料,外推到开放域、多领域 temporal QA、真实法律/医学时间线还需要验证。

  • VCD benchmark 是作者构造的 160-query 数据集,test 只有 120 个 query,规模偏小。

  • TCAR-Gen 有 trainable GNN,baseline 多是 inference-time 方法;虽然论文解释这是架构差异,但监督信号和开发成本并不完全对等。

  • No Context Graph 消融 Recall@5 直接为 0.0000,说明系统强依赖图 schema 和 query grounding;如果 seed extraction 或 entity linking 失败,后续模块很难恢复。

  • Cross-Case 是最弱类型,bounded expansion 容易漏掉另一个 case 子图,说明跨文档桥接仍是瓶颈。

  • 没有与已有 temporal GraphRAG / temporal KGQA 方法如 STAR-RAG 在同一数据集上直接对齐评测。

  • End-to-end latency 为 4.2s/query,高于 Vanilla RAG 的 1.1s;Chain-of-Trees 和 GNN 带来可见开销。

  • Generation faithfulness 在小模型上明显下降,说明结构化检索不能完全替代生成模型的多步合成能力。

  • 作者 Future Work:

    • 扩展到更大、更多样的 benchmark。
    • 改进 adaptive graph construction 和 learned weighting。
    • 扩展 temporal modelling,捕捉更丰富的 event structures。
    • 降低 reasoning overhead。
    • 与更小模型或分布式系统集成,提高可扩展性。
  • Agent 推断的 Research Opportunities:

    • 做 temporal evidence fusion diagnostic:区分失败来自 seed grounding、bounded expansion、temporal alignment、path fusion 还是 generation synthesis。
    • 把 cross-case bridge retrieval 作为专门问题:增加 alias normalization、case-to-case bridge expansion 和 multi-seed coverage constraint。
    • 在 STAR-RAG 的 temporal rule graph 和 TCAR-Gen 的 query-conditioned context graph 之间做对照:一个偏时间规则摘要,一个偏 query-specific evidence fusion。
    • 将 temporal penalty 泛化为 constraint penalty:时间、空间、因果、权限、流程都可作为 path scoring 约束。
    • 对小模型路线做两阶段系统:小模型负责 retrieval / path filtering,大模型只在 high-risk synthesis 时调用。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q5 动态状态与学习策略, Q6 证据来源与可解释性
展开原始论文笔记全文

基本信息

  • 英文标题:TCAR-Gen: Temporal Graph Retrieval with Evidence Fusion for Knowledge-Grounded Generation
  • 中文标题:TCAR-Gen:面向知识生成的时间图检索与证据融合
  • 作者:Sidra Nasir, Muhammad Noman Zahid, Rizwan Ahmed Khan
  • 机构:Università di Verona;University of Camerino;Institute of Business Administration, Karachi
  • 年份:2026
  • 版本:arXiv v1,2026-04-15
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:论文未给出公开代码链接
  • 阅读状态:PDF级
  • 所属方向:temporal GraphRAG、query-conditioned graph retrieval、temporal evidence fusion、Chain-of-Trees reasoning
  • 优先级:P1

Background

  • 研究问题:复杂历史案件叙事问答中,答案往往依赖多个证据片段、实体关系和事件顺序。普通 RAG 只按文本相似度检索 chunk,容易漏掉跨文档、多跳、时间顺序相关的证据。
  • 为什么重要:时间推理不只是检索到“相关事件”,还要保证事件先后、证据时间窗、因果顺序和跨案件关系都一致。生成器如果最后才处理时间冲突,往往已经被错误证据污染。
  • 对本知识库的意义:TCAR-Gen 补上了时间 GraphRAG 方向的一条新线:不是只在 retrieval 后做 temporal rerank,也不是只把时间戳写进 community summary,而是在 query-conditioned context graph、GNN attention、hybrid retrieval 和 path fusion 中都加入时间约束。它连接 STAR-RAG、StreamingRAG、GraphRAG中的Personalized-PageRank 和 GraphRAG中的查询语义、逻辑约束与数据库视角。

TCARGen-fig1-positioning

Figure 1 把 TCAR-Gen 放在四条线的交汇处:text-based RAG、graph-based retrieval、temporal KG reasoning 和 LLM multi-step inference。论文认为现有方向各自推进,但缺少一个把 document context、query-conditioned graph、temporal modelling 和 evidence-grounded multi-branch reasoning 统一起来的 pipeline。

Gap

  • Text-only RAG 关注 query-chunk 相似度,无法显式表示实体、事件、地点、证据之间的关系。
  • Temporal RAG 如果只做检索后重排,只能利用表层时间窗口,不能处理多跳事件链和跨文档时间依赖。
  • Community-style GraphRAG 可以组织结构,但 community summary 太粗,难以区分具体 evidence chunks。
  • 现有 Chain-of-Thought / self-consistency 主要在生成阶段多想几条路径,不保证每条中间推理都被外部结构证据支撑。
  • 时间 KG 模型常专注图推理或补全,较少和 LLM 的证据检索、prompt construction、answer fusion 打通。

Insight

  • 一句话创新点:TCAR-Gen 用 query-conditioned context graph 缩小搜索空间,再用 temporal GNN attention、semantic-graph-time hybrid retrieval 和 Chain-of-Trees path fusion,让检索、推理和时间一致性约束共享同一张证据图。
  • 核心洞察:
    • 时间信息不能只作为检索后的排序因子,而要进入 graph encoding、chunk scoring 和 reasoning path scoring。
    • 对多跳/反事实/跨案件问题,正确证据通常分散在多个 chunk 和多个 graph region,必须用分支式推理比较不同证据路径。
    • GraphRAG-T 的时间 community summary 不够细;时间信号必须落到 evidence chunk level。
    • 小模型仍能保留一定 retrieval coverage,但生成 faithfulness 会快速下降,说明结构化检索和多步合成能力应分开评估。

Method

1. Query-specific context graph:先把大图压成查询相关子图

TCARGen-fig2-framework

TCAR-Gen 的输入是全局案件知识图谱 $G=(V,E)$ 和自然语言 query $q$。每条边带 relation type,部分边带 temporal marker。目标是生成答案 $y$,同时返回 evidence set $C_q$ 和 reasoning trace $P_q$。

第一步从 query 中抽取 seed mentions:case title、suspect name、victim、location、time expression、crime descriptor,并映射到图节点:

S(q)=\{s_1,s_2,\ldots,s_m\}

然后从 seed 出发做 bounded multi-hop expansion,得到查询相关上下文图:

G_{ctx}(q)=(V_q,E_q)

输入是 query 和全局图;计算是 entity grounding + 有 hop / node budget 的邻域扩展;输出是只包含相关 entity、event、relation、narrative chunk 的 compact subgraph。

TCARGen-fig3-query-context-graph

Figure 3 展示了从全局 Victorian Crime Diaries 图到 query-specific subgraph 的缩小过程。对于 poisoning-fraud comparison query,系统保留 poisoning case、fraud case、John、Mary、bottle 等节点,并给节点分配 query-conditioned relevance score $\beta$。

2. Temporal GNN + Query-conditioned attention:给节点和边打查询相关分

节点初始化由语义向量和类型特征拼接:

h_v^{(0)}=[x_v\parallel \phi_v]

其中 $x_v$ 是 node text / metadata embedding,$\phi_v$ 是 type-specific feature。边上 relation type 映射为 $r_{uv}$,时间间隔编码为 $\psi(\Delta t_{uv})$。

每层 temporal message passing:

h_v^{(\ell+1)}=\sigma\left(W_0h_v^{(\ell)}+\sum_{u\in N(v)}\alpha_{uv}W_1[h_u^{(\ell)}\parallel \psi(\Delta t_{uv})\parallel r_{uv}]\right)

输入是 context graph;计算是把 neighbor representation、time gap、relation embedding 一起聚合;输出是带时间邻域信息的 node representation。

然后用 query embedding $q$ 对节点做 attention:

\beta_v=\frac{\exp(q^TW_ah_v^{(L)})}{\sum_{u\in V_q}\exp(q^TW_ah_u^{(L)})}

并得到 graph summary:

g_{ctx}=\sum_{v\in V_q}\beta_vh_v^{(L)}

这里的 $\beta_v$ 后续会被复用为 graph relevance signal,进入 chunk retrieval 和 path scoring。

3. Hybrid retrieval:semantic + graph + temporal 三路打分

候选 evidence chunk $c$ 的最终检索分数是:

Score(c\mid q)=\lambda_sSim(q,e_c)+\lambda_gGraphRel(c\mid G_{ctx},\beta)+\lambda_tTimeAlign(c\mid q)

其中:

Sim(q,e_c)=\frac{q^Te_c}{\|q\|\|e_c\|}
GraphRel(c\mid G_{ctx},\beta)=\max_{v\in Nodes(c)}\beta_v
TimeAlign(c\mid q)=\frac{|I_q\cap I_c|}{|I_q\cup I_c|}

输入是 candidate chunks、query、context graph 和时间窗口;计算是语义相似度、节点相关性、时间窗口重叠的加权和;输出是 top-K evidence chunks:

C_q=\{c_1,c_2,\ldots,c_K\}

论文实现中权重为:

\lambda_s=0.5,\quad \lambda_g=0.3,\quad \lambda_t=0.2

4. Evidence-grounded prompt:把文本证据和图摘要一起给 LLM

检索后的 prompt 包括 query、retrieved chunks、context graph rendering、top nodes 和 top edges:

P(q)=T(q,C_q,Render(G_{ctx}),TopNodes(\beta),TopEdges(\alpha))

输入是检索证据和图 salience;计算是把 top nodes / top edges 线性化成 compact typed triples;输出是 graph-aware prompt。这个步骤的目的不是塞更多文本,而是把 LLM 的回答空间约束在“可被证据 chunk 和图边支持”的局部上下文内。

5. Chain-of-Trees:保留多条证据路径再融合

普通 single-chain CoT 容易在一条路径早早犯错。TCAR-Gen 生成一棵 reasoning tree $T_q$,根节点是初始 prompt,每个子节点是一条基于特定证据分支的 local claim。

当前实现有三类初始 branch:

  • witness-link evidence。
  • temporal-overlap evidence。
  • shared physical evidence。

生成 leaf paths:

\Pi_q=\{p_1,p_2,\ldots,p_M\}

输入是 evidence-grounded prompt;计算是分支扩展、低置信路径剪枝、最多深度 3;输出是多条 candidate reasoning paths。

6. Path scoring and decision fusion:按证据、时间、图一致性选路径

每条路径 $p$ 的总分:

S(p)=w_eEvid(p)+w_tTemp(p)+w_gGraph(p)+w_mConf(p)

其中 evidence support:

Evid(p)=\frac{1}{|Supp(p)|}\sum_{c\in Supp(p)}Score(c\mid q)

graph coherence:

Graph(p)=\frac{1}{|Edges(p)|}\sum_{(u\to v)\in Edges(p)}\alpha_{uv}

temporal consistency:

Temp(p)=1-\eta|V_{temp}(p)|

输入是 candidate reasoning paths;计算是 evidence support、temporal violation penalty、graph edge salience、model confidence 的加权融合;输出是 top paths 和 final answer:

\Pi_q^*=TopM(\Pi_q;S)

实现权重:

w_e=0.3,\quad w_t=0.3,\quad w_g=0.2,\quad w_m=0.2

Results

1. 数据集:Victorian Crime Diaries,160 个分层 query

论文在 Victorian Crime Diaries (VCD) corpus 上评估。语料是 Victorian-era criminal case narratives,构造成 Neo4j 异构图:

  • 节点:Case、Person、Evidence、Location、Chunk。
  • 边:APPEARS_IN、FOUND_IN、OCCURRED_AT、FROM_CASE 等。
  • 案件类型:poisoning、murder、theft、conspiracy、blackmail、forgery、kidnapping、fraud。
  • 每个 Case 有 date attribute,可做 temporal ordering 和 cross-case comparison。

benchmark 有 160 个 query:

  • train 20:训练 GNN evidence labels。
  • dev 20:调 retrieval weights 和 path scoring weights。
  • test 120:最终评估。

七类 query:Narrative、Entity Lookup、Cross-Case、Evidence、Temporal、Multi-Hop、Counterfactual。

2. 主结果:TCAR-Gen 在 retrieval 和 temporal consistency 上拉开差距

TCARGen-fig4-main-results

Figure 4 比较 TCAR-Gen、Vanilla RAG、Temporal RAG、GraphRAG-C、GraphRAG-T。关键数字:

  • Recall@5:TCAR-Gen 0.3738,最强 baseline GraphRAG-C 0.0738。
  • Recall@10:TCAR-Gen 0.5476,GraphRAG-C 0.0738。
  • NDCG@5:TCAR-Gen 0.2354,GraphRAG-C 0.0603。
  • MRR:TCAR-Gen 0.3357,Temporal RAG 0.0881。
  • Faithfulness:TCAR-Gen 0.7872,GraphRAG-T 0.7236。
  • Temporal Consistency:TCAR-Gen 1.0000,GraphRAG-T 0.9110,Vanilla RAG 0.7330。

解读:GraphRAG-T 虽然有时间 edge attributes,但只在 community summary 级别加入时间信息,无法细粒度区分 evidence chunks。TCAR-Gen 把时间约束下沉到 evidence-level scoring 和 path fusion,所以 temporal consistency 分离最明显。

3. 分类型结果:Multi-Hop 和 Entity Lookup 收益最大

TCARGen-table1-query-type-recall

Table 1 显示 TCAR-Gen 在 7 类 query 上 Recall@5 都最高:

  • Multi-Hop:0.350,所有 baseline 都是 0.000,margin +0.350。
  • Entity Lookup:0.500,GraphRAG-C 0.200,margin +0.300。
  • Counterfactual:0.350,Vanilla / Temporal RAG 0.100,margin +0.250。
  • Temporal:0.267,GraphRAG-C 0.100,margin +0.167。
  • Cross-Case:0.200,margin 只有 +0.100,是最弱类型。

Cross-Case 较弱的原因很有价值:query 跨两个 case document 时,seed entities 可能只激活其中一个子图,另一个 case 的连接证据落在 bounded two-hop expansion 之外。这直接指向 cross-case entity resolution / alias normalization 的改进空间。

4. 消融:context graph、QCAP-GNN、temporal penalty 都是硬组件

TCARGen-table2-ablation

Table 2 的关键信号:

  • No Context Graph:Recall@5 从 0.3738 掉到 0.0000。
  • Semantic Only:Recall@5 0.3429,说明语义仍有基础作用,但不足以达到完整系统。
  • Semantic + Temporal:Recall@5 0.3524,优于 Semantic + Graph 的 0.3429,说明单独看时 temporal alignment 更有区分力。
  • No GNN:Faithfulness 从 0.7872 掉到 0.0440。
  • Linear Chain-of-Thought:Faithfulness 0.0591。
  • No Temporal Penalty:Faithfulness 0.0374,是最大退化。

解读:TCAR-Gen 的收益不是单个“加时间”模块带来的,而是 context graph 控制检索空间、GNN 产生可靠节点权重、Chain-of-Trees 比较证据路径、temporal penalty 过滤违背时间顺序的路径共同作用。

5. 跨模型缩放:retrieval 比 generation 更抗小模型退化

TCARGen-table3-cross-model

Table 3 比较 GPT-OSS 20B、LLaMA-3.1 13B、Mistral 7B、Phi-3-mini 3.8B、TinyLlama 1.1B:

  • Recall@5:0.3738 -> 0.2945 -> 0.2570 -> 0.2247 -> 0.1711。
  • Recall@10:0.5476 -> 0.4981 -> 0.4347 -> 0.3800 -> 0.2893。
  • Faithfulness:0.7872 -> 0.2535 -> 0.2212 -> 0.1934 -> 0.1472。
  • Temporal Consistency:1.0000 -> 0.9703 -> 0.9291 -> 0.8903 -> 0.8163。

这说明 TCAR-Gen 的 retrieval coverage 有较强结构支撑,即使小模型也保留一定 Recall@5;但 generation faithfulness 对模型容量高度敏感。换句话说,小模型不是找不到所有证据,而是不一定能把结构化多步证据合成忠实答案。

TCARGen-fig5-radar

Figure 5 也显示不同模型上的 query difficulty 排序基本稳定:Entity Lookup 最容易,Cross-Case 最难。难度主要由结构属性决定,例如 reasoning hops 和跨文档桥接,而不是只由模型大小决定。

Limitations

  • 只评估 Victorian Crime Diaries 一个语料,外推到开放域、多领域 temporal QA、真实法律/医学时间线还需要验证。
  • VCD benchmark 是作者构造的 160-query 数据集,test 只有 120 个 query,规模偏小。
  • TCAR-Gen 有 trainable GNN,baseline 多是 inference-time 方法;虽然论文解释这是架构差异,但监督信号和开发成本并不完全对等。
  • No Context Graph 消融 Recall@5 直接为 0.0000,说明系统强依赖图 schema 和 query grounding;如果 seed extraction 或 entity linking 失败,后续模块很难恢复。
  • Cross-Case 是最弱类型,bounded expansion 容易漏掉另一个 case 子图,说明跨文档桥接仍是瓶颈。
  • 没有与已有 temporal GraphRAG / temporal KGQA 方法如 STAR-RAG 在同一数据集上直接对齐评测。
  • End-to-end latency 为 4.2s/query,高于 Vanilla RAG 的 1.1s;Chain-of-Trees 和 GNN 带来可见开销。
  • Generation faithfulness 在小模型上明显下降,说明结构化检索不能完全替代生成模型的多步合成能力。

Future Directions

  • 作者 Future Work:
    • 扩展到更大、更多样的 benchmark。
    • 改进 adaptive graph construction 和 learned weighting。
    • 扩展 temporal modelling,捕捉更丰富的 event structures。
    • 降低 reasoning overhead。
    • 与更小模型或分布式系统集成,提高可扩展性。
  • Agent 推断的 Research Opportunities:
    • 做 temporal evidence fusion diagnostic:区分失败来自 seed grounding、bounded expansion、temporal alignment、path fusion 还是 generation synthesis。
    • 把 cross-case bridge retrieval 作为专门问题:增加 alias normalization、case-to-case bridge expansion 和 multi-seed coverage constraint。
    • 在 STAR-RAG 的 temporal rule graph 和 TCAR-Gen 的 query-conditioned context graph 之间做对照:一个偏时间规则摘要,一个偏 query-specific evidence fusion。
    • 将 temporal penalty 泛化为 constraint penalty:时间、空间、因果、权限、流程都可作为 path scoring 约束。
    • 对小模型路线做两阶段系统:小模型负责 retrieval / path filtering,大模型只在 high-risk synthesis 时调用。

与本知识库的连接

一句话定位

TCAR-Gen 的核心价值是把 temporal GraphRAG 从“检索后按时间重排”推进到“查询相关子图、时间 GNN、证据级时间对齐和多分支路径融合”的统一 pipeline,说明时间一致性必须约束检索和推理两个阶段。