GGraphRAG 文献图谱自动同步
LIT-2B95BFD1 · 2026

STAR - Semantic-Tuned and Tail-Adaptive Retriever for GraphRAG

STAR 用 single-tower cross-attention 让 query 和 path 做 token-level interaction,并用 hard path mining + path-weighted contrastive loss 强化难负例和长尾路径,从而同时缓解 Semantic Shortcut Bias 和 Long-Tail Path Bias。

PDF 级阅读卡优先级 P1Shuai Li, Chen Huang, Duanyu Feng, Wenqiang Lei, See-Kiong Ng发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:知识图谱 GraphRAG 中,系统需要从 topic entity 出发找出能支撑答案的 reasoning path,再把路径交给 LLM 生成答案。
  • 为什么重要:让 LLM 自己做图遍历通常慢且贵;轻量 retriever 可以低延迟地给 LLM 提供结构化路径,但它必须在语义稀疏的 KG 上判断 query 和 path 是否逻辑匹配。
  • 对本知识库的意义:STAR 补上了 GraphRAG 中“路径检索器本身怎么训练”的一条线。它不是改图构建,也不是改 agentic planning,而是研究 path scorer 的系统性偏差,连接 GraphRAG中的Query-Complexity与结构选择、Graph搜索的完备性与Beam-Search偏差 和 GraphRAG中的Agentic轨迹质量。

Figure 1 的例子说明 semantic shortcut:问题问 David Luiz 为哪个国家效力,真正需要先走 sports.pro_athlete.teams 找球队,再找国家;但浅层语义相似会偏向 people.person.nationality,因为 country 和 nationality 看起来更接近。

Figure 2 显示 reasoning paths 呈明显长尾分布。少量高频 path 被大量训练样本覆盖,很多低频 path 几乎没有学习信号,导致 retriever 在 tail paths 上更容易失败。

  • 现有轻量 GraphRAG retriever 常用 dual encoder 或 embedding similarity,把 query 和 path 分开编码后再算相似度。
  • KG path 的语义很稀疏,通常只是实体名和关系名序列;整体相似度容易误把“文本相似”当作“逻辑正确”。
  • 训练数据中的 reasoning paths 分布长尾,普通 contrastive learning 把所有样本同等对待,会让模型过度拟合高频 head paths。
  • 现有工作更多报告 Hits@1 / F1,不一定诊断错误来自 semantic shortcut 还是 long-tail path bias。

Figure 3 把错误集合和正确集合分开统计:错误检索里 semantic shortcut 和 long-tail path 的比例更高。WebQSP 上 RoG 的 shortcut ratio 在错误样本中为 58.0%,正确样本中只有 26.0%;RD-P 在 WebQSP 错误样本中的 long-tail ratio 为 55.5%,正确样本约 17.9%。这说明两类偏差不是偶然现象,而是系统性错误来源。

方法与机制

1. 任务定义:给 query 选择最优 reasoning path

知识图谱定义为:

G=\{(e,r,e')\mid e,e'\in E,r\in R\}

给定从 query $q$ 抽取出的 topic entity $e_t$,一条 path 表示为:

p=e_t \xrightarrow{r_1} e_1 \cdots \xrightarrow{r_l} e_l

lightweight retriever 的目标是学习 scorer $p_\theta$,从候选路径集合 $P$ 中选出最优路径:

p^*=\arg\max_{p\in P}p_\theta(p\mid q,G)

输出路径 $p^*$ 进入 LLM,作为最终答案生成的结构化证据。

2. 总体框架:Token-level interaction + Path-weighted contrastive learning

Figure 4 显示 STAR 有三块:

  1. Token-Level Interaction Learning:single-tower PLM 同时读取 query 和 path,显式建模二者的 token-level interaction。
  2. Hard Path Mining:构造 hard positive paths 和 hard negative paths,让模型学习区分“语义相似但逻辑错误”的路径。
  3. Path-weighted Contrastive Learning:根据路径出现频次给样本加权,提高长尾路径训练信号。

3. Cross-attentive architecture:让 query 和 path 联合编码

输入序列为:

x=\{[CLS],[SEP],[QSP],q,[SEP],[PSP],p\}

其中 [QSP] 标记 query segment,[PSP] 标记 path segment。PLM 输出 query tokens $H_Q$、path tokens $H_P$ 和特殊 token hidden states。STAR 对 [QSP] 和 [PSP] 做 cross-attention:

Attn(q,K,V)=softmax\left(\frac{W_Q(q)\cdot W_K(K)^T}{\sqrt{d_k}}\right)V

再得到更新后的 segment 表示:

h'_{[QSP]}=Attn(h_{[QSP]},H_Q,H_Q)
h'_{[PSP]}=Attn(h_{[PSP]},H_P,H_P)

最后用 [CLS]、[QSP]、[PSP] 的组合表示输出 path relevance score:

s=\sigma(FFN(Concat(h_{[CLS]},h''_{[QSP]},h''_{[PSP]})))

输入是 query-path pair;计算是 joint PLM encoding、cross-attention、FFN scoring;输出是 path score $s$。这个设计的目的就是避免 dual encoder 只靠整体语义相似度。

4. Hard path mining:构造更有辨别力的训练样本

Hard Positive Path Curation:

  • 输入:query $q$、topic entities $E_t$、answer entities $E_a$、KG $G$、max hop $H$。
  • 先找从 topic entity 到 answer entity 的 shortest paths。
  • 对每条候选 path 计算 $sim(q,p_i)$。
  • 只保留相似度高于该 query 平均相似度的路径:
\mu_q=\frac{1}{|P_q|}\sum_{p_i\in P_q}sim(q,p_i)
P^+=\{p_i\in P_q\mid sim(q,p_i)\ge \mu_q\}

Hard Negative Path Curation:

  • 输入:positive paths $P^+$、KG $G$、similarity model $M$、negative 数量 $K$。
  • 对 positive path 中每一跳 $(e,r^+)$,取当前位置可走关系集合 $R$。
  • hard negatives 是与 $r^+$ 语义最相似的 Top-K 关系;normal negatives 是随机采样关系。
  • 输出是 semantically plausible but logically invalid 的 path variants。

5. Path-weighted contrastive learning:给长尾 path 更高学习权重

普通 hard contrastive loss 为:

L_{SHC}=-\log\frac{exp(s_{pos})}{exp(s_{pos})+\sum_{j\in N_K}exp(s_j)}

STAR 再用 graph-contextual path reweighting。path $p_i$ 的原始权重与其 occurrence count $n_i$ 的倒数有关,并按 positive / negative class size 做归一化,再缩放到 $[w^-,w^+]$,得到 $\tilde{w}_i$。

最终损失:

L_{STAR}=-\log\frac{\tilde{w}_{pos}\cdot exp(s_{pos})}{\tilde{w}_{pos}\cdot exp(s_{pos})+\sum_{j\in N_K}\tilde{w}_j\cdot exp(s_j)}

原始笔记摘录已截断;请打开来源笔记阅读完整内容。

证据与结果

1. 主结果:STAR 同时提高检索准确率和生成 F1

Table 2 在 WebQSP、CWQ、GrailQA 上比较 LLM without KG、LLM-centric retriever 和 lightweight retriever。STAR 在三组数据上均取得最高 Hits@1:

  • WebQSP:88.7 Hits@1 / 74.1 F1 / 0.9s RT。
  • CWQ:86.3 Hits@1 / 69.1 F1 / 1.2s RT。
  • GrailQA:80.4 Hits@1 / 76.3 F1 / 1.1s RT。

论文报告 STAR 相比基线平均 Hits@1 提升 1.8%,LLM QA F1 提升 2.2%。关键点不只是分数最高,而是 RT 接近 RD-P 这类轻量方法,同时明显快于 Graph CoT 这类 LLM-centric retriever。

2. 消融:token-level interaction 主要缓解 semantic shortcut

Table 3 显示,把 similarity-based dual encoder 换成 cross-attentive architecture 后,WebQSP 和 CWQ 上 error 明显下降;加入 hard path mining 后继续小幅下降。一个重要现象是:BERT 这类不是为 sentence similarity 优化的 backbone,在 similarity-based 设置下错误率明显升高,而 cross-attention + HPM 更稳定,说明 token-level interaction 减少了对 backbone embedding 质量的依赖。

3. 消融:path weighting 主要缓解 long-tail path bias

Table 4 显示,在 cross-attentive retriever 上加入 path weighting 后,WebQSP long-tail error 从 6.7 降到 5.8,CWQ 从 3.8 降到 3.2。完整 STAR 进一步降低 shortcut error,同时保持长尾收益,说明 hard mining 和 path weighting 是互补关系。

4. 下游 LLM 和 top-K:路径质量能稳定提升不同生成器

STAR 输出路径后,不同 LLM 都能获得明显 F1 提升。例如 DeepSeek-R1-70B + STAR 在 WebQSP / CWQ / GrailQA 上达到 86.3 / 70.0 / 78.2 F1。

Table 6 显示 top-K path 增加会继续提高 Hits@1:WebQSP 从 K=1 的 88.7 到 K=7 的 95.2;GrailQA 从 80.1 到 89.8。这说明 STAR 通常能把正确 path 放进候选集,但 top-1 排序仍有进一步优化空间。

5. Case study:STAR 能看 query 和 relation token 的逻辑对应

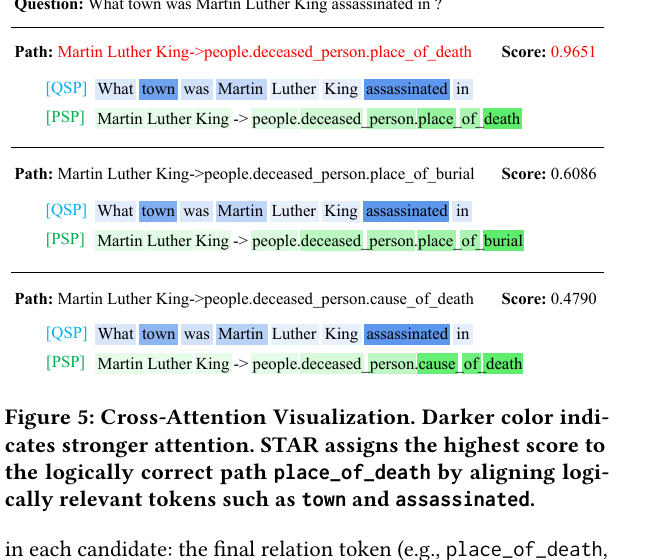
Figure 5 中,问题问 Martin Luther King 被刺杀在哪个 town。place_of_burial 和 cause_of_death 都与死亡语义有关,但正确路径是 place_of_death。STAR 的 attention 更集中在 query token town、assassinated 和 path token place_of_death 上,因此能避开表面相似但逻辑错误的路径。

局限与开放问题

  • STAR 依赖已有 KG 和 topic entity linking;如果初始实体识别错或 KG 缺边,path scorer 无法恢复不存在的候选路径。

  • 方法主要评估 WebQSP、CWQ、GrailQA 这类 KGQA 数据,和文档型 GraphRAG、代码库 GraphRAG、长文档 evidence graph 的迁移关系还需要验证。

  • hard positive path 通过 shortest paths + semantic threshold 构造,可能漏掉非最短但更符合真实推理的路径。

  • path weighting 使用频次倒数处理长尾,但没有直接建模 path difficulty、答案歧义或 schema type constraints。

  • Top-K 结果显示正确路径常在候选集中但不一定 top-1,说明 reranking 和 path calibration 仍有空间。

  • 作者 Future Work:继续探索更高级的 graph-aware mechanism 和 representation learning,让模型更充分利用 sparse graph semantics。

  • Agent 推断的 Research Opportunities:

    • 把 semantic shortcut / long-tail path bias 加入 GraphRAG 检索诊断指标,不只报告 Hits@K。
    • 在 BERDG-RAG / QueryShift 类方法中引入 hard path mining:构造语义相近但 support set 错误的 hard negatives。
    • 将 path frequency、path difficulty 和 answerability signal 一起用于 retrieval loss weighting。
    • 把 STAR 的 token-level path scorer 与 A2RAG - Adaptive Agentic Graph Retrieval 的阶段式检索结合:easy query 用轻量 path scorer,hard query 再触发 bridge / PPR / agentic search。
    • 在 GraphRAG中的Agentic轨迹质量 中加入 path-level calibration:正确 path 是否只是出现在 top-K,还是被稳定排到 top-1。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q5 动态状态与学习策略

展开原始论文笔记全文

基本信息

  • 英文标题:STAR: Semantic-Tuned and Tail-Adaptive Retriever for Graph-Augmented Generation
  • 中文标题:STAR:面向 GraphRAG 的语义调优与长尾自适应检索器
  • 作者:Shuai Li, Chen Huang, Duanyu Feng, Wenqiang Lei, See-Kiong Ng
  • 年份:2026
  • 版本:arXiv v1,2026-04-11
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码:论文给出匿名仓库 https://anonymous.4open.science/r/STAR-C583
  • 阅读状态:PDF级
  • 所属方向:lightweight GraphRAG retriever、path retrieval、retrieval bias、contrastive learning
  • 优先级:P1

Background

  • 研究问题:知识图谱 GraphRAG 中,系统需要从 topic entity 出发找出能支撑答案的 reasoning path,再把路径交给 LLM 生成答案。
  • 为什么重要:让 LLM 自己做图遍历通常慢且贵;轻量 retriever 可以低延迟地给 LLM 提供结构化路径,但它必须在语义稀疏的 KG 上判断 query 和 path 是否逻辑匹配。
  • 对本知识库的意义:STAR 补上了 GraphRAG 中“路径检索器本身怎么训练”的一条线。它不是改图构建,也不是改 agentic planning,而是研究 path scorer 的系统性偏差,连接 GraphRAG中的Query-Complexity与结构选择、Graph搜索的完备性与Beam-Search偏差 和 GraphRAG中的Agentic轨迹质量。

STAR-fig1-semantic-shortcut

Figure 1 的例子说明 semantic shortcut:问题问 David Luiz 为哪个国家效力,真正需要先走 sports.pro_athlete.teams 找球队,再找国家;但浅层语义相似会偏向 people.person.nationality,因为 country 和 nationality 看起来更接近。

STAR-fig2-long-tail-distribution

Figure 2 显示 reasoning paths 呈明显长尾分布。少量高频 path 被大量训练样本覆盖,很多低频 path 几乎没有学习信号,导致 retriever 在 tail paths 上更容易失败。

Gap

  • 现有轻量 GraphRAG retriever 常用 dual encoder 或 embedding similarity,把 query 和 path 分开编码后再算相似度。
  • KG path 的语义很稀疏,通常只是实体名和关系名序列;整体相似度容易误把“文本相似”当作“逻辑正确”。
  • 训练数据中的 reasoning paths 分布长尾,普通 contrastive learning 把所有样本同等对待,会让模型过度拟合高频 head paths。
  • 现有工作更多报告 Hits@1 / F1,不一定诊断错误来自 semantic shortcut 还是 long-tail path bias。

STAR-fig3-bias-analysis

Figure 3 把错误集合和正确集合分开统计:错误检索里 semantic shortcut 和 long-tail path 的比例更高。WebQSP 上 RoG 的 shortcut ratio 在错误样本中为 58.0%,正确样本中只有 26.0%;RD-P 在 WebQSP 错误样本中的 long-tail ratio 为 55.5%,正确样本约 17.9%。这说明两类偏差不是偶然现象,而是系统性错误来源。

Insight

  • 一句话创新点:STAR 用 single-tower cross-attention 让 query 和 path 做 token-level interaction,并用 hard path mining + path-weighted contrastive loss 强化难负例和长尾路径,从而同时缓解 Semantic Shortcut Bias 和 Long-Tail Path Bias。
  • 核心洞察:
    • path retrieval 不能只看 query-path 整体 embedding 相似度,而要看 query token 与 relation token 的细粒度对齐。
    • 负样本不应只是 random walk,还应包含“语义很像但逻辑错误”的 hard negative path。
    • 长尾路径需要更高训练权重,否则模型会在高频路径上表现好,在少见推理模式上失败。
    • 轻量 retriever 的价值在于接近 LLM-centric retriever 的准确率,同时保持秒级路径检索。

Method

1. 任务定义:给 query 选择最优 reasoning path

知识图谱定义为:

G=\{(e,r,e')\mid e,e'\in E,r\in R\}

给定从 query $q$ 抽取出的 topic entity $e_t$,一条 path 表示为:

p=e_t \xrightarrow{r_1} e_1 \cdots \xrightarrow{r_l} e_l

lightweight retriever 的目标是学习 scorer $p_\theta$,从候选路径集合 $P$ 中选出最优路径:

p^*=\arg\max_{p\in P}p_\theta(p\mid q,G)

输出路径 $p^*$ 进入 LLM,作为最终答案生成的结构化证据。

2. 总体框架:Token-level interaction + Path-weighted contrastive learning

STAR-fig4-method-overview

Figure 4 显示 STAR 有三块:

  1. Token-Level Interaction Learning:single-tower PLM 同时读取 query 和 path,显式建模二者的 token-level interaction。
  2. Hard Path Mining:构造 hard positive paths 和 hard negative paths,让模型学习区分“语义相似但逻辑错误”的路径。
  3. Path-weighted Contrastive Learning:根据路径出现频次给样本加权,提高长尾路径训练信号。

3. Cross-attentive architecture:让 query 和 path 联合编码

输入序列为:

x=\{[CLS],[SEP],[QSP],q,[SEP],[PSP],p\}

其中 [QSP] 标记 query segment,[PSP] 标记 path segment。PLM 输出 query tokens $H_Q$、path tokens $H_P$ 和特殊 token hidden states。STAR 对 [QSP] 和 [PSP] 做 cross-attention:

Attn(q,K,V)=softmax\left(\frac{W_Q(q)\cdot W_K(K)^T}{\sqrt{d_k}}\right)V

再得到更新后的 segment 表示:

h'_{[QSP]}=Attn(h_{[QSP]},H_Q,H_Q)
h'_{[PSP]}=Attn(h_{[PSP]},H_P,H_P)

最后用 [CLS]、[QSP]、[PSP] 的组合表示输出 path relevance score:

s=\sigma(FFN(Concat(h_{[CLS]},h''_{[QSP]},h''_{[PSP]})))

输入是 query-path pair;计算是 joint PLM encoding、cross-attention、FFN scoring;输出是 path score $s$。这个设计的目的就是避免 dual encoder 只靠整体语义相似度。

4. Hard path mining:构造更有辨别力的训练样本

STAR-algorithms-hard-path-curation

Hard Positive Path Curation:

  • 输入:query $q$、topic entities $E_t$、answer entities $E_a$、KG $G$、max hop $H$。
  • 先找从 topic entity 到 answer entity 的 shortest paths。
  • 对每条候选 path 计算 $sim(q,p_i)$。
  • 只保留相似度高于该 query 平均相似度的路径:
\mu_q=\frac{1}{|P_q|}\sum_{p_i\in P_q}sim(q,p_i)
P^+=\{p_i\in P_q\mid sim(q,p_i)\ge \mu_q\}

Hard Negative Path Curation:

  • 输入:positive paths $P^+$、KG $G$、similarity model $M$、negative 数量 $K$。
  • 对 positive path 中每一跳 $(e,r^+)$,取当前位置可走关系集合 $R$。
  • hard negatives 是与 $r^+$ 语义最相似的 Top-K 关系;normal negatives 是随机采样关系。
  • 输出是 semantically plausible but logically invalid 的 path variants。

5. Path-weighted contrastive learning:给长尾 path 更高学习权重

普通 hard contrastive loss 为:

L_{SHC}=-\log\frac{exp(s_{pos})}{exp(s_{pos})+\sum_{j\in N_K}exp(s_j)}

STAR 再用 graph-contextual path reweighting。path $p_i$ 的原始权重与其 occurrence count $n_i$ 的倒数有关,并按 positive / negative class size 做归一化,再缩放到 $[w^-,w^+]$,得到 $\tilde{w}_i$。

最终损失:

L_{STAR}=-\log\frac{\tilde{w}_{pos}\cdot exp(s_{pos})}{\tilde{w}_{pos}\cdot exp(s_{pos})+\sum_{j\in N_K}\tilde{w}_j\cdot exp(s_j)}

输入是 hard-mined positives / negatives 和 path frequency;计算是加权对比学习;输出是更关注 rare positive paths 的 path scorer。

STAR-algorithm3-inference

推理从 topic entity 出发,在每一步展开当前实体可走关系集合 $R$,并加入特殊关系 [EOP] 表示路径结束。STAR 对候选扩展打分,只保留 top-B 路径进入下一步。结束后选择 top-K finished paths 交给 LLM 生成答案。

输入是 query、topic entities、KG、trained STAR、max hop、beam width;计算是 score-guided beam search;输出是供 LLM 使用的 top reasoning paths。

Results

1. 主结果:STAR 同时提高检索准确率和生成 F1

STAR-table2-main-results

Table 2 在 WebQSP、CWQ、GrailQA 上比较 LLM without KG、LLM-centric retriever 和 lightweight retriever。STAR 在三组数据上均取得最高 Hits@1:

  • WebQSP:88.7 Hits@1 / 74.1 F1 / 0.9s RT。
  • CWQ:86.3 Hits@1 / 69.1 F1 / 1.2s RT。
  • GrailQA:80.4 Hits@1 / 76.3 F1 / 1.1s RT。

论文报告 STAR 相比基线平均 Hits@1 提升 1.8%,LLM QA F1 提升 2.2%。关键点不只是分数最高,而是 RT 接近 RD-P 这类轻量方法,同时明显快于 Graph CoT 这类 LLM-centric retriever。

2. 消融:token-level interaction 主要缓解 semantic shortcut

STAR-table3-token-interaction-ablation

Table 3 显示,把 similarity-based dual encoder 换成 cross-attentive architecture 后,WebQSP 和 CWQ 上 error 明显下降;加入 hard path mining 后继续小幅下降。一个重要现象是:BERT 这类不是为 sentence similarity 优化的 backbone,在 similarity-based 设置下错误率明显升高,而 cross-attention + HPM 更稳定,说明 token-level interaction 减少了对 backbone embedding 质量的依赖。

3. 消融:path weighting 主要缓解 long-tail path bias

STAR-table4-path-weighted-ablation

Table 4 显示,在 cross-attentive retriever 上加入 path weighting 后,WebQSP long-tail error 从 6.7 降到 5.8,CWQ 从 3.8 降到 3.2。完整 STAR 进一步降低 shortcut error,同时保持长尾收益,说明 hard mining 和 path weighting 是互补关系。

4. 下游 LLM 和 top-K:路径质量能稳定提升不同生成器

STAR-table5-llm-generators

STAR 输出路径后,不同 LLM 都能获得明显 F1 提升。例如 DeepSeek-R1-70B + STAR 在 WebQSP / CWQ / GrailQA 上达到 86.3 / 70.0 / 78.2 F1。

STAR-table6-topk

Table 6 显示 top-K path 增加会继续提高 Hits@1:WebQSP 从 K=1 的 88.7 到 K=7 的 95.2;GrailQA 从 80.1 到 89.8。这说明 STAR 通常能把正确 path 放进候选集,但 top-1 排序仍有进一步优化空间。

5. Case study:STAR 能看 query 和 relation token 的逻辑对应

STAR-fig5-cross-attention-case

Figure 5 中,问题问 Martin Luther King 被刺杀在哪个 town。place_of_burial 和 cause_of_death 都与死亡语义有关,但正确路径是 place_of_death。STAR 的 attention 更集中在 query token town、assassinated 和 path token place_of_death 上,因此能避开表面相似但逻辑错误的路径。

Limitations

  • STAR 依赖已有 KG 和 topic entity linking;如果初始实体识别错或 KG 缺边,path scorer 无法恢复不存在的候选路径。
  • 方法主要评估 WebQSP、CWQ、GrailQA 这类 KGQA 数据,和文档型 GraphRAG、代码库 GraphRAG、长文档 evidence graph 的迁移关系还需要验证。
  • hard positive path 通过 shortest paths + semantic threshold 构造,可能漏掉非最短但更符合真实推理的路径。
  • path weighting 使用频次倒数处理长尾,但没有直接建模 path difficulty、答案歧义或 schema type constraints。
  • Top-K 结果显示正确路径常在候选集中但不一定 top-1,说明 reranking 和 path calibration 仍有空间。

Future Directions

  • 作者 Future Work:继续探索更高级的 graph-aware mechanism 和 representation learning,让模型更充分利用 sparse graph semantics。
  • Agent 推断的 Research Opportunities:
    • 把 semantic shortcut / long-tail path bias 加入 GraphRAG 检索诊断指标,不只报告 Hits@K。
    • 在 BERDG-RAG / QueryShift 类方法中引入 hard path mining:构造语义相近但 support set 错误的 hard negatives。
    • 将 path frequency、path difficulty 和 answerability signal 一起用于 retrieval loss weighting。
    • 把 STAR 的 token-level path scorer 与 A2RAG - Adaptive Agentic Graph Retrieval 的阶段式检索结合:easy query 用轻量 path scorer,hard query 再触发 bridge / PPR / agentic search。
    • 在 GraphRAG中的Agentic轨迹质量 中加入 path-level calibration:正确 path 是否只是出现在 top-K,还是被稳定排到 top-1。

与本知识库的连接

一句话定位

STAR 的核心价值是把 GraphRAG 的轻量路径检索问题从“算 query-path 相似度”推进到“诊断并训练消除路径偏差”:用 token-level interaction 抵抗语义捷径,用 path-weighted contrastive learning 提高长尾路径鲁棒性。