GGraphRAG 文献图谱自动同步
LIT-2123044E · 2026

TechGraphRAG - Agentic Graph-Augmented RAG Framework

把技术文献推理组织成多步骤 agentic pipeline,并用 evidence sufficiency rubric 驱动外部搜索、KG 遍历和再生成。

PDF 级阅读卡优先级 P0Kanwar Bharat Singh发表信息待核验
内容状态:PDF 级阅读卡。结构化摘录继承当前知识库的来源等级;具体 claim 应回到一手论文核验。

研究问题与动机

  • 研究问题:技术文献问答需要跨论文、跨概念、跨引用关系整合证据,单轮 RAG 容易证据不足。

  • 为什么重要:科研知识库场景天然需要外部学术检索、引用校验、KG 遍历和答案质量检查。

  • 现有方法:常规 RAG 多为单次检索;GraphRAG 强调结构化图索引;Self-RAG / CRAG 引入检索自评或纠错,但不一定把本地检索、外部学术搜索、知识图谱、引用校验和质量检查统一成可审计流程。

  • 单次检索无法保证证据充分。

  • 外部学术数据库检索、KG 遍历和 citation integrity 往往割裂。

  • 缺少可执行的证据充分性评分和自动重试机制。

  • 对科研知识库而言,只给最终答案不够,还需要展示检索状态、证据强度、外部补充来源、引用校验和成本。

方法与机制

  • 整体框架:offline indexing + query-time 13-step agentic pipeline。离线阶段完成 PDF 解析、结构化 chunking、embedding、BM25/FAISS、实体抽取和 Neo4j KG 构建;在线阶段按 query route 执行 evidence gathering 与 answer verification。
  • 模块分解:
    • Query Classification:将查询分为 content、bibliometric、trend、current_world。
    • Query Rewrite:GPT-4o-mini 改写成更适合检索的技术查询。
    • Local Retrieval:FAISS semantic retrieval + BM25 keyword retrieval,经 Reciprocal Rank Fusion 合并,再用 cross-encoder rerank。
    • Evidence Sufficiency Scoring:100 分 rubric 判断本地证据是否足够。
    • Agentic Retry:若 evidence 为 WEAK,做 query reformulation、drift guard、二次 hybrid check。
    • External Search:按 route 调 Crossref、OpenAlex、Semantic Scholar;使用 optimize-search-vet-reformulate 循环。
    • Knowledge Graph Traversal:Neo4j 中查 related papers、co-citing papers、author lookup。
    • Build Augmented Prompt:合并本地 chunks、外部 abstracts 和 graph context。
    • Citation Verification:生成前检查 source coverage、source contradiction 和 attribution issue。
    • Generate Answer:答案模型只基于 assembled evidence 生成。
    • Quality Check:GPT-4o-mini 检查回答是否回答问题、是否引用、是否 grounded、是否有明显 gap;必要时自动再生成一次。
    • Cost Tracking:记录 token 和 cost。
  • Evidence Sufficiency 100 分 rubric:
    • Retrieval Confidence:40 分,主要看 cross-encoder reranker 的 top chunks 是否相关。
    • Answer Specificity:25 分,是否包含具体数据、方法、公式、结果。
    • Source Diversity:15 分,是否来自多个不同论文。
    • Metadata Completeness:10 分,是否有 section labels、page numbers、year。
    • Recency / Intent Fit:10 分,是否满足 query 的时效性要求。
  • Evidence 阈值:
    • 80-100 STRONG:只用内部 corpus 回答,跳过外部搜索。
    • 50-79 MODERATE:用内部 corpus 回答,可补外部来源。
    • 0-49 WEAK:触发 agentic retry,然后外部学术搜索。
  • 训练目标:没有新的模型训练目标;这是一个工程系统架构与评估论文。
  • 推理流程:
    1. 用户输入 query。
    2. 判断 route 并改写 query。
    3. 对 content query 先做本地 hybrid retrieval。
    4. 对本地证据打 evidence sufficiency 分数。
    5. WEAK 时重写并二次检索;MODERATE/WEAK 时补外部学术搜索。
    6. Neo4j 补充 related / co-citing / author context。
    7. 生成前做 citation verification。
    8. 生成后做 quality check,失败则带 critique 自动重生成一次。
  • Method Figure 解读:

Figure 1 和 Table 2 把系统分成两个 loop。Loop 1 是 Evidence Gathering:先决定 query 类型,再做本地检索、证据充分性评分、必要时重试和外部学术搜索,最后用 Neo4j 补关系上下文。Loop 2 是 Answer Curation & Verification:把证据合并成 prompt,先做引用校验,再生成答案,最后做质量检查和可选再生成。它和普通 GraphRAG 的区别是:图只是证据来源之一,控制流由 evidence sufficiency 决定。

证据与结果

  • 典型成本:

强本地证据 query 约 $0.0006;带 1 次外部搜索的 full pipeline 约 $0.003;3 次外部搜索约 $0.005;premium model answer 约 $0.008。这个成本表适合估算科研知识库工作流的 query-time 运行成本,但依赖当前 OpenAI/API 价格和模型设置。

  • Route-level evaluation:

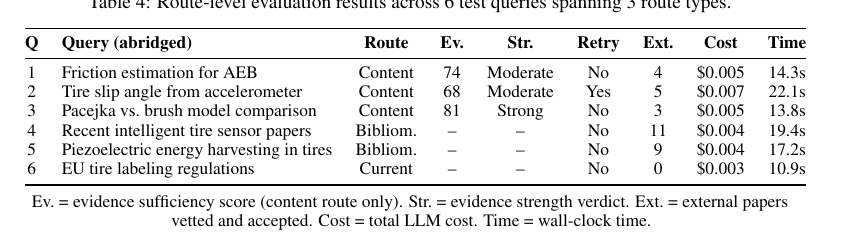
作者用 6 条代表性查询测试 content、bibliometric、current_world 三类 route。6/6 route classification 正确;3 条 content query 的 evidence score 为 68、74、81;其中最低分 68 的 query 触发 retry。总成本 $0.027,平均 $0.0045/query;耗时 10.9s 到 22.1s,平均 16.4s。

  • Retrieval ablation:

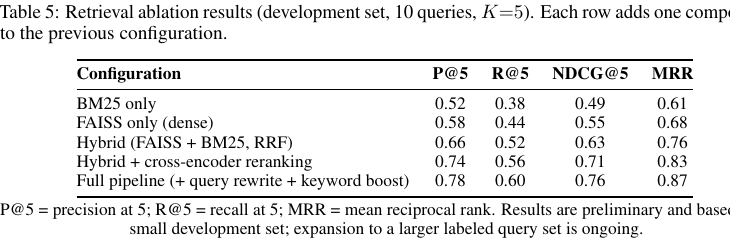
10 条 development queries、K=5 的小规模 ablation 显示:BM25 P@5=0.52,FAISS P@5=0.58,Hybrid=0.66,Hybrid+cross-encoder=0.74,Full pipeline=0.78。最大单步提升来自 cross-encoder reranking;query rewrite + keyword boost 继续带来小幅增益。

  • 与强 baseline 的差异:
    • 这篇不是 SOTA benchmark 论文,而是 domain-specific agentic RAG 系统案例。
    • 结果主要证明系统可运行、成本可记录、route/evidence control 可解释。
    • route-level evaluation 只有 6 条 query,retrieval ablation 只有 10 条 query,不能作为强统计结论。

局限与开放问题

  • 13 步 pipeline 可能成本高、实现复杂。

  • evidence sufficiency rubric 是否可迁移到通用 QA 需要验证。

  • 外部搜索依赖 Crossref、OpenAlex、Semantic Scholar 等服务,复现稳定性需要检查。

  • 语料是 proprietary corpus,不能公开复现实验数据。

  • route-level evaluation 和 retrieval ablation 样本很小,缺少统计显著性。

  • Step 3 evidence sufficiency reviewer 和 Step 11 quality checker 都依赖 GPT-4o-mini,存在 LLM-as-judge 偏差。

  • 当前 pipeline 只处理 PDF 文本,不抽取/索引图片、表格、图表和公式图片;这对工程论文是重要限制。

  • 作者 Future Work:

    • 把 figures、tables、charts、diagrams 等视觉内容纳入 multimodal RAG。
    • 用本地 open-weight models 替换云端 LLM API,降低成本和隐私风险。
    • 引入 human-in-the-loop feedback,持续优化检索排序、prompt 和 evidence sufficiency thresholds。
    • 扩大 labeled query set,做更完整的 retrieval ablation 和统计检验。
  • Agent 推断的 Research Opportunities:

    • 将 evidence sufficiency rubric 简化成可训练 controller。
    • 将学术搜索工作流迁移到本 Obsidian 知识库的增量发现 Agent。
    • 用 citation integrity 作为 GraphRAG faithfulness 的评测维度。
    • 把 Paper Pool -> Paper Card -> Trend Report -> Open Problems 直接实现成类似 TechGraphRAG 的 route-dependent workflow。
    • 设计“科研知识库质量仪表盘”:覆盖 paper freshness、citation grounding、evidence sufficiency、open-problem traceability。

关联与拓展

研究问题入口

Q1 领域边界与适用性, Q2 图构建与表示, Q3 证据检索与集合形成, Q4 查询规划与执行, Q6 证据来源与可解释性

展开原始论文笔记全文

基本信息

  • 英文标题:TechGraphRAG: An Agentic Graph-Augmented RAG Framework for Technical Literature Reasoning
  • 中文标题:面向技术文献推理的 Agentic Graph-Augmented RAG 框架
  • 作者:Kanwar Bharat Singh
  • 机构:Global Tire Intelligence and Solutions (GTIS), The Goodyear Tire & Rubber Company
  • 年份:2026
  • 链接:arXiv
  • PDF:查看论文原文
  • 代码链接:待补充
  • 阅读状态:PDF级
  • 所属方向:Agentic GraphRAG、技术文献推理、证据充分性
  • 优先级:P0 精读

Background

  • 研究问题:技术文献问答需要跨论文、跨概念、跨引用关系整合证据,单轮 RAG 容易证据不足。
  • 为什么重要:科研知识库场景天然需要外部学术检索、引用校验、KG 遍历和答案质量检查。
  • 现有方法:常规 RAG 多为单次检索;GraphRAG 强调结构化图索引;Self-RAG / CRAG 引入检索自评或纠错,但不一定把本地检索、外部学术搜索、知识图谱、引用校验和质量检查统一成可审计流程。

Gap

  • 单次检索无法保证证据充分。
  • 外部学术数据库检索、KG 遍历和 citation integrity 往往割裂。
  • 缺少可执行的证据充分性评分和自动重试机制。
  • 对科研知识库而言,只给最终答案不够,还需要展示检索状态、证据强度、外部补充来源、引用校验和成本。

Insight

  • 一句话创新点:把技术文献推理组织成多步骤 agentic pipeline,并用 evidence sufficiency rubric 驱动外部搜索、KG 遍历和再生成。
  • 核心洞察:GraphRAG 在科研场景中更像一个证据工作流,而不只是一个检索器;真正关键的是“何时相信本地库、何时外部搜索、何时重试、何时声明证据不足”。

Method

  • 整体框架:offline indexing + query-time 13-step agentic pipeline。离线阶段完成 PDF 解析、结构化 chunking、embedding、BM25/FAISS、实体抽取和 Neo4j KG 构建;在线阶段按 query route 执行 evidence gathering 与 answer verification。
  • 模块分解:
    • Query Classification:将查询分为 content、bibliometric、trend、current_world。
    • Query Rewrite:GPT-4o-mini 改写成更适合检索的技术查询。
    • Local Retrieval:FAISS semantic retrieval + BM25 keyword retrieval,经 Reciprocal Rank Fusion 合并,再用 cross-encoder rerank。
    • Evidence Sufficiency Scoring:100 分 rubric 判断本地证据是否足够。
    • Agentic Retry:若 evidence 为 WEAK,做 query reformulation、drift guard、二次 hybrid check。
    • External Search:按 route 调 Crossref、OpenAlex、Semantic Scholar;使用 optimize-search-vet-reformulate 循环。
    • Knowledge Graph Traversal:Neo4j 中查 related papers、co-citing papers、author lookup。
    • Build Augmented Prompt:合并本地 chunks、外部 abstracts 和 graph context。
    • Citation Verification:生成前检查 source coverage、source contradiction 和 attribution issue。
    • Generate Answer:答案模型只基于 assembled evidence 生成。
    • Quality Check:GPT-4o-mini 检查回答是否回答问题、是否引用、是否 grounded、是否有明显 gap;必要时自动再生成一次。
    • Cost Tracking:记录 token 和 cost。
  • Evidence Sufficiency 100 分 rubric:
    • Retrieval Confidence:40 分,主要看 cross-encoder reranker 的 top chunks 是否相关。
    • Answer Specificity:25 分,是否包含具体数据、方法、公式、结果。
    • Source Diversity:15 分,是否来自多个不同论文。
    • Metadata Completeness:10 分,是否有 section labels、page numbers、year。
    • Recency / Intent Fit:10 分,是否满足 query 的时效性要求。
  • Evidence 阈值:
    • 80-100 STRONG:只用内部 corpus 回答,跳过外部搜索。
    • 50-79 MODERATE:用内部 corpus 回答,可补外部来源。
    • 0-49 WEAK:触发 agentic retry,然后外部学术搜索。
  • 训练目标:没有新的模型训练目标;这是一个工程系统架构与评估论文。
  • 推理流程:
    1. 用户输入 query。
    2. 判断 route 并改写 query。
    3. 对 content query 先做本地 hybrid retrieval。
    4. 对本地证据打 evidence sufficiency 分数。
    5. WEAK 时重写并二次检索;MODERATE/WEAK 时补外部学术搜索。
    6. Neo4j 补充 related / co-citing / author context。
    7. 生成前做 citation verification。
    8. 生成后做 quality check,失败则带 critique 自动重生成一次。
  • Method Figure 解读:

TechGraphRAG-pipeline-and-stages

Figure 1 和 Table 2 把系统分成两个 loop。Loop 1 是 Evidence Gathering:先决定 query 类型,再做本地检索、证据充分性评分、必要时重试和外部学术搜索,最后用 Neo4j 补关系上下文。Loop 2 是 Answer Curation & Verification:把证据合并成 prompt,先做引用校验,再生成答案,最后做质量检查和可选再生成。它和普通 GraphRAG 的区别是:图只是证据来源之一,控制流由 evidence sufficiency 决定。

Results

  • 典型成本:

TechGraphRAG-table3-costs

强本地证据 query 约 $0.0006;带 1 次外部搜索的 full pipeline 约 $0.003;3 次外部搜索约 $0.005;premium model answer 约 $0.008。这个成本表适合估算科研知识库工作流的 query-time 运行成本,但依赖当前 OpenAI/API 价格和模型设置。

  • Route-level evaluation:

TechGraphRAG-table4-route-eval

作者用 6 条代表性查询测试 content、bibliometric、current_world 三类 route。6/6 route classification 正确;3 条 content query 的 evidence score 为 68、74、81;其中最低分 68 的 query 触发 retry。总成本 $0.027,平均 $0.0045/query;耗时 10.9s 到 22.1s,平均 16.4s。

  • Retrieval ablation:

TechGraphRAG-table5-retrieval-ablation

10 条 development queries、K=5 的小规模 ablation 显示:BM25 P@5=0.52,FAISS P@5=0.58,Hybrid=0.66,Hybrid+cross-encoder=0.74,Full pipeline=0.78。最大单步提升来自 cross-encoder reranking;query rewrite + keyword boost 继续带来小幅增益。

  • 与强 baseline 的差异:
    • 这篇不是 SOTA benchmark 论文,而是 domain-specific agentic RAG 系统案例。
    • 结果主要证明系统可运行、成本可记录、route/evidence control 可解释。
    • route-level evaluation 只有 6 条 query,retrieval ablation 只有 10 条 query,不能作为强统计结论。

Limitations

  • 13 步 pipeline 可能成本高、实现复杂。
  • evidence sufficiency rubric 是否可迁移到通用 QA 需要验证。
  • 外部搜索依赖 Crossref、OpenAlex、Semantic Scholar 等服务,复现稳定性需要检查。
  • 语料是 proprietary corpus,不能公开复现实验数据。
  • route-level evaluation 和 retrieval ablation 样本很小,缺少统计显著性。
  • Step 3 evidence sufficiency reviewer 和 Step 11 quality checker 都依赖 GPT-4o-mini,存在 LLM-as-judge 偏差。
  • 当前 pipeline 只处理 PDF 文本,不抽取/索引图片、表格、图表和公式图片;这对工程论文是重要限制。

Future Directions

  • 作者 Future Work:
    • 把 figures、tables、charts、diagrams 等视觉内容纳入 multimodal RAG。
    • 用本地 open-weight models 替换云端 LLM API,降低成本和隐私风险。
    • 引入 human-in-the-loop feedback,持续优化检索排序、prompt 和 evidence sufficiency thresholds。
    • 扩大 labeled query set,做更完整的 retrieval ablation 和统计检验。
  • Agent 推断的 Research Opportunities:
    • 将 evidence sufficiency rubric 简化成可训练 controller。
    • 将学术搜索工作流迁移到本 Obsidian 知识库的增量发现 Agent。
    • 用 citation integrity 作为 GraphRAG faithfulness 的评测维度。
    • 把 Paper Pool -> Paper Card -> Trend Report -> Open Problems 直接实现成类似 TechGraphRAG 的 route-dependent workflow。
    • 设计“科研知识库质量仪表盘”:覆盖 paper freshness、citation grounding、evidence sufficiency、open-problem traceability。

与本知识库的连接

本卡片待补

  • 检查作者是否公开代码或系统 demo。
  • 把 evidence sufficiency rubric 转成可复用模板,供本 Obsidian 工作流使用。
  • 设计适合本知识库的 route-level evaluation set,至少覆盖 content、bibliometric、trend、gap-mining 四类 query。