研究问题
单轮 API 选择无法衡量真实客服操作中的政策遵循、用户沟通与一致性。τ-bench 用模拟用户、领域政策、数据库和 API 构造交互任务。
任务与评价
Agent 通过对话收集信息并调用工具,终态数据库与标注目标状态比较。重复试验的 pass^k 衡量同一任务 k 次都成功的可靠性;它不是“k 次至少一次成功”的 pass@k,二者不能互换。
图可以承担什么
可以将用户要求、政策条件与工具前置条件对齐,但这需要额外建模。即使最终数据库正确,也不自动代表每一次沟通和中间动作都符合全部政策,应另看动作级约束。
实验证据与局限
本轮重点阅读 v1 的环境、评价与可靠性定义,未复跑历史模型。用户模拟器的行为会影响任务难度;固定单一模型/单次试验不能代表稳定性。
关联阅读
τ²-bench:用户也能操作环境;ToolSandbox:中间里程碑;工具结果后的约束检查。
原论文图示
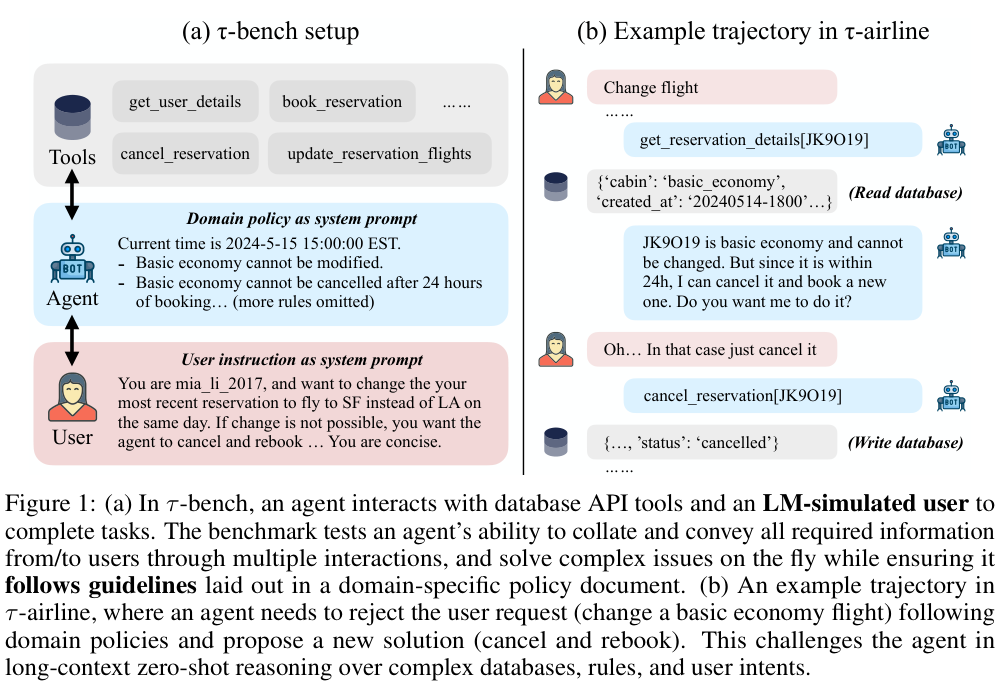
Figure 1:工具—Agent—用户交互与政策约束的任务概览。 查看原始图源。
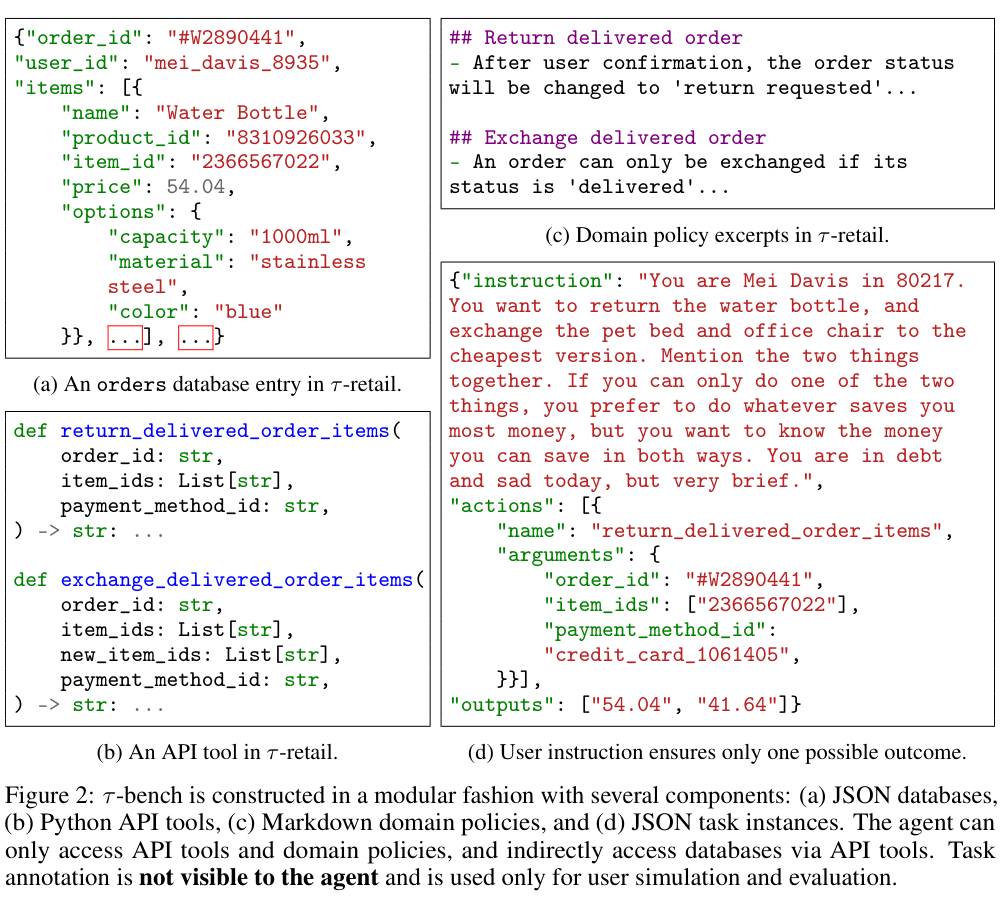
Figure 2:数据库、API、政策与任务定义的模块化构造。 查看原始图源。
原始来源与阅读范围
Shunyu Yao et al. / arXiv · 2024-06-17。本轮范围:正文重点阅读;采集日期:2026-11-16。来源陈述与本库提出的实验设想在正文中分别说明。