研究问题
增加多个 Agent 不一定显著改善任务表现。论文通过执行轨迹研究失败如何发生,提供 MAST 分类与 MAST-Data。
方法与数据
正文从人工分析与标注一致性出发形成分类,再用 LLM 标注扩展。v3 描述超过 1600 条轨迹、7 类框架及 14 种失败模式,归为系统设计、Agent 间 misalignment 和任务验证三类。
图在本库中可以用于对齐任务、信息与执行依赖,但论文不是“用图修复这些错误”的实验证据。尤其是缺少检查、隐式假设冲突或错误终止,不一定靠增加通信边解决。
如何用于研究设计
先标注失败来自任务分解、信息缺失、状态冲突还是错误验收,再针对其中一类提出图机制。报告修复前后各类失败的变化,而不只给总成功率。
证据边界
本轮读 v3 的分类、数据构建、案例与讨论,没有重新标注数据或验证 LLM judge。论文的失败分布属于其采集系统和任务,不能直接当作本库新环境的发生率。
关联阅读
Cognition 的隐式决策冲突;Anthropic 的并行收益与协调成本;社区争议。
原论文图示
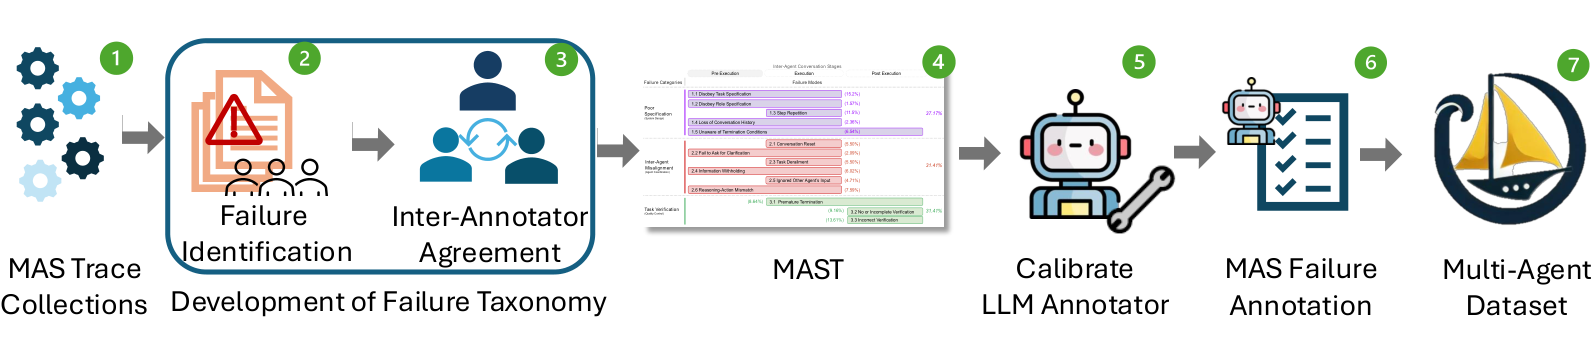
Figure 2:失败分类与 MAST-Data 的构建流程(方法图)。 查看原始图源。

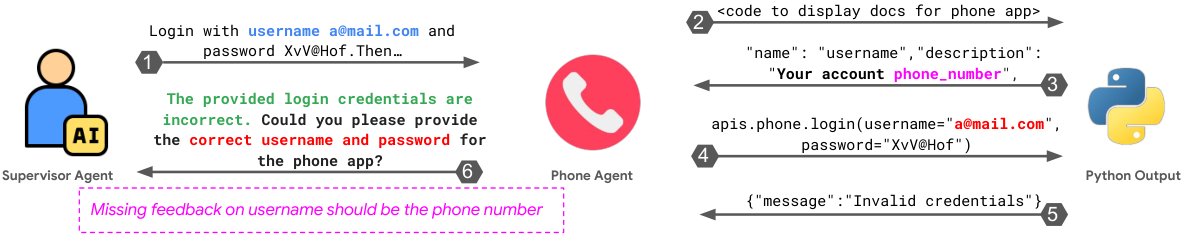
Figure 3:关键信息未共享导致失败的轨迹案例。 查看原始图源。

原始来源与阅读范围
Mert Cemri et al. / arXiv · 2025-03-17。本轮范围:正文重点阅读;采集日期:2026-11-16。来源陈述与本库提出的实验设想在正文中分别说明。